


Puoi gestire controllo dell'accesso centralizzato per i workload Hadoop, YARN e Hive integrando Apache Ranger con Kerberos in Managed Service for Apache Spark. In questo tutorial creerai un cluster con i componenti Ranger e Apache Solr, configurerai le policy di autorizzazione e verificherai le autorizzazioni dell'utente.
Durante la valutazione delle policy di accesso, Managed Service for Apache Spark mappa le entità Kerberos agli utenti di sistema rimuovendo il realm e l'istanza, ad esempio mappando user1/cluster-m@MY.REALM a user1. Puoi gestire queste policy nell'interfaccia utente web di Ranger tramite il gateway dei componenti.
Crea il cluster.
- Il seguente comando
gcloudpuò essere eseguito in una finestra del terminale locale o da Cloud Shell di un progetto.gcloud dataproc clusters create cluster-name \ --region=region \ --optional-components=SOLR,RANGER \ --enable-component-gateway \ --properties="dataproc:ranger.kms.key.uri=projects/project-id/locations/global/keyRings/keyring/cryptoKeys/key,dataproc:ranger.admin.password.uri=gs://bucket/admin-password.encrypted" \ --kerberos-root-principal-password-uri=gs://bucket/kerberos-root-principal-password.encrypted \ --kerberos-kms-key=projects/project-id/locations/global/keyRings/keyring/cryptoKeys/key
- Il seguente comando
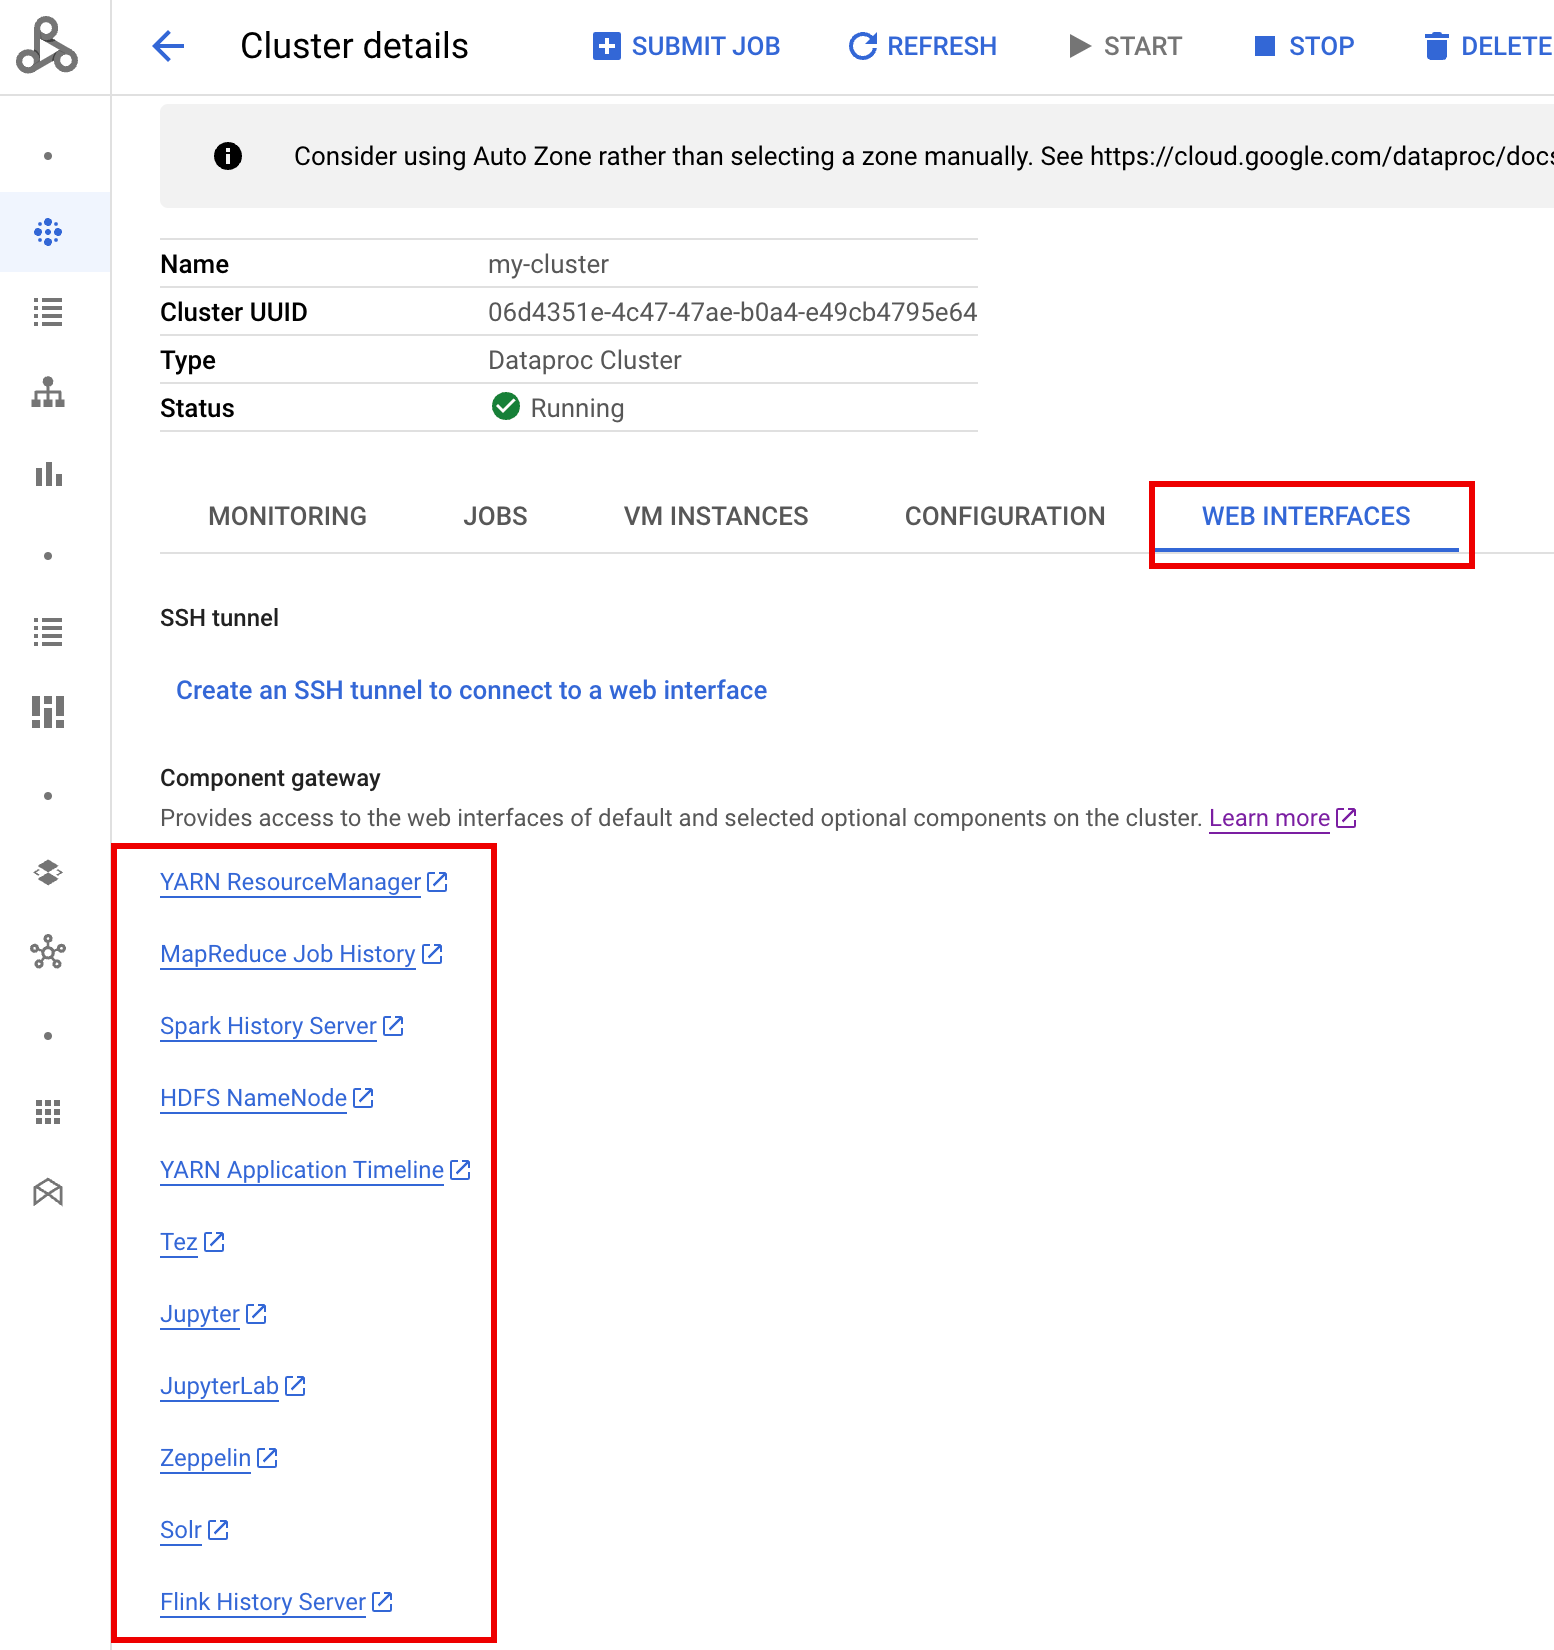
Dopo l'avvio del cluster, vai alla pagina Cluster di Managed Service for Apache Spark nella console Google Cloud , quindi seleziona il nome del cluster per aprire la pagina Dettagli cluster. Fai clic sulla scheda Interfacce web per visualizzare un elenco di link del gateway dei componenti alle interfacce web dei componenti predefiniti e facoltativi installati sul cluster. Fai clic sul link Ranger.
Accedi a Ranger inserendo il nome utente
admine la password amministratore di Ranger.
La UI di Ranger
adminsi apre in un browser locale.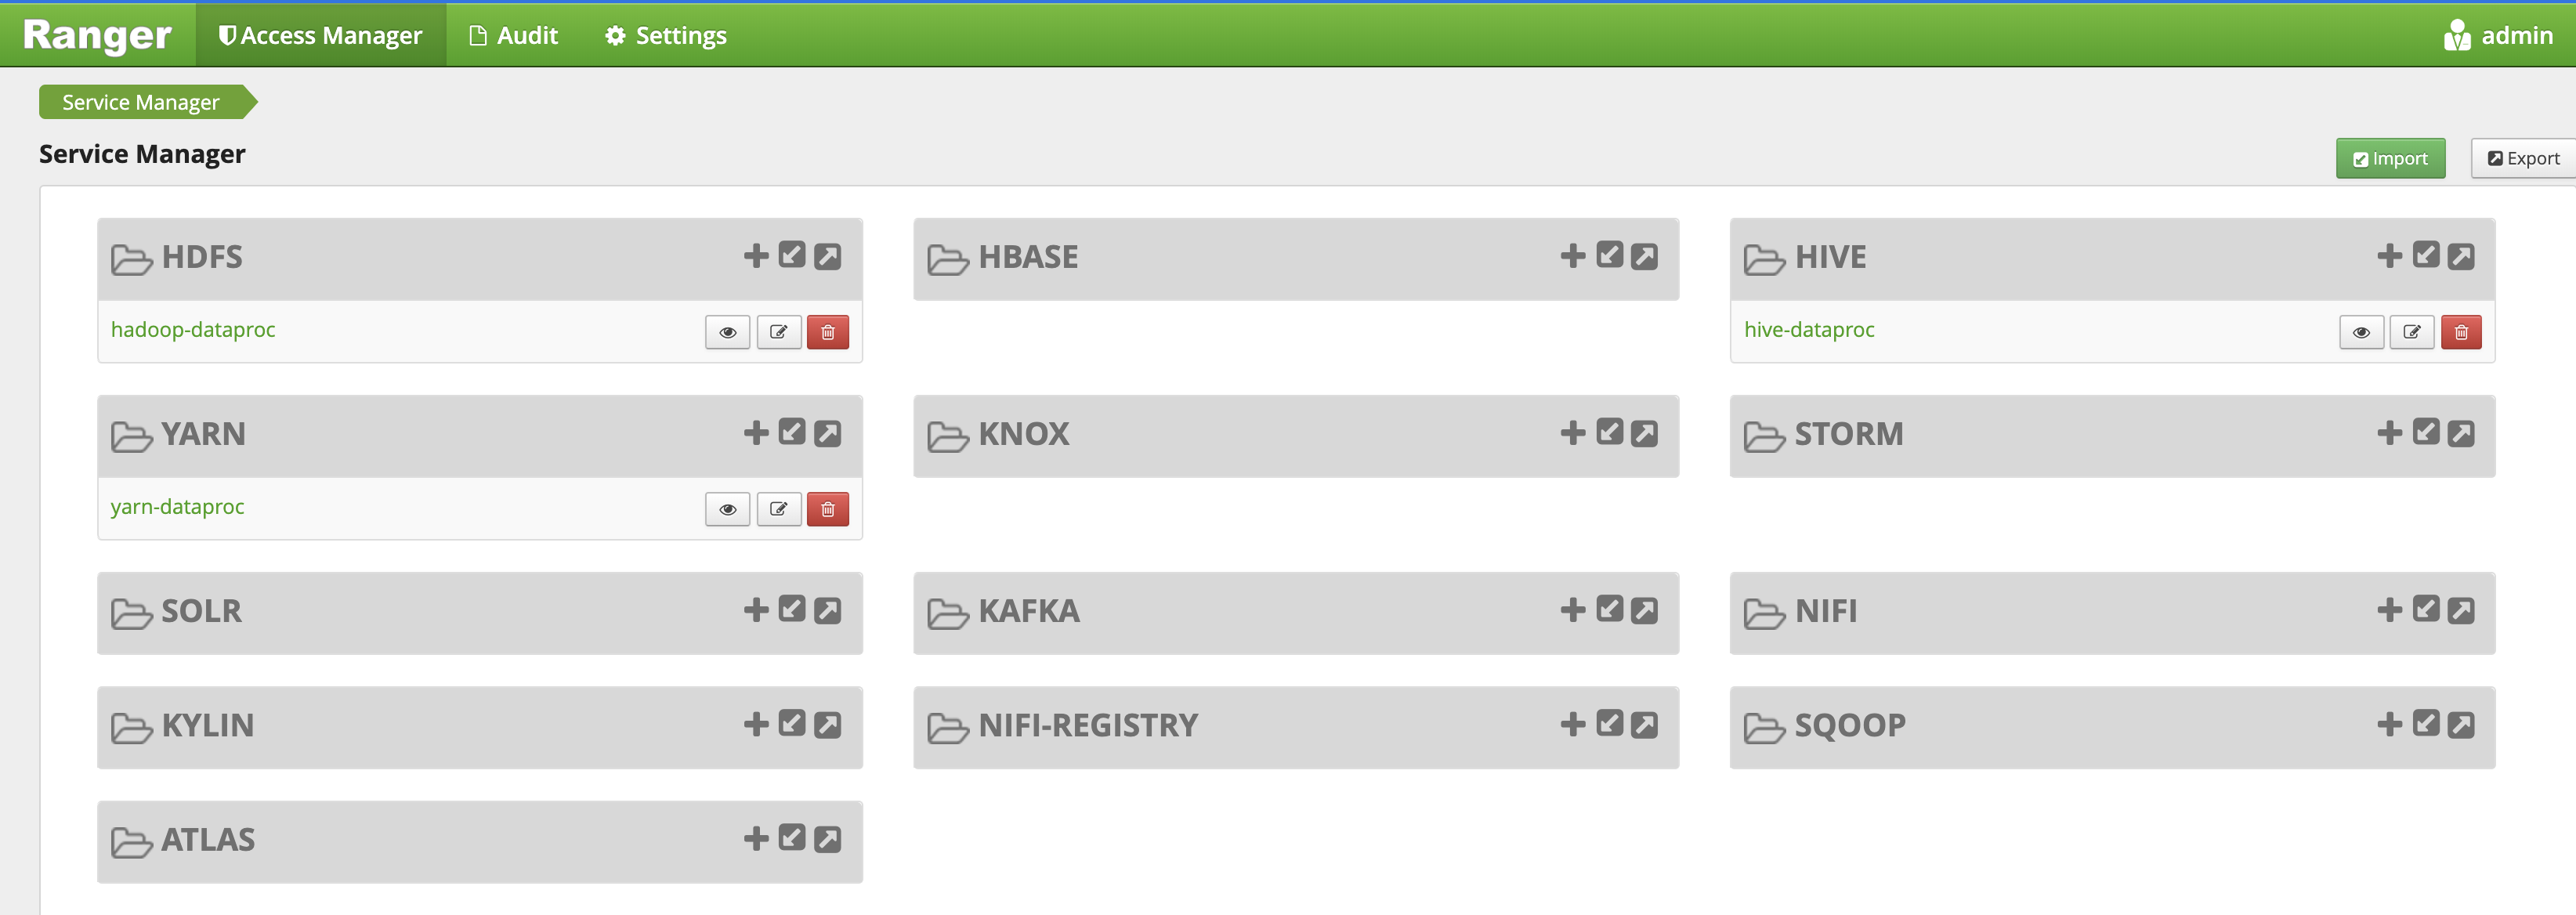
Policy di accesso YARN
Questo esempio crea una policy di Ranger per consentire e negare l'accesso degli utenti alla coda root.default di YARN.
Seleziona
yarn-dataprocdall'interfaccia utente amministratore di Ranger.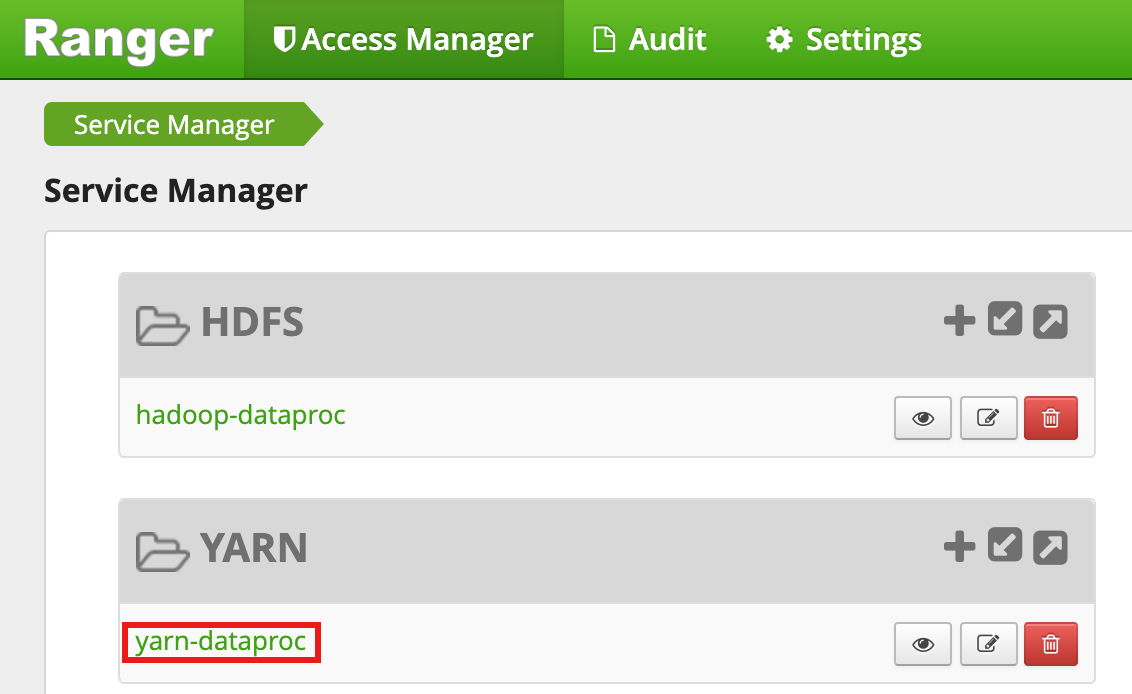
Nella pagina yarn-dataproc Policies (Policy yarn-dataproc), fai clic su Add New Policy (Aggiungi nuova policy). Nella pagina Crea policy, vengono inseriti o selezionati i seguenti campi:
Policy Name: "yarn-policy-1"Queue: "root.default"Audit Logging: "Sì"Allow Conditions:Select User: "userone"Permissions: "Seleziona tutto" per concedere tutte le autorizzazioni
Deny Conditions:Select User: "usertwo"Permissions: "Seleziona tutto" per negare tutte le autorizzazioni
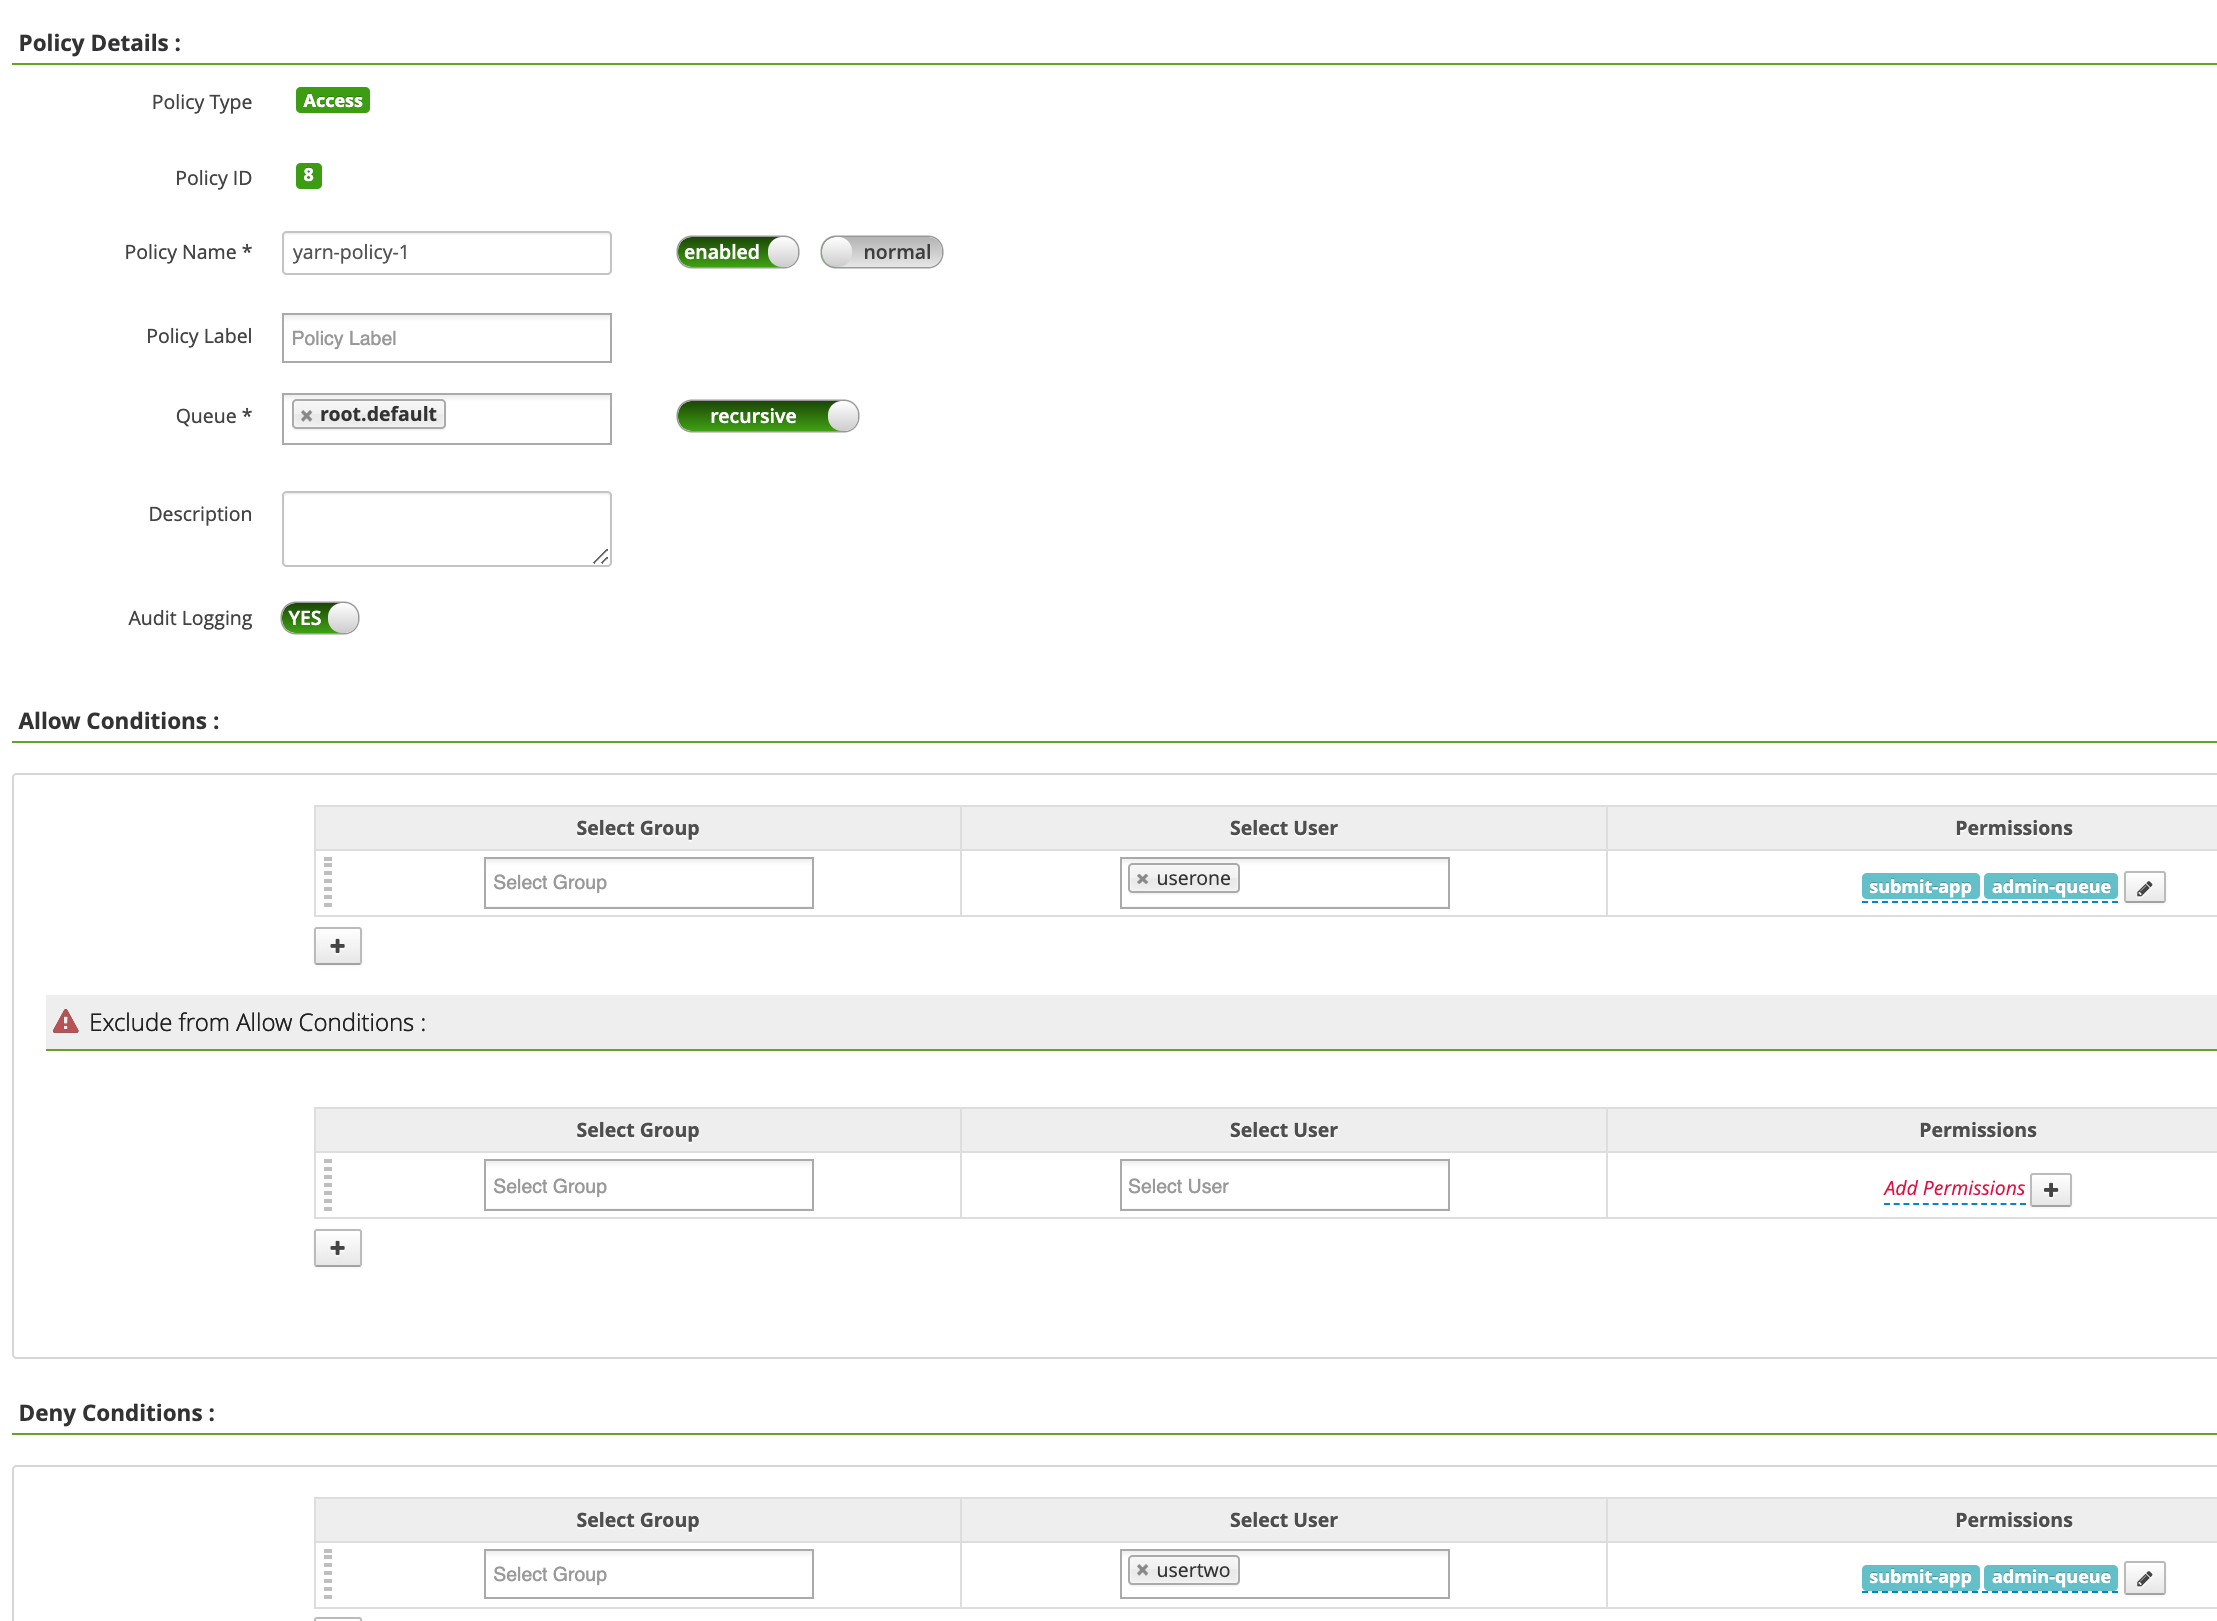
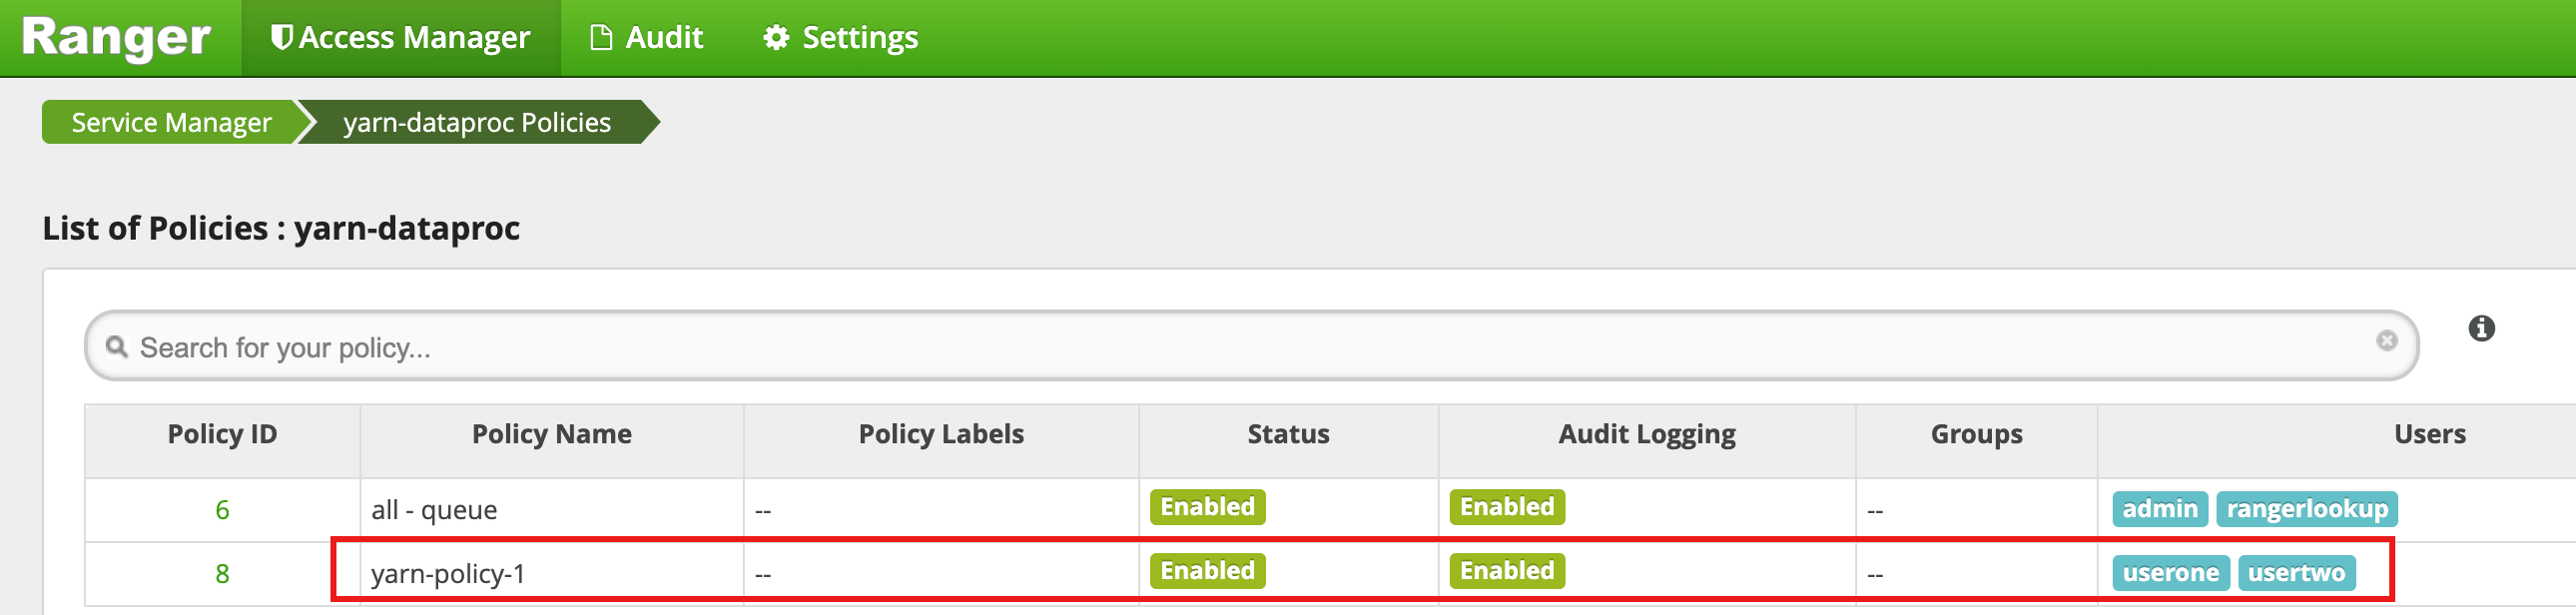
Fai clic su Aggiungi per salvare la policy. La policy è elencata nella pagina Policy yarn-dataproc:
Esegui un job MapReduce di Hadoop nella finestra della sessione SSH master come userone:
userone@example-cluster-m:~$ hadoop jar /usr/lib/hadoop-mapreduce/hadoop-mapreduced-examples.
jar pi 5 10
- La UI di Ranger mostra che
useroneè stato autorizzato a inviare il job.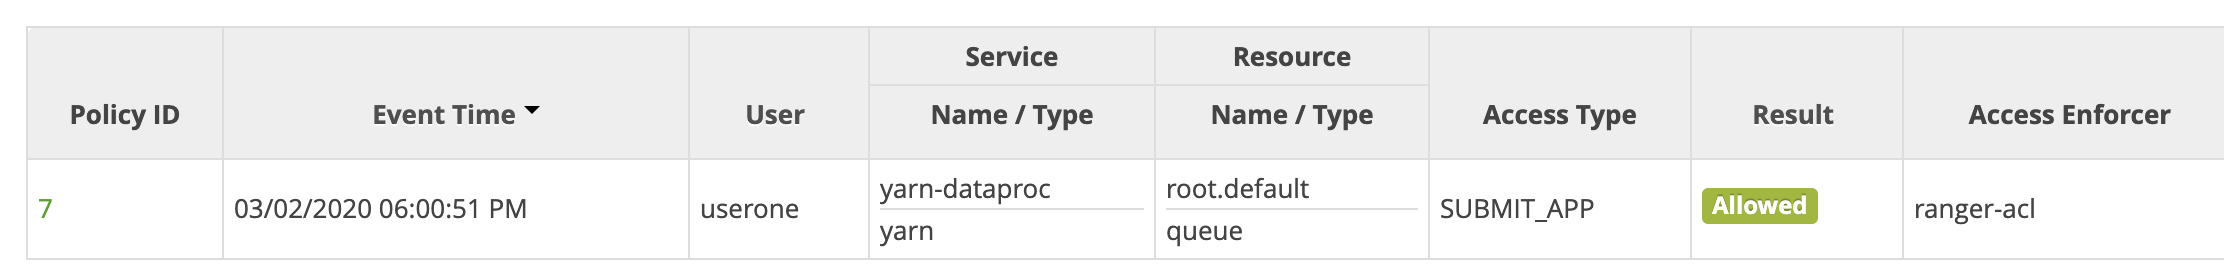
- La UI di Ranger mostra che
Esegui il job MapReduce di Hadoop dalla finestra della sessione SSH del master VM come
usertwo:usertwo@example-cluster-m:~$ hadoop jar /usr/lib/hadoop-mapreduce/hadoop-mapreduced-examples. jar pi 5 10
- La UI di Ranger mostra che a
usertwoè stato negato l'accesso per l'invio del job.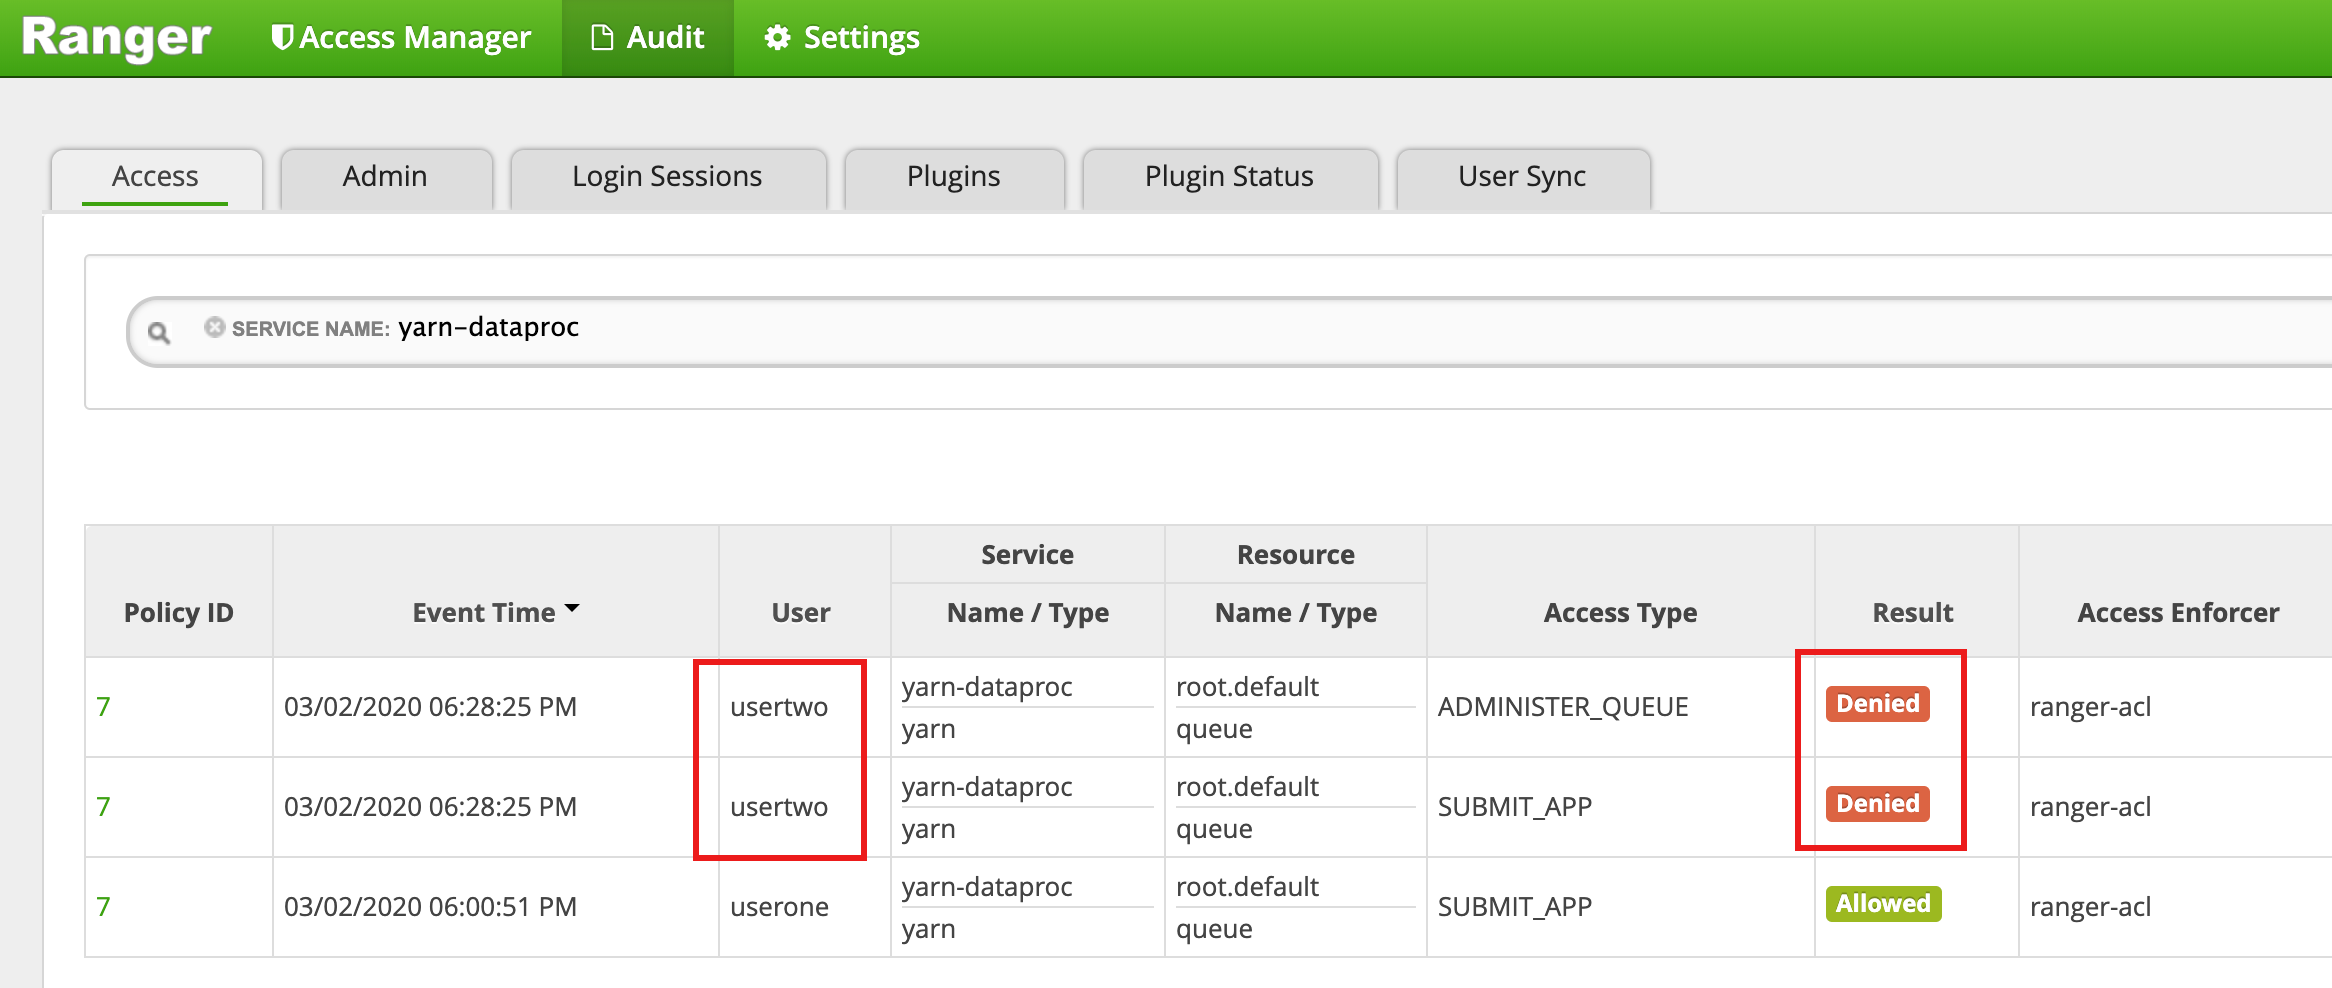
- La UI di Ranger mostra che a
Policy di accesso HDFS
Questo esempio crea una policy di Ranger per consentire e negare l'accesso degli utenti alla directory HDFS /tmp.
Seleziona
hadoop-dataprocdall'interfaccia utente amministratore di Ranger.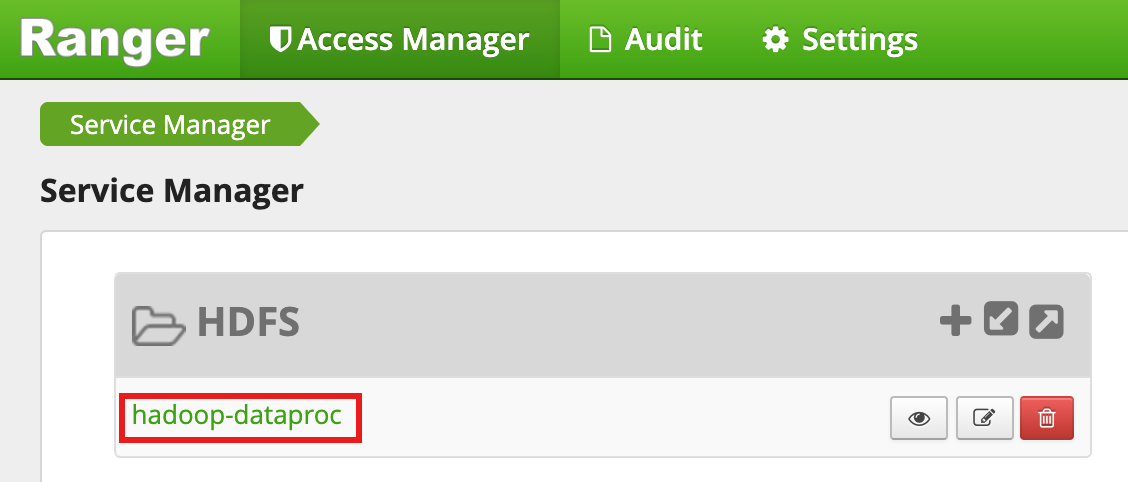
Nella pagina hadoop-dataproc Policies, fai clic su Add New Policy. Nella pagina Crea policy, vengono inseriti o selezionati i seguenti campi:
Policy Name: "hadoop-policy-1"Resource Path: "/tmp"Audit Logging: "Sì"Allow Conditions:Select User: "userone"Permissions: "Seleziona tutto" per concedere tutte le autorizzazioni
Deny Conditions:Select User: "usertwo"Permissions: "Seleziona tutto" per negare tutte le autorizzazioni
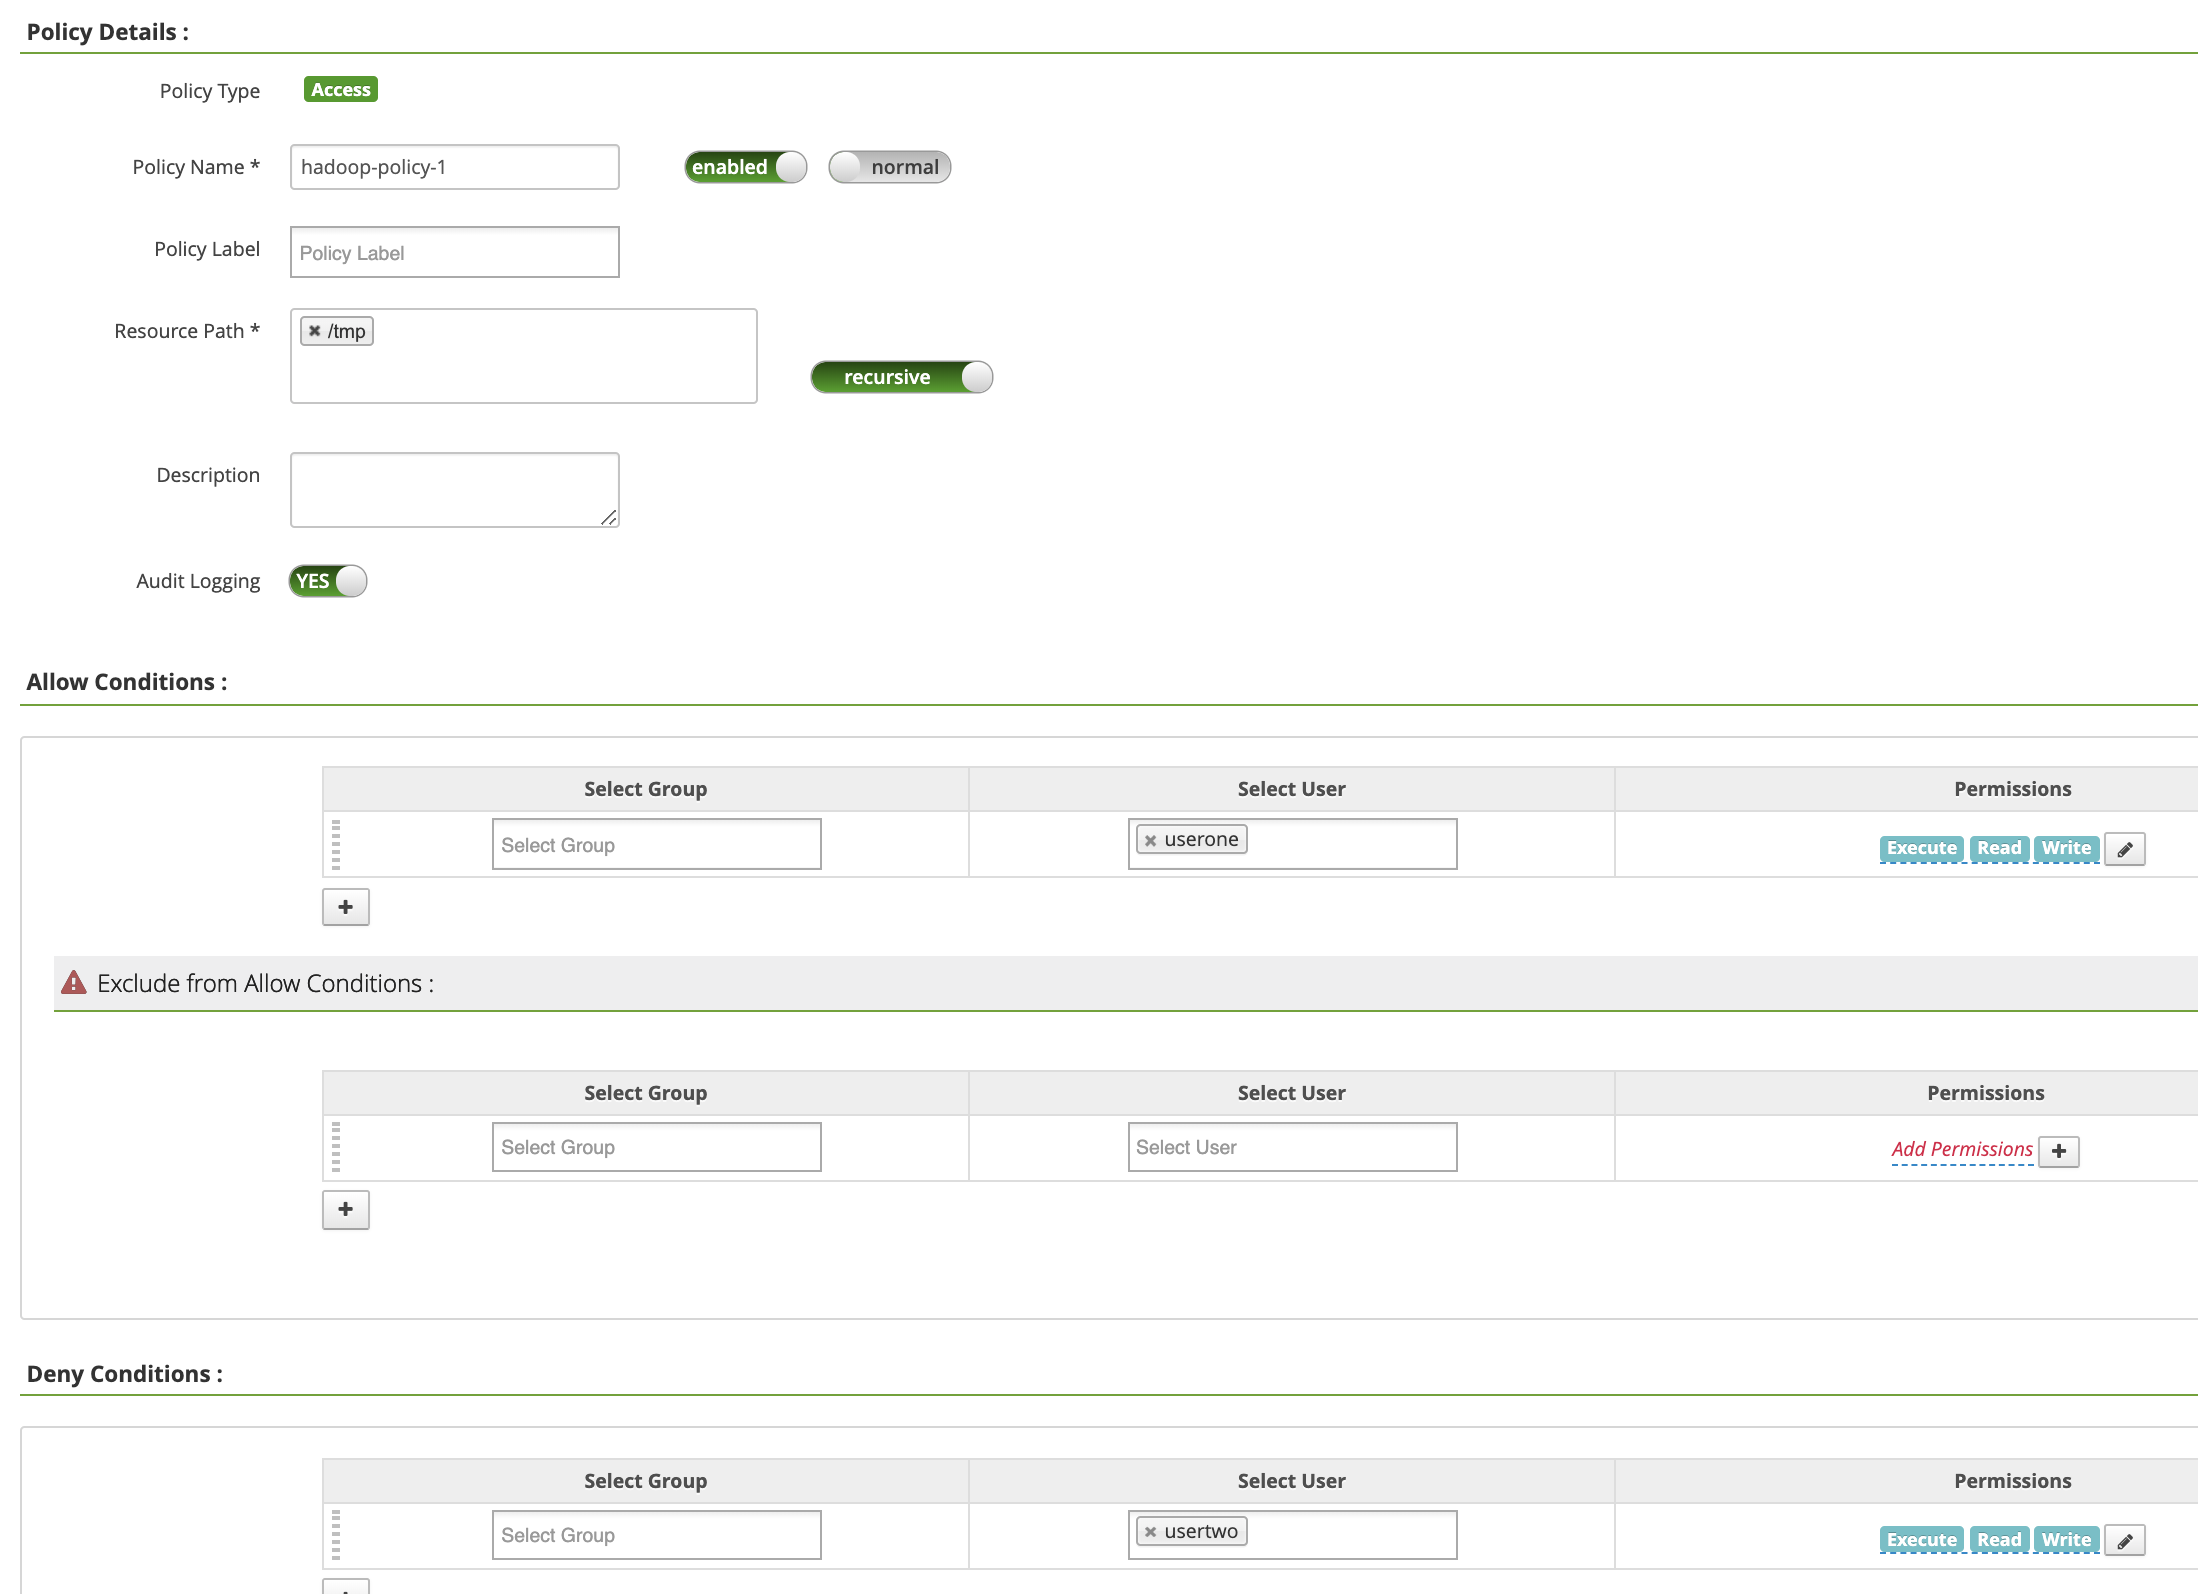
Fai clic su Aggiungi per salvare la policy. La policy è elencata nella pagina Policy hadoop-dataproc:
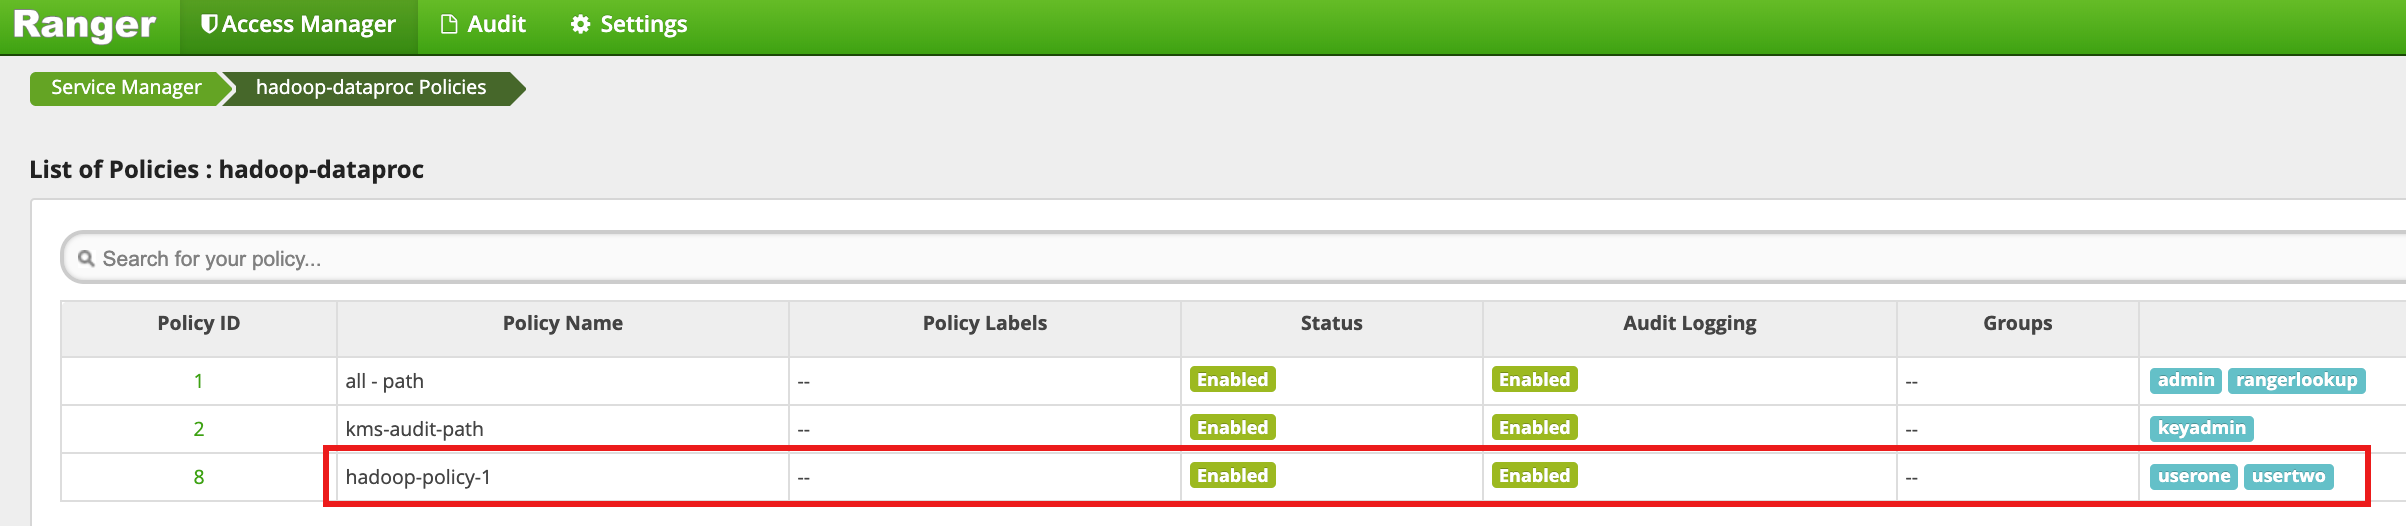
Accedi alla directory HDFS
/tmpcome userone:userone@example-cluster-m:~$ hadoop fs -ls /tmp
- La UI di Ranger mostra che
useroneha ottenuto l'accesso alla directory /tmp di HDFS.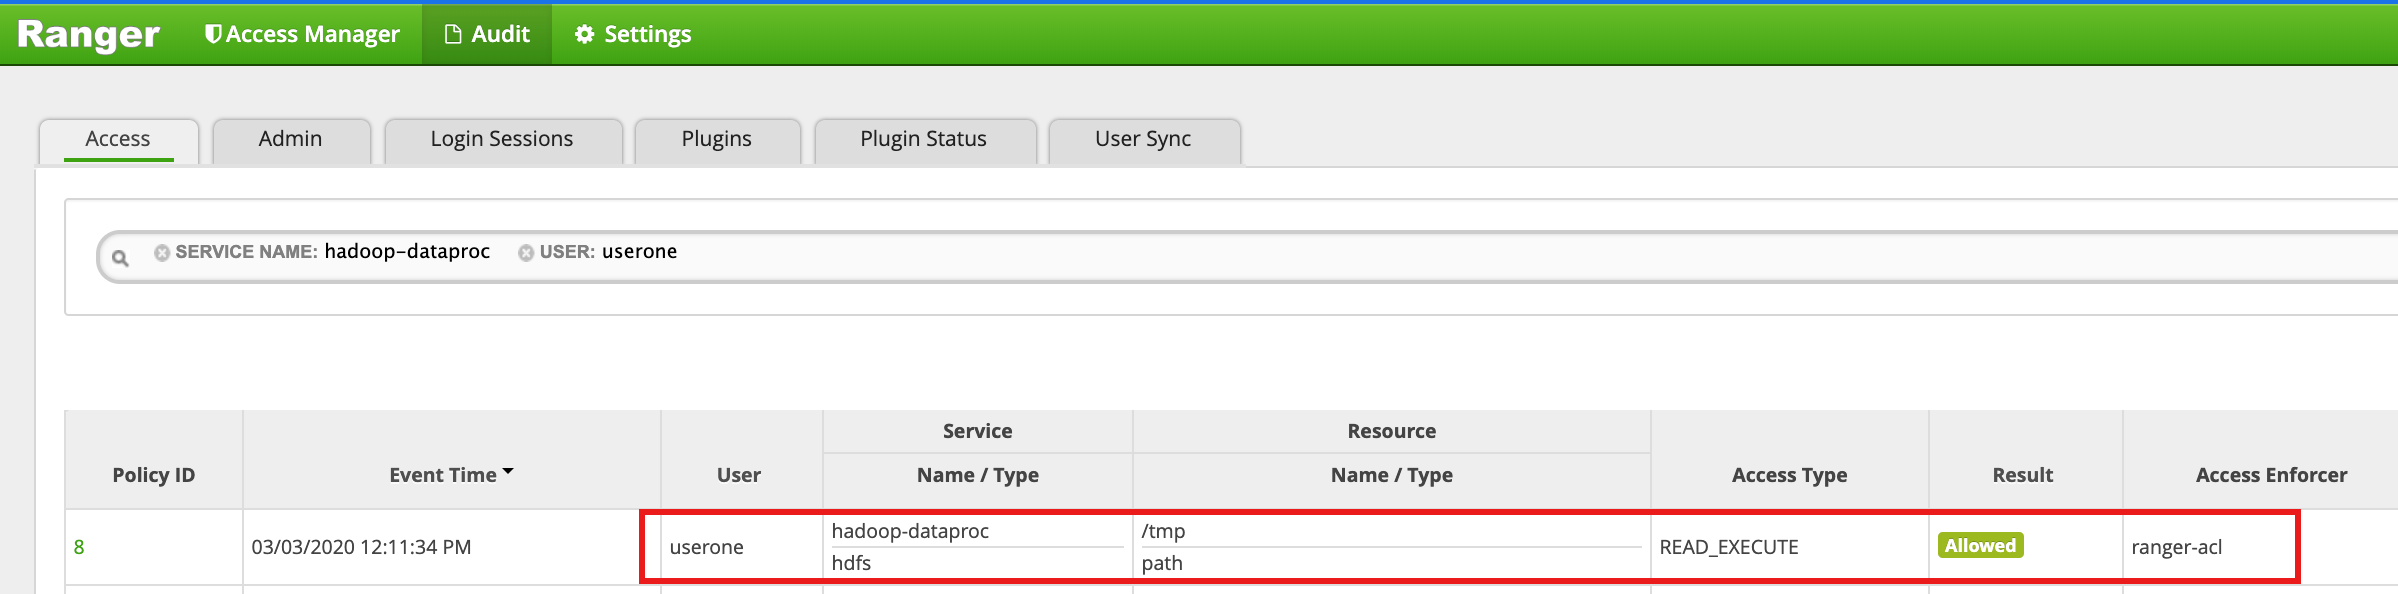
- La UI di Ranger mostra che
Accedi alla directory HDFS
/tmpcomeusertwo:usertwo@example-cluster-m:~$ hadoop fs -ls /tmp
- La UI di Ranger mostra che
usertwonon ha ottenuto l'accesso alla directory HDFS /tmp.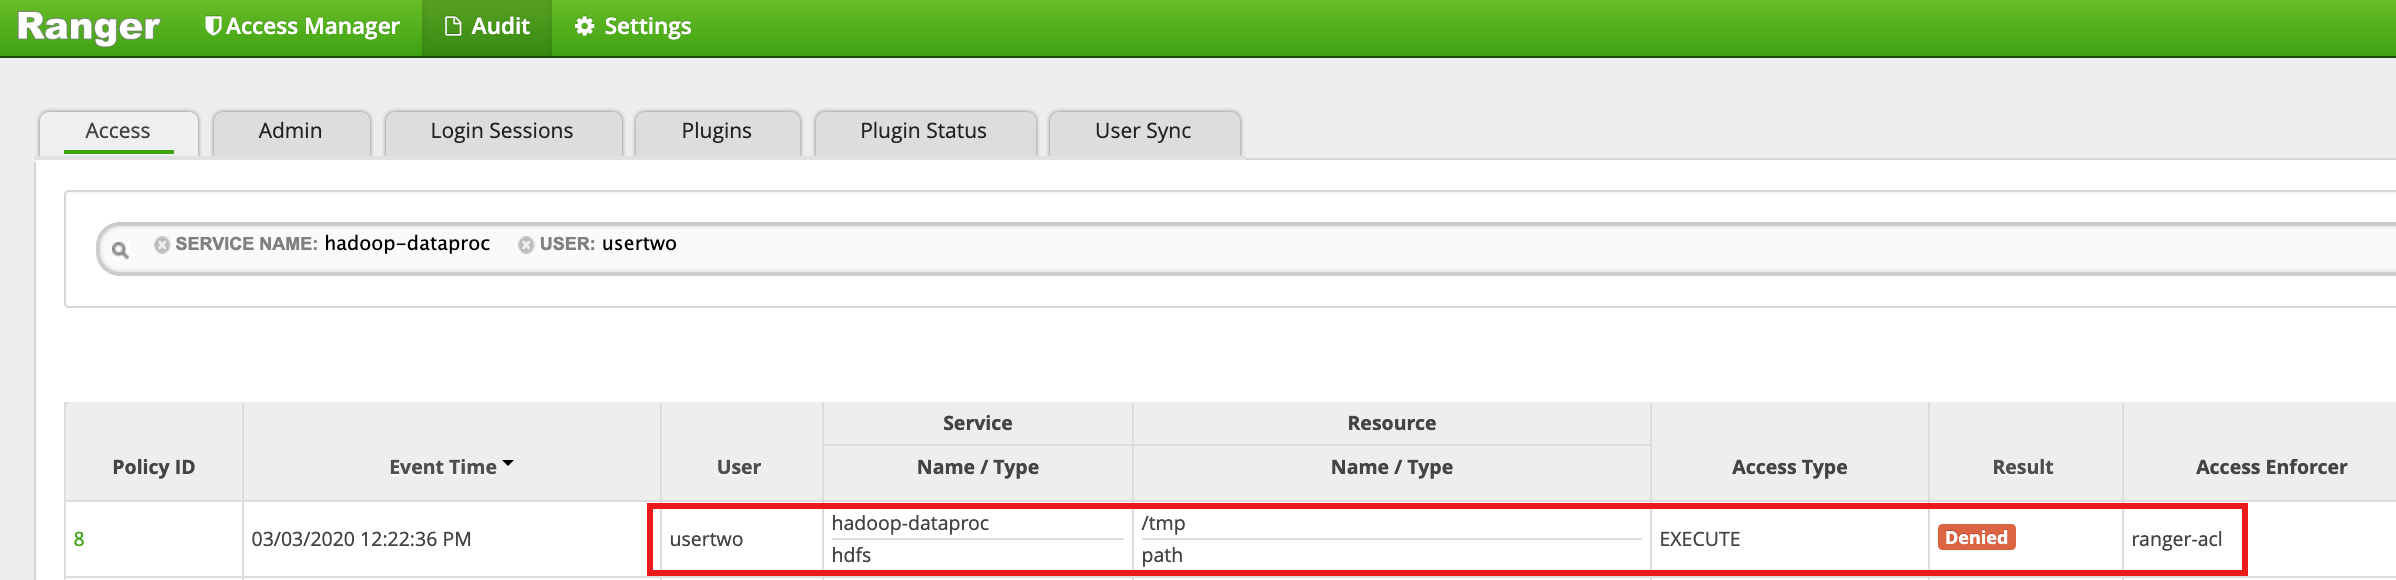
- La UI di Ranger mostra che
Policy di accesso Hive
Questo esempio crea una policy di Ranger per consentire e negare l'accesso degli utenti a una tabella Hive.
Crea una piccola tabella
employeeutilizzando l'interfaccia a riga di comando di Hive nell'istanza master.hive> CREATE TABLE IF NOT EXISTS employee (eid int, name String); INSERT INTO employee VALUES (1 , 'bob') , (2 , 'alice'), (3 , 'john');
Seleziona
hive-dataprocdall'interfaccia utente amministratore di Ranger.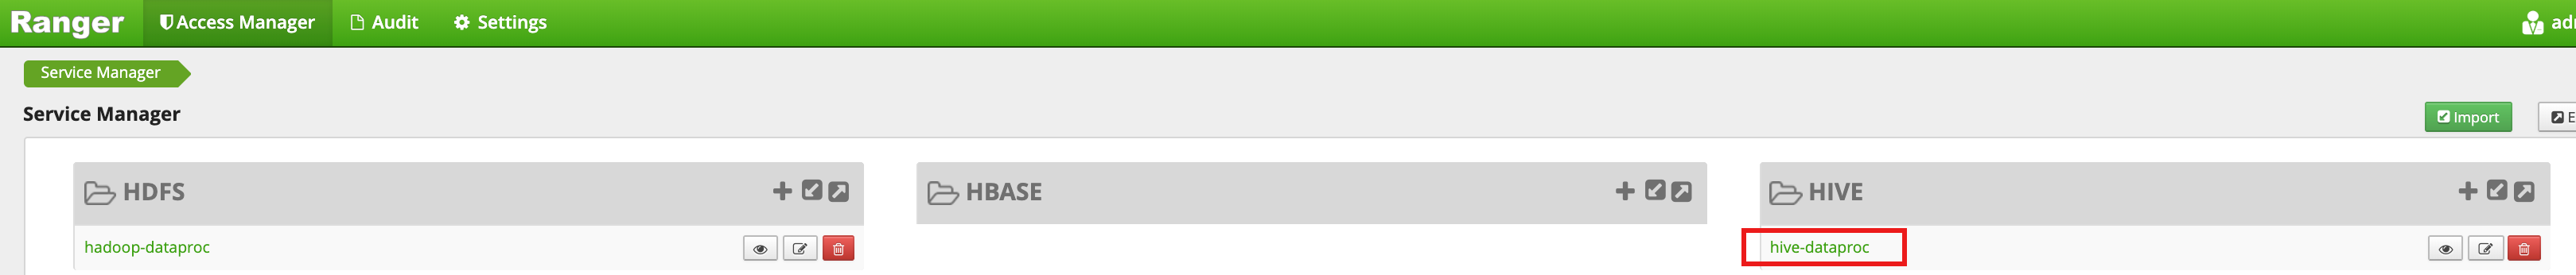
Nella pagina hive-dataproc Policies, fai clic su Add New Policy. Nella pagina Crea policy, vengono inseriti o selezionati i seguenti campi:
Policy Name: "hive-policy-1"database: "default"table: "employee"Hive Column: "*"Audit Logging: "Sì"Allow Conditions:Select User: "userone"Permissions: "Seleziona tutto" per concedere tutte le autorizzazioni
Deny Conditions:Select User: "usertwo"Permissions: "Seleziona tutto" per negare tutte le autorizzazioni
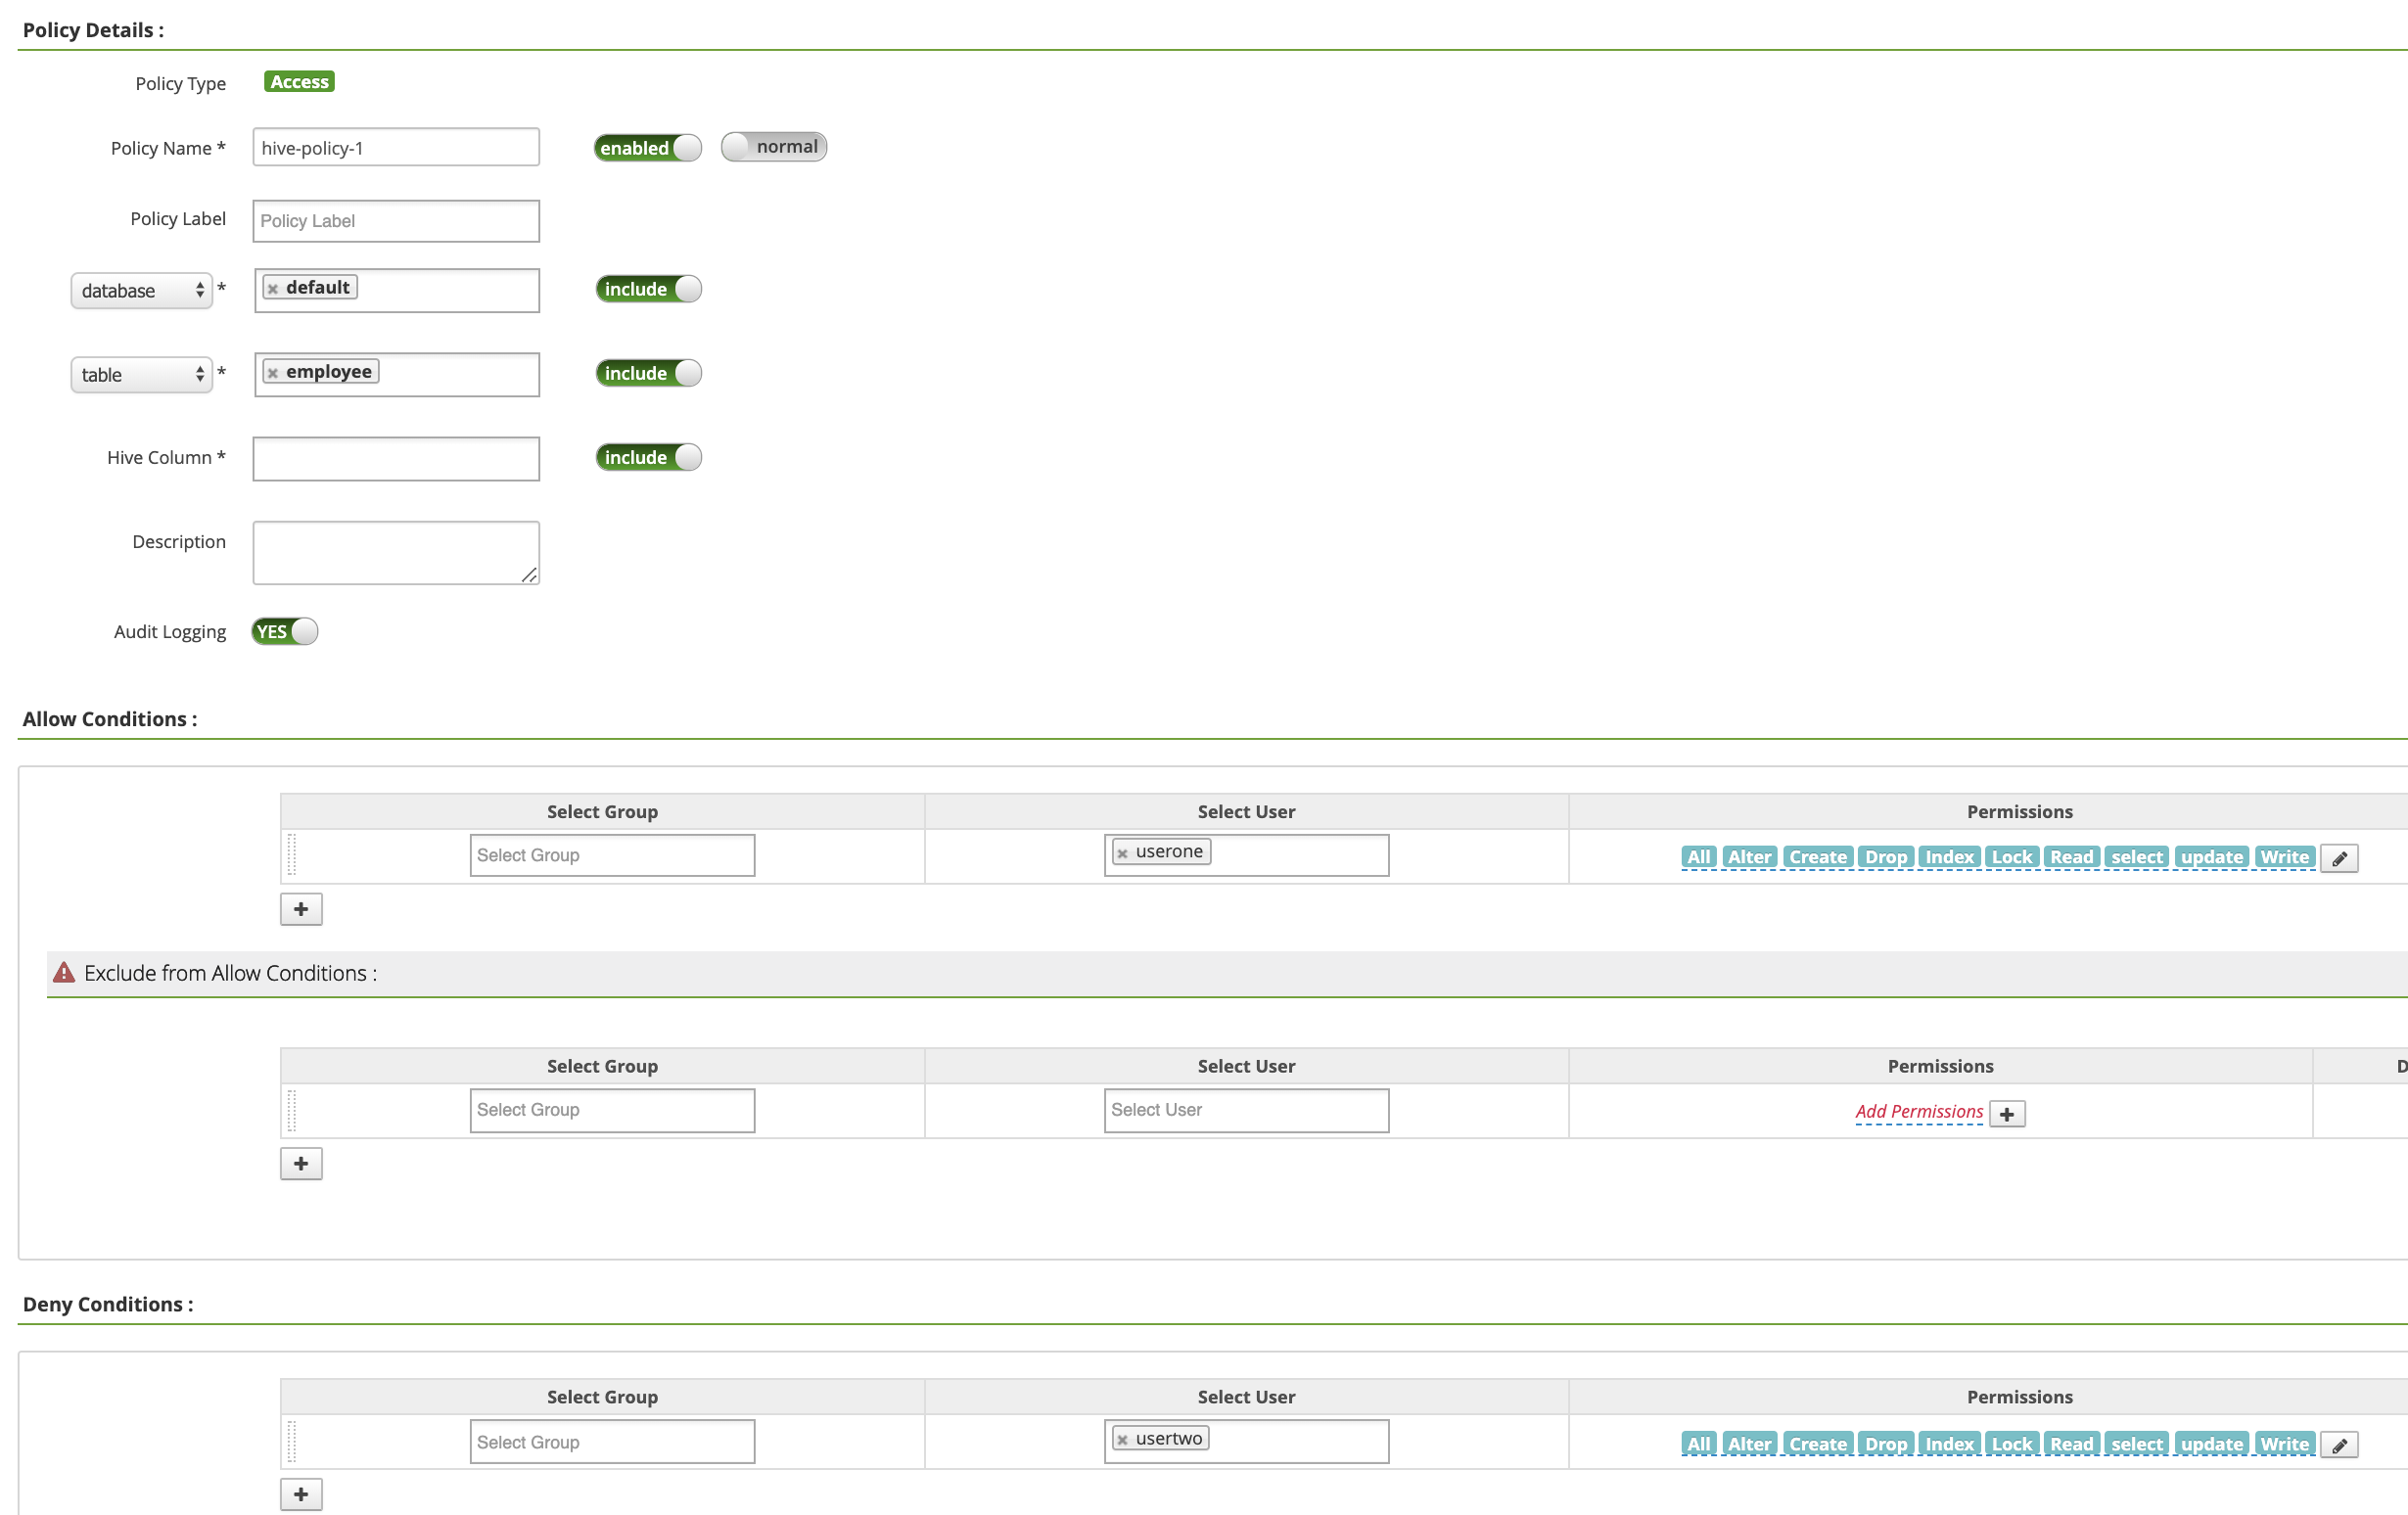
Fai clic su Aggiungi per salvare la policy. La policy è elencata nella pagina Policy hive-dataproc:
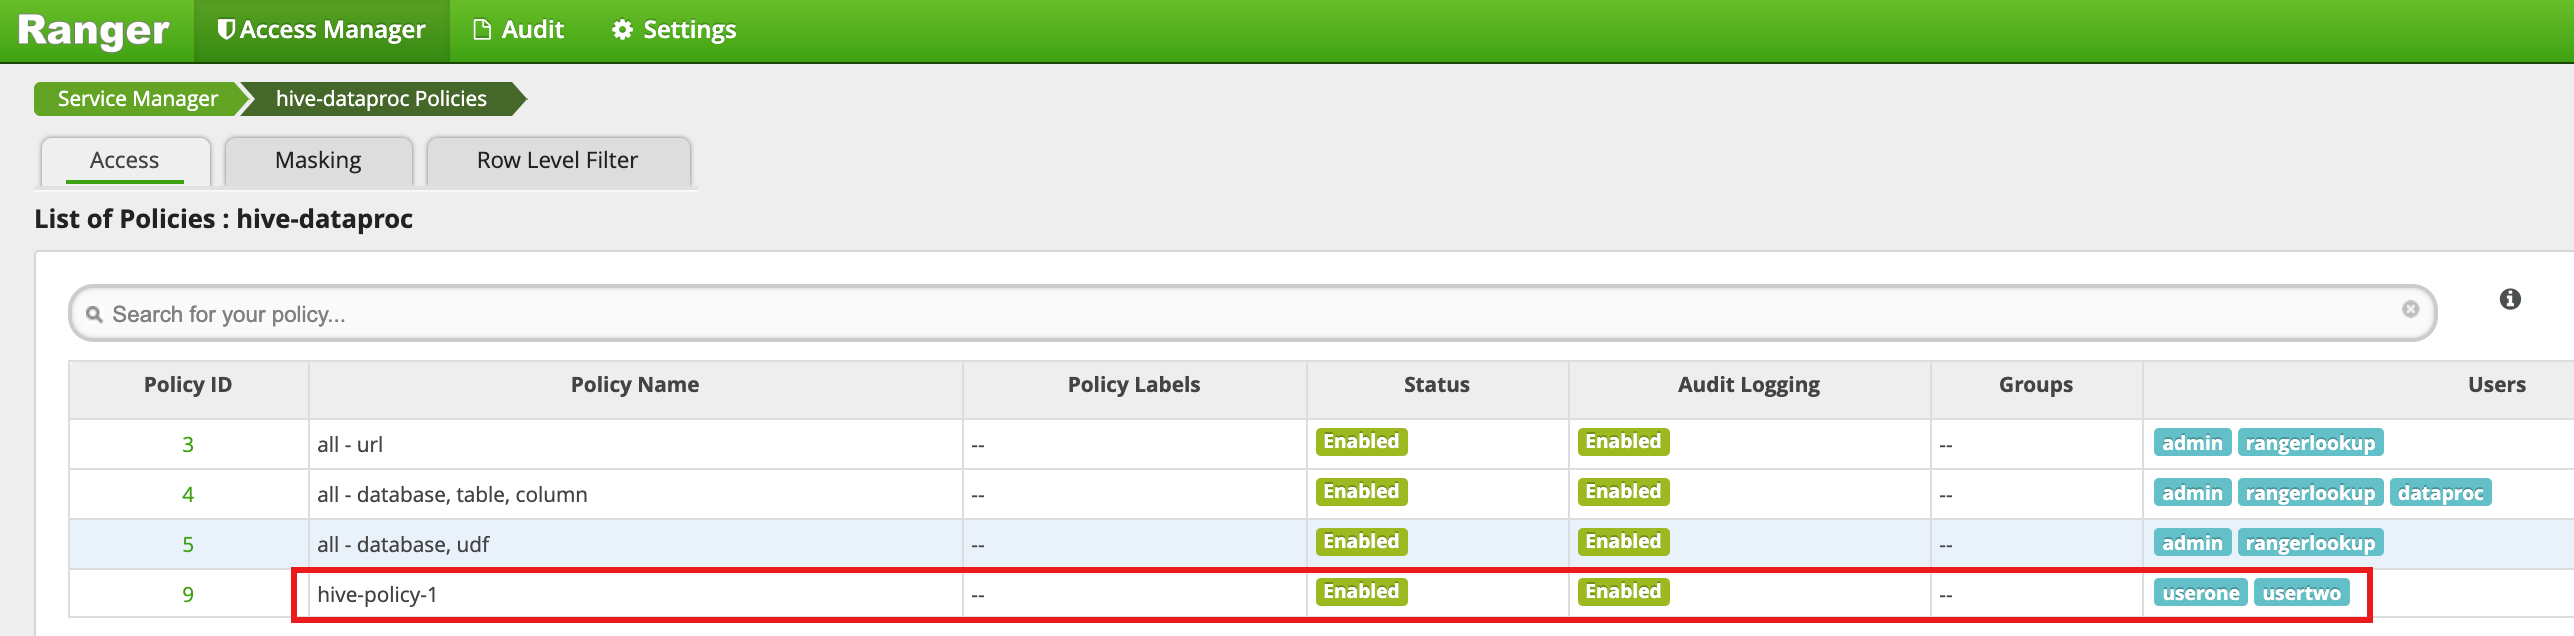
Esegui una query dalla sessione SSH master della VM sulla tabella dei dipendenti Hive come userone:
userone@example-cluster-m:~$ beeline -u "jdbc:hive2://$(hostname -f):10000/default;principal=hive/$(hostname -f)@REALM" -e "select * from employee;"
- La query di userone ha esito positivo:
Connected to: Apache Hive (version 2.3.6)
Driver: Hive JDBC (version 2.3.6)
Transaction isolation: TRANSACTION_REPEATABLE_READ
+---------------+----------------+
| employee.eid  | employee.name  |
+---------------+----------------+
| 1             | bob            |
| 2             | alice          |
| 3             | john           |
+---------------+----------------+
3 rows selected (2.033 seconds)
- La query di userone ha esito positivo:
Esegui una query dalla sessione SSH master della VM sulla tabella dei dipendenti Hive come usertwo:
usertwo@example-cluster-m:~$ beeline -u "jdbc:hive2://$(hostname -f):10000/default;principal=hive/$(hostname -f)@REALM" -e "select * from employee;"
- usertwo non può accedere alla tabella:
Error: Could not open client transport with JDBC Uri:
...
Permission denied: user=usertwo, access=EXECUTE, inode="/tmp/hive"
- usertwo non può accedere alla tabella:
Accesso Hive granulare
Ranger supporta il mascheramento e i filtri a livello di riga su Hive. Questo esempio si basa sul hive-policy-1 precedente aggiungendo policy di mascheramento e filtro.
Seleziona
hive-dataprocdall'interfaccia utente amministratore di Ranger, poi seleziona la scheda Mascheramento e fai clic su Aggiungi nuova policy.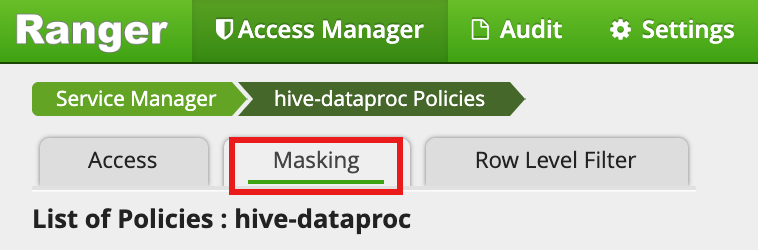
Nella pagina Crea policy, i seguenti campi vengono inseriti o selezionati per creare una policy per mascherare (annullare) la colonna del nome del dipendente:
Policy Name: "hive-masking policy"database: "default"table: "employee"Hive Column: "name"Audit Logging: "Sì"Mask Conditions:Select User: "userone"Access Types: autorizzazioni di aggiunta/modifica "select"Select Masking Option: "nullify"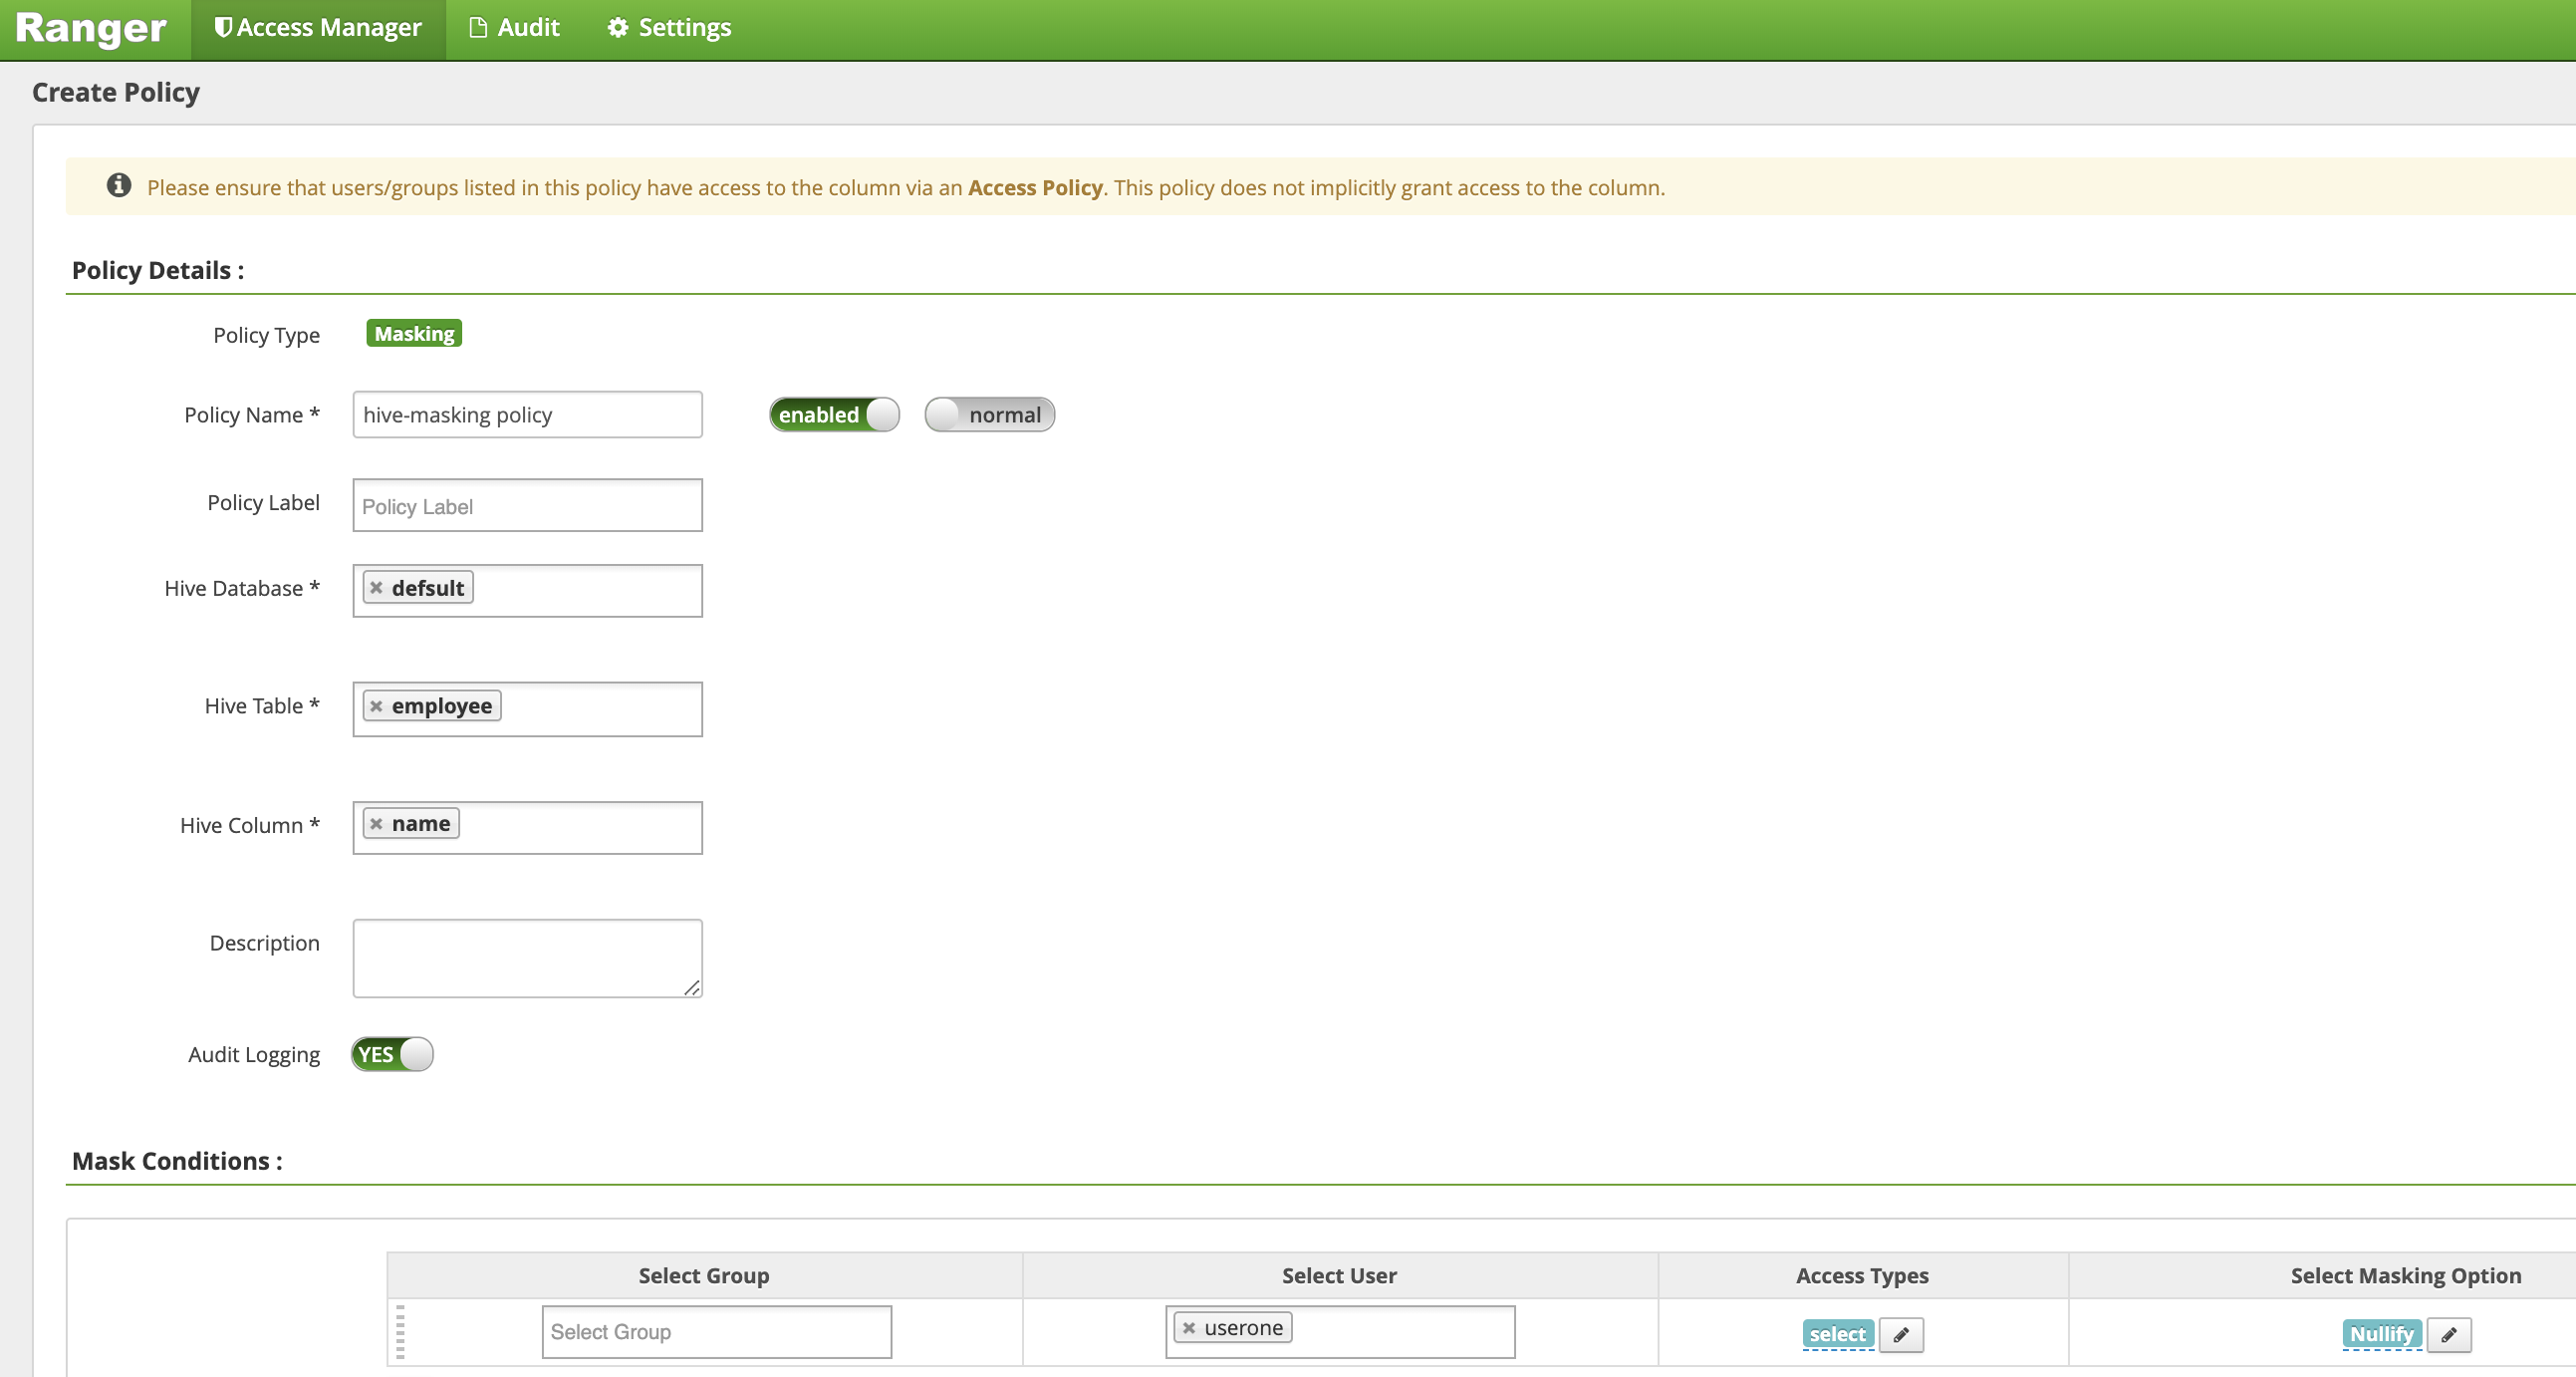
Fai clic su Aggiungi per salvare la policy.
Seleziona
hive-dataprocdall'interfaccia utente amministratore di Ranger, quindi seleziona la scheda Filtro a livello di riga e fai clic su Aggiungi nuova policy.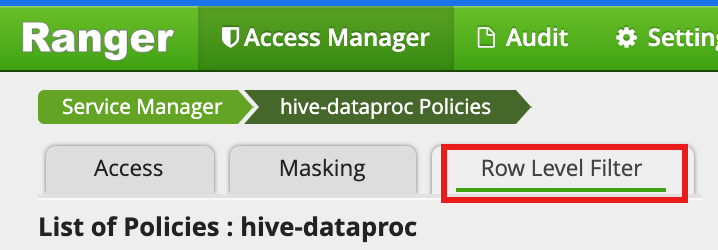
Nella pagina Crea policy, i seguenti campi vengono inseriti o selezionati per creare una policy per filtrare (restituire) le righe in cui
eidnon è uguale a1:Policy Name: "hive-filter policy"Hive Database: "default"Hive Table: "employee"Audit Logging: "Sì"Mask Conditions:Select User: "userone"Access Types: autorizzazioni di aggiunta/modifica "select"Row Level Filter: espressione di filtro "eid != 1"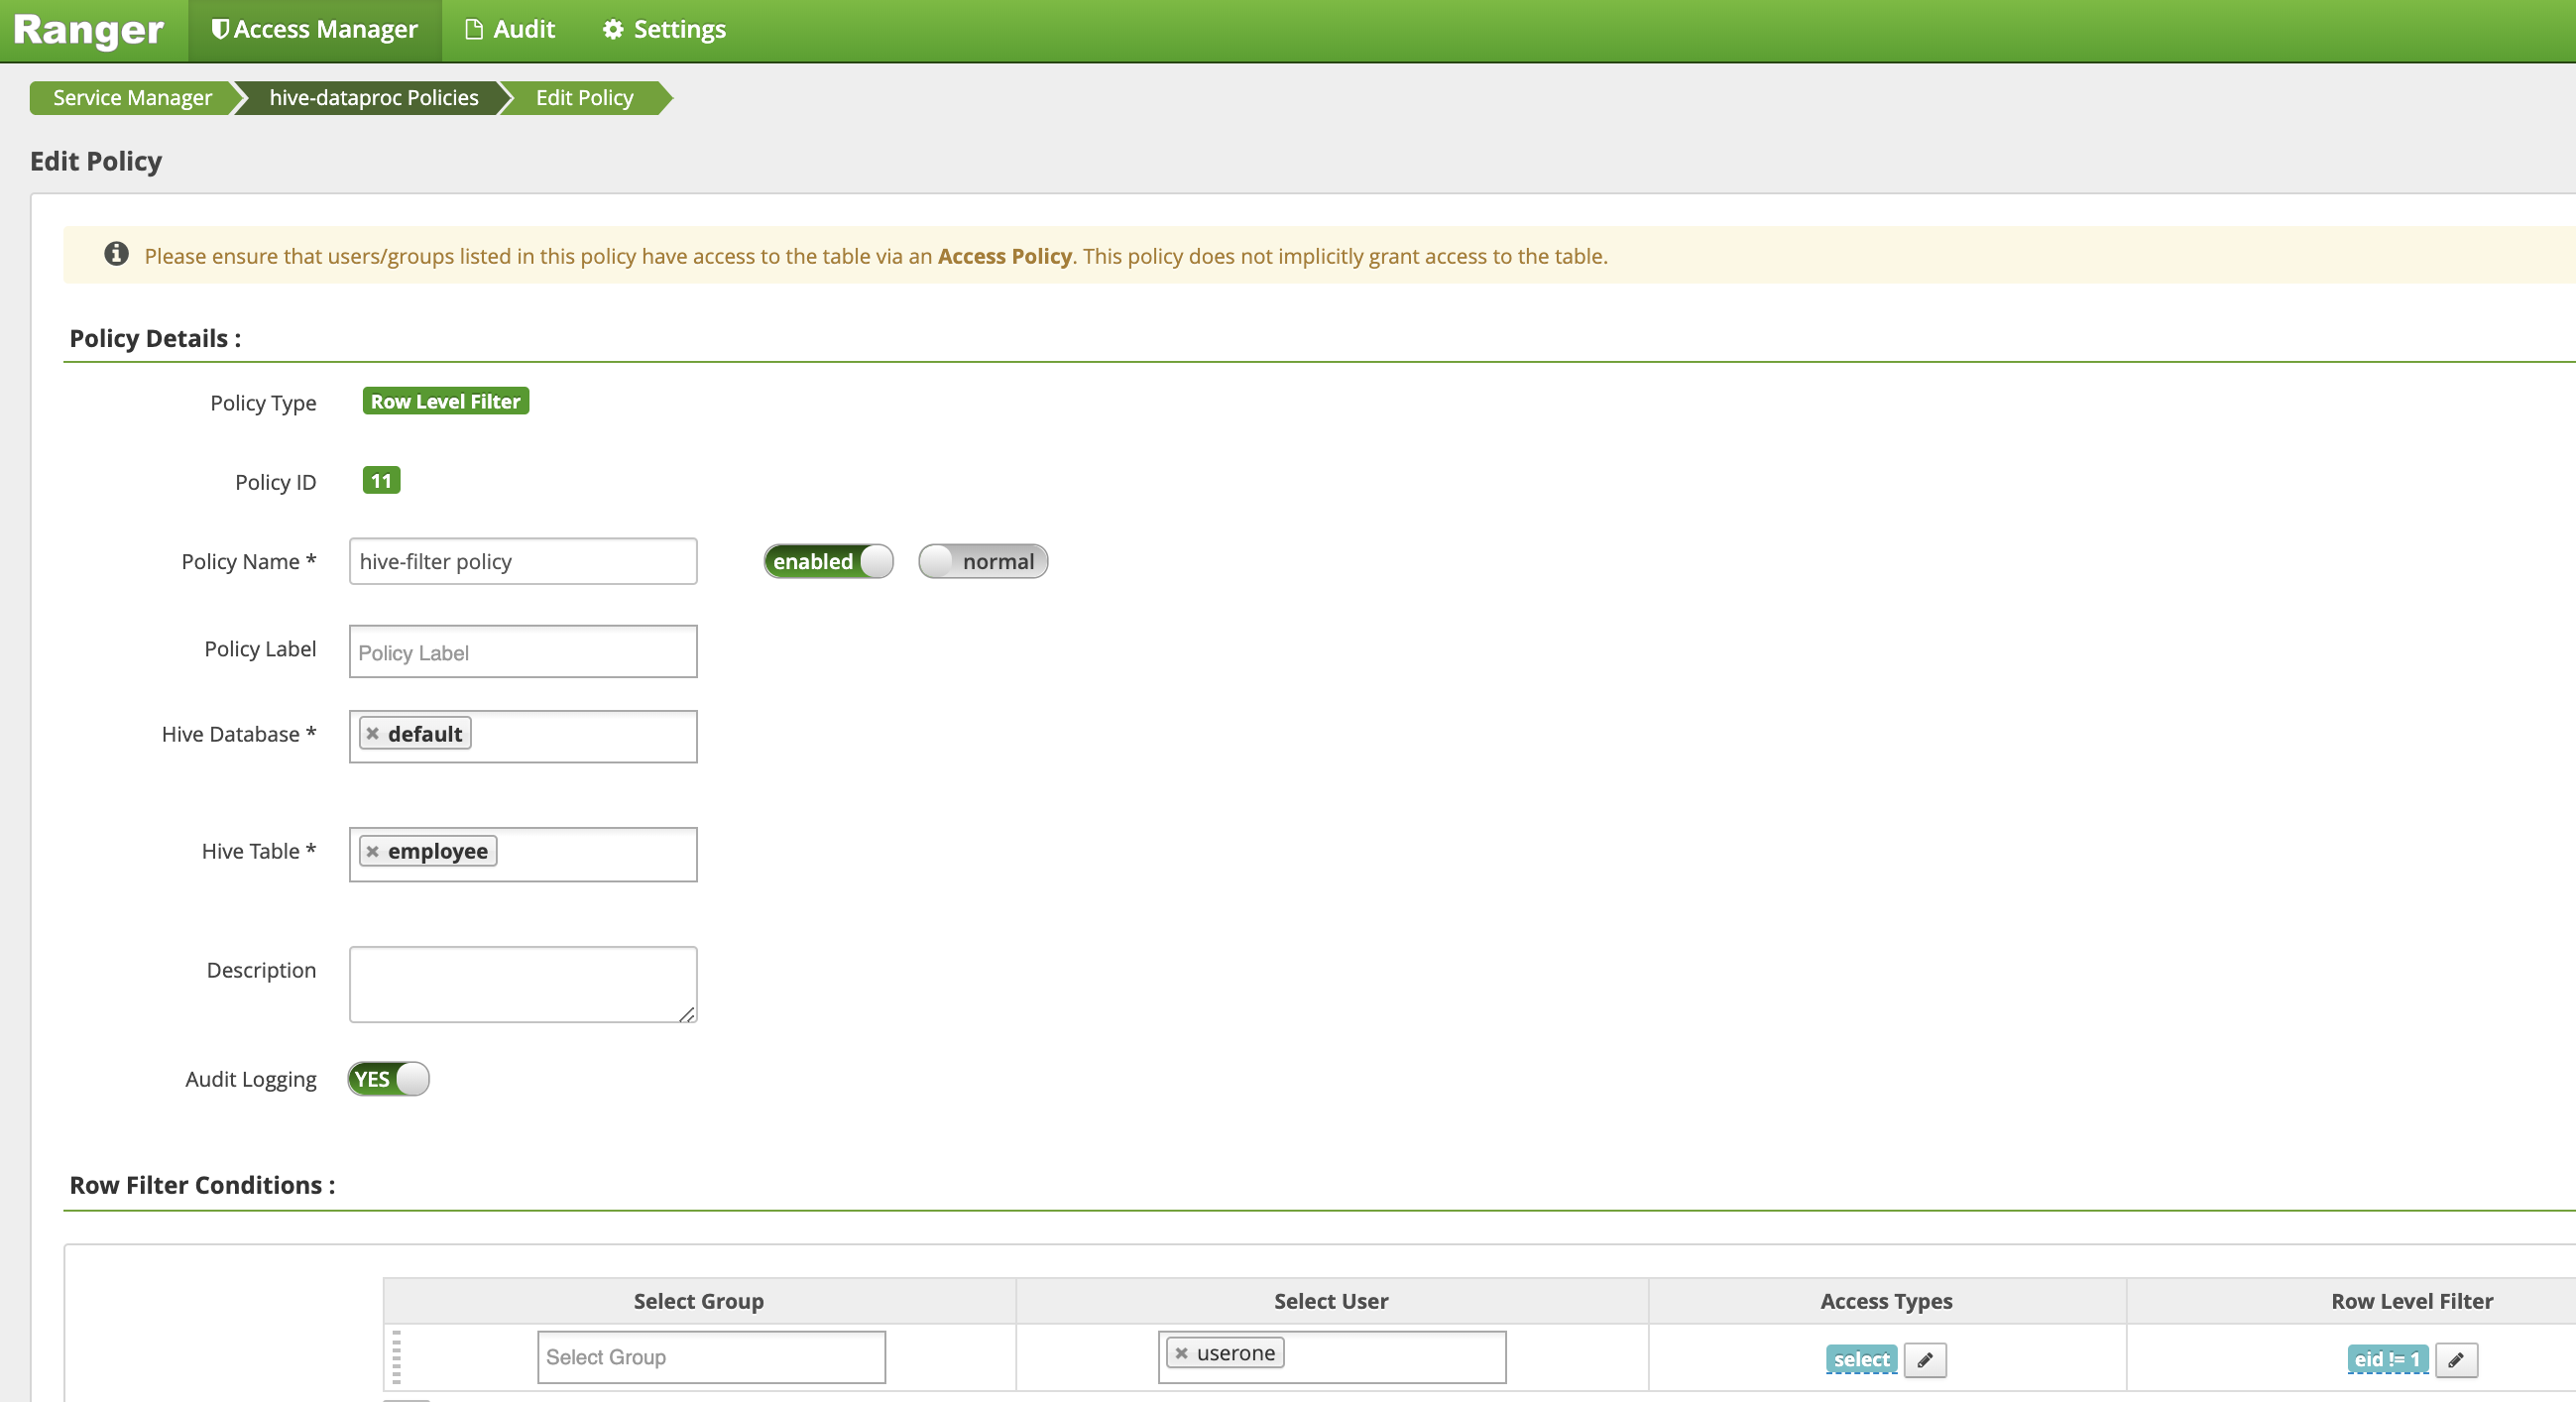
Fai clic su Aggiungi per salvare la policy.
Ripeti la query precedente dalla sessione SSH della VM master sulla tabella dei dipendenti Hive come userone:
userone@example-cluster-m:~$ beeline -u "jdbc:hive2://$(hostname -f):10000/default;principal=hive/$(hostname -f)@REALM" -e "select * from employee;"
- La query restituisce la colonna name mascherata e bob (eid=1) filtrato dai risultati:
Transaction isolation: TRANSACTION_REPEATABLE_READ
+---------------+----------------+
| employee.eid  | employee.name  |
+---------------+----------------+
| 2             | NULL           |
| 3             | NULL           |
+---------------+----------------+
2 rows selected (0.47 seconds)
- La query restituisce la colonna name mascherata e bob (eid=1) filtrato dai risultati: