


Autotuning Managed Service untuk Apache Spark memungkinkan Anda mengoptimalkan workload batch berulang untuk performa dan ketahanan tanpa konfigurasi manual. Daripada mengharuskan Anda mengevaluasi parameter Spark yang kompleks, autotuning menganalisis operasi sebelumnya (disebut cohort) dan otomatis menerapkan setelan berdasarkan praktik terbaik Spark.
Dokumen ini memberikan informasi tentang penyesuaian otomatis workload batch Managed Service untuk Apache Spark. Mengoptimalkan workload Spark untuk performa dan ketahanan dapat menjadi tantangan karena banyaknya opsi konfigurasi Spark dan sulitnya menilai dampak opsi tersebut terhadap workload. Autotuning Managed Service untuk Apache Spark memberikan alternatif untuk konfigurasi workload manual dengan menerapkan setelan konfigurasi Spark secara otomatis ke workload Spark berulang berdasarkan praktik terbaik pengoptimalan Spark dan analisis operasi workload (disebut "kohor").
Mendaftar ke autotuning Managed Service untuk Apache Spark
Untuk mendaftar akses ke rilis pratinjau penyesuaian otomatis Managed Service untuk Apache Spark yang dijelaskan di halaman ini, lengkapi dan kirimkan formulir pendaftaran Permintaan akses Pratinjau Managed Service untuk Apache Spark. Setelah formulir disetujui, project yang tercantum dalam formulir akan memiliki akses ke fitur pratinjau.
Manfaat
Autotuning Managed Service untuk Apache Spark dapat memberikan manfaat berikut:
- Pengoptimalan otomatis: Menyesuaikan konfigurasi Spark dan batch Managed Service untuk Apache Spark yang tidak efisien secara otomatis, yang dapat mempercepat runtime tugas.
- Pembelajaran historis: Belajar dari operasi berulang untuk menerapkan rekomendasi yang disesuaikan dengan workload Anda.
Kelompok penyesuaian otomatis
Penyesuaian otomatis diterapkan ke eksekusi berulang (kohor) workload batch.
Nama kelompok yang Anda tentukan saat mengirimkan workload batch mengidentifikasinya sebagai salah satu operasi berturut-turut dari workload berulang.
Penyesuaian otomatis diterapkan ke kelompok workload batch sebagai berikut:
Penyesuaian otomatis dihitung dan diterapkan ke kohor kedua dan berikutnya dari workload. Autotuning tidak diterapkan pada operasi pertama workload berulang karena autotuning Managed Service untuk Apache Spark menggunakan histori workload untuk pengoptimalan.
Penyesuaian otomatis tidak diterapkan secara surut ke workload yang sedang berjalan, tetapi hanya diterapkan ke workload yang baru dikirimkan.
Penyesuaian otomatis belajar dan meningkat seiring waktu dengan menganalisis statistik kelompok. Agar sistem dapat mengumpulkan data yang memadai, sebaiknya biarkan penyesuaian otomatis diaktifkan setidaknya selama lima kali operasi.
Nama kelompok: Praktik yang direkomendasikan adalah menggunakan nama kelompok yang membantu
mengidentifikasi jenis workload berulang. Misalnya, Anda dapat menggunakan
daily_sales_aggregation sebagai nama cohort untuk workload terjadwal yang menjalankan
tugas agregasi penjualan harian.
Skenario penyesuaian otomatis
Jika berlaku, penyesuaian otomatis akan otomatis memilih dan menjalankan
scenarios atau sasaran berikut untuk mengoptimalkan workload batch:
- Scaling: Setelan konfigurasi penskalaan otomatis Spark.
- Pengoptimalan join: Setelan konfigurasi Spark untuk mengoptimalkan performa join siaran SQL.
- Partisi shuffle: Setelan konfigurasi Spark untuk menyesuaikan partisi shuffle.
Menggunakan penyesuaian otomatis Managed Service untuk Apache Spark
Anda dapat mengaktifkan penyesuaian otomatis Managed Service untuk Apache Spark pada beban kerja batch menggunakan konsol Google Cloud , Google Cloud CLI, atau Dataproc API, atau Library Klien Cloud.
Konsol
Untuk mengaktifkan autotuning Managed Service untuk Apache Spark pada setiap pengiriman workload batch berulang, lakukan langkah-langkah berikut:
Di konsol Google Cloud , buka halaman Batches Managed Service untuk Apache Spark.
Untuk membuat workload batch, klik Create.
Di bagian Autotuning:
Klik tombol Enable untuk mengaktifkan penyesuaian otomatis untuk workload Spark.
Cohort: Isi nama cohort, yang mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang. Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, tentukan
daily_sales_aggregationsebagai nama kelompok untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian.
Isi bagian lain di halaman Create batch sesuai kebutuhan, lalu klik Submit. Untuk mengetahui informasi selengkapnya tentang kolom ini, lihat Mengirimkan workload batch.
gcloud
Untuk mengaktifkan penyesuaian otomatis Managed Service untuk Apache Spark pada setiap pengiriman workload batch berulang, jalankan perintah gcloud CLI
gcloud dataproc batches submit
berikut secara lokal di jendela terminal atau di
Cloud Shell.
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    --autotuning-scenarios=auto  \
    other arguments ...
Ganti kode berikut:
- COMMAND: jenis workload Spark, seperti
Spark,PySpark,Spark-Sql, atauSpark-R. - REGION: region tempat workload batch Anda akan dijalankan.
- COHORT: nama cohort, yang
mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang.
Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, tentukan
daily_sales_aggregationsebagai nama kelompok untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian. --autotuning-scenarios=auto: Mengaktifkan penyesuaian otomatis.
API
Untuk mengaktifkan autotuning Managed Service untuk Apache Spark pada setiap pengiriman workload batch berulang, kirimkan permintaan batches.create yang menyertakan kolom berikut:
RuntimeConfig.cohort: nama cohort, yang mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang. Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, tentukandaily_sales_aggregationsebagai nama cohort untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian.AutotuningConfig.scenarios: TentukanAUTOuntuk mengaktifkan penyesuaian otomatis pada workload batch Spark.
Contoh:
...
runtimeConfig:
  cohort: COHORT_NAME
  autotuningConfig:
    scenarios:
    - AUTO
...
Java
Sebelum mencoba contoh ini, ikuti petunjuk penyiapan Java di panduan memulai Managed Service untuk Apache Spark menggunakan library klien. Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Java Managed Service untuk Apache Spark.
Untuk melakukan autentikasi ke Managed Service untuk Apache Spark, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Untuk mengaktifkan autotuning Managed Service untuk Apache Spark pada setiap pengiriman workload batch berulang, panggil BatchControllerClient.createBatch dengan CreateBatchRequest yang menyertakan kolom berikut:
Batch.RuntimeConfig.cohort: Nama cohort, yang mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang. Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, Anda dapat menentukandaily_sales_aggregationsebagai nama kelompok untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian.Batch.RuntimeConfig.AutotuningConfig.scenarios: TentukanAUTOuntuk mengaktifkan penyesuaian otomatis pada workload batch Spark.
Contoh:
...
Batch batch =
  Batch.newBuilder()
    .setRuntimeConfig(
      RuntimeConfig.newBuilder()
        .setCohort("daily_sales_aggregation")
        .setAutotuningConfig(
          AutotuningConfig.newBuilder()
            .addScenarios(Scenario.AUTO))
    ...
  .build();

batchControllerClient.createBatch(
    CreateBatchRequest.newBuilder()
        .setParent(parent)
        .setBatchId(batchId)
        .setBatch(batch)
        .build());
...
Untuk menggunakan API, Anda harus menggunakan library klien google-cloud-dataproc versi
4.43.0 atau yang lebih baru. Anda dapat menggunakan salah satu konfigurasi berikut untuk menambahkan library ke project Anda.
Maven
<dependencies>
 <dependency>
   <groupId>com.google.cloud</groupId>
   <artifactId>google-cloud-dataproc</artifactId>
   <version>4.43.0</version>
 </dependency>
</dependencies>
Gradle
implementation 'com.google.cloud:google-cloud-dataproc:4.43.0'
SBT
libraryDependencies += "com.google.cloud" % "google-cloud-dataproc" % "4.43.0"
Python
Sebelum mencoba contoh ini, ikuti petunjuk penyiapan Python di panduan memulai Managed Service untuk Apache Spark menggunakan library klien. Untuk mengetahui informasi selengkapnya, lihat dokumentasi referensi API Python Managed Service untuk Apache Spark.
Untuk melakukan autentikasi ke Managed Service untuk Apache Spark, siapkan Kredensial Default Aplikasi. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan autentikasi untuk lingkungan pengembangan lokal.
Untuk mengaktifkan autotuning Managed Service untuk Apache Spark pada setiap pengiriman workload batch berulang, panggil BatchControllerClient.create_batch dengan Batch yang menyertakan kolom berikut:
batch.runtime_config.cohort: Nama cohort, yang mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang. Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, Anda dapat menentukandaily_sales_aggregationsebagai nama cohort untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian.batch.runtime_config.autotuning_config.scenarios: TentukanAUTOuntuk mengaktifkan penyesuaian otomatis pada workload batch Spark.
Contoh:
# Create a client
client = dataproc_v1.BatchControllerClient()

# Initialize request argument(s)
batch = dataproc_v1.Batch()
batch.pyspark_batch.main_python_file_uri = "gs://bucket/run_tpcds.py"
batch.runtime_config.cohort = "daily_sales_aggregation"
batch.runtime_config.autotuning_config.scenarios = [
    Scenario.AUTO
]

request = dataproc_v1.CreateBatchRequest(
    parent="parent_value",
    batch=batch,
)

# Make the request
operation = client.create_batch(request=request)
Untuk menggunakan API, Anda harus menggunakan library klien google-cloud-dataproc versi 5.10.1 atau yang lebih baru. Untuk menambahkannya ke project, Anda dapat menggunakan persyaratan berikut:
google-cloud-dataproc>=5.10.1
Airflow
Daripada mengirimkan setiap batch cohort yang disesuaikan secara otomatis secara manual, Anda dapat menggunakan Airflow untuk menjadwalkan pengiriman setiap workload batch berulang. Untuk melakukannya, panggil BatchControllerClient.create_batch dengan Batch yang menyertakan kolom berikut:
batch.runtime_config.cohort: Nama cohort, yang mengidentifikasi batch sebagai salah satu dari serangkaian workload berulang. Penyesuaian otomatis diterapkan ke workload kedua dan berikutnya yang dikirimkan dengan nama kelompok ini. Misalnya, Anda dapat menentukandaily_sales_aggregationsebagai nama kelompok untuk workload batch terjadwal yang menjalankan tugas agregasi penjualan harian.batch.runtime_config.autotuning_config.scenarios: TentukanAUTOuntuk mengaktifkan penyesuaian otomatis pada workload batch Spark.
Contoh:
create_batch = DataprocCreateBatchOperator(
    task_id="batch_create",
    batch={
        "pyspark_batch": {
            "main_python_file_uri": PYTHON_FILE_LOCATION,
        },
        "environment_config": {
            "peripherals_config": {
                "spark_history_server_config": {
                    "dataproc_cluster": PHS_CLUSTER_PATH,
                },
            },
        },
        "runtime_config": {
            "cohort": "daily_sales_aggregation",
            "autotuning_config": {
                "scenarios": [
                    Scenario.AUTO,
                ]
            }
        },
    },
    batch_id="BATCH_ID",
)
Untuk menggunakan API, Anda harus menggunakan library klien google-cloud-dataproc versi 5.10.1 atau yang lebih baru. Anda dapat menggunakan persyaratan lingkungan Airflow berikut:
google-cloud-dataproc>=5.10.1
Untuk mengupdate paket di Managed Service untuk Apache Airflow, lihat Menginstal dependensi Python untuk Managed Airflow .
Melihat perubahan penyesuaian otomatis
Untuk melihat perubahan autotuning Managed Service untuk Apache Spark pada workload batch, jalankan perintah gcloud dataproc batches describe.
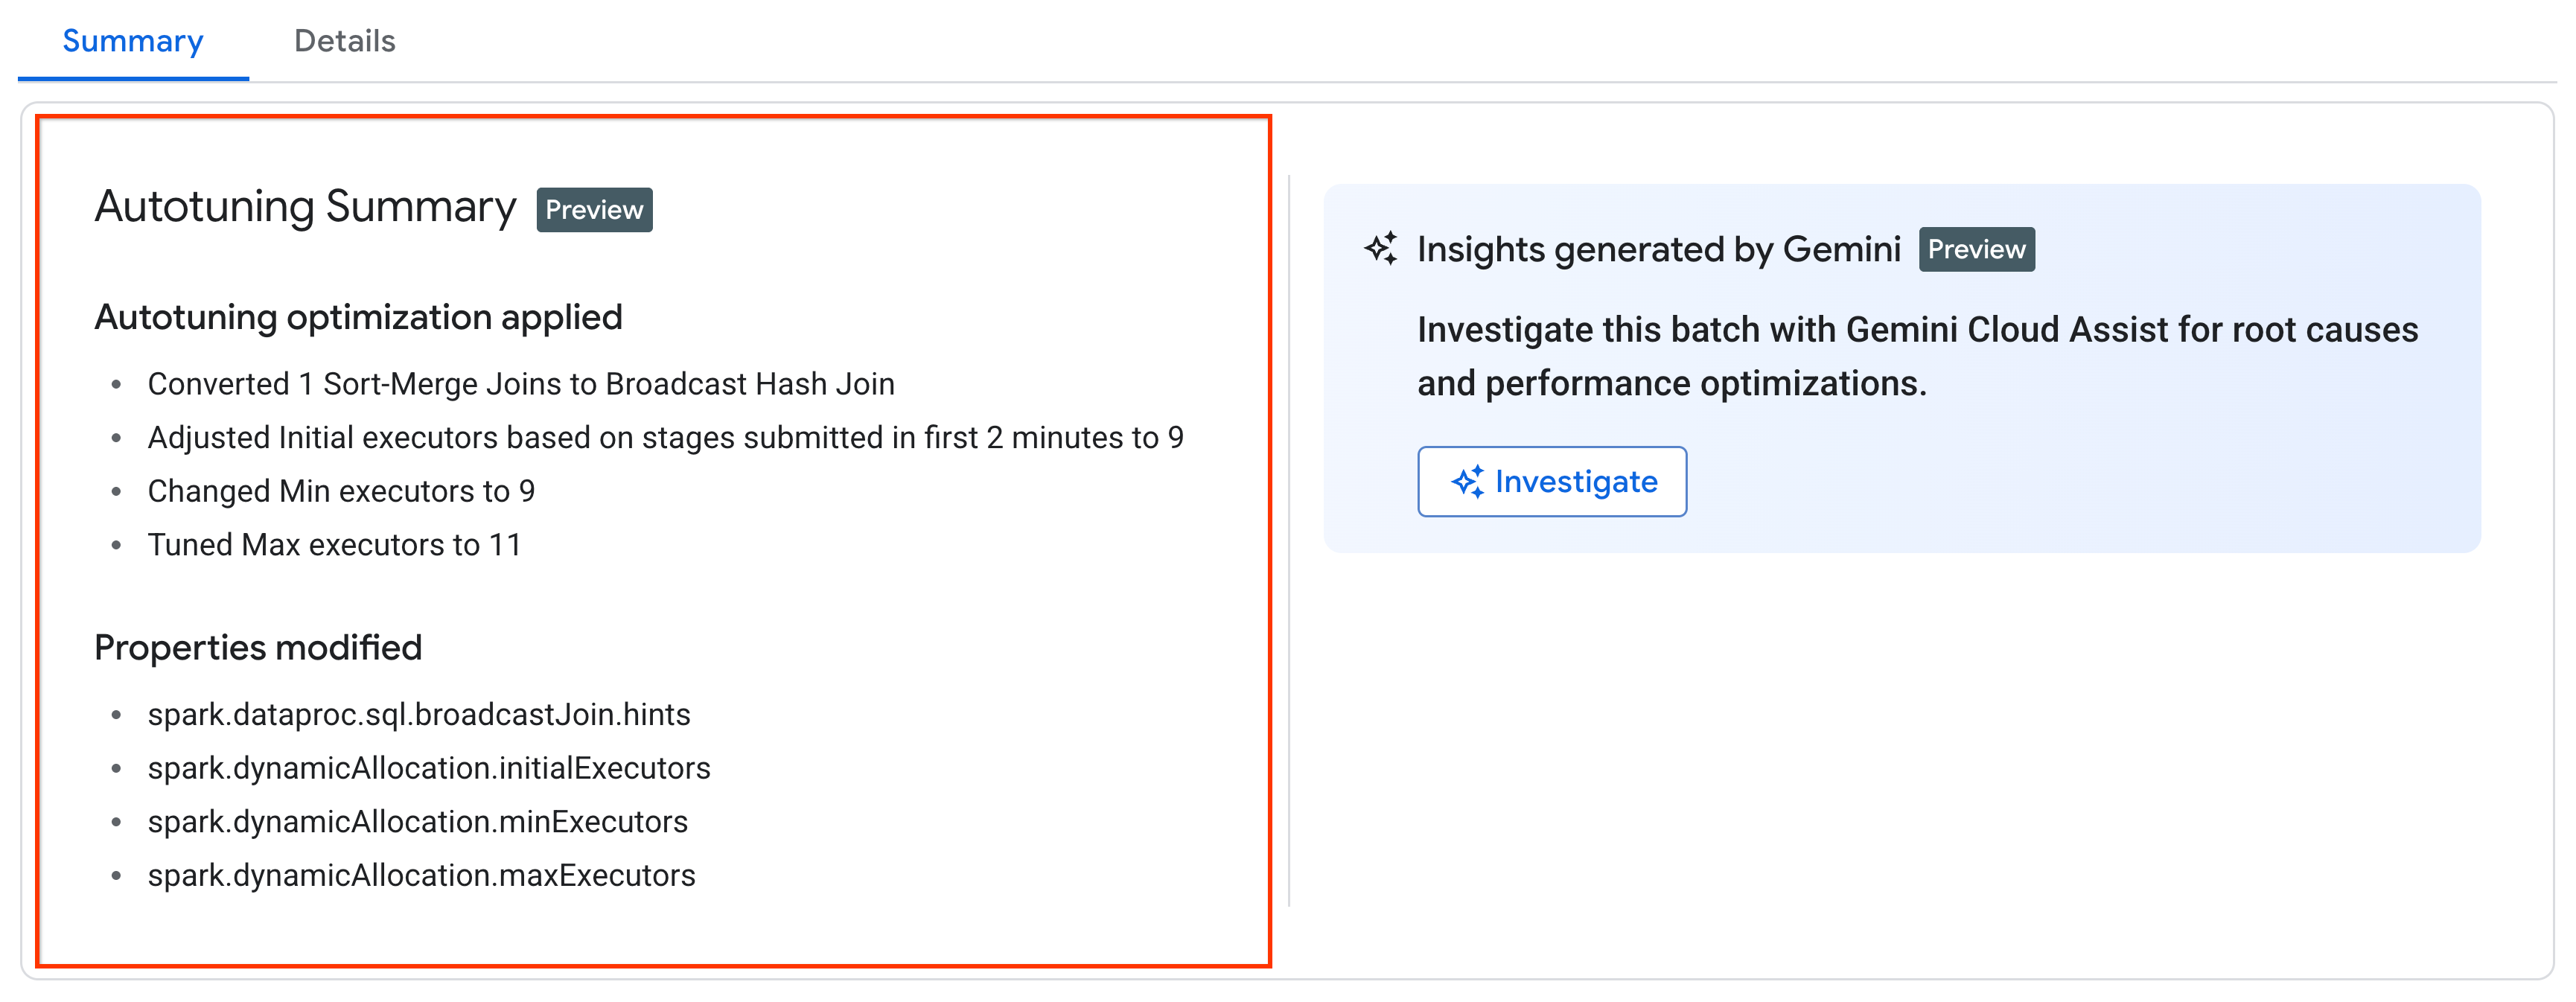
Contoh: Output gcloud dataproc batches describe mirip dengan berikut ini:
...
runtimeInfo:
  propertiesInfo:
    # Properties set by autotuning.
    autotuningProperties:
      spark.dataproc.sql.broadcastJoin.hints:
        annotation: Converted 1 Sort-Merge Joins to Broadcast Hash Join
        value: v2;Inner,<hint>
      spark.dynamicAllocation.initialExecutors:
        annotation: Adjusted Initial executors based on stages submitted in first
          2 minutes to 9
        overriddenValue: '2'
        value: '9'
      spark.dynamicAllocation.maxExecutors:
        annotation: Tuned Max executors to 11
        overriddenValue: '5'
        value: '11'
      spark.dynamicAllocation.minExecutors:
        annotation: Changed Min executors to 9
        overriddenValue: '2'
        value: '9'
...
Anda dapat melihat perubahan penyesuaian otomatis terbaru yang diterapkan pada workload yang sedang berjalan, selesai, atau gagal di halaman Batch details di konsol Google Cloud , di tab Summary.
Harga
Autotuning Managed Service untuk Apache Spark ditawarkan selama pratinjau pribadi tanpa biaya tambahan. Harga Managed Service untuk Apache Spark standar berlaku.