


Mit der automatischen Abstimmung von Managed Service for Apache Spark können Sie wiederkehrende Batcharbeitslasten ohne manuelle Konfiguration im Hinblick auf Leistung und Ausfallsicherheit optimieren. Anstatt komplexe Spark-Parameter auszuwerten, analysiert die automatische Abstimmung frühere Ausführungen (sogenannte Kohorten) und wendet automatisch Einstellungen basierend auf Best Practices für Spark an.
In diesem Dokument finden Sie Informationen zur automatischen Optimierung von Batcharbeitslasten in Managed Service for Apache Spark. Die Optimierung einer Spark-Arbeitslast im Hinblick auf Leistung und Ausfallsicherheit kann aufgrund der Anzahl der Spark-Konfigurationsoptionen und der Schwierigkeit, die Auswirkungen dieser Optionen auf eine Arbeitslast zu bewerten, eine Herausforderung sein. Das Autotuning von Managed Service for Apache Spark bietet eine Alternative zur manuellen Konfiguration von Arbeitslasten. Dabei werden Spark-Konfigurationseinstellungen automatisch auf eine wiederkehrende Spark-Arbeitslast angewendet. Dies basiert auf Best Practices für die Spark-Optimierung und einer Analyse von Arbeitslastausführungen (sogenannten „Kohorten“).
Für die automatische Optimierung von Managed Service for Apache Spark registrieren
Wenn Sie sich für den Zugriff auf die Vorabversion des automatischen Tunings von Managed Service for Apache Spark registrieren möchten, die auf dieser Seite beschrieben wird, füllen Sie das Anfrageformular für den Zugriff auf die Vorabversion von Managed Service for Apache Spark aus und senden Sie es ab. Nachdem das Formular genehmigt wurde, haben die im Formular aufgeführten Projekte Zugriff auf die Funktionen in der Vorabversion.
Vorteile
Die automatische Abstimmung von Managed Service for Apache Spark bietet die folgenden Vorteile:
- Automatische Optimierung: Ineffiziente Managed Service for Apache Spark-Batch- und Spark-Konfigurationen werden automatisch optimiert, was die Joblaufzeiten verkürzen kann.
- Historisches Lernen: Aus wiederkehrenden Ausführungen lernen, um Empfehlungen anzuwenden, die auf Ihre Arbeitslast zugeschnitten sind.
Autotuning-Kohorten
Die automatische Abstimmung wird auf wiederkehrende Ausführungen (Kohorten) einer Batcharbeitslast angewendet.
Der Kohortenname, den Sie beim Senden einer Batcharbeitslast angeben, identifiziert sie als eine der aufeinanderfolgenden Ausführungen der wiederkehrenden Arbeitslast.
Die automatische Abstimmung wird auf Batcharbeitslast-Kohorten so angewendet:
Die automatische Abstimmung wird für die zweite und nachfolgende Kohorten einer Arbeitslast berechnet und angewendet. Die automatische Optimierung wird nicht auf die erste Ausführung einer wiederkehrenden Arbeitslast angewendet, da die automatische Optimierung von Managed Service for Apache Spark den Verlauf der Arbeitslast für die Optimierung verwendet.
Die automatische Abstimmung wird nicht rückwirkend auf laufende Arbeitslasten angewendet, sondern nur auf neu eingereichte Arbeitslasten.
Die automatische Abstimmung lernt und verbessert sich im Laufe der Zeit durch die Analyse der Kohortenstatistiken. Damit das System genügend Daten erfassen kann, empfehlen wir, die automatische Abstimmung für mindestens fünf Ausführungen aktiviert zu lassen.
Kohortennamen: Es wird empfohlen, Kohortennamen zu verwenden, mit denen sich der wiederkehrende Arbeitslasttyp identifizieren lässt. Sie können beispielsweise daily_sales_aggregation als Kohortenname für eine geplante Arbeitslast verwenden, die eine tägliche Aufgabe zur Umsatzaggregation ausführt.
Szenarien für die automatische Abstimmung
Falls zutreffend, werden beim Autotuning automatisch die folgenden scenarios oder Ziele ausgewählt und ausgeführt, um eine Batcharbeitslast zu optimieren:
- Skalierung: Konfigurationseinstellungen für das Autoscaling von Spark.
- Join-Optimierung: Spark-Konfigurationseinstellungen zur Optimierung der Leistung von SQL-Broadcast-Joins.
- Shuffle-Partitionen: Spark-Konfigurationseinstellungen zum Optimieren von Shuffle-Partitionen.
Autotuning von Managed Service for Apache Spark verwenden
Sie können die automatische Abstimmung von Managed Service for Apache Spark für eine Batch-Arbeitslast über die Google Cloud Console, die Google Cloud CLI, die Dataproc API oder die Cloud-Clientbibliotheken aktivieren.
Console
So aktivieren Sie die automatische Optimierung von Managed Service for Apache Spark bei jeder Übermittlung einer wiederkehrenden Batcharbeitslast:
Rufen Sie in der Google Cloud Console die Seite Batches für Managed Service for Apache Spark auf.
Klicken Sie auf Erstellen, um eine Batch-Arbeitslast zu erstellen.
Im Abschnitt Autotuning:
Klicken Sie auf den Ein/Aus-Button Aktivieren, um die automatische Abstimmung für die Spark-Arbeitslast zu aktivieren.
Kohorte: Geben Sie den Namen der Kohorte ein, die den Batch als Teil einer Reihe wiederkehrender Arbeitslasten identifiziert. Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Geben Sie beispielsweise
daily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast an, die eine tägliche Verkaufsaggregationsaufgabe ausführt.
Füllen Sie nach Bedarf die anderen Abschnitte der Seite Batch erstellen aus und klicken Sie dann auf Senden. Weitere Informationen zu diesen Feldern finden Sie unter Batcharbeitslast senden.
gcloud
Wenn Sie die automatische Optimierung von Managed Service for Apache Spark bei jeder Übermittlung einer wiederkehrenden Batcharbeitslast aktivieren möchten, führen Sie den folgenden gcloud CLI-Befehl gcloud dataproc batches submit lokal in einem Terminalfenster oder in Cloud Shell aus.
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    --autotuning-scenarios=auto  \
    other arguments ...
Ersetzen Sie Folgendes:
- COMMAND: der Spark-Arbeitslasttyp, z. B.
Spark,PySpark,Spark-SqloderSpark-R. - REGION: die Region, in der Ihre Batcharbeitslast ausgeführt wird.
- COHORT: Der Name der Kohorte, die den Batch als eine von mehreren wiederkehrenden Arbeitslasten identifiziert.
Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Geben Sie beispielsweise
daily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast an, die eine tägliche Verkaufsaggregationsaufgabe ausführt. --autotuning-scenarios=auto: Autotuning aktivieren.
API
Wenn Sie die automatische Optimierung von Managed Service for Apache Spark bei jeder Übermittlung einer wiederkehrenden Batcharbeitslast aktivieren möchten, senden Sie eine batches.create-Anfrage mit den folgenden Feldern:
RuntimeConfig.cohort: Der Name der Kohorte, die den Batch als eine von mehreren wiederkehrenden Arbeitslasten identifiziert. Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Geben Sie beispielsweisedaily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast an, die eine tägliche Verkaufsaggregationsaufgabe ausführt.AutotuningConfig.scenarios: Geben SieAUTOan, um die automatische Abstimmung für die Spark-Batcharbeitslast zu aktivieren.
Beispiel:
...
runtimeConfig:
  cohort: COHORT_NAME
  autotuningConfig:
    scenarios:
    - AUTO
...
Java
Bevor Sie dieses Beispiel ausprobieren, folgen Sie der Einrichtungsanleitung für Java in der Kurzanleitung für Managed Service for Apache Spark mit Clientbibliotheken. Weitere Informationen finden Sie in der API-Referenzdokumentation zu Managed Service for Apache Spark für Java.
Richten Sie zur Authentifizierung bei Managed Service for Apache Spark die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Wenn Sie die automatische Optimierung von Managed Service for Apache Spark bei jeder Übermittlung einer wiederkehrenden Batcharbeitslast aktivieren möchten, rufen Sie BatchControllerClient.createBatch mit einer CreateBatchRequest auf, die die folgenden Felder enthält:
Batch.RuntimeConfig.cohort: Der Name der Kohorte, der den Batch als Teil einer Reihe wiederkehrender Arbeitslasten identifiziert. Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Sie können beispielsweisedaily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast angeben, die eine tägliche Verkaufsaggregationsaufgabe ausführt.Batch.RuntimeConfig.AutotuningConfig.scenarios: Geben SieAUTOan, um die automatische Abstimmung für die Spark-Batcharbeitslast zu aktivieren.
Beispiel:
...
Batch batch =
  Batch.newBuilder()
    .setRuntimeConfig(
      RuntimeConfig.newBuilder()
        .setCohort("daily_sales_aggregation")
        .setAutotuningConfig(
          AutotuningConfig.newBuilder()
            .addScenarios(Scenario.AUTO))
    ...
  .build();

batchControllerClient.createBatch(
    CreateBatchRequest.newBuilder()
        .setParent(parent)
        .setBatchId(batchId)
        .setBatch(batch)
        .build());
...
Wenn Sie die API verwenden möchten, müssen Sie die google-cloud-dataproc-Clientbibliothek in der Version 4.43.0 oder höher verwenden. Sie können eine der folgenden Konfigurationen verwenden, um die Bibliothek Ihrem Projekt hinzuzufügen.
Maven
<dependencies>
 <dependency>
   <groupId>com.google.cloud</groupId>
   <artifactId>google-cloud-dataproc</artifactId>
   <version>4.43.0</version>
 </dependency>
</dependencies>
Gradle
implementation 'com.google.cloud:google-cloud-dataproc:4.43.0'
SBT
libraryDependencies += "com.google.cloud" % "google-cloud-dataproc" % "4.43.0"
Python
Bevor Sie dieses Beispiel ausprobieren, folgen Sie der Einrichtungsanleitung für Python in der Kurzanleitung für Managed Service for Apache Spark mit Clientbibliotheken. Weitere Informationen finden Sie in der API-Referenzdokumentation zu Managed Service for Apache Spark für Python.
Richten Sie zur Authentifizierung bei Managed Service for Apache Spark die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Wenn Sie die automatische Optimierung von Managed Service for Apache Spark bei jeder Übermittlung einer wiederkehrenden Batcharbeitslast aktivieren möchten, rufen Sie BatchControllerClient.create_batch mit einem Batch auf, der die folgenden Felder enthält:
batch.runtime_config.cohort: Der Name der Kohorte, der den Batch als Teil einer Reihe wiederkehrender Arbeitslasten identifiziert. Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Sie können beispielsweisedaily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast angeben, die eine tägliche Verkaufsaggregationsaufgabe ausführt.batch.runtime_config.autotuning_config.scenarios: Geben SieAUTOan, um die automatische Abstimmung für die Spark-Batcharbeitslast zu aktivieren.
Beispiel:
# Create a client
client = dataproc_v1.BatchControllerClient()

# Initialize request argument(s)
batch = dataproc_v1.Batch()
batch.pyspark_batch.main_python_file_uri = "gs://bucket/run_tpcds.py"
batch.runtime_config.cohort = "daily_sales_aggregation"
batch.runtime_config.autotuning_config.scenarios = [
    Scenario.AUTO
]

request = dataproc_v1.CreateBatchRequest(
    parent="parent_value",
    batch=batch,
)

# Make the request
operation = client.create_batch(request=request)
Wenn Sie die API verwenden möchten, müssen Sie die google-cloud-dataproc-Clientbibliothek in der Version 5.10.1 oder höher verwenden. Wenn Sie es Ihrem Projekt hinzufügen möchten, können Sie die folgende Anforderung verwenden:
google-cloud-dataproc>=5.10.1
Airflow
Anstatt jede automatisch abgestimmte Batchkohorte manuell einzureichen, können Sie Airflow verwenden, um die Einreichung jeder wiederkehrenden Batcharbeitslast zu planen. Rufen Sie dazu BatchControllerClient.create_batch mit einem Batch auf, der die folgenden Felder enthält:
batch.runtime_config.cohort: Der Name der Kohorte, der den Batch als Teil einer Reihe wiederkehrender Arbeitslasten identifiziert. Die automatische Abstimmung wird auf die zweite und nachfolgende Arbeitslasten angewendet, die mit diesem Kohortennamen gesendet werden. Sie können beispielsweisedaily_sales_aggregationals Kohortenname für eine geplante Batcharbeitslast angeben, die eine tägliche Verkaufsaggregationsaufgabe ausführt.batch.runtime_config.autotuning_config.scenarios: Geben SieAUTOan, um die automatische Abstimmung für die Spark-Batcharbeitslast zu aktivieren.
Beispiel:
create_batch = DataprocCreateBatchOperator(
    task_id="batch_create",
    batch={
        "pyspark_batch": {
            "main_python_file_uri": PYTHON_FILE_LOCATION,
        },
        "environment_config": {
            "peripherals_config": {
                "spark_history_server_config": {
                    "dataproc_cluster": PHS_CLUSTER_PATH,
                },
            },
        },
        "runtime_config": {
            "cohort": "daily_sales_aggregation",
            "autotuning_config": {
                "scenarios": [
                    Scenario.AUTO,
                ]
            }
        },
    },
    batch_id="BATCH_ID",
)
Wenn Sie die API verwenden möchten, müssen Sie die google-cloud-dataproc-Clientbibliothek in der Version 5.10.1 oder höher verwenden. Sie können die folgende Anforderung für die Airflow-Umgebung verwenden:
google-cloud-dataproc>=5.10.1
Informationen zum Aktualisieren des Pakets in Managed Service for Apache Airflow finden Sie unter Python-Abhängigkeiten für Managed Airflow installieren .
Autotuning-Änderungen ansehen
Wenn Sie die Änderungen der automatischen Optimierung von Managed Service for Apache Spark an einer Batcharbeitslast aufrufen möchten, führen Sie den Befehl gcloud dataproc batches describe aus.
Beispiel: Die Ausgabe von gcloud dataproc batches describe sieht in etwa so aus:
...
runtimeInfo:
  propertiesInfo:
    # Properties set by autotuning.
    autotuningProperties:
      spark.dataproc.sql.broadcastJoin.hints:
        annotation: Converted 1 Sort-Merge Joins to Broadcast Hash Join
        value: v2;Inner,<hint>
      spark.dynamicAllocation.initialExecutors:
        annotation: Adjusted Initial executors based on stages submitted in first
          2 minutes to 9
        overriddenValue: '2'
        value: '9'
      spark.dynamicAllocation.maxExecutors:
        annotation: Tuned Max executors to 11
        overriddenValue: '5'
        value: '11'
      spark.dynamicAllocation.minExecutors:
        annotation: Changed Min executors to 9
        overriddenValue: '2'
        value: '9'
...
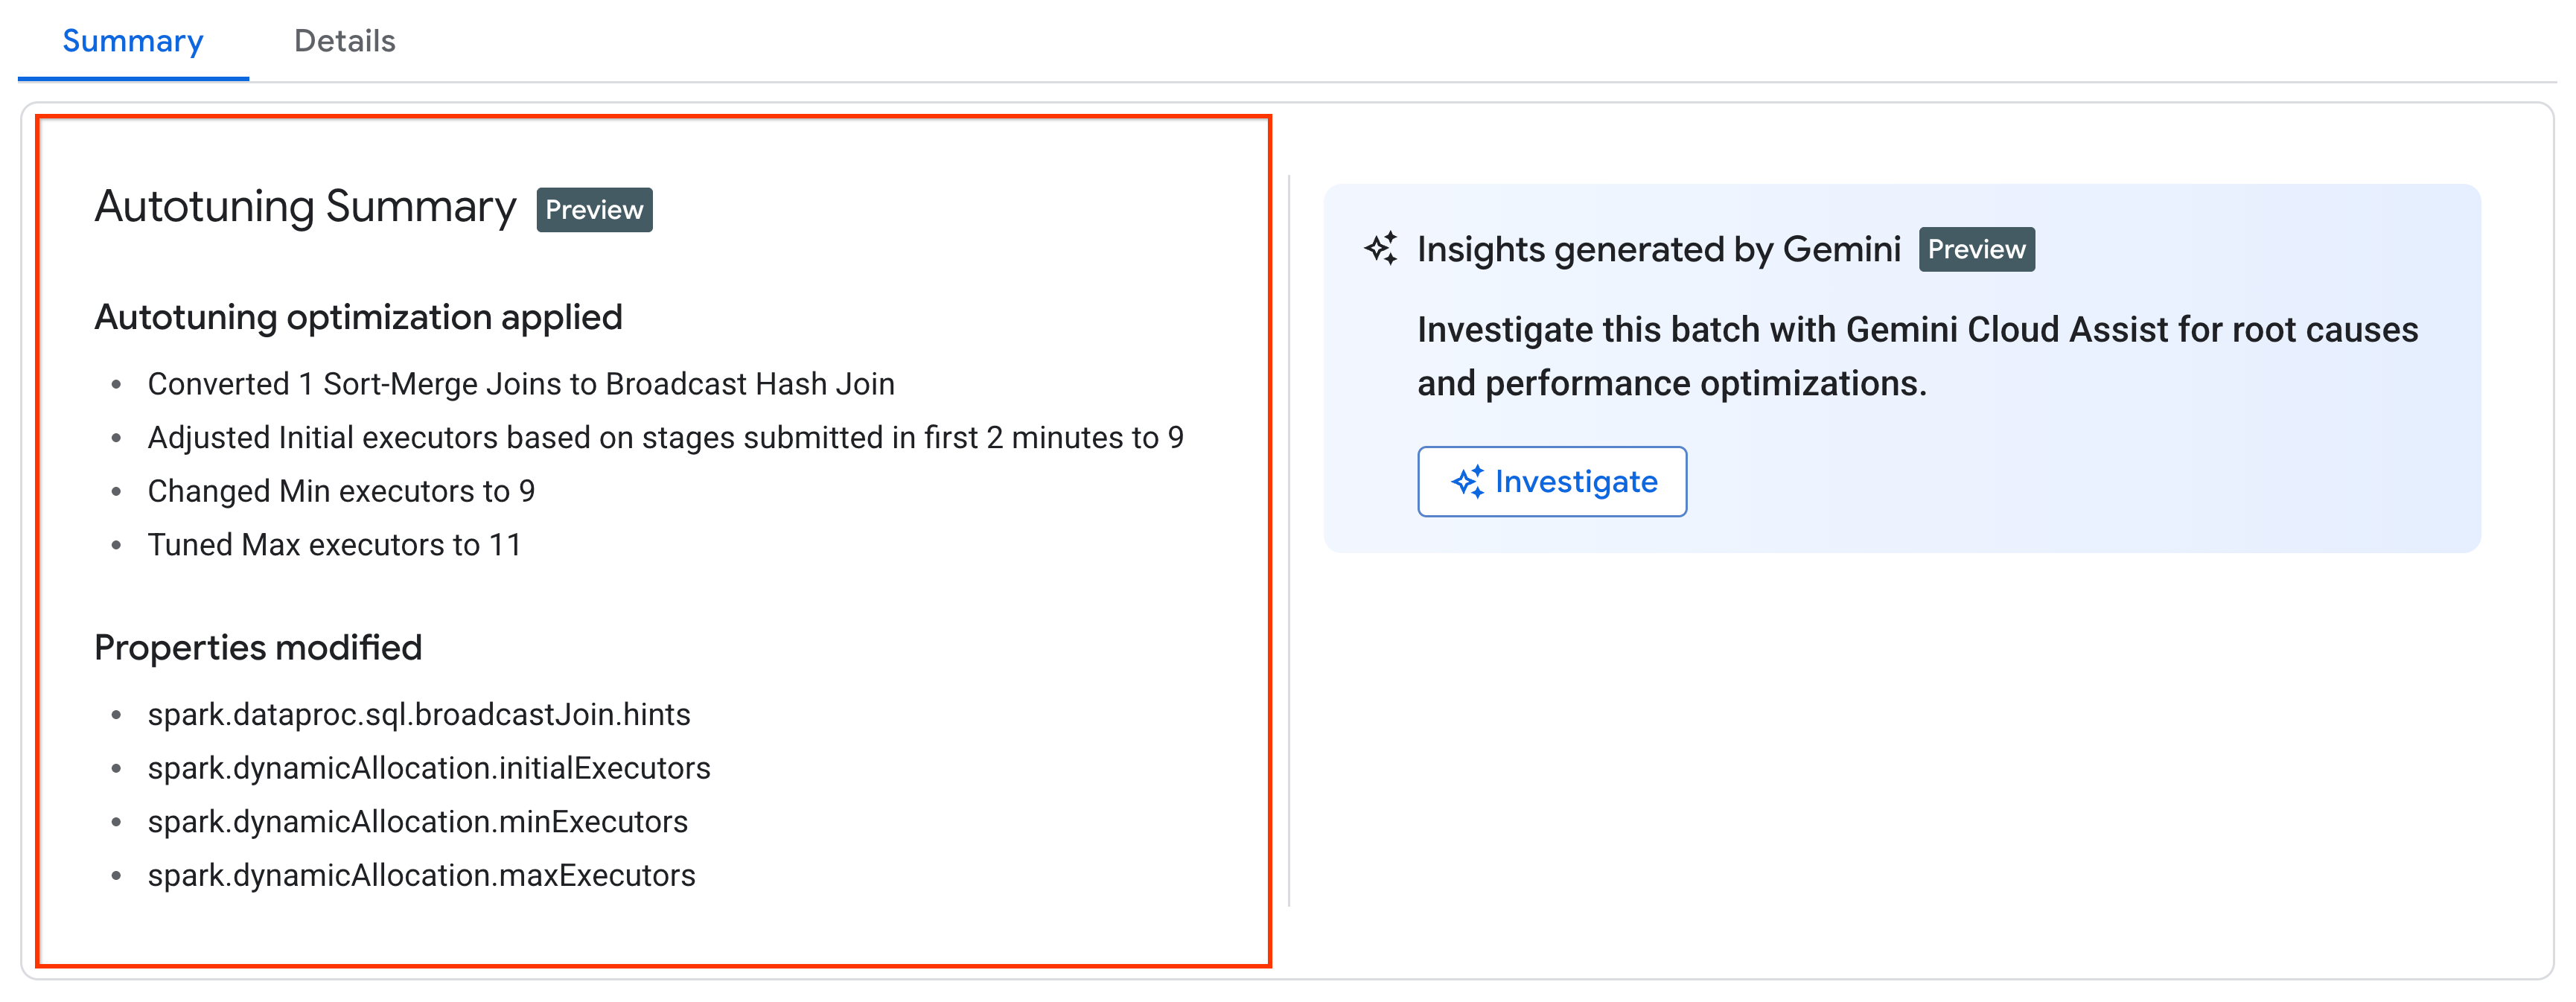
Sie können die neuesten Autotuning-Änderungen, die auf eine laufende, abgeschlossene oder fehlgeschlagene Arbeitslast angewendet wurden, in der Google Cloud Console auf der Seite Batchdetails auf dem Tab Zusammenfassung ansehen.
Preise
Die automatische Abstimmung für Managed Service for Apache Spark wird während der privaten Vorschau ohne zusätzliche Kosten angeboten. Es gelten die Standardpreise für Managed Service for Apache Spark.