


טבלאות נגזרות פותחות עולם של אפשרויות ניתוח מתקדמות, אבל יכול להיות קשה לגשת אליהן, להטמיע אותן ולפתור בהן בעיות. המדריך הזה מכיל את התרחישים הנפוצים ביותר לשימוש בטבלאות נגזרות ב-Looker.
הדף הזה מכיל את הדוגמאות הבאות:
- בניית טבלה בכל יום בשעה 3:00
- הוספת נתונים חדשים לטבלה גדולה
- שימוש בפונקציות אנליטיות (window functions) ב-SQL
- יצירת עמודות נגזרות לערכים מחושבים
- שיטות אופטימיזציה
- שימוש ב-PDT לבדיקת אופטימיזציות
UNIONשתי טבלאות- חישוב סכום של סכום (הפיכת מדד למאפיין)
- טבלאות סיכום עם מוּדעוּת לצבירת נתונים
מקורות מידע על טבלאות נגזרות
ההנחה במדריכים האלה היא שיש לכם הבנה בסיסית ב-LookML ובטבלאות נגזרות. אתם צריכים לדעת איך ליצור תצוגות ולערוך את קובץ המודל. אם אתם רוצים לרענן את הזיכרון לגבי אחד מהנושאים האלה, אתם יכולים לעיין במקורות המידע הבאים:
- טבלאות נגזרות
- מונחים ומושגים ב-LookML
- יצירת טבלאות נגזרות מבוססות LookML
- חומרי עזר בנושא פרמטרים של
derived_table - שמירת שאילתות במטמון ובנייה מחדש של טבלאות PDT באמצעות קבוצות נתונים
יצירת טבלה כל יום ב-3:00
בדוגמה הזו, הנתונים מגיעים כל יום בשעה 02:00. התוצאות של שאילתה על הנתונים האלה יהיו זהות, גם אם היא תופעל ב-3:00 וגם אם היא תופעל ב-21:00. לכן, הגיוני לבנות את הטבלה פעם ביום ולאפשר למשתמשים לשלוף תוצאות מהמטמון.
אם תכללו את קבוצת הנתונים בקובץ המודל, תוכלו להשתמש בה שוב בכמה טבלאות וניתוחים. קבוצת הנתונים הזו מכילה פרמטר sql_trigger_value שמציין לקבוצת הנתונים מתי להפעיל ולבנות מחדש את הטבלה הנגזרת.
דוגמאות נוספות לביטויים של טריגרים מופיעות במאמרי העזרה של sql_trigger_value.
## in the model file

datagroup: standard_data_load {
  sql_trigger_value: SELECT FLOOR(((TIMESTAMP_DIFF(CURRENT_TIMESTAMP(),'1970-01-01 00:00:00',SECOND)) - 60*60*3)/(60*60*24)) ;;
  max_cache_age: "24 hours"
}

explore: orders {
…
מוסיפים את הפרמטר datagroup_trigger להגדרה של derived_table בקובץ התצוגה, ומציינים את השם של קבוצת הנתונים שבה רוצים להשתמש. בדוגמה הזו, קבוצת הנתונים היא standard_data_load.
view: orders {
 derived_table: {
  indexes: ["id"]
  datagroup_trigger: standard_data_load
    sql:
      SELECT
        user_id,
        id,
        created_at,
        status
      FROM
        demo_db.orders
      GROUP BY
        user_id ;;
    }

…
}
הוספת נתונים חדשים לטבלה גדולה
טבלת PDT מצטברת היא טבלה נגזרת מתמידה ש-Looker יוצר על ידי הוספת נתונים חדשים לטבלה, במקום ליצור מחדש את הטבלה כולה.
הדוגמה הבאה מבוססת על הדוגמה של הטבלה orders, כדי להראות איך הטבלה נבנית באופן מצטבר. נתוני הזמנות חדשים מגיעים כל יום, ואפשר להוסיף אותם לטבלה הקיימת כשמוסיפים פרמטר increment_key ופרמטר increment_offset.
view: orders {
 derived_table: {
    indexes: ["id"]
    increment_key: "created_at"
    increment_offset: 3
    datagroup_trigger: standard_data_load
    distribution_style: all
    sql:
      SELECT
        user_id,
        id,
        created_at,
        status
      FROM
        demo_db.orders
      GROUP BY
        user_id ;;
    }

  dimension: id {
    primary_key: yes
    type: number
    sql: ${TABLE}.id ;;  }

…
}
הערך של increment_key מוגדר כ-created_at, שהוא מרווח הזמן שבו צריך לשלוח שאילתה על נתונים עדכניים ולהוסיף אותם ל-PDT בדוגמה הזו.
הערך של increment_offset מוגדר כ-3 כדי לציין את מספר התקופות הקודמות (ברמת הפירוט של מפתח ההגדלה) שנבנות מחדש כדי להביא בחשבון נתונים שהגיעו באיחור.
שימוש בפונקציות אנליטיות (window functions) ב-SQL
חלק מהדיאלקטים של מסדי נתונים תומכים בפונקציות אנליטיות, במיוחד כדי ליצור מספרים סידוריים, מפתחות ראשיים, סכומים מצטברים וחישובים שימושיים אחרים של כמה שורות. אחרי שהשאילתה הראשית מופעלת, כל ההצהרות של derived_column מופעלות במעבר נפרד.
אם הניב של מסד הנתונים תומך בפונקציות אנליטיות (window functions), אתם יכולים להשתמש בהן בטבלה הנגזרת מבוססת LookML. יוצרים פרמטר derived_column עם פרמטר sql שמכיל את הפונקציה האנליטית. כשמתייחסים לערכים, צריך להשתמש בשם העמודה כפי שהוגדר בטבלה הנגזרת מבוססת LookML (NDT).
בדוגמה הבאה אפשר לראות איך יוצרים טבלה נגזרת מבוססת LookML שכוללת את העמודות user_id, order_id ו-created_time. לאחר מכן, משתמשים בעמודה נגזרת עם פונקציה אנליטית (window function) של SQL ROW_NUMBER() כדי לחשב עמודה שמכילה את המספר הסידורי של הזמנת הלקוח.
view: user_order_sequences {
  derived_table: {
    explore_source: order_items {
      column: user_id {
        field: order_items.user_id
      }
      column: order_id {
        field: order_items.order_id
      }
      column: created_time {
        field: order_items.created_time
      }
      derived_column: user_sequence {
        sql: ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY created_time) ;;
      }
    }
  }
  dimension: order_id {
    hidden: yes
  }
  dimension: user_sequence {
    type: number
  }
}
יצירת עמודות נגזרות לערכים מחושבים
אפשר להוסיף פרמטרים של derived_column כדי לציין עמודות שלא קיימות ב-Explore של הפרמטר explore_source. לכל פרמטר derived_column יש פרמטר sql שמציין איך ליצור את הערך.
בחישוב של sql אפשר להשתמש בכל העמודות שציינתם באמצעות הפרמטרים של column. עמודות נגזרות לא יכולות לכלול פונקציות צבירה, אבל הן יכולות לכלול חישובים שאפשר לבצע בשורה אחת בטבלה.
בדוגמה הזו נוצרת עמודה של average_customer_order, שמחושבת לפי העמודות lifetime_customer_value ו-lifetime_number_of_orders בטבלה הנגזרת מבוססת LookML.
view: user_order_facts {
  derived_table: {
    explore_source: order_items {
      column: user_id {
        field: users.id
      }
      column: lifetime_number_of_orders {
        field: order_items.count
      }
      column: lifetime_customer_value {
        field: order_items.total_profit
      }
      derived_column: average_customer_order {
        sql:  lifetime_customer_value / lifetime_number_of_orders ;;
      }
    }
  }

  dimension: user_id {
    hidden: yes
  }
  dimension: lifetime_number_of_orders {
    type: number
  }
  dimension: lifetime_customer_value {
    type: number
  }
  dimension: average_customer_order {
    type: number
  }
}
אסטרטגיות אופטימיזציה
טבלאות PDT מאוחסנות במסד הנתונים, ולכן כדאי לבצע אופטימיזציה שלהן באמצעות השיטות הבאות, בהתאם לניב הנתמך:
לדוגמה, כדי להוסיף עקביות, אפשר להגדיר את ה-PDT כך שייבנה מחדש כשקבוצת הנתונים orders_datagroup מופעלת, ואז להוסיף אינדקסים גם ב-customer_id וגם ב-first_order, כמו שמוצג בהמשך:
view: customer_order_summary {
  derived_table: {
    explore_source: orders {
      ...
    }
    datagroup_trigger: orders_datagroup
    indexes: ["customer_id", "first_order"]
  }
}
אם לא תוסיפו אינדקס (או מקבילה לניב שלכם), Looker יזהיר אתכם שצריך לעשות זאת כדי לשפר את ביצועי השאילתות.
שימוש ב-PDT כדי לבדוק אופטימיזציות
אתם יכולים להשתמש ב-PDT כדי לבדוק אפשרויות שונות של הוספה לאינדקס, הפצה ואופטימיזציה אחרת, בלי להזדקק לתמיכה רבה ממנהל מסד הנתונים או ממפתחי ה-ETL.
נניח שיש לכם טבלה ואתם רוצים לבדוק אינדקסים שונים. ה-LookML הראשוני של התצוגה עשוי להיראות כך:
view: customer {
  sql_table_name: warehouse.customer ;;
}
כדי לבדוק אסטרטגיות אופטימיזציה, אתם יכולים להשתמש בפרמטר indexes כדי להוסיף אינדקסים ל-LookML, כמו שמוצג בהמשך:
view: customer {
  # sql_table_name: warehouse.customer
  derived_table: {
    sql: SELECT * FROM warehouse.customer ;;
    persist_for: "8 hours"
    indexes: [customer_id, customer_name, salesperson_id]
  }
}
מריצים שאילתה על התצוגה פעם אחת כדי ליצור את ה-PDT. לאחר מכן, מריצים את שאילתות הבדיקה ומשווים את התוצאות. אם התוצאות טובות, אתם יכולים לבקש ממנהל מסד הנתונים או מצוות ה-ETL להוסיף את האינדקסים לטבלה המקורית.
UNION שתי טבלאות
אם הדיאלקט של SQL תומך בכך, אפשר להריץ אופרטור UNION או UNION ALL של SQL בשתי הטבלאות הנגזרות. האופרטורים UNION ו-UNION ALL משלבים את קבוצות התוצאות של שתי שאילתות.
בדוגמה הזו אפשר לראות איך נראית טבלה נגזרת שמבוססת על SQL עם UNION:
view: first_and_second_quarter_sales {
  derived_table: {
    sql:
       SELECT * AS sales_records
       FROM sales_records_first_quarter
       UNION
       SELECT * AS sales_records
       FROM sales_records_second_quarter ;;
   }
}
ההצהרה UNION בפרמטר sql יוצרת טבלה נגזרת שמשלבת את התוצאות של שתי השאילתות.
ההבדל בין UNION לבין UNION ALL הוא שהפונקציה UNION ALL לא מסירה שורות כפולות. יש שיקולי ביצועים שצריך להביא בחשבון כשמשתמשים ב-UNION לעומת UNION ALL, כי שרת מסד הנתונים צריך לבצע עבודה נוספת כדי להסיר את השורות הכפולות.
חישוב סכום של סכום (הפיכת מדד למאפיין)
ככלל ב-SQL, וכתוצאה מכך גם ב-Looker, אי אפשר לקבץ שאילתה לפי התוצאות של פונקציית צבירה (שמיוצגת ב-Looker כמדדים). אפשר לבצע קיבוץ לפי שדות לא נצברים (שמיוצגים ב-Looker כמאפיינים).
כדי לקבץ לפי צבירה (למשל, כדי לחשב סכום של סכום), צריך להפוך מדד ל "מאפיין". אחת הדרכים לעשות זאת היא באמצעות טבלה נגזרת, שיוצרת למעשה שאילתת משנה של הצבירה.
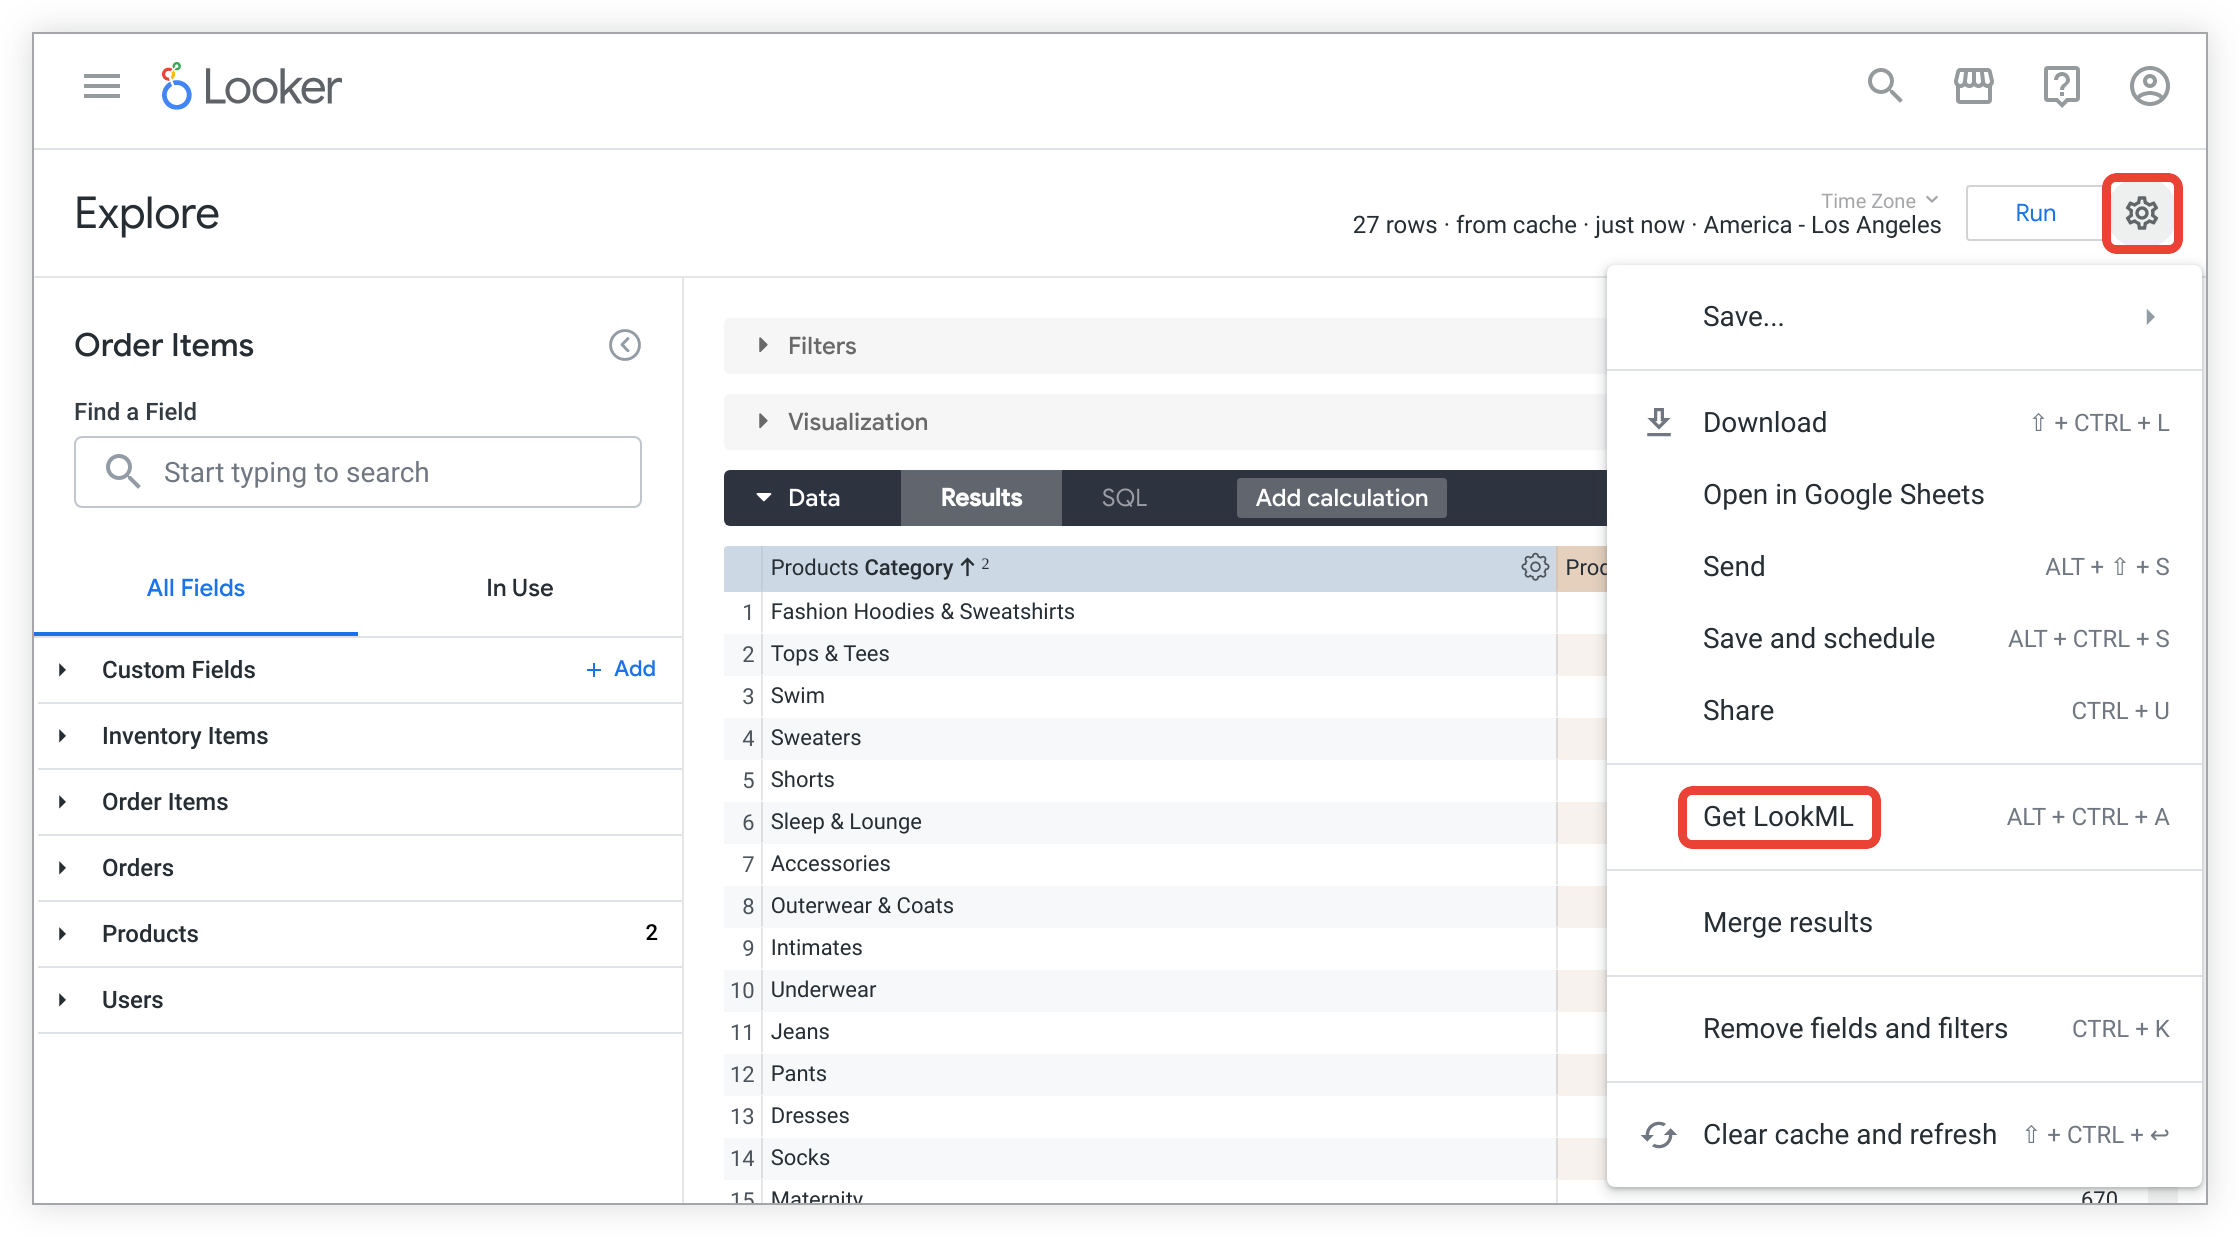
החל מ-Explore, Looker יכול ליצור LookML לכל הטבלה הנגזרת או לרובה. פשוט יוצרים Explore ובוחרים את כל השדות שרוצים לכלול בטבלה הנגזרת. כדי ליצור את ה-LookML של הטבלה הנגזרת המקורית (או שמבוססת על SQL), פועלים לפי השלבים הבאים:
לוחצים על תפריט גלגל השיניים של Explore ובוחרים באפשרות Get LookML.
כדי לראות את ה-LookML ליצירת טבלה נגזרת מבוססת LookML ל-Explore, לוחצים על הכרטיסייה Derived Table.
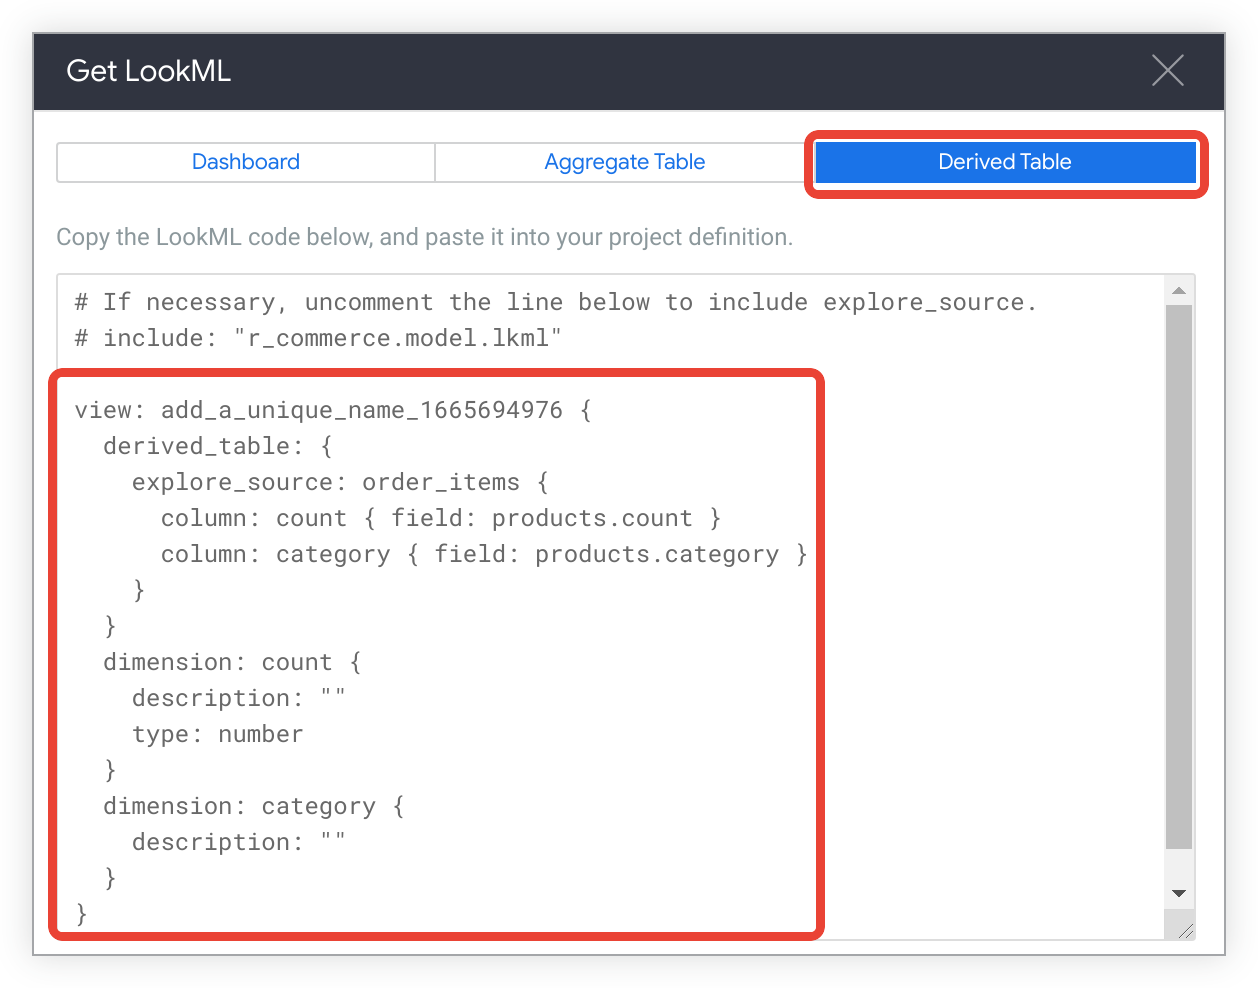
מעתיקים את ה-LookML.
אחרי שהעתקתם את קוד ה-LookML שנוצר, אתם יכולים להדביק אותו בקובץ תצוגה. כך עושים את זה:
במצב פיתוח, עוברים אל קובצי הפרויקט.
לוחצים על + בחלק העליון של רשימת קובצי הפרויקט ב-Looker IDE, ובוחרים באפשרות Create View. לחלופין, כדי ליצור את הקובץ בתוך התיקייה, לוחצים על התפריט של התיקייה ובוחרים באפשרות יצירת תצוגה.
נותנים לתצוגה שם בעל משמעות.
אם רוצים, אפשר לשנות את שמות העמודות, לציין עמודות נגזרות ולהוסיף מסננים.
טבלאות סיכום עם מודעות לצבירה
ב-Looker, יכול להיות שתיתקלו לעיתים קרובות במערכי נתונים או בטבלאות גדולים מאוד, שכדי לשפר את הביצועים שלהם צריך להשתמש בטבלאות מסכמות או באוספי נתונים.
בעזרת המודעות לטבלאות מסכמות ב-Looker, אתם יכולים ליצור מראש טבלאות מסכמות ברמות שונות של פירוט, מאפיינים וצבירה, ולהגדיר ל-Looker איך להשתמש בהן בתוך Explores קיימים. לאחר מכן, השאילתות ישתמשו בטבלאות הסיכום האלה במקרים שבהם Looker רואה לנכון, ללא קלט של משתמשים. כך אפשר להקטין את גודל השאילתה, לקצר את זמני ההמתנה ולשפר את חוויית המשתמש.
הדוגמה הבאה מציגה הטמעה פשוטה מאוד במודל של Looker, כדי להדגים עד כמה קל להשתמש במודעוּת לצבירת נתונים. נניח שיש במסד הנתונים טבלת טיסות היפותטית עם שורה לכל טיסה שמתועדת דרך ה-FAA. אתם יכולים ליצור מודל של הטבלה הזו ב-Looker עם תצוגה ו-Explore משלה. בהמשך מוצג קוד LookML של טבלה מסכמת שאפשר להגדיר ל-Explore:
  explore: flights {
    aggregate_table: flights_by_week_and_carrier {
      query: {
        dimensions: [carrier, depart_week]
        measures: [cancelled_count, count]
      }

      materialization: {
        sql_trigger_value: SELECT CURRENT-DATE;;
      }
    }
  }
בעזרת הטבלה המסכמת הזו, משתמש יכול לשלוח שאילתה ל-Explore של flights, ו-Looker ישתמש באופן אוטומטי בטבלה המסכמת כדי לענות על שאילתות. במדריך בנושא מוּדעוּת לצבירת נתונים מופיע הסבר מפורט יותר על הנושא.