


בעיות באיזון העומסים ב-Google Kubernetes Engine (GKE) עלולות לגרום לשיבושים בשירות, כמו שגיאות HTTP 502, או למנוע גישה לאפליקציות.
במאמר הזה מוסבר איך לפתור שגיאות 502 שמתקבלות מ-Ingress חיצוני, ואיך להשתמש ביומנים של איזון עומסים ובכלי אבחון כמו check-gke-ingress כדי לזהות בעיות.
המידע הזה חשוב לאדמינים ולמפעילים של פלטפורמות, ולמפתחי אפליקציות שמגדירים ותחזקים שירותים עם איזון עומסים ב-GKE. מידע נוסף על התפקידים הנפוצים ודוגמאות למשימות שאנחנו מתייחסים אליהן בתוכן של Google Cloud , זמין במאמר תפקידי משתמשים ומשימות נפוצים ב-GKE.
לא נמצא BackendConfig
השגיאה הזו מתרחשת כשמציינים BackendConfig ליציאת שירות בהערת השירות, אבל לא ניתן למצוא את משאב ה-BackendConfig בפועל.
כדי להעריך אירוע ב-Kubernetes, מריצים את הפקודה הבאה:
kubectl get event
הפלט הבא לדוגמה מציין שלא נמצא BackendConfig:
KIND    ... SOURCE
Ingress ... loadbalancer-controller

MESSAGE
Error during sync: error getting BackendConfig for port 80 on service "default/my-service":
no BackendConfig for service port exists
כדי לפתור את הבעיה, ודאו שלא יצרתם את המשאב BackendConfig במרחב השמות הלא נכון, או שלא אייתתם בצורה שגויה את ההפניה שלו בהערה של השירות.
מדיניות אבטחה של Ingress לא נמצאה
אחרי שיוצרים את אובייקט ה-Ingress, אם מדיניות האבטחה לא משויכת כראוי לשירות LoadBalancer, צריך להעריך את אירוע Kubernetes כדי לראות אם יש טעות בהגדרה. אם ב-BackendConfig מצוינת מדיניות אבטחה שלא קיימת, אירוע אזהרה מופק מעת לעת.
כדי להעריך אירוע ב-Kubernetes, מריצים את הפקודה הבאה:
kubectl get event
הפלט הבא לדוגמה מציין שמדיניות האבטחה לא נמצאה:
KIND    ... SOURCE
Ingress ... loadbalancer-controller

MESSAGE
Error during sync: The given security policy "my-policy" does not exist.
כדי לפתור את הבעיה, צריך לציין את השם הנכון של מדיניות האבטחה ב-BackendConfig.
טיפול בשגיאות מסוג 500 באמצעות NEGs במהלך שינוי קנה מידה של עומסי עבודה ב-GKE
התסמין:
כשמשתמשים ב-NEGs שמוקצים ב-GKE לצורך איזון עומסים, יכול להיות שיופיעו שגיאות 502 או 503 בשירותים במהלך הקטנת עומס העבודה. שגיאות 502 מתרחשות כשפודים מסתיימים לפני שחיבורים קיימים נסגרים, ושגיאות 503 מתרחשות כשנתיב התנועה מופנה לפודים שנמחקו.
הבעיה הזו יכולה להשפיע על אשכולות אם אתם משתמשים במוצרים מנוהלים של GKE לאיזון עומסים שמשתמשים ב-NEGs, כולל Gateway, Ingress ו-NEGs עצמאיים. אם אתם משנים את גודל עומסי העבודה לעיתים קרובות, הסיכון שהאשכול יושפע גבוה יותר.
אבחון:
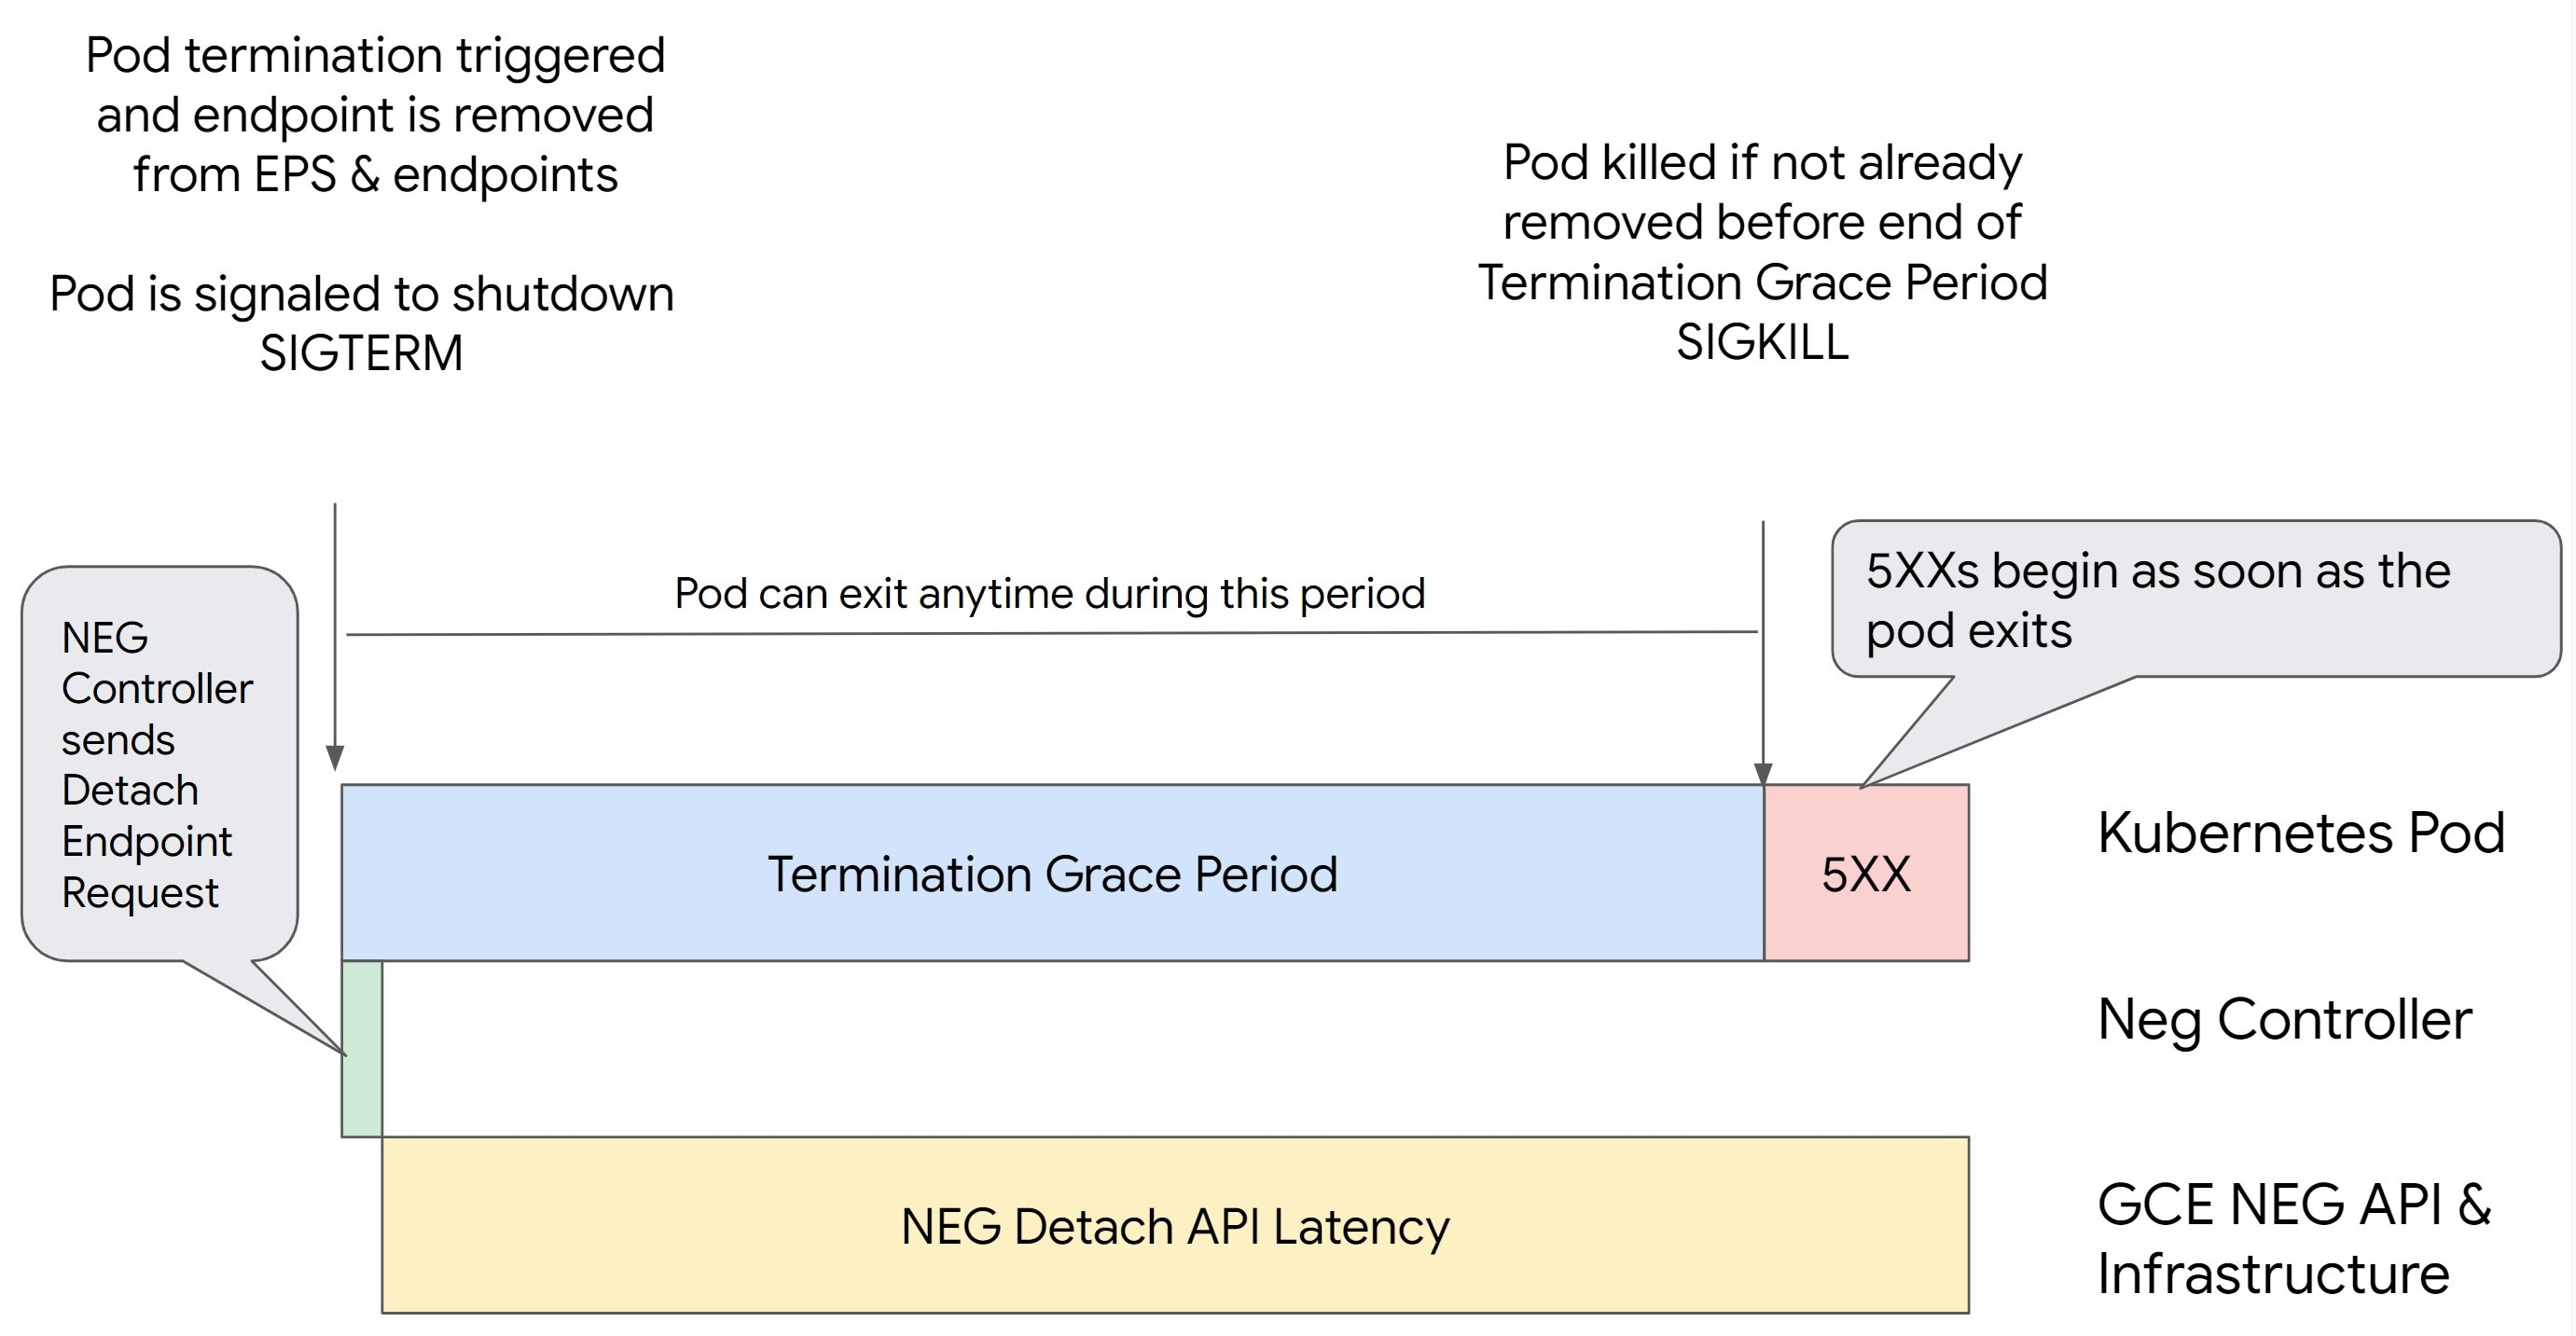
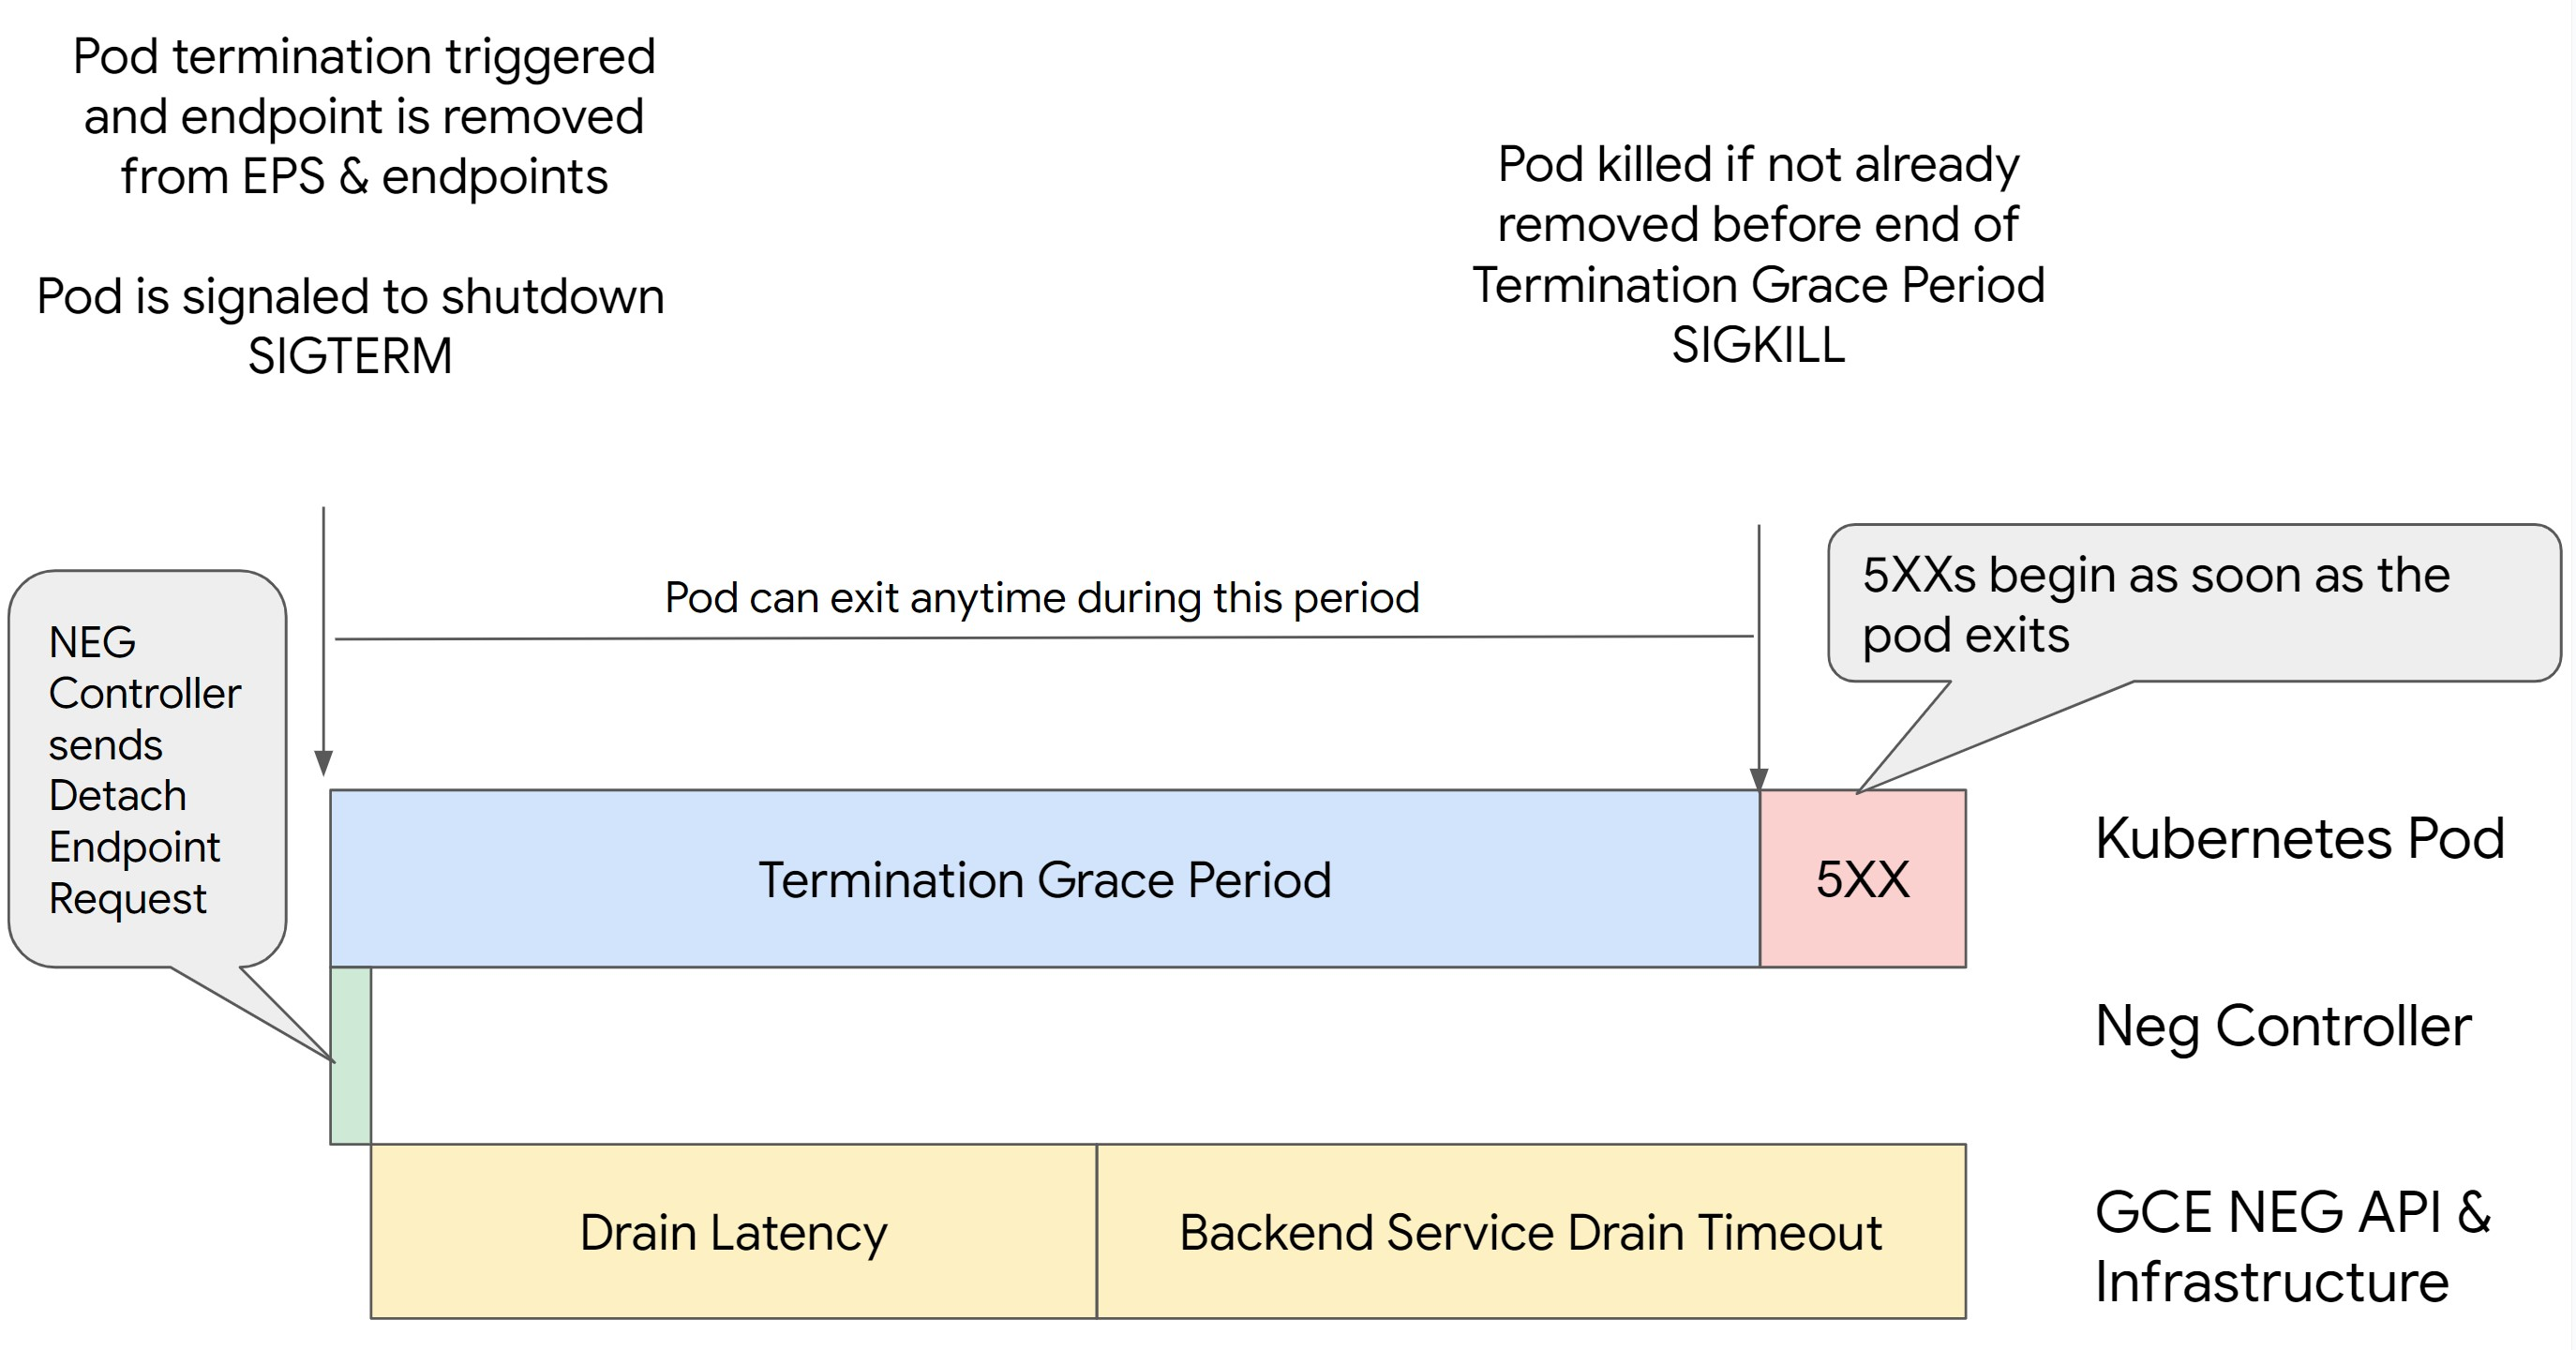
אם מסירים Pod ב-Kubernetes בלי לרוקן את נקודת הקצה שלו ולהסיר אותו קודם מה-NEG, זה מוביל לשגיאות מסדרת 500. כדי להימנע מבעיות במהלך סיום הפעולה של ה-Pod, צריך לשים לב לסדר הפעולות. בתמונות הבאות מוצגים תרחישים שבהם BackendService Drain Timeout לא מוגדר ו-BackendService Drain Timeout מוגדר עם BackendConfig.
תרחיש 1: המדיניות BackendService Drain Timeout לא מוגדרת.
בתמונה הבאה מוצג תרחיש שבו הערך של BackendService Drain Timeout לא מוגדר.
תרחיש 2: BackendService Drain Timeout מוגדר.
בתמונה הבאה מוצג תרחיש שבו הערך BackendService Drain Timeout מוגדר.
הזמן המדויק שבו מתרחשות השגיאות מסדרה 500 תלוי בגורמים הבאים:
זמן האחזור של ניתוק NEG API: זמן האחזור של ניתוק NEG API מייצג את הזמן הנוכחי שנדרש לסיום פעולת הניתוק ב- Google Cloud. הגורמים שמשפיעים על כך הם מגוונים ולא קשורים ל-Kubernetes, כולל סוג מאזן העומסים והאזור הספציפי.
השהיית ניקוז: השהיית ניקוז היא הזמן שנדרש למאזן העומסים כדי להתחיל להפנות את התנועה מחלק מסוים במערכת. אחרי שמפעילים את הניקוי, מאזן העומסים מפסיק לשלוח בקשות חדשות לנקודת הקצה, אבל עדיין יש השהיה בהפעלת הניקוי (השהיית הניקוי) שיכולה לגרום לשגיאות זמניות מסוג 503 אם ה-Pod כבר לא קיים.
הגדרת בדיקת התקינות: סף רגיש יותר לבדיקת התקינות מקצר את משך השגיאות מסוג 503, כי הוא יכול לאותת למאזן העומסים להפסיק לשלוח בקשות לנקודות קצה גם אם פעולת הניתוק לא הסתיימה.
תקופת חסד לסיום: תקופת החסד לסיום קובעת את משך הזמן המקסימלי שניתן ל-Pod כדי לצאת. עם זאת, אפשר לצאת מ-Pod לפני שתקופת החסד לסיום מסתיימת. אם פוד נמשך יותר מהתקופה הזו, הוא נאלץ לצאת בסוף התקופה. זו הגדרה ב-Pod שצריך להגדיר בהגדרת עומס העבודה.
פתרון אפשרי:
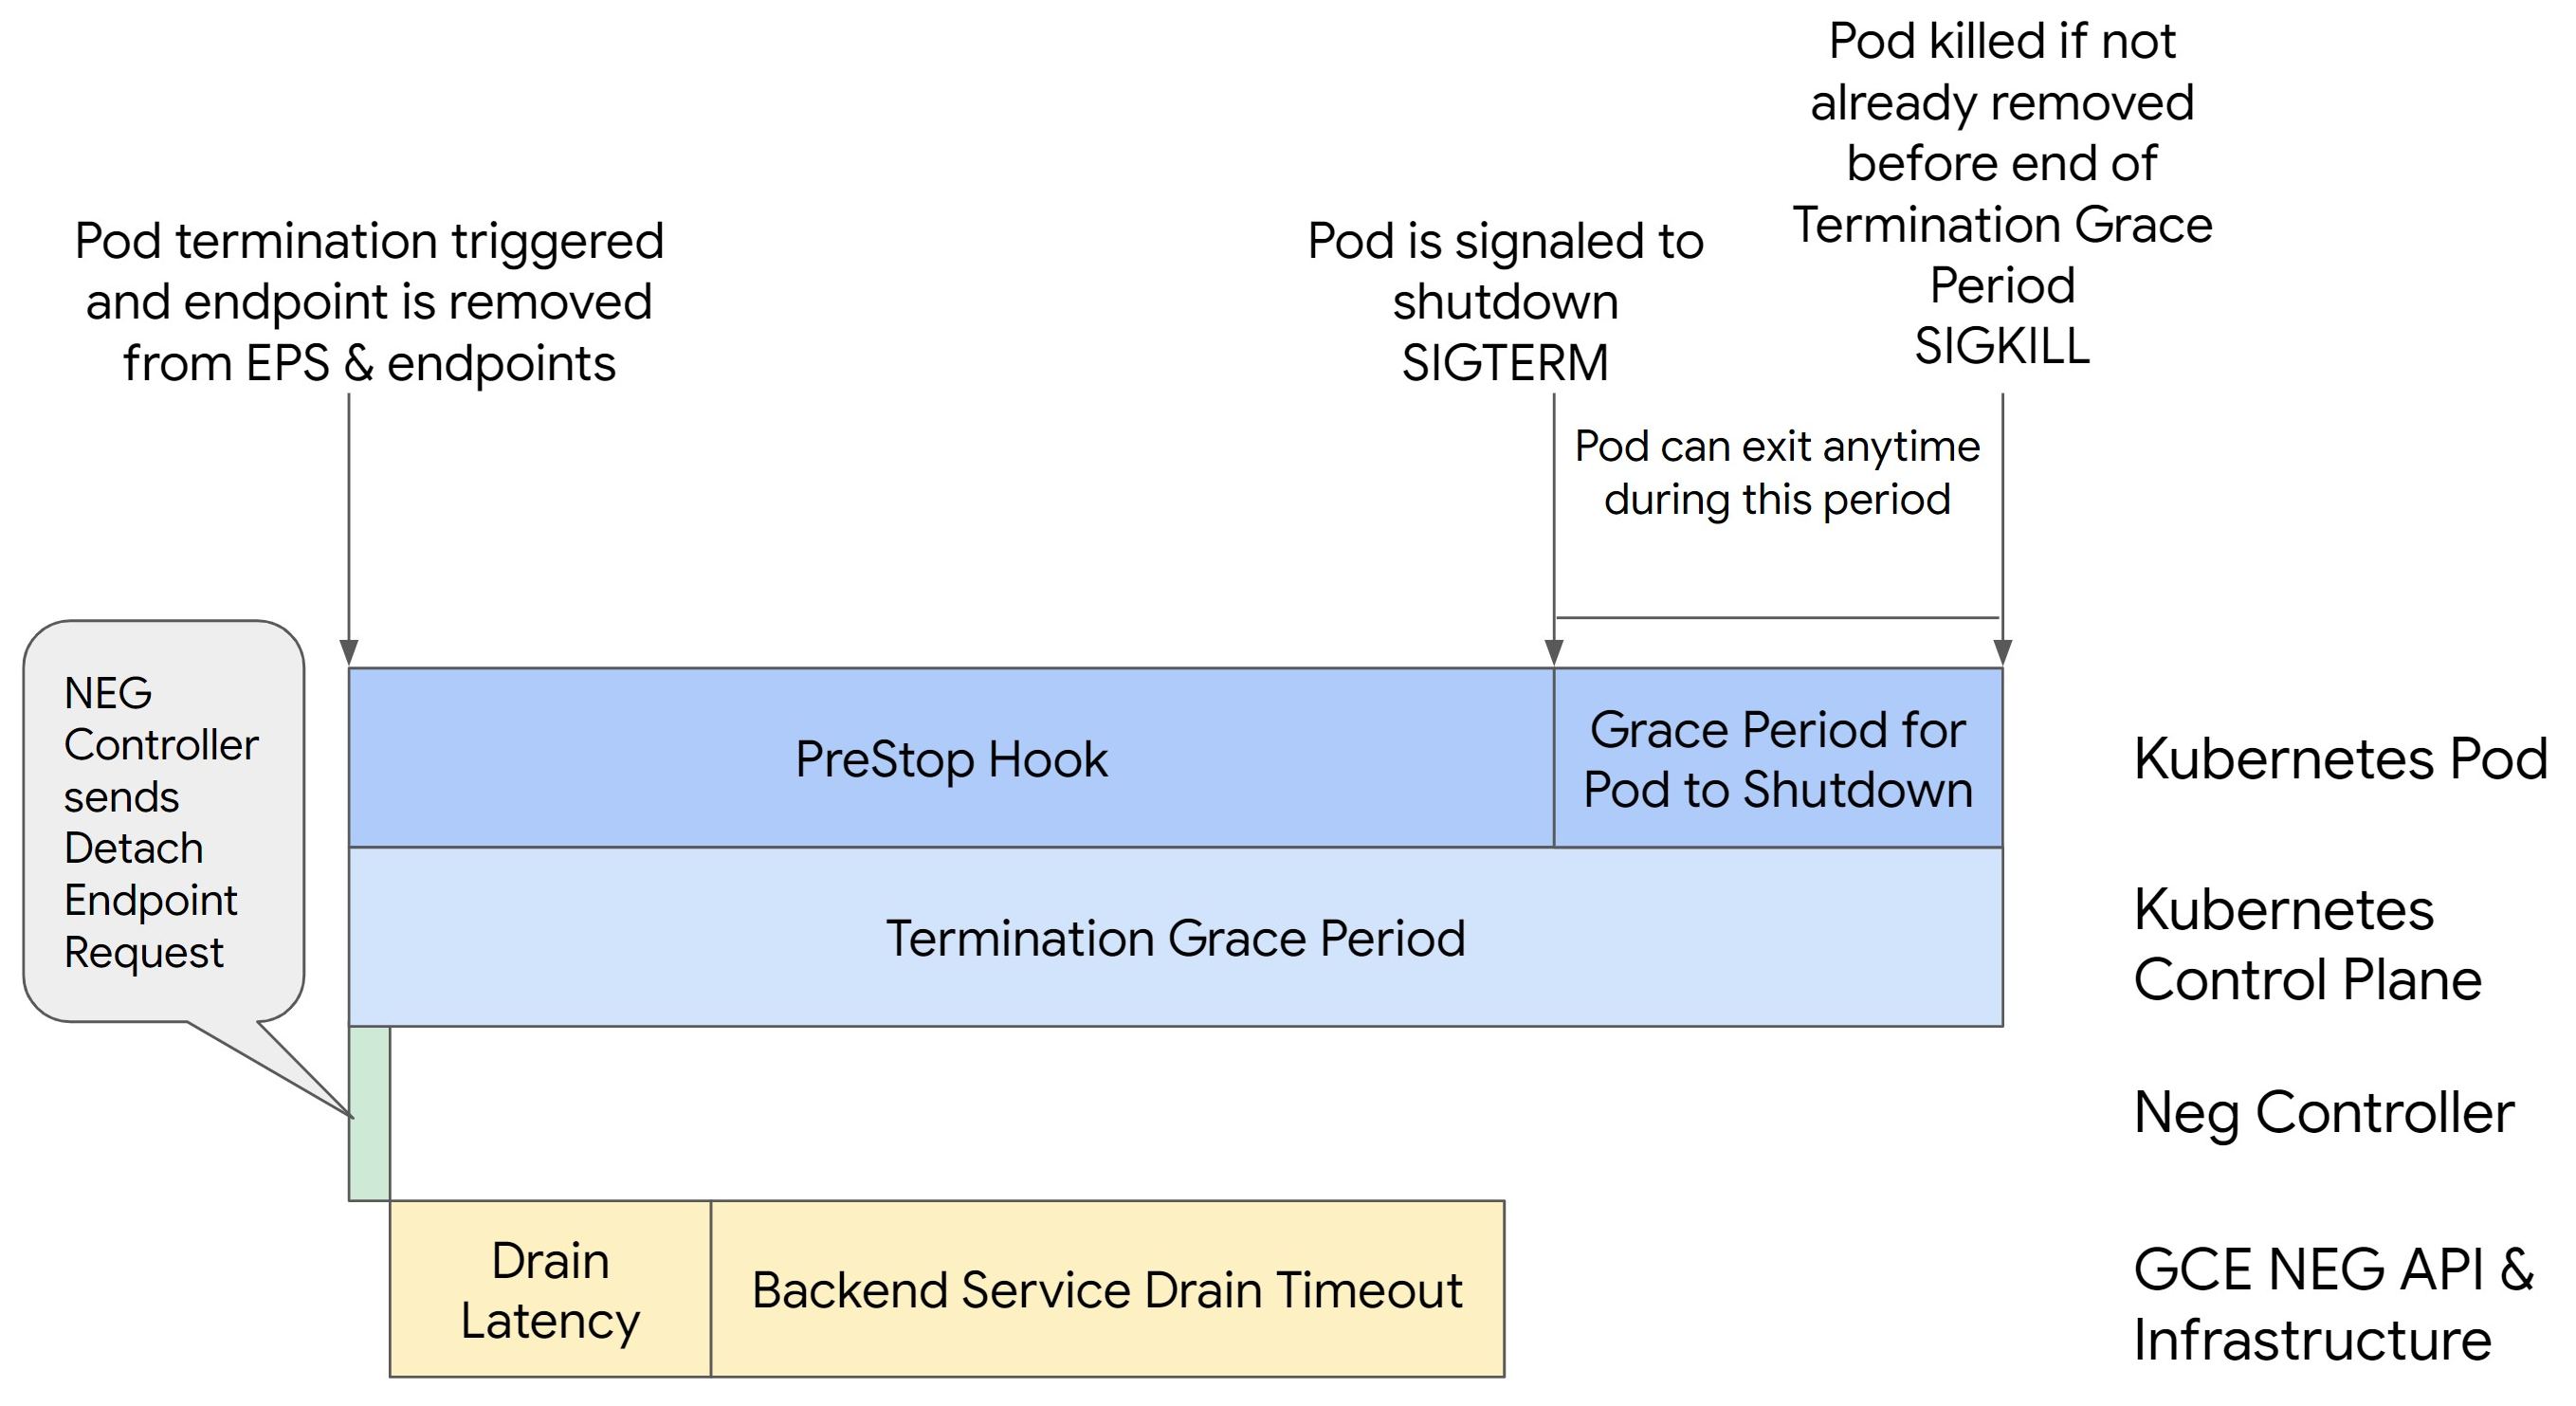
כדי למנוע את שגיאות 5XX, צריך להחיל את ההגדרות הבאות. ערכי הזמן הקצוב לתפוגה הם בגדר הצעה, ויכול להיות שתצטרכו לשנות אותם בהתאם לאפליקציה הספציפית שלכם. בקטע הבא מוסבר תהליך ההתאמה האישית.
בתמונה הבאה אפשר לראות איך משאירים את ה-Pod פעיל באמצעות הוק preStop:
כדי להימנע משגיאות מסוג 500, מבצעים את השלבים הבאים:
מגדירים את
BackendService Drain Timeoutשל השירות לדקה אחת.למשתמשי Ingress, ראו הגדרת זמן הקצוב לתפוגה ב-BackendConfig.
משתמשי Gateway יכולים לקרוא על הגדרת פסק הזמן ב-GCPBackendPolicy.
אם אתם מנהלים את ה-BackendServices ישירות כשאתם משתמשים ב-NEGs עצמאיים, עיינו במאמר הגדרת זמן הקצוב לתפוגה ישירות ב-Backend Service.
הארכת
terminationGracePeriodבפוד.מגדירים את
terminationGracePeriodSecondsב-Pod ל-3.5 דקות. בשילוב עם ההגדרות המומלצות, זה מאפשר לפודים חלון של 30 עד 45 שניות לכיבוי מבוקר אחרי שנקודת הקצה של הפוד הוסרה מה-NEG. אם אתם צריכים יותר זמן לכיבוי מבוקר, אתם יכולים להאריך את תקופת החסד או לפעול לפי ההוראות בקטע התאמה אישית של זמני קצובות לתפוגה.במניפסט של ה-Pod הבא מוגדר זמן להשלמת תהליך (connection draining) של 210 שניות (3.5 דקות):
spec:
  terminationGracePeriodSeconds: 210
  containers:
  - name: my-app
    ...
  ...
מחילים הוק של
preStopעל כל מאגרי התגים.החלת וו (hook) של
preStopשיבטיח שה-Pod יפעל למשך 120 שניות נוספות בזמן שנקודת הקצה של ה-Pod מתרוקנת במאזן העומסים ונקודת הקצה מוסרת מה-NEG.spec: containers: - name: my-app ... lifecycle: preStop: exec: command: ["/bin/sh", "-c", "sleep 120s"] ...
התאמה אישית של זמני קצובת הזמן הקצוב לתפוגה
כדי להבטיח את המשכיות של ה-Pod ולמנוע שגיאות מסדרה 500, ה-Pod צריך להיות פעיל עד להסרת נקודת הקצה מה-NEG. כדי למנוע שגיאות 502 ו-503, כדאי להטמיע שילוב של זמני קצובות לתפוגה ו-hook של preStop.
כדי שה-Pod ימשיך לפעול למשך זמן ארוך יותר במהלך תהליך ההשבתה, מוסיפים ל-Pod preStop hook. ה-hook preStop מופעל לפני שמתקבל אות ליציאה מ-Pod, כך שאפשר להשתמש ב-hook preStop כדי לשמור על פעילות ה-Pod עד שהנקודה המקבילה שלו מוסרת מ-NEG.
כדי להאריך את משך הזמן שבו ה-Pod נשאר פעיל במהלך תהליך ההשבתה, מוסיפים וו (hook) של preStop להגדרת ה-Pod באופן הבא:
spec:
  containers:
  - name: my-app
    ...
    lifecycle:
      preStop:
        exec:
          command: ["/bin/sh", "-c", "sleep <latency time>"]
אתם יכולים להגדיר פסק זמן והגדרות קשורות כדי לנהל את ההשבתה המבוקרת של ה-Pods במהלך צמצום של עומס העבודה. אפשר לשנות את הגדרות הזמן הקצוב לתפוגה בהתאם לתרחישי שימוש ספציפיים. מומלץ להתחיל עם ערכי זמן קצוב ארוכים יותר ולקצר את משך הזמן לפי הצורך. כדי לשנות את הגדרות הזמן הקצוב לתפוגה, אפשר להגדיר פרמטרים שקשורים לזמן קצוב לתפוגה ול-hook preStop באחת מהדרכים הבאות:
זמן קצוב לתפוגה של ניקוז שירות לקצה העורפי
כברירת מחדל, הפרמטר Backend Service Drain Timeout לא מוגדר ואין לו השפעה. אם מגדירים את הפרמטר Backend Service Drain Timeout ומפעילים אותו, מאזן העומסים מפסיק להפנות בקשות חדשות לנקודת הקצה וממתין עד שתפוג ההמתנה לפני סיום החיבורים הקיימים.
אפשר להגדיר את הפרמטר Backend Service Drain Timeout באמצעות BackendConfig עם Ingress, GCPBackendPolicy עם Gateway או באופן ידני ב-BackendService עם NEGs עצמאיים. הזמן הקצוב לתפוגה צריך להיות ארוך פי 1.5 עד 2 מהזמן שנדרש לעיבוד הבקשה. כך אפשר לוודא שאם בקשה הגיעה ממש לפני שהתחיל הניקוז, היא תסתיים לפני שייגמר הזמן הקצוב. הגדרת הפרמטר Backend Service Drain Timeout לערך גדול מ-0 עוזרת לצמצם את מספר השגיאות מסוג 503, כי לא נשלחות בקשות חדשות לנקודות קצה שמתוזמנות להסרה. כדי שההגדרה הזו תהיה יעילה, צריך להשתמש בה עם ה-hook preStop כדי לוודא שה-Pod יישאר פעיל בזמן הניקוי. בלי השילוב הזה, בקשות קיימות שלא הושלמו יקבלו שגיאה 502.
זמן הוק של preStop
ה-hook preStop צריך לעכב את השבתת ה-Pod מספיק זמן כדי לאפשר את השלמת ההמתנה לסיום הניקוז (drain) של ה-Pod ואת פסק הזמן של ניקוז שירות ה-backend, וכך לוודא שהחיבורים ינותקו בצורה תקינה והנקודות להעברת נתונים יוסרו מ-NEG לפני שה-Pod מושבת.
כדי לקבל תוצאות אופטימליות, חשוב לוודא שזמן הביצוע של ה-hook של preStop גדול או שווה לסכום של Backend Service Drain Timeout וזמן האחזור של הניקוז.
כדי לחשב את זמן ההפעלה האידיאלי של ה-preStophook, משתמשים בנוסחה הבאה:
preStop hook execution time >= BACKEND_SERVICE_DRAIN_TIMEOUT + DRAIN_LATENCY
מחליפים את מה שכתוב בשדות הבאים:
-
BACKEND_SERVICE_DRAIN_TIMEOUT: הזמן שהגדרתם ל-Backend Service Drain Timeout. -
DRAIN_LATENCY: זמן משוער של השהיית הניקוז. מומלץ להשתמש בדקה אחת כהערכה.
אם שגיאות 500 נמשכות, מעריכים את משך הזמן הכולל של השגיאות ומוסיפים את הזמן הזה כפול 2 לזמן האחזור המשוער של הניקוז. כך לפוד יהיה מספיק זמן לסיים את הפעילות שלו לפני שהוא יוסר מהשירות. אתם יכולים לשנות את הערך הזה אם הוא ארוך מדי לתרחיש השימוש הספציפי שלכם.
לחלופין, אפשר להעריך את התזמון על ידי בדיקת חותמת הזמן של המחיקה מה-Pod וחותמת הזמן של הסרת נקודת הקצה מה-NEG ביומני הביקורת של Cloud.
הפרמטר Termination Grace Period
אתם צריכים להגדיר את הפרמטר terminationGracePeriod כך שיהיה מספיק זמן לסיום של ה-hook preStop ולסיום תקין של ה-Pod.
כברירת מחדל, אם לא מגדירים את terminationGracePeriod, הערך הוא 30 שניות.
אפשר לחשב את הערך האופטימלי של terminationGracePeriod באמצעות הנוסחה:
terminationGracePeriod >= preStop hook time + Pod shutdown time
כדי להגדיר את terminationGracePeriod בתצורת ה-Pod באופן הבא:
  spec:
    terminationGracePeriodSeconds: <terminationGracePeriod>
    containers:
    - name: my-app
      ...
    ...
לא נמצאה קבוצת נקודות קצה ברשת (NEG) כשנוצר משאב Ingress פנימי
יכול להיות שתקבלו את השגיאה הבאה כשאתם יוצרים Ingress פנימי ב-GKE:
Error syncing: error running backend syncing routine: googleapi: Error 404: The resource 'projects/PROJECT_ID/zones/ZONE/networkEndpointGroups/NEG' was not found, notFound
השגיאה הזו מתרחשת כי Ingress למאזני עומסים פנימיים של אפליקציות (ALB) דורש קבוצות של נקודות קצה ברשת (NEGs) כבק-אנד.
בסביבות VPC משותף או באשכולות שבהם מופעלת מדיניות רשת ב-Kubernetes, מוסיפים את ההערה cloud.google.com/neg: '{"ingress": true}' למניפסט של השירות.
504 Gateway Timeout: upstream request timeout
יכול להיות שתקבלו את השגיאה הבאה כשאתם ניגשים לשירות מ-Ingress פנימי ב-GKE:
HTTP/1.1 504 Gateway Timeout
content-length: 24
content-type: text/plain

upstream request timeout
השגיאה הזו מתרחשת כי תעבורת נתונים שנשלחת אל מאזני עומסים של אפליקציות פנימיים מועברת דרך שרתי proxy של Envoy בטווח של רשת משנה (subnet) שמוגדרת ל-proxy בלבד.
כדי לאפשר תעבורת נתונים מטווח תת-הרשת של שרת ה-proxy בלבד, יוצרים כלל של חומת אש ב-targetPort של השירות.
שגיאה 400: ערך לא תקין בשדה 'resource.target'
יכול להיות שתקבלו את השגיאה הבאה כשאתם ניגשים לשירות מ-Ingress פנימי ב-GKE:
Error syncing:LB_NAME does not exist: googleapi: Error 400: Invalid value for field 'resource.target': 'https://www.googleapis.com/compute/v1/projects/PROJECT_NAME/regions/REGION_NAME/targetHttpProxies/LB_NAME. A reserved and active subnetwork is required in the same region and VPC as the forwarding rule.
כדי לפתור את הבעיה, צריך ליצור רשת משנה לשרתי proxy בלבד.
שגיאה במהלך הסנכרון: שגיאה בהרצת שגרת הסנכרון של מאזן העומסים: מאזן העומסים לא קיים
אחת מהשגיאות הבאות עשויה להתרחש כשמשדרגים את מישור הבקרה של GKE או כשמשנים אובייקט Ingress:
"Error during sync: error running load balancer syncing routine: loadbalancer
INGRESS_NAME does not exist: invalid ingress frontend configuration, please
check your usage of the 'kubernetes.io/ingress.allow-http' annotation."
או:
Error during sync: error running load balancer syncing routine: loadbalancer LOAD_BALANCER_NAME does not exist:
googleapi: Error 400: Invalid value for field 'resource.IPAddress':'INGRESS_VIP'. Specified IP address is in-use and would result in a conflict., invalid
כדי לפתור את הבעיות האלה, נסו את השלבים הבאים:
- מוסיפים את השדה
hostsבקטעtlsשל מניפסט ה-Ingress, ואז מוחקים את ה-Ingress. מחכים חמש דקות עד ש-GKE ימחק את משאבי ה-Ingress שלא בשימוש. ואז יוצרים מחדש את ה-Ingress. למידע נוסף, קראו את המאמר השדה hosts של אובייקט Ingress. - מבטלים את השינויים שביצעתם ב-Ingress. לאחר מכן מוסיפים אישור באמצעות הערה או סוד של Kubernetes.
תעבורת נתונים נכנסת (ingress) חיצונית גורמת לשגיאות HTTP 502
כדי לפתור שגיאות HTTP 502 במשאבי Ingress חיצוניים, אפשר להיעזר בהנחיות הבאות:
- מפעילים יומנים לכל שירות לקצה העורפי שמשויך לכל שירות GKE שאליו יש הפניה ב-Ingress.
- אפשר להשתמש בפרטי הסטטוס כדי לזהות את הסיבות לתגובות HTTP 502. פרטי הסטטוס שמציינים שהתגובה HTTP 502 הגיעה מהקצה העורפי מחייבים פתרון בעיות ב-Pods של ההגשה, ולא במאזן העומסים.
קבוצות לא מנוהלות של מכונות
יכול להיות שתיתקלו בשגיאות HTTP 502 במשאבי Ingress חיצוניים אם משאבי Ingress החיצוניים משתמשים בשרתי קצה של קבוצות מופעים לא מנוהלות. הבעיה הזו מתרחשת כשכל התנאים הבאים מתקיימים:
- במאגר יש מספר גדול של צמתים בכל מאגרי הצמתים.
- ה-Pods שמציגים את השירותים שאליהם מפנה ה-Ingress נמצאים רק בכמה צמתים.
- השירותים שאליהם מפנה ה-Ingress משתמשים ב-
externalTrafficPolicy: Local.
כדי לבדוק אם ה-Ingress החיצוני שלכם משתמש בקצה העורפי של קבוצת מופעים לא מנוהלת:
עוברים לדף Ingress במסוף Google Cloud .
לוחצים על השם של ה-Ingress החיצוני.
לוחצים על השם של מאזן העומסים. יוצג הדף Load balancing details.
כדי לבדוק אם ה-Ingress החיצוני שלכם משתמש ב-NEGs או בקבוצות של מכונות וירטואליות, צריך לעיין בטבלה שבקטע שירות לקצה העורפי.
כדי לפתור את הבעיה, אפשר לנסות אחד מהפתרונות הבאים:
- שימוש באשכול המותאם ל-VPC.
- משתמשים ב-
externalTrafficPolicy: Clusterלכל שירות שאליו מפנה ה-Ingress החיצוני. הפתרון הזה גורם לאובדן של כתובת ה-IP המקורית של הלקוח במקורות של החבילה. - משתמשים בהערה
node.kubernetes.io/exclude-from-external-load-balancers=true. מוסיפים את ההערה לצמתים או למאגרי הצמתים שלא מריצים אף Pod של שרת לכל שירות שמפנה לכל Ingress חיצוני או לכל שירותLoadBalancerבאשכול.
הגדרת רישום ביומן של מאזן עומסים בשכבה 4
בקטע הזה מופיע מידע לפתרון בעיות אם הפעלתם רישום ביומן למאזן עומסי רשת חיצוני להעברת סיגנל ללא שינוי או למאזן עומסי רשת פנימי להעברת סיגנל ללא שינוי.
מעקב אחרי הסטטוס של הגדרת הרישום ביומן
בקר GKE L4LB מספק משוב על סטטוס ההתאמה של הרישום ביומן באמצעות הסוג status.conditions של השירות. כדי לבדוק את הסטטוס, מריצים את הפקודה הבאה:
kubectl get svc SERVICE_NAME -o yaml
מחליפים את מה שכתוב בשדות הבאים:
-
SERVICE_NAME: שם האשכול.
בפלט, מחפשים את סוג התנאי LoggingConfigManaged. בטבלה הבאה מפורטות הסיבות האפשריות למצב:
| סטטוס התנאי | סיבה | תיאור |
|---|---|---|
| True | מותאם | הבקר אוכף באופן פעיל את הגדרות הרישום ביומן שמוגדרות ב-CRD L4LBConfig. |
| לא נכון | לא מנוהל | הקטע logging חסר ב-CRD L4LBConfig, או שההערה הוסרה. הבקר הפסיק את הניהול והשאיר את השירות לקצה העורפי במצב האחרון הידוע שלו. |
| לא נכון | חסר | לא נמצא המשאב L4LBConfig שאליו מפנה ההערה של השירות. |
| לא נכון | לא חוקי | המשאב L4LBConfig נכשל באימות הצולב של הפרמטר optionalFields. |
| לא נכון | שגיאה | אירעה שגיאה במהלך ההתאמה של שירות לקצה העורפי. |
הסבר על התנהגות החוף
אם ההערה networking.gke.io/l4lb-config תוסר מהמניפסט של השירות, או אם המשאב L4LBConfig שאליו מפנים יימחק, ההגדרה תעבור למצב Coast.
במצב הזה, בקר GKE מפסיק לנהל את הגדרות הרישום ביומן, אבל לא מאפס את שירות הקצה העורפי של Google Cloud להגדרות ברירת המחדל שלו. במקום זאת, השירות לקצה העורפי נשאר במצב האחרון שהיה תקין. אירוע אזהרה מונפק בדרך כלל כדי להודיע לכם ש-Kubernetes כבר לא שולט בהגדרה.
שימוש ביומנים של מאזן העומסים לפתרון בעיות
אתם יכולים להשתמש ביומנים של מאזני עומסי רשת פנימיים להעברת סיגנל ללא שינוי וביומנים של מאזני עומסי רשת חיצוניים להעברת סיגנל ללא שינוי כדי לפתור בעיות במאזני העומסים, ולקשר בין התנועה ממאזני העומסים לבין משאבי GKE.
היומנים מצטברים לכל חיבור ומיוצאים כמעט בזמן אמת. יומנים נוצרים לכל צומת GKE שמעורב בנתיב הנתונים של שירות LoadBalancer, גם לתנועת נתונים נכנסת וגם לתנועת נתונים יוצאת. הרשומות ביומן כוללות שדות נוספים למשאבי GKE, כמו:
- שם האשכול
- מיקום האשכול
- שם השירות
- מרחב השמות של השירות
- שם ה-Pod
- מרחב השמות של ה-Pod
תמחור
אין חיובים נוספים על שימוש ביומנים. התמחור הסטנדרטי של Cloud Logging, BigQuery או Pub/Sub חל בהתאם לאופן ההטמעה של היומנים. הפעלת היומנים לא משפיעה על הביצועים של מאזן העומסים.
שימוש בכלי אבחון כדי לפתור בעיות
כלי האבחון check-gke-ingress בודק משאבי Ingress כדי לזהות בעיות נפוצות בהגדרות. אפשר להשתמש בכלי check-gke-ingress בדרכים הבאות:
- מריצים את כלי שורת הפקודה
gcpdiagבאשכול. תוצאות ה-Ingress מופיעות בקטעgke/ERR/2023_004של כלל הבדיקה. - אפשר להשתמש בכלי
check-gke-ingressלבד או כפלאגין של kubectl. כדי לעשות את זה, צריך לפעול לפי ההוראות שמפורטות ב-check-gke-ingress.
המאמרים הבאים
אם לא מצאתם פתרון לבעיה שלכם במסמכים, תוכלו להיעזר בקבלת תמיכה, כולל עצות בנושאים הבאים:
- פתיחת בקשת תמיכה באמצעות פנייה אל Cloud Customer Care.
- לקבל תמיכה מהקהילה על ידי פרסום שאלות ב-StackOverflow ושימוש בתג
google-kubernetes-engineכדי לחפש בעיות דומות. אתם יכולים גם להצטרף לערוץ Slack של#kubernetes-engineכדי לקבל תמיכה מהקהילה. - דיווח על בעיות או שליחת בקשות להוספת תכונות באמצעות הכלי הציבורי Issue Tracker.