


בדף הזה מוסבר איך להעביר את ההגדרה של GKE Inference Gateway מגרסת הטרום-השקה של v1alpha2 API לגרסה הזמינה לכולם של v1 API.
המסמך הזה מיועד לאדמינים של פלטפורמות ולמומחי רשתות שמשתמשים בגרסה v1alpha2 של GKE Inference Gateway ורוצים לשדרג לגרסה 1 כדי להשתמש בתכונות העדכניות ביותר.
לפני שמתחילים בהעברה, חשוב להכיר את המושגים ואת הפריסה של GKE Inference Gateway. מומלץ לקרוא את המאמר פריסת GKE Inference Gateway.
לפני שמתחילים
לפני שמתחילים בהעברה, צריך לקבוע אם צריך לפעול לפי המדריך הזה.
בדיקה אם קיימים ממשקי API בגרסה v1alpha2
כדי לבדוק אם אתם משתמשים ב-API של v1alpha2 GKE Inference Gateway, מריצים את הפקודות הבאות:
kubectl get inferencepools.inference.networking.x-k8s.io --all-namespaces
kubectl get inferencemodels.inference.networking.x-k8s.io --all-namespaces
הפלט של הפקודות האלה קובע אם צריך לבצע מיגרציה:
- אם אחת מהפקודות מחזירה משאב אחד או יותר מסוג
InferencePoolאוInferenceModel, אתם משתמשים ב-v1alpha2API ועליכם לפעול לפי ההנחיות במדריך הזה. - אם שתי הפקודות מחזירות
No resources found, אתם לא משתמשים ב-APIv1alpha2. אפשר להמשיך בהתקנה חדשה שלv1GKE Inference Gateway.
נתיבי העברה
יש שתי דרכים להעברה מ-v1alpha2 ל-v1:
- העברה פשוטה (עם זמן השבתה): הדרך הזו מהירה ופשוטה יותר, אבל היא גורמת לזמן השבתה קצר. זהו הנתיב המומלץ אם אתם לא צריכים לבצע העברה ללא השבתה.
- העברה ללא השבתה: האפשרות הזו מתאימה למשתמשים שלא יכולים להרשות לעצמם הפסקה בשירות. התהליך כולל הפעלה של שני סטאקים,
v1alpha2ו-v1, זה לצד זה, והעברה הדרגתית של התנועה.
העברה פשוטה (עם זמן השבתה)
בקטע הזה מוסבר איך לבצע העברה פשוטה עם זמן השבתה.
מחיקת
v1alpha2משאבים קיימים: כדי למחוק אתv1alpha2המשאבים, בוחרים באחת מהאפשרויות הבאות:אפשרות 1: הסרה באמצעות Helm
helm uninstall HELM_PREVIEW_INFERENCEPOOL_NAMEאפשרות 2: מחיקת משאבים באופן ידני
אם אתם לא משתמשים ב-Helm, אתם צריכים למחוק באופן ידני את כל המשאבים שמשויכים לפריסת
v1alpha2:- מעדכנים או מוחקים את
HTTPRouteכדי להסיר אתbackendRefשמפנה אלv1alpha2InferencePool. - מוחקים את
v1alpha2InferencePool, את כל משאביInferenceModelשמפנים אליו, ואת הפריסה והשירות התואמים של Endpoint Picker (EPP).
אחרי שמוחקים את כל המשאבים המותאמים אישית
v1alpha2, מסירים את Custom Resource Definitions (הגדרות של משאבים מותאמים אישית, CRD) מהאשכול:kubectl delete -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v0.3.0/manifests.yaml- מעדכנים או מוחקים את
התקנת משאבים בגרסה 1: אחרי שמנקים את המשאבים הישנים, מתקינים את
v1GKE Inference Gateway. התהליך הזה כולל את השלבים הבאים:- מתקינים את
v1הגדרות המשאבים המותאמות אישית (CRD) החדשות. - יוצרים
v1InferencePoolחדש ומשאביInferenceObjectiveתואמים. המשאבInferenceObjectiveעדיין מוגדר ב-APIv1alpha2. - יוצרים
HTTPRouteחדש שמפנה תנועה אלv1החדשInferencePool.
- מתקינים את
אימות הפריסה: אחרי כמה דקות, מוודאים שהתנועה מופנית אל
v1הסטאק החדש בצורה תקינה.מוודאים שהסטטוס של השער הוא
PROGRAMMED:kubectl get gateway -o wideהפלט שאתם מקבלים אמור להיראות כך:
NAME                CLASS                            ADDRESS        PROGRAMMED   AGE
inference-gateway   gke-l7-regional-external-managed   <IP_ADDRESS>   True         10m
כדי לאמת את נקודת הקצה, שולחים בקשה:
IP=$(kubectl get gateway/inference-gateway -o jsonpath='{.status.addresses[0].value}')
PORT=80
curl -i ${IP}:${PORT}/v1/completions -H 'Content-Type: application/json' -d '{"model": "<var>YOUR_MODEL</var>","prompt": "<var>YOUR_PROMPT</var>","max_tokens": 100,"temperature": 0}'
מוודאים שמקבלים תגובה מוצלחת עם קוד תגובה
200.
העברה ללא השבתה
נתיב ההעברה הזה מיועד למשתמשים שלא יכולים להרשות לעצמם הפסקה בשירות. בתרשים הבא מוצג איך GKE Inference Gateway מאפשר להפעיל כמה מודלים של AI גנרטיבי, שהוא היבט מרכזי באסטרטגיית מעבר ללא השבתה.
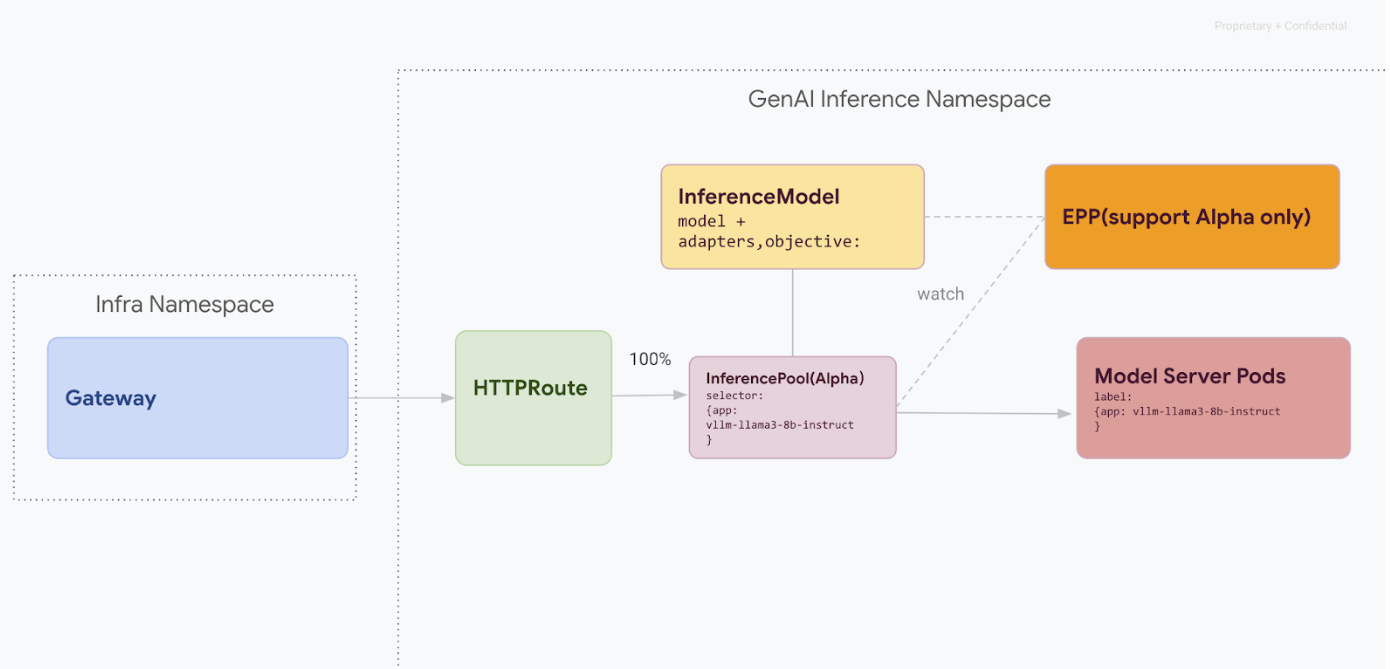
הבחנה בין גרסאות API באמצעות kubectl
במהלך ההעברה ללא השבתה, שני ה-CRD v1alpha2 ו-v1 מותקנים באשכול. זה יכול ליצור אי-בהירות כשמשתמשים ב-kubectl כדי לשלוח שאילתות לגבי משאבי InferencePool. כדי לוודא שאתם משתמשים בגרסה הנכונה, אתם צריכים להשתמש בשם המשאב המלא:
עבור
v1alpha2:kubectl get inferencepools.inference.networking.x-k8s.ioעבור
v1:kubectl get inferencepools.inference.networking.k8s.io
ב-API של v1 יש גם שם מקוצר ונוח, infpool, שבו אפשר להשתמש כדי לשלוח שאילתות למשאבים של v1 באופן ספציפי:
kubectl get infpool
שלב 1: פריסה של גרסה 1 לצד גרסה 2
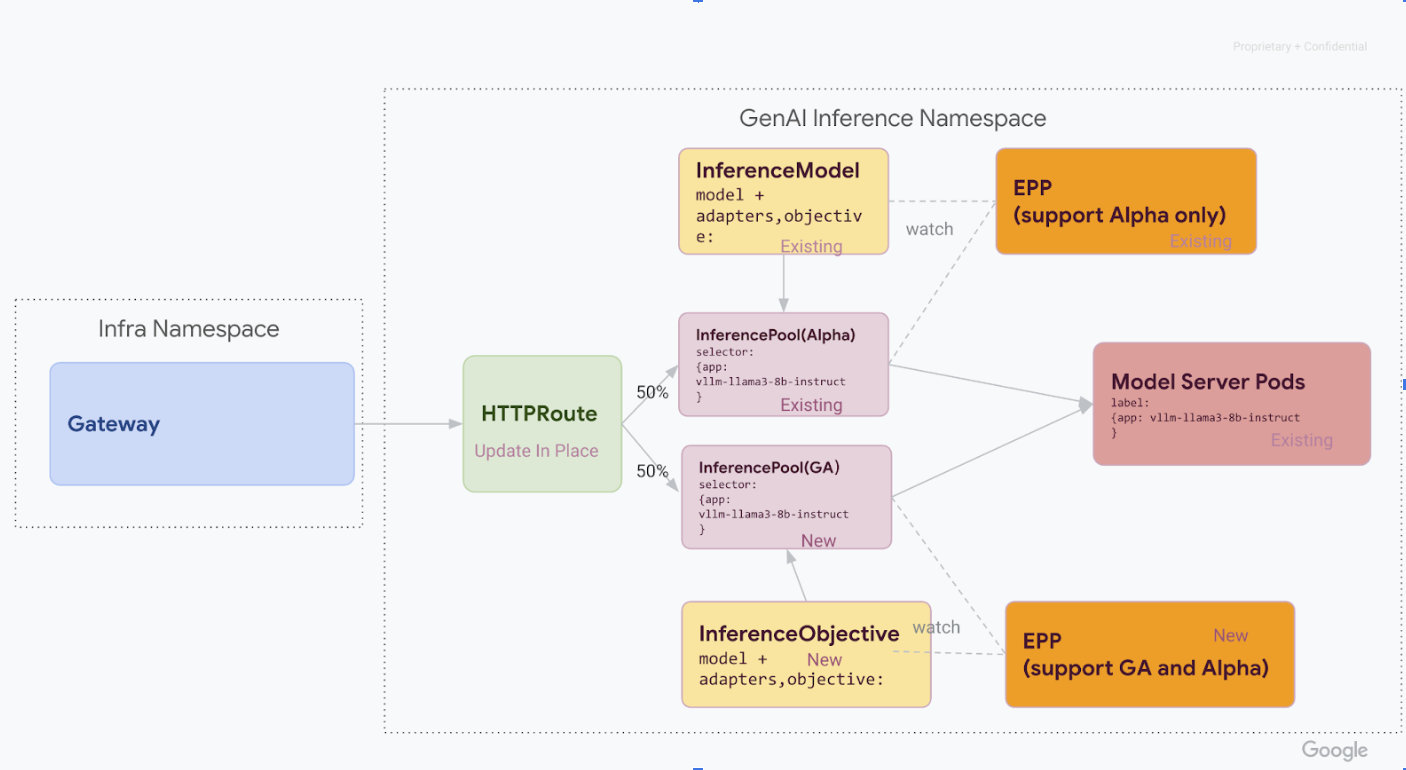
בשלב הזה, פורסים את מחסנית v1 InferencePool החדשה לצד מחסנית v1alpha2 הקיימת, וכך מתאפשרת העברה בטוחה והדרגתית.
אחרי שתסיימו את כל השלבים, תהיה לכם התשתית שמוצגת בתרשים הבא:
מתקינים את ההגדרות הנדרשות של משאבים מותאמים אישית (CRD) באשכול GKE:
- בגרסאות GKE קודמות לגרסה
1.34.0-gke.1626000, מריצים את הפקודה הבאה כדי להתקין את ה-CRD של גרסה v1InferencePoolואת ה-CRD של גרסת אלפאInferenceObjective:
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v1.0.0/manifests.yaml- בגרסאות GKE
1.34.0-gke.1626000ואילך, מתקינים רק את ה-CRD של אלפאInferenceObjectiveבאמצעות הפקודה הבאה:
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/raw/v1.0.0/config/crd/bases/inference.networking.x-k8s.io_inferenceobjectives.yaml- בגרסאות GKE קודמות לגרסה
מתקינים את
v1 InferencePool.משתמשים ב-Helm כדי להתקין
v1 InferencePoolחדש עם שם גרסה ייחודי, כמוvllm-llama3-8b-instruct-ga. ה-InferencePoolצריך לטרגט לאותם פודים של שרת המודל כמו ה-InferencePoolשל גרסת האלפא, באמצעותinferencePool.modelServers.matchLabels.app.כדי להתקין את
InferencePool, משתמשים בפקודה הבאה:helm install vllm-llama3-8b-instruct-ga \ --set inferencePool.modelServers.matchLabels.app=MODEL_SERVER_DEPLOYMENT_LABEL \ --set provider.name=gke \ --version RELEASE \ oci://registry.k8s.io/gateway-api-inference-extension/charts/inferencepoolמחליפים את מה שכתוב בשדות הבאים:
-
MODEL_SERVER_DEPLOYMENT_LABEL: התווית שמשמשת את פודי שרת המודל הקיים (לדוגמה,vllm-llama3-8b-instruct-preview). -
RELEASE: הגרסה של תרשים ה-Helm של v1 Gateway API Inference Extension שרוצים להתקין
-
יצירת משאבים מסוג
v1alpha2 InferenceObjective.במסגרת המעבר לגרסה 1.0 של Gateway API Inference Extension, צריך גם לעבור מ-API אלפא
InferenceModelל-API החדשInferenceObjective.מחילים את קובץ ה-YAML הבא כדי ליצור את משאבי
InferenceObjective:kubectl apply -f - <<EOF --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: food-review spec: priority: 2 poolRef: group: inference.networking.k8s.io name: vllm-llama3-8b-instruct-ga --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: base-model spec: priority: 2 poolRef: group: inference.networking.k8s.io name: vllm-llama3-8b-instruct-ga --- EOF
שלב 2: העברת התנועה
אחרי ששתי החבילות יפעלו, תוכלו להתחיל להעביר תנועה מ-v1alpha2 אל v1 על ידי עדכון HTTPRoute כדי לפצל את התנועה. בדוגמה הזו מוצגת חלוקה של 50-50.
מעדכנים את HTTPRoute לפיצול התנועה.
כדי לעדכן את
HTTPRouteלפיצול תנועה, מריצים את הפקודה הבאה:kubectl apply -f - <<EOF --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: llm-route spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: inference-gateway rules: - backendRefs: - group: inference.networking.x-k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-preview weight: 50 - group: inference.networking.k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-ga weight: 50 --- EOFאימות ומעקב.
אחרי שמחילים את השינויים, חשוב לעקוב אחרי הביצועים והיציבות של מחסנית
v1החדשה. מוודאים שהסטטוס של שער ה-inference-gatewayהואPROGRAMMED, ושהערך שלו הואTRUE.
שלב 3: סיום וניקוי
אחרי שמוודאים ש-v1 InferencePool יציב, אפשר להפנות אליו את כל התנועה ולהוציא משימוש את המשאבים הישנים של v1alpha2.
מעבירים 100% מהתנועה אל
v1 InferencePool.כדי להעביר 100% מהתנועה אל
v1 InferencePool, מריצים את הפקודה הבאה:kubectl apply -f - <<EOF --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: llm-route spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: inference-gateway rules: - backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-ga weight: 100 --- EOFמבצעים אימות סופי.
אחרי שמפנים את כל התנועה למקבץ
v1, מוודאים שהוא מטפל בכל התנועה כמו שצריך.מוודאים שהסטטוס של השער הוא
PROGRAMMED:kubectl get gateway -o wideהפלט שאתם מקבלים אמור להיראות כך:
NAME                CLASS                              ADDRESS           PROGRAMMED   AGE
inference-gateway   gke-l7-regional-external-managed   <IP_ADDRESS>   True                     10m
כדי לאמת את נקודת הקצה, שולחים בקשה:
IP=$(kubectl get gateway/inference-gateway -o jsonpath='{.status.addresses[0].value}')
PORT=80
curl -i ${IP}:${PORT}/v1/completions -H 'Content-Type: application/json' -d '{
"model": "YOUR_MODEL",
"prompt": "YOUR_PROMPT",
"max_tokens": 100,
"temperature": 0
}'
מוודאים שמקבלים תגובה מוצלחת עם קוד תגובה
200.
מחיקת משאבי v1alpha2
אחרי שמוודאים שהמקבץ של
v1פועל באופן מלא, מסירים בבטחה את המשאבים הישנים שלv1alpha2.בדיקה אם נשארו משאבים ב-
v1alpha2עכשיו, אחרי שביצעתם מיגרציה ל-API
v1InferencePool, אפשר למחוק את ה-CRD הישנים. בודקים אם יש ממשקי API קיימים בגרסה v1alpha2 כדי לוודא שאין יותר משאביv1alpha2בשימוש. אם נשארו לכם עוד כמה, אתם יכולים להמשיך את תהליך ההעברה עבורם.מחיקת
v1alpha2CRDאחרי שכל המשאבים המותאמים אישית של
v1alpha2נמחקו, מסירים את הגדרות המשאבים המותאמים אישית (CRD) מהאשכול:kubectl delete -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v0.3.0/manifests.yamlאחרי השלמת כל השלבים, התשתית שלכם אמורה להיראות כמו בדיאגרמה הבאה:
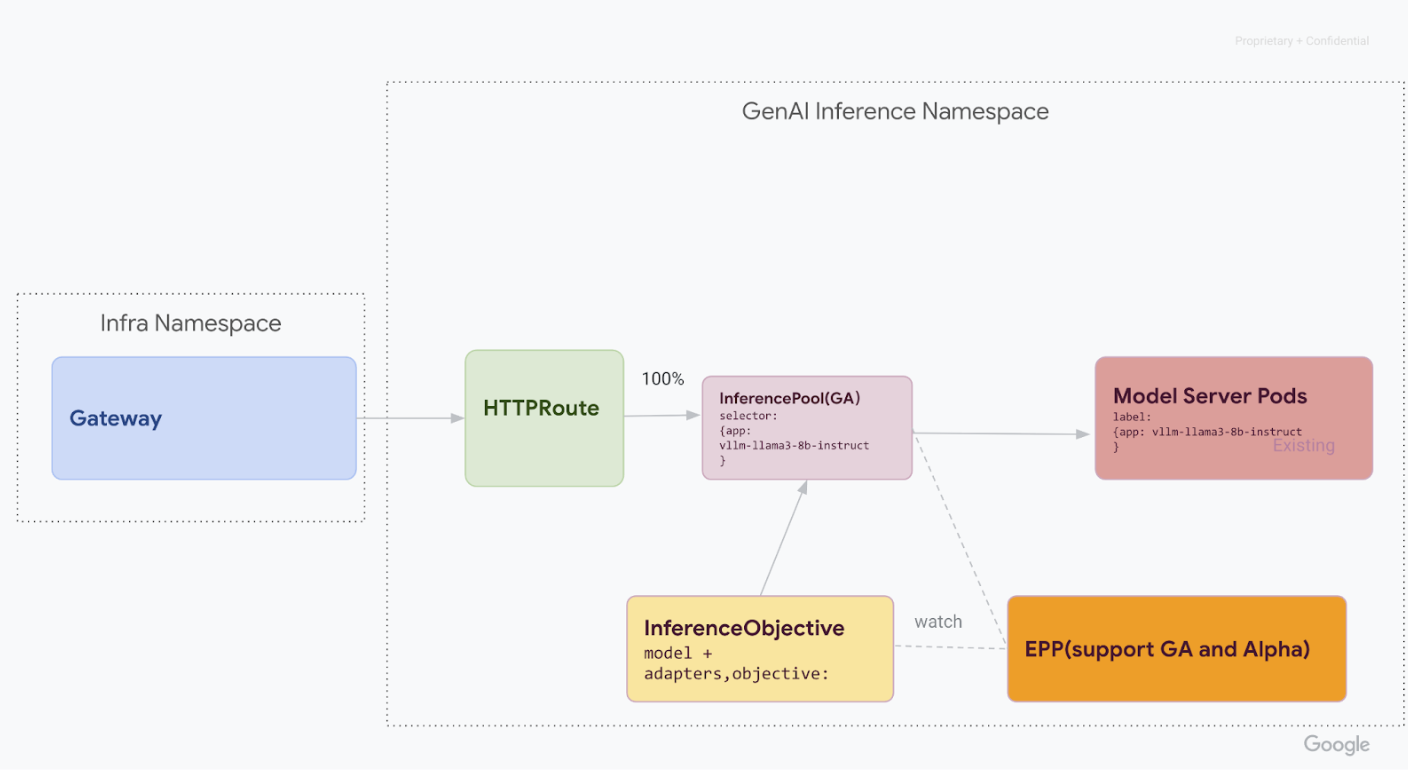
איור: GKE Inference Gateway מעביר בקשות ניתוב למודלים שונים של AI גנרטיבי על סמך שם המודל והעדיפות