


Esta página disponibiliza uma visão geral das funções do GKE Dataplane V2 e como ele funciona.
Nesta página, consideramos que você conhece a rede nos clusters do GKE.
Visão geral do GKE Dataplane V2
O GKE Dataplane V2 é um plano de dados otimizado para a rede do Kubernetes. O GKE Dataplane V2 oferece o seguinte:
- Experiência do usuário consistente na rede.
- visibilidade em tempo real da atividade da rede;
- arquitetura mais simples que facilita o gerenciamento e a solução de problemas de clusters.
O GKE Dataplane V2 é ativado por padrão para todos os novos clusters do Autopilot.
Como o GKE Dataplane V2 funciona
O GKE Dataplane V2 é implementado usando o eBPF.
À medida que os pacotes chegam a um nó do GKE, os programas eBPF instalados no kernel decidem como rotear e processar os pacotes. Ao contrário do processamento de pacotes
com iptables, os programas eBPF podem usar metadados específicos do Kubernetes no pacote. Isso permite que o GKE Dataplane V2 processe pacotes de rede no kernel com mais eficiência e relate ações anotadas de volta ao espaço do usuário para geração de registros.
O diagrama a seguir mostra o caminho de um pacote ao longo de um nó usando o GKE Dataplane V2:
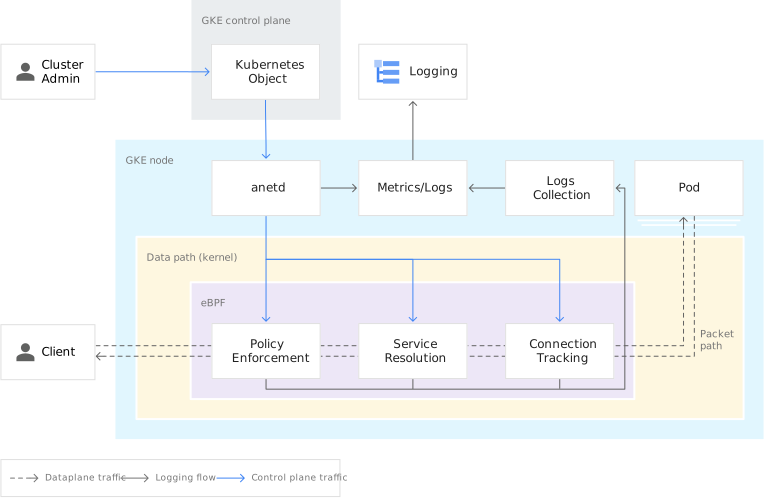
O GKE implanta o controlador do GKE Dataplane V2 como um DaemonSet chamado anetd em cada nó no cluster. anetd interpreta objetos do Kubernetes
e programa topologias de rede no eBPF. Os pods anetd são executados no
namespace kube-system.
GKE Dataplane V2 e NetworkPolicy
O GKE Dataplane V2 é implementado usando o Cilium. O plano de dados legado do GKE é implementado usando o Calico.
Ambas as tecnologias gerenciam o NetworkPolicy do Kubernetes.
O Cilium usa o eBPF e a interface de rede de contêiner (CNI, na sigla em inglês) do Calico usa a iptables no kernel do Linux.
Programas eBPF personalizados
O GKE Dataplane V2 usa programas eBPF para gerenciar o tráfego de rede, incluindo roteamento, balanceamento de carga e aplicação da política de rede. Como esses programas são essenciais para a conectividade de rede, o GKE não oferece suporte à instalação de programas eBPF personalizados em nós que usam o GKE Dataplane V2. Programas eBPF personalizados podem interferir nos programas do GKE Dataplane V2 e prejudicar a rede do cluster.
Se um programa eBPF personalizado for detectado no seu cluster, o GKE vai fornecer uma recomendação informando sobre a presença dele.
Vantagens do GKE Dataplane V2
O GKE Dataplane V2 oferece os seguintes benefícios:
Escalonabilidade
O GKE Dataplane V2 tem características de escalonabilidade diferentes do plano de dados legado.
Para versões do GKE em que o GKE Dataplane V2
não usa kube-proxy
e não depende do iptables para roteamento de serviço, o GKE remove
alguns gargalos relacionados ao iptables, como o número de Serviços.
O GKE Dataplane V2 depende de mapas eBPF limitados a 260.000 endpoints em todos os serviços.
Segurança
A NetworkPolicy do Kubernetes está sempre ativada em clusters com o GKE Dataplane V2. Não é preciso instalar e gerenciar complementos de software de terceiros, como o Calico, para aplicar a política de rede.
Operações
Quando você cria um cluster com o GKE Dataplane V2, a geração de registros de política de rede é integrada. Configure a CRD da geração de registros no cluster para ver quando as conexões são permitidas e negadas pelos pods.
Consistência
O GKE Dataplane V2 oferece uma experiência de rede consistente.
Para mais informações, consulte Disponibilidade do GKE Dataplane V2.
Especificações técnicas do GKE Dataplane V2
O GKE Dataplane V2 aceita clusters com as seguintes especificações:
| Especificação | GKE | Google Distributed Cloud Edge | Google Distributed Cloud Hosted |
|---|---|---|---|
| Número de nós por cluster | 15.000 | 500 | 500 |
| Número de pods por cluster | 400.000 | 15.000 | 27.500 |
| Número de pods por trás de um serviço | 10.000 | 1.000 | 1.000 |
| Número de serviços de IP de cluster | 10.000 | 1.000 | 1.000 |
| Número de serviços do LoadBalancer por cluster | 750 | 500 | 1.000 |
O GKE Dataplane V2 mantém um mapa de serviços para acompanhar quais serviços se referem a quais pods como back-ends. O número de back-ends de pods de cada serviço somado em todos os serviços precisa caber no mapa, que pode conter até 260.000 entradas. Se esse limite for excedido, talvez o cluster não funcione conforme o esperado.
Limites de nós
O número máximo de nós por cluster depende da localização do cluster do GKE Dataplane V2:
- Clusters regionais: até 5.000, 15.000 ou 65.000 nós por cluster. Nem todos os aumentos de nós são automáticos. Dependendo da contagem de nós de destino, há requisitos de infraestrutura específicos, e talvez seja necessário entrar em contato com o Cloud Customer Care. Para escalonar até 65.000 nós,é necessário o modo otimizado para escalonamento do Dataplane V2, que desativa a aplicação da política de rede. Para informações detalhadas, consulte Limites e requisitos de tamanho do cluster.
- Clusters zonais: até 1.000 nós.
Para atingir limites de escalonamento de nós além de 5.000 nós em clusters regionais, seu ambiente precisa atender às seguintes condições:
- O cluster precisa ter o Private Service Connect ativado. Para verificar se o cluster usa o Private Service Connect, consulte Clusters com o Private Service Connect.
- Os clusters que usam o CRD CiliumNetworkPolicy estão restritos aos limites de cluster zonais de até 1.000 nós. Use a CRD CiliumClusterwideNetworkPolicy para oferecer suporte ao escalonamento de até 5.000 nós.
Serviços LoadBalancer no Google Distributed Cloud
O número de serviços LoadBalancer aceitos no Google Distributed Cloud depende as modo do balanceador de carga que está sendo usado. O Google Distributed Cloud oferece suporte a 500 serviços LoadBalancer ao usar modo de balanceamento de carga em pacote (Seesaw) e 250 ao usar a carga integrada de balanceamento de carga com F5. Para mais informações, consulte Escalonabilidade.
Suporte do Maglev
Para clusters do GKE que executam a versão 1.36.0-gke.2882000 e mais recentes, é possível configurar os serviços para usar o algoritmo hashing consistente Maglev para seleção de back-end.
Por padrão, os serviços do Kubernetes usam o algoritmo random para selecionar back-ends. O algoritmo random pode fazer com que conexões íntegras sejam redirecionadas e redefinidas quando o conjunto de pods de back-end muda (por exemplo, durante eventos de escalonamento). O Maglev atenua isso continuando a rotear o tráfego para o back-end atribuído de uma conexão enquanto ele permanece íntegro, mesmo quando outros pods são adicionados ou removidos.
Benefícios de usar o algoritmo Maglev
O uso do algoritmo Maglev oferece os seguintes benefícios:
- Ela pode melhorar a estabilidade da conexão direcionando o tráfego de uma conexão para o mesmo back-end.
- Ele pode reduzir problemas de conexão quando pods de back-end são adicionados ou removidos, por exemplo, durante reinicializações de pods.
Limitações do uso do algoritmo Maglev
O uso do algoritmo Maglev pode consumir muitos recursos:
- Isso pode aumentar o uso da memória em
anetdem todos os clusters. Para mais informações, consulte a próxima seção, "Considerações sobre o uso da memória do Maglev". - Isso pode estar relacionado a um uso maior da CPU
anetd(até três vezes mais) durante as mudanças no back-end.
Considerações sobre o uso da memória do Maglev
Para rastrear conexões e back-ends, o algoritmo Maglev usa uma tabela hash: ele faz o hash da 5-tupla do pacote (endereço IP de origem, endereço IP de destino, porta de origem, porta de destino e protocolo).
O tamanho da tabela de pesquisa é configurado para 16.381 entradas. Como cada entrada tem um tamanho de 4 bytes, um serviço configurado para usar o algoritmo Maglev requer 65,5 KB (16.381 × 4 bytes) da memória alocável de cada nó.
| Número de serviços com o Maglev ativado | Uso adicional de memória |
|---|---|
| 100 | 6,5 MB |
| 1.000 | 65 MB |
| 10.000 | 650 MB |
Aplicar o algoritmo Maglev
Para aplicar o algoritmo Maglev a um serviço do tipo NodePort ou LoadBalancer,
adicione a anotação gke.networking.io/lb-algorithm: "maglev" aos metadados do serviço
durante a criação dele.
Exemplo:
apiVersion: v1
kind: Service
metadata:
  name: maglev-service
  annotations:
    gke.networking.io/lb-algorithm: "maglev"
spec:
  type: LoadBalancer
  selector:
    app: application
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
A anotação gke.networking.io/lb-algorithm entra em vigor durante a criação do serviço. Para mudar o algoritmo de um serviço, é preciso excluir e
recriar o serviço. Mudar o valor da anotação sem recriá-la causa um comportamento inconsistente. O anetd em novos nós tenta usar o algoritmo recém-configurado, enquanto os pods atuais continuam usando o algoritmo anterior.
Implantar cargas de trabalho com SCTP
É possível implantar cargas de trabalho que usam o protocolo de transmissão de controle de fluxo (SCTP) em clusters ativados com o GKE Dataplane V2. O SCTP é um protocolo de camada de transporte que oferece transmissão confiável e orientada a mensagens. Para mais informações, consulte Implantar cargas de trabalho com SCTP.
Limitações
O GKE Dataplane V2 tem as seguintes limitações:
- O GKE Dataplane V2 só pode ser ativado ao criar um novo cluster. Os clusters atuais não podem ser atualizados para usar o GKE Dataplane V2.
- Os balanceadores de carga de rede de passagem internos que foram criados manualmente e associados a um serviço do tipo NodePort não são compatíveis.
- O GKE Dataplane V2 usa
ciliumem vez dekube-proxypara implementar os serviços do Kubernetes. Okube-proxyé mantido e desenvolvido pela comunidade do Kubernetes. Portanto, é mais provável que novos recursos para serviços sejam implementados emkube-proxyantes de serem implementados emciliumpara o GKE Dataplane V2. - Em alguns casos, os pods do agente do GKE Dataplane V2 (
anetd) podem consumir uma quantidade significativa de recursos de CPU, até duas ou três vCPUs por instância. Isso ocorre quando há um grande volume de conexões TCP abertas e fechadas rapidamente no nó. Para atenuar esse problema, recomendamos a implementação de sinais de atividade para chamadas HTTP e o pool de conexões para as cargas de trabalho relevantes. O uso da memória informado dos pods do agente do GKE Dataplane V2 (
anetd) depende da memória total disponível no nó. Os nós com mais memória total informam um uso da memória maior para os podsanetd. Os podsanetdnão usam mais memória. O uso informado aumenta porque essa métrica inclui a reserva de memória do mapa eBPF.No GKE, a reserva de memória para os maiores mapas eBPF é de 0,25% da memória total do nó. Outra memória pode ser reservada para outros recursos específicos do GKE.
O GKE Dataplane V2 usa o eBPF para gerenciar o tráfego de rede do cluster. Se você instalar um aplicativo de terceiros que também usa eBPF, ele poderá interferir no GKE Dataplane V2. Por exemplo, usar o Retina com o GKE Dataplane V2 pode impedir que seus pods se conectem aos serviços. Isso acontece porque os programas eBPF do Retina podem prejudicar a forma como o GKE Dataplane V2 roteia o tráfego. Se você encontrar mensagens de erro indicando que o tráfego está sendo descartado porque está tentando alcançar o endereço IP do serviço diretamente, talvez você esteja enfrentando esse problema. Isso acontece porque os pods não podem acessar diretamente o endereço IP do serviço, e o tráfego precisa passar pelos mecanismos de roteamento do Dataplane V2. Para mais informações, consulte Problemas de incompatibilidade com a tela Retina.
Pacotes ICMP fragmentados não são compatíveis e são descartados pelo GKE Dataplane V2.
Aplicação da política de rede sem o GKE Dataplane V2
Consulte Como usar a aplicação de política de rede para instruções sobre como ativar a aplicação de política de rede em clusters que não usam o GKE Dataplane V2.
A seguir
- Leia Como usar o GKE Dataplane V2.
- Saiba mais sobre a observabilidade do GKE Dataplane V2.
- Saiba como usar a geração de registros de políticas de rede.
- Veja em quais ambientes de cluster do GKE Enterprise o GKE Dataplane V2 está disponível.