


Halaman ini menjelaskan konsep dan fitur utama Gateway Inferensi Google Kubernetes Engine (GKE), ekstensi ke Gateway GKE untuk penyajian aplikasi AI generatif yang dioptimalkan.
Halaman ini mengasumsikan bahwa Anda sudah mengetahui hal-hal berikut:
- Orkestrasi AI/ML di GKE
- Terminologi AI generatif
- Konsep jaringan GKE, termasuk Layanan, dan GKE Gateway API
- Load balancing di Google Cloud, terutama cara load balancer berinteraksi dengan GKE
Halaman ini ditujukan untuk persona berikut:
- Engineer machine learning (ML), Admin dan operator platform, serta Pakar Data dan AI yang tertarik menggunakan kemampuan orkestrasi container Kubernetes untuk menyajikan workload AI/ML.
- Arsitek cloud dan spesialis Jaringan yang berinteraksi dengan jaringan Kubernetes.
Ringkasan
GKE Inference Gateway adalah ekstensi untuk GKE Gateway yang menyediakan perutean dan load balancing yang dioptimalkan untuk menyajikan workload Kecerdasan Buatan (AI) generatif. Layanan ini menyederhanakan deployment, pengelolaan, dan kemampuan pengamatan workload inferensi AI. GKE Inference Gateway tersedia tanpa biaya tambahan. Anda hanya membayar Google Cloud resource dasar yang digunakan.
Untuk memilih strategi load balancing yang optimal untuk workload AI/ML Anda, lihat Memilih strategi load balancing untuk inferensi AI di GKE.
Fitur dan manfaat
GKE Inference Gateway menyediakan kemampuan utama berikut untuk menyajikan model AI generatif secara efisien untuk aplikasi AI generatif di GKE:
- Metrik yang didukung:
KV cache hits: jumlah pencarian yang berhasil di cache nilai kunci (KV).- Penggunaan GPU atau TPU: persentase waktu GPU atau TPU memproses secara aktif.
- Panjang antrean permintaan: jumlah permintaan yang menunggu untuk diproses.
- Load balancing yang dioptimalkan untuk inferensi: mendistribusikan permintaan untuk mengoptimalkan performa penyajian model AI. Solusi ini menggunakan metrik dari server model, seperti
KV cache hitsdanqueue length of pending requestsuntuk menggunakan akselerator (seperti GPU dan TPU) secara lebih efisien untuk workload AI generatif. Hal ini memungkinkan Perutean yang Peka terhadap Cache Awalan, fitur utama yang mengirimkan permintaan dengan konteks bersama, yang diidentifikasi dengan menganalisis isi permintaan, ke replika model yang sama dengan memaksimalkan cache ditemukan. Pendekatan ini secara signifikan mengurangi komputasi yang berlebihan dan meningkatkan Time-to-First-Token, sehingga sangat efektif untuk AI percakapan, Retrieval-Augmented Generation (RAG), dan beban kerja AI generatif berbasis template lainnya. - Penyajian model yang disesuaikan dengan LoRA dinamis: mendukung penyajian model yang disesuaikan dengan LoRA dinamis pada akselerator umum. Hal ini mengurangi jumlah GPU dan TPU yang diperlukan untuk menyajikan model dengan melakukan multiplexing beberapa model yang telah disesuaikan dengan LoRA pada model dasar dan akselerator umum.
- Penskalaan otomatis yang dioptimalkan untuk inferensi: Horizontal Pod Autoscaler (HPA) GKE menggunakan metrik server model untuk melakukan penskalaan otomatis, yang membantu memastikan penggunaan resource komputasi yang efisien dan performa inferensi yang dioptimalkan.
- Pemilihan rute berbasis model: merutekan permintaan inferensi berdasarkan nama model yang ditentukan dalam spesifikasi
OpenAI APIdalam cluster GKE Anda. Anda dapat menentukan kebijakan perutean Gateway, seperti pemisahan traffic dan pencerminan permintaan, untuk mengelola berbagai versi model dan menyederhanakan peluncuran model. Misalnya, Anda dapat merutekan permintaan untuk nama model tertentu ke objek InferencePool yang berbeda, yang masing-masing menyajikan versi model yang berbeda. Untuk mengetahui informasi selengkapnya tentang cara mengonfigurasi hal ini, lihat Mengonfigurasi Perutean Berbasis Isi. - Pemfilteran konten dan keamanan AI terintegrasi: GKE Inference Gateway terintegrasi dengan Google Cloud Model Armor untuk menerapkan pemeriksaan keamanan AI dan pemfilteran konten pada perintah dan respons di gateway. Anda juga dapat menggunakan NVIDIA NeMo Guardrails. Model Armor menyediakan log permintaan, respons, dan pemrosesan untuk analisis dan pengoptimalan retrospektif. Antarmuka terbuka GKE Inference Gateway memungkinkan penyedia dan developer pihak ketiga mengintegrasikan layanan kustom ke dalam proses permintaan inferensi.
- Penyaluran khusus model
Priority: memungkinkan Anda menentukan penyaluranPrioritymodel AI. Prioritaskan permintaan yang sensitif terhadap latensi daripada tugas inferensi batch yang toleran terhadap latensi. Misalnya, Anda dapat memprioritaskan permintaan dari aplikasi yang sensitif terhadap latensi dan membatalkan tugas yang kurang sensitif terhadap waktu saat resource terbatas. - Perutean berbasis latensi yang diprediksi: merutekan permintaan inferensi menggunakan model XGBoost yang dilatih secara berkelanjutan pada traffic live, mengoptimalkan tujuan Time-to-First-Token (TTFT) dan Time-per-Output-Token (TPOT) per permintaan. Lebih akurat daripada heuristik statis dalam workload dengan varians tinggi. Lihat Menggunakan perutean berbasis latensi yang diprediksi dengan GKE Inference Gateway.
- Kemampuan observasi inferensi: menyediakan metrik kemampuan observasi untuk permintaan inferensi, seperti rasio permintaan, latensi, error, dan saturasi. Pantau performa dan perilaku layanan inferensi Anda melalui Cloud Monitoring dan Cloud Logging, dengan memanfaatkan dasbor bawaan khusus untuk mendapatkan insight mendetail. Untuk mengetahui informasi selengkapnya, lihat Melihat dasbor GKE Inference Gateway.
- Konfigurasi CORS: mendukung Cross-Origin Resource Sharing (CORS) pada
resource
HTTPRoute. CORS membantu aplikasi web yang berjalan di domain yang berbeda mengakses endpoint inferensi Anda dengan aman. CORS didukung untuk Gateway cluster tunggal. - Pengelolaan API Tingkat Lanjut dengan Apigee: terintegrasi dengan Apigee untuk meningkatkan kualitas gateway inferensi Anda dengan fitur seperti keamanan API, pembatasan kapasitas, dan kuota. Untuk mengetahui petunjuk mendetail, lihat Mengonfigurasi Apigee untuk autentikasi dan pengelolaan API.
- Ekstensibilitas: dibangun di Ekstensi Inferensi Kubernetes Gateway API open source yang dapat diperluas yang mendukung algoritma Pemilih Endpoint (EPP) llm-d yang dikelola pengguna, yang didukung oleh llm-d. Algoritma Pemilih Endpoint (EPP) llm-d, yang didukung oleh llm-d, menyediakan kecerdasan perutean inti untuk ekstensi ini.
- Dukungan multi-port: mendukung server model yang mengekspos beberapa port, yang penting untuk skenario inferensi lanjutan seperti perhatian Paralel Data.
- Batas Grup Endpoint Jaringan (NEG): memiliki batas 50 NEG per Google Cloud Layanan Backend. Saat menggunakan InferencePool multi-port, setiap port di setiap zona akan membuat NEG khusus. Misalnya, InferencePool dengan delapan port di cluster regional standar (tiga zona) menghasilkan 24 NEG. Oleh karena itu, Gateway multi-cluster hanya dapat menggabungkan InferencePool tersebut dari maksimum dua cluster (dua cluster × 24 NEG = 48 NEG) sebelum mencapai batas 50 NEG.
Memahami konsep utama
GKE Inference Gateway meningkatkan GKE Gateway yang ada yang menggunakan objek GatewayClass. GKE Inference Gateway memperkenalkan Custom Resource Definition (CRD) Gateway API baru berikut, yang selaras dengan ekstensi Gateway API Kubernetes OSS untuk Inferensi:
- Objek InferencePool: mewakili grup Pod (container) yang
memiliki konfigurasi komputasi, jenis akselerator, model bahasa dasar,
dan server model yang sama. Hal ini secara logis mengelompokkan dan mengelola resource penayangan model AI Anda. Satu objek InferencePool dapat mencakup beberapa Pod di berbagai node GKE serta memberikan skalabilitas dan ketersediaan tinggi. Anda dapat menentukan hingga delapan
targetPortsdalam resource InferencePool untuk mendukung server model yang memerlukan beberapa port. - Objek InferenceObjective: menentukan nama model inferensi dari InferencePool sesuai dengan spesifikasi
OpenAI API. Objek InferenceObjective juga menentukan properti penayangan model, sepertiPrioritymodel AI. GKE Inference Gateway memberikan preferensi pada workload dengan nilai prioritas yang lebih tinggi. Dengan begitu, Anda dapat melakukan multipleks workload AI yang mementingkan latensi dan toleran terhadap latensi di cluster GKE. Anda juga dapat mengonfigurasi objek InferenceObjective untuk menayangkan model yang di-fine-tune LoRA.
Diagram berikut mengilustrasikan GKE Inference Gateway dan integrasinya dengan keamanan AI, kemampuan observasi, dan penyajian model dalam cluster GKE.
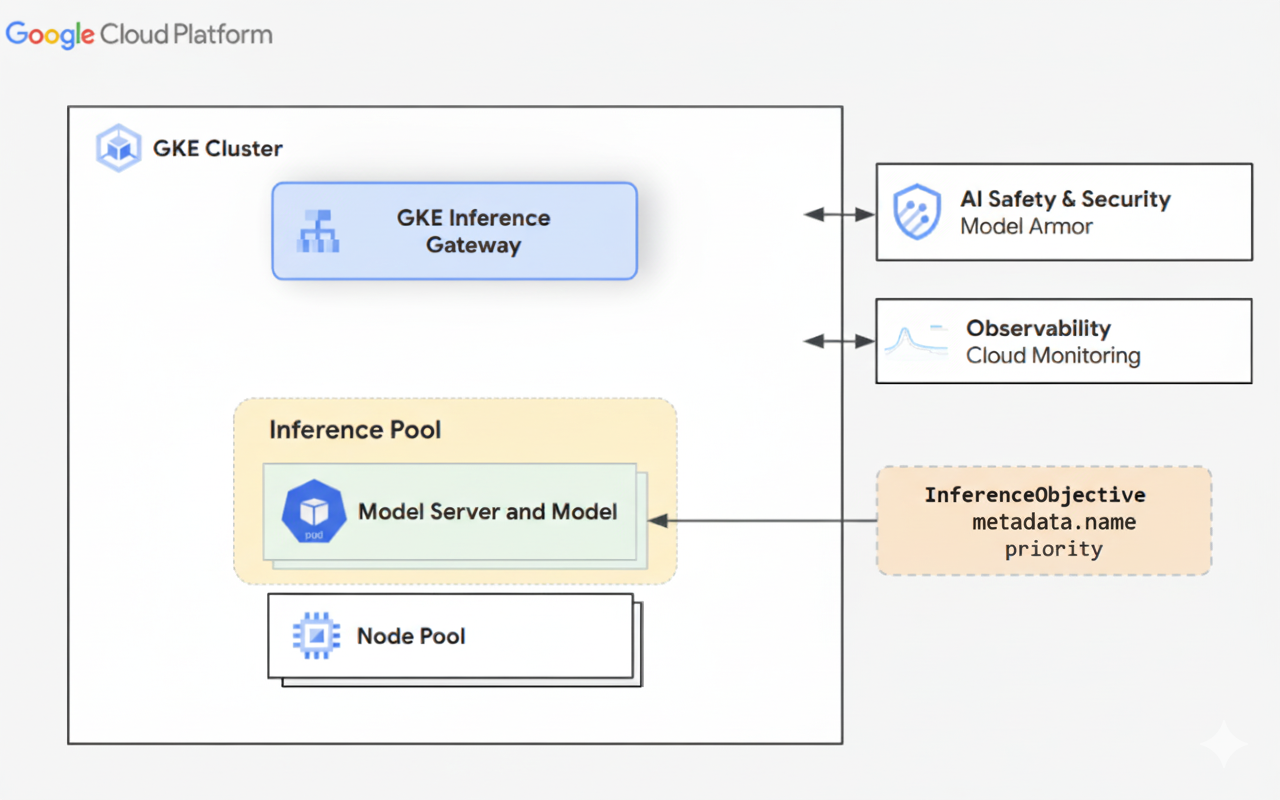
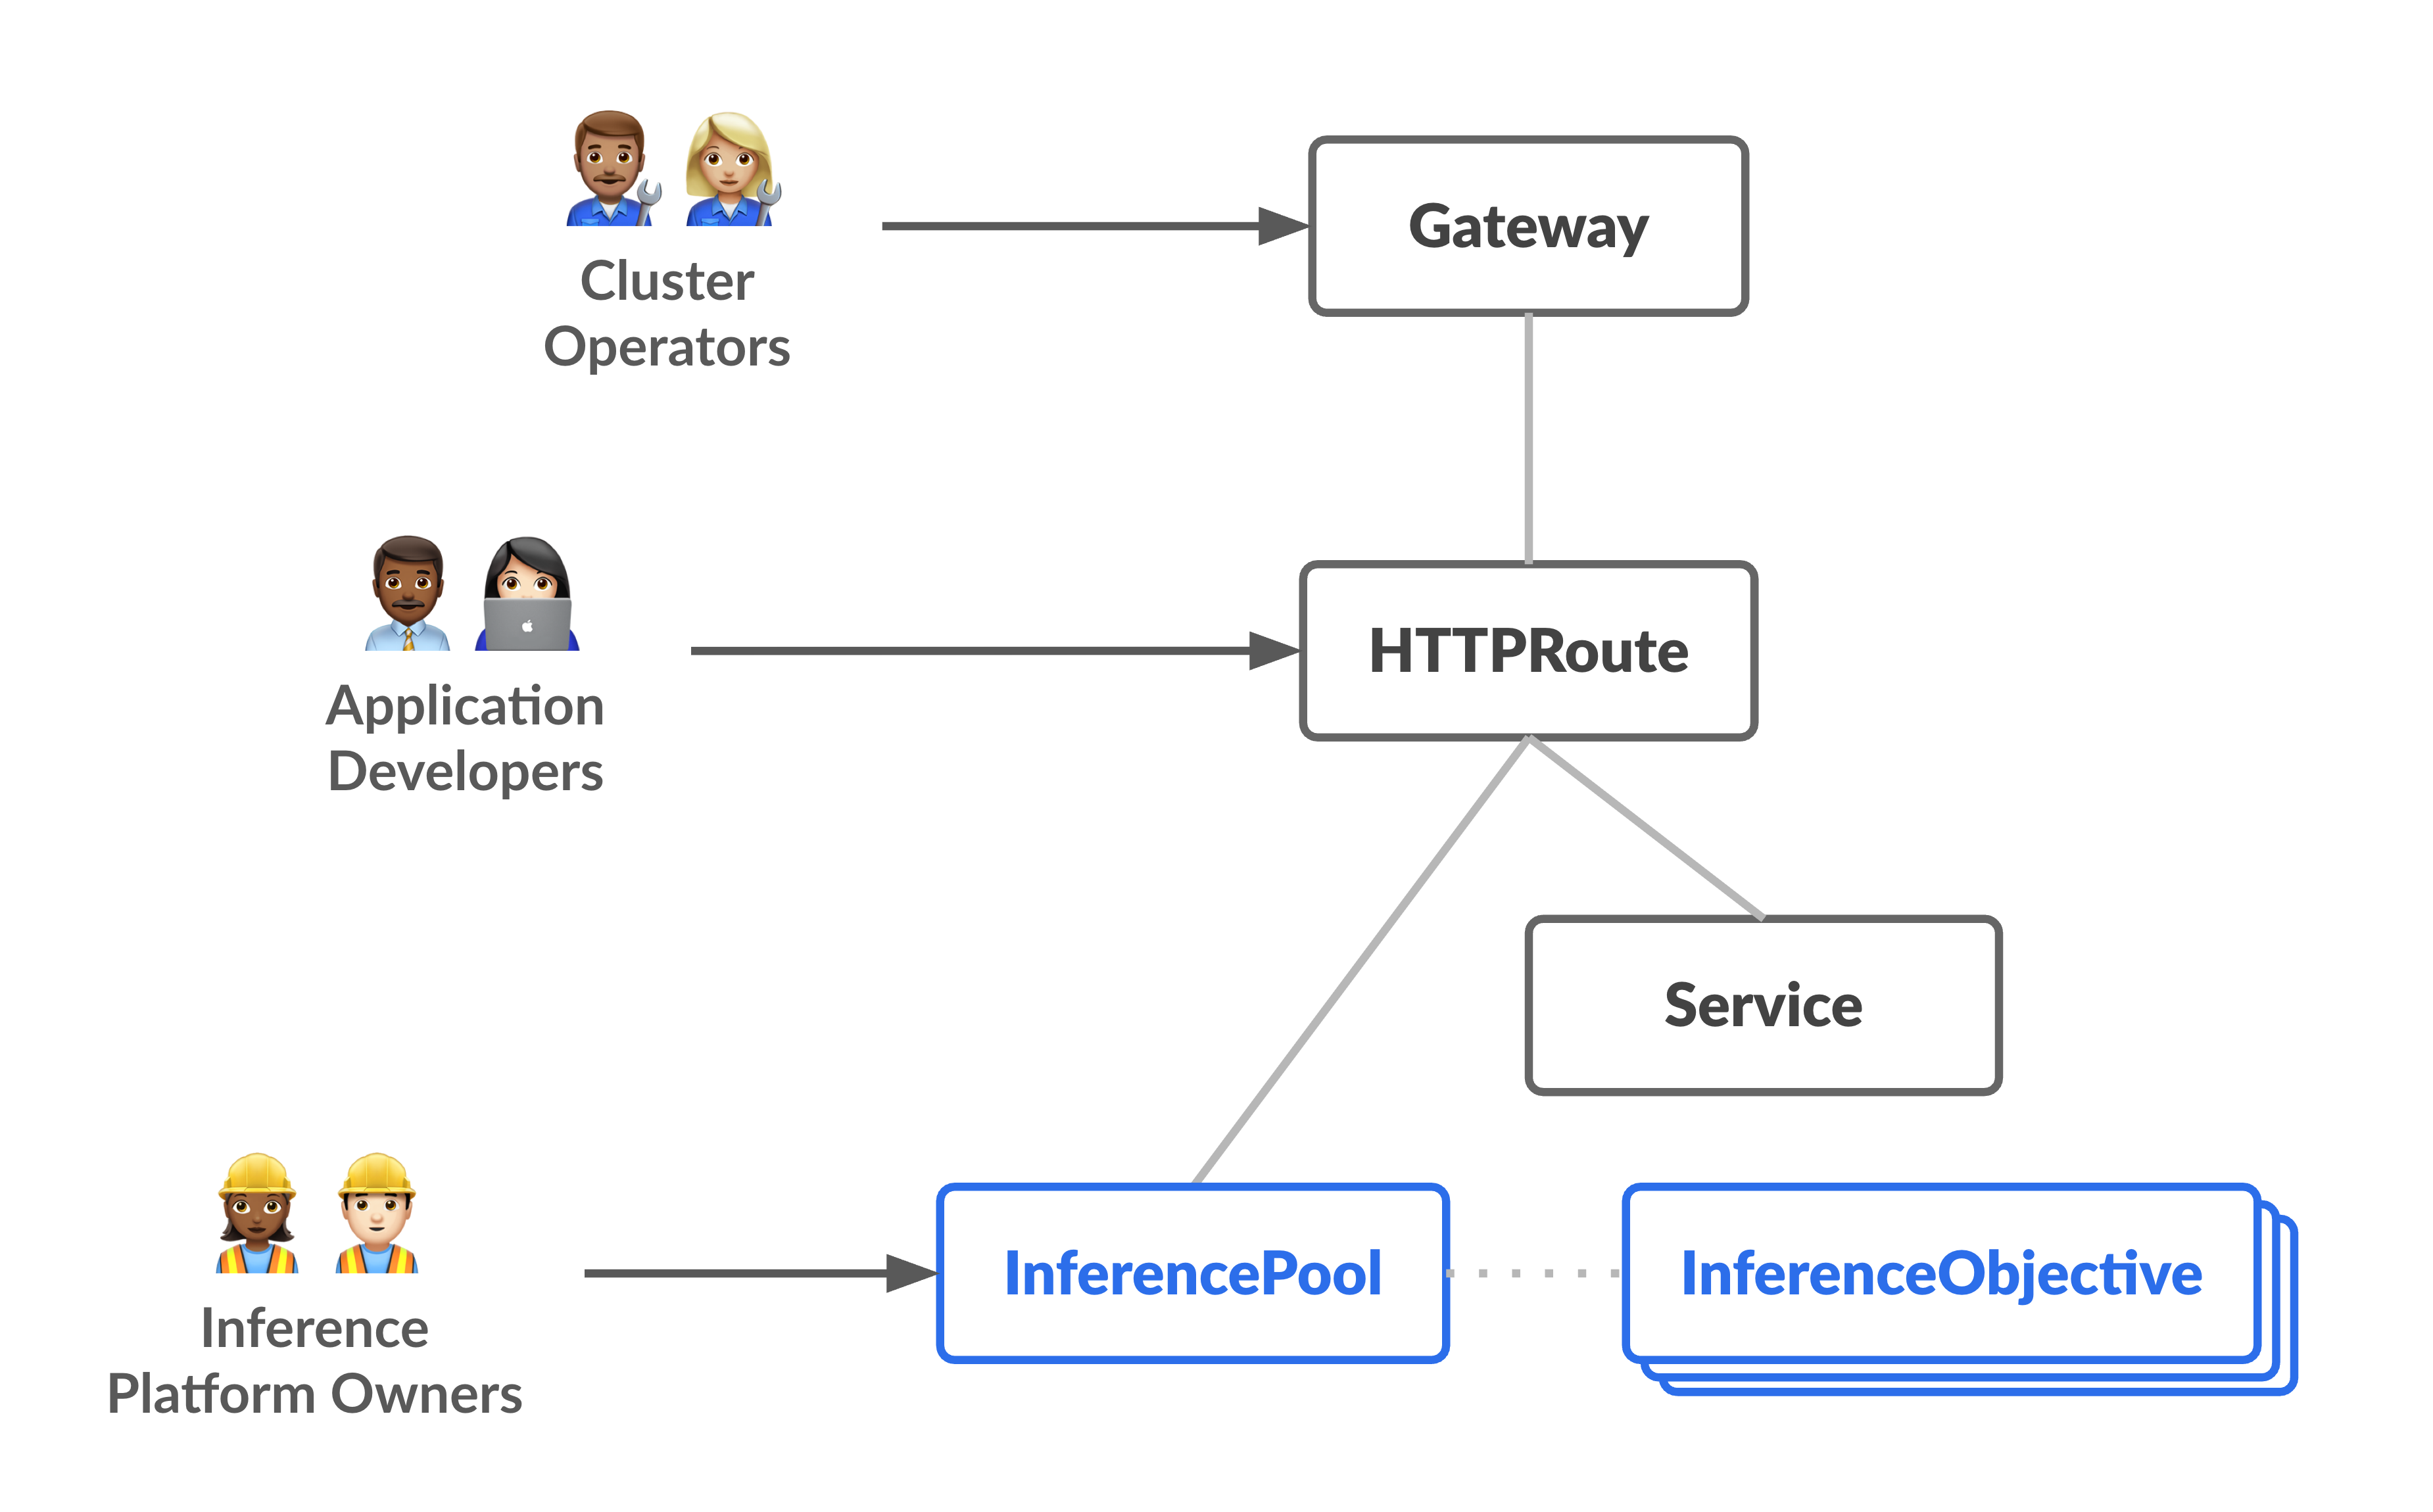
Diagram berikut mengilustrasikan model resource yang berfokus pada dua persona baru yang berfokus pada inferensi dan resource yang mereka kelola.
Router llm-d
Router llm-d adalah komponen perutean permintaan cerdas yang digunakan Inference Gateway untuk membuat keputusan endpoint per permintaan. Komponen ini
terdiri dari dua subkomponen:
| Subkomponen | Deskripsi |
|---|---|
| `L7 Proxy` | Setiap proxy L7 tingkat industri yang sesuai (biasanya Envoy) yang menangani data plane: pengelolaan koneksi, TLS termination, dan penerusan permintaan. Di GKE Inference Gateway (Mode Gateway), Proxy adalah GKE Gateway. |
| `llm-d Endpoint Picker (EPP)` | Layanan khusus yang dikonsultasikan oleh Proxy untuk setiap permintaan menggunakan protokol ext-proc. EPP berisi kecerdasan pemilihan rute. Komponen ini menggunakan sinyal real-time dari server model
(pemanfaatan cache KV, panjang antrean, status cache awalan, dan afinitas
adaptor LoRA) untuk memilih Pod server model yang optimal untuk setiap
permintaan. |
Mode Gateway
GKE Inference Gateway adalah llm-d Router yang beroperasi dalam Mode Gateway. Dalam
Mode Gateway, Proxy adalah Gateway Kubernetes formal yang disediakan dan dikelola
secara terpisah dari layanan EPP. Gateway memanggil EPP melalui ext-proc untuk
membuat keputusan pemilihan rute, lalu meneruskan permintaan langsung ke Pod server model
yang dipilih.
Pemisahan Gateway (bidang data) dari EPP (kecerdasan pemilihan rute) ini memungkinkan:
- Infrastruktur bersama: satu GKE Gateway melayani beberapa InferencePool bersama dengan Service Kubernetes standar.
- Pengelolaan traffic lanjutan: Kebijakan
HTTPRoutemendukung pemisahan berbobot, peluncuran bertahap, dan pencerminan permintaan. - Penskalaan independen: layanan EPP diskalakan secara independen dari Gateway.
- Integrasi berbasis cloud: berfungsi dengan Gateway controller terkelola GKE, Cloud Load Balancing, dan alat pengamatan yang ada.
Cara kerja GKE Inference Gateway
GKE Inference Gateway menggunakan ekstensi Gateway API dan logika perutean khusus model untuk menangani permintaan klien ke model AI. Langkah-langkah berikut menjelaskan alur permintaan.
Cara kerja alur permintaan
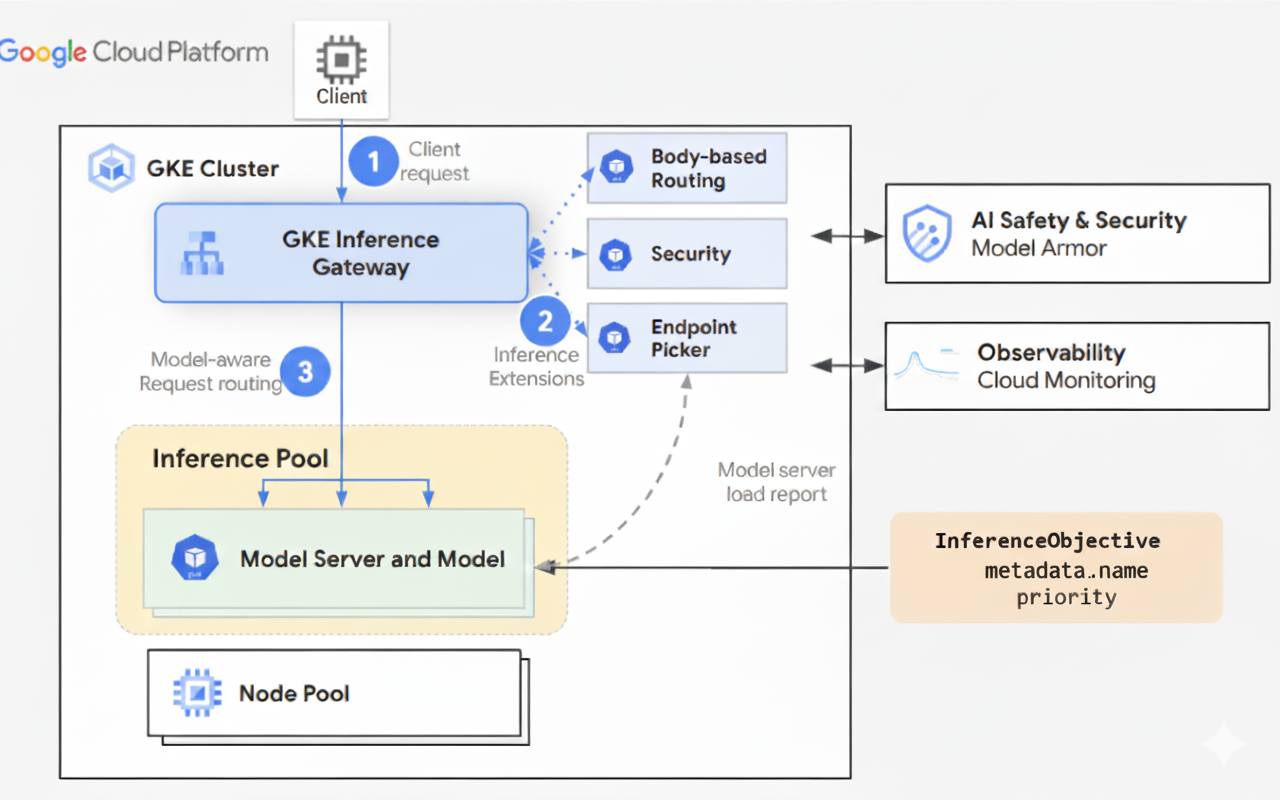
GKE Inference Gateway merutekan permintaan klien dari permintaan awal ke instance model. Bagian ini menjelaskan cara GKE Inference Gateway menangani permintaan. Alur permintaan ini umum untuk semua klien.
- Klien mengirimkan permintaan, yang diformat seperti yang dijelaskan dalam spesifikasi OpenAI API, ke model yang berjalan di GKE.
GKE Inference Gateway memproses permintaan menggunakan ekstensi inferensi berikut:
- Ekstensi perutean berbasis isi: mengekstrak ID model dari isi permintaan klien dan mengirimkannya ke GKE Inference Gateway.
GKE Inference Gateway kemudian menggunakan ID ini untuk merutekan
permintaan berdasarkan aturan yang ditentukan dalam objek
HTTPRouteGateway API. Perutean isi permintaan mirip dengan perutean berdasarkan jalur URL. Perbedaannya adalah perutean isi permintaan menggunakan data dari isi permintaan. - Ekstensi keamanan: menggunakan Model Armor, NVIDIA NeMo Guardrails, atau solusi pihak ketiga yang didukung untuk menerapkan kebijakan keamanan khusus model, yang mencakup pemfilteran konten, deteksi ancaman, pembersihan, dan logging. Ekstensi keamanan menerapkan kebijakan ini ke jalur pemrosesan permintaan dan respons.
- llm-d Endpoint Picker (EPP): memantau metrik utama dari server model dalam InferencePool dan merutekan permintaan ke replika model yang optimal. Untuk mengetahui informasi selengkapnya, lihat Router llm-d.
- Ekstensi perutean berbasis isi: mengekstrak ID model dari isi permintaan klien dan mengirimkannya ke GKE Inference Gateway.
GKE Inference Gateway kemudian menggunakan ID ini untuk merutekan
permintaan berdasarkan aturan yang ditentukan dalam objek
GKE Inference Gateway merutekan permintaan ke replika model yang ditampilkan oleh ekstensi pemilih endpoint.
Diagram berikut mengilustrasikan alur permintaan dari klien ke instance model melalui GKE Inference Gateway.
Cara kerja distribusi traffic
GKE Inference Gateway secara dinamis mendistribusikan permintaan inferensi ke server model dalam objek InferencePool. Hal ini membantu mengoptimalkan pemanfaatan resource dan mempertahankan performa dalam berbagai kondisi beban. GKE Inference Gateway menggunakan dua mekanisme berikut untuk mengelola distribusi traffic:
Pemilihan endpoint: memilih server model yang paling sesuai secara dinamis untuk menangani permintaan inferensi. Sistem ini memantau beban dan ketersediaan server, lalu membuat keputusan perutean yang optimal dengan menghitung
scoreuntuk setiap server dengan menggabungkan sejumlah heuristik pengoptimalan:- Perutean yang mendukung cache awalan: GKE Inference Gateway melacak indeks cache awalan yang tersedia di setiap server model, dan memberikan skor yang lebih tinggi ke server dengan kecocokan cache awalan yang lebih panjang.
- Perutean berbasis beban: GKE Inference Gateway memantau beban server (pemanfaatan cache KV dan kedalaman antrean yang tertunda), dan memberikan skor yang lebih tinggi kepada server dengan beban yang lebih rendah.
- Perutean yang kompatibel dengan LoRA: saat penayangan LoRA dinamis diaktifkan, GKE Inference Gateway akan memantau adaptor LoRA aktif per server, dan memberikan skor yang lebih tinggi ke server dengan adaptor LoRA yang diminta aktif, atau ruang tambahan untuk memuat adaptor LoRA yang diminta secara dinamis. Server dengan skor total tertinggi dari semua server sebelumnya akan dipilih.
Pengantrean dan shedding: mengelola alur permintaan dan mencegah kelebihan beban traffic. GKE Inference Gateway menyimpan permintaan masuk dalam antrean dan memprioritaskan permintaan berdasarkan prioritas yang ditentukan.
GKE Inference Gateway menggunakan sistem Priority numerik, yang juga dikenal sebagai
Criticality, untuk mengelola alur permintaan dan mencegah kelebihan beban. Priority ini adalah
kolom bilangan bulat opsional yang ditentukan oleh pengguna untuk setiap InferenceObjective. Nilai yang lebih tinggi menandakan permintaan yang lebih penting. Saat sistem mengalami tekanan, permintaan dengan Priority kurang dari 0 dianggap memiliki prioritas lebih rendah dan akan dihapus terlebih dahulu, sehingga menampilkan error 429 untuk melindungi workload yang lebih penting. Secara default, Priority adalah 0. Permintaan hanya
dihapus karena prioritas jika Priority-nya ditetapkan secara eksplisit ke nilai yang lebih kecil
dari 0. Sistem ini memungkinkan Anda memprioritaskan traffic inferensi online yang sensitif terhadap latensi daripada tugas batch yang kurang sensitif terhadap waktu.
GKE Inference Gateway mendukung inferensi streaming untuk aplikasi seperti chatbot dan terjemahan langsung, yang memerlukan update berkelanjutan atau hampir real-time. Inferensi streaming memberikan respons dalam potongan atau segmen inkremental, bukan output tunggal yang lengkap. Jika terjadi error selama respons streaming, streaming akan dihentikan, dan klien akan menerima pesan error. GKE Inference Gateway tidak mencoba ulang respons streaming.
Mempelajari contoh aplikasi
Bagian ini memberikan contoh penggunaan GKE Inference Gateway untuk menangani berbagai skenario aplikasi AI generatif.
Contoh 1: Menyajikan beberapa model AI generatif di cluster GKE
Sebuah perusahaan ingin men-deploy beberapa model bahasa besar (LLM) untuk melayani
berbagai workload. Misalnya, mereka mungkin ingin men-deploy model Gemma3 untuk antarmuka chatbot dan model DeepSeek untuk aplikasi rekomendasi. Perusahaan
harus memastikan performa penayangan yang optimal untuk LLM ini.
Dengan menggunakan GKE Inference Gateway, Anda dapat men-deploy LLM ini di cluster GKE dengan konfigurasi akselerator yang Anda pilih di InferencePool. Kemudian, Anda dapat merutekan permintaan berdasarkan nama model (seperti chatbot dan recommender) dan properti Priority.
Diagram berikut menggambarkan cara GKE Inference Gateway merutekan permintaan ke berbagai model berdasarkan nama model dan Priority.
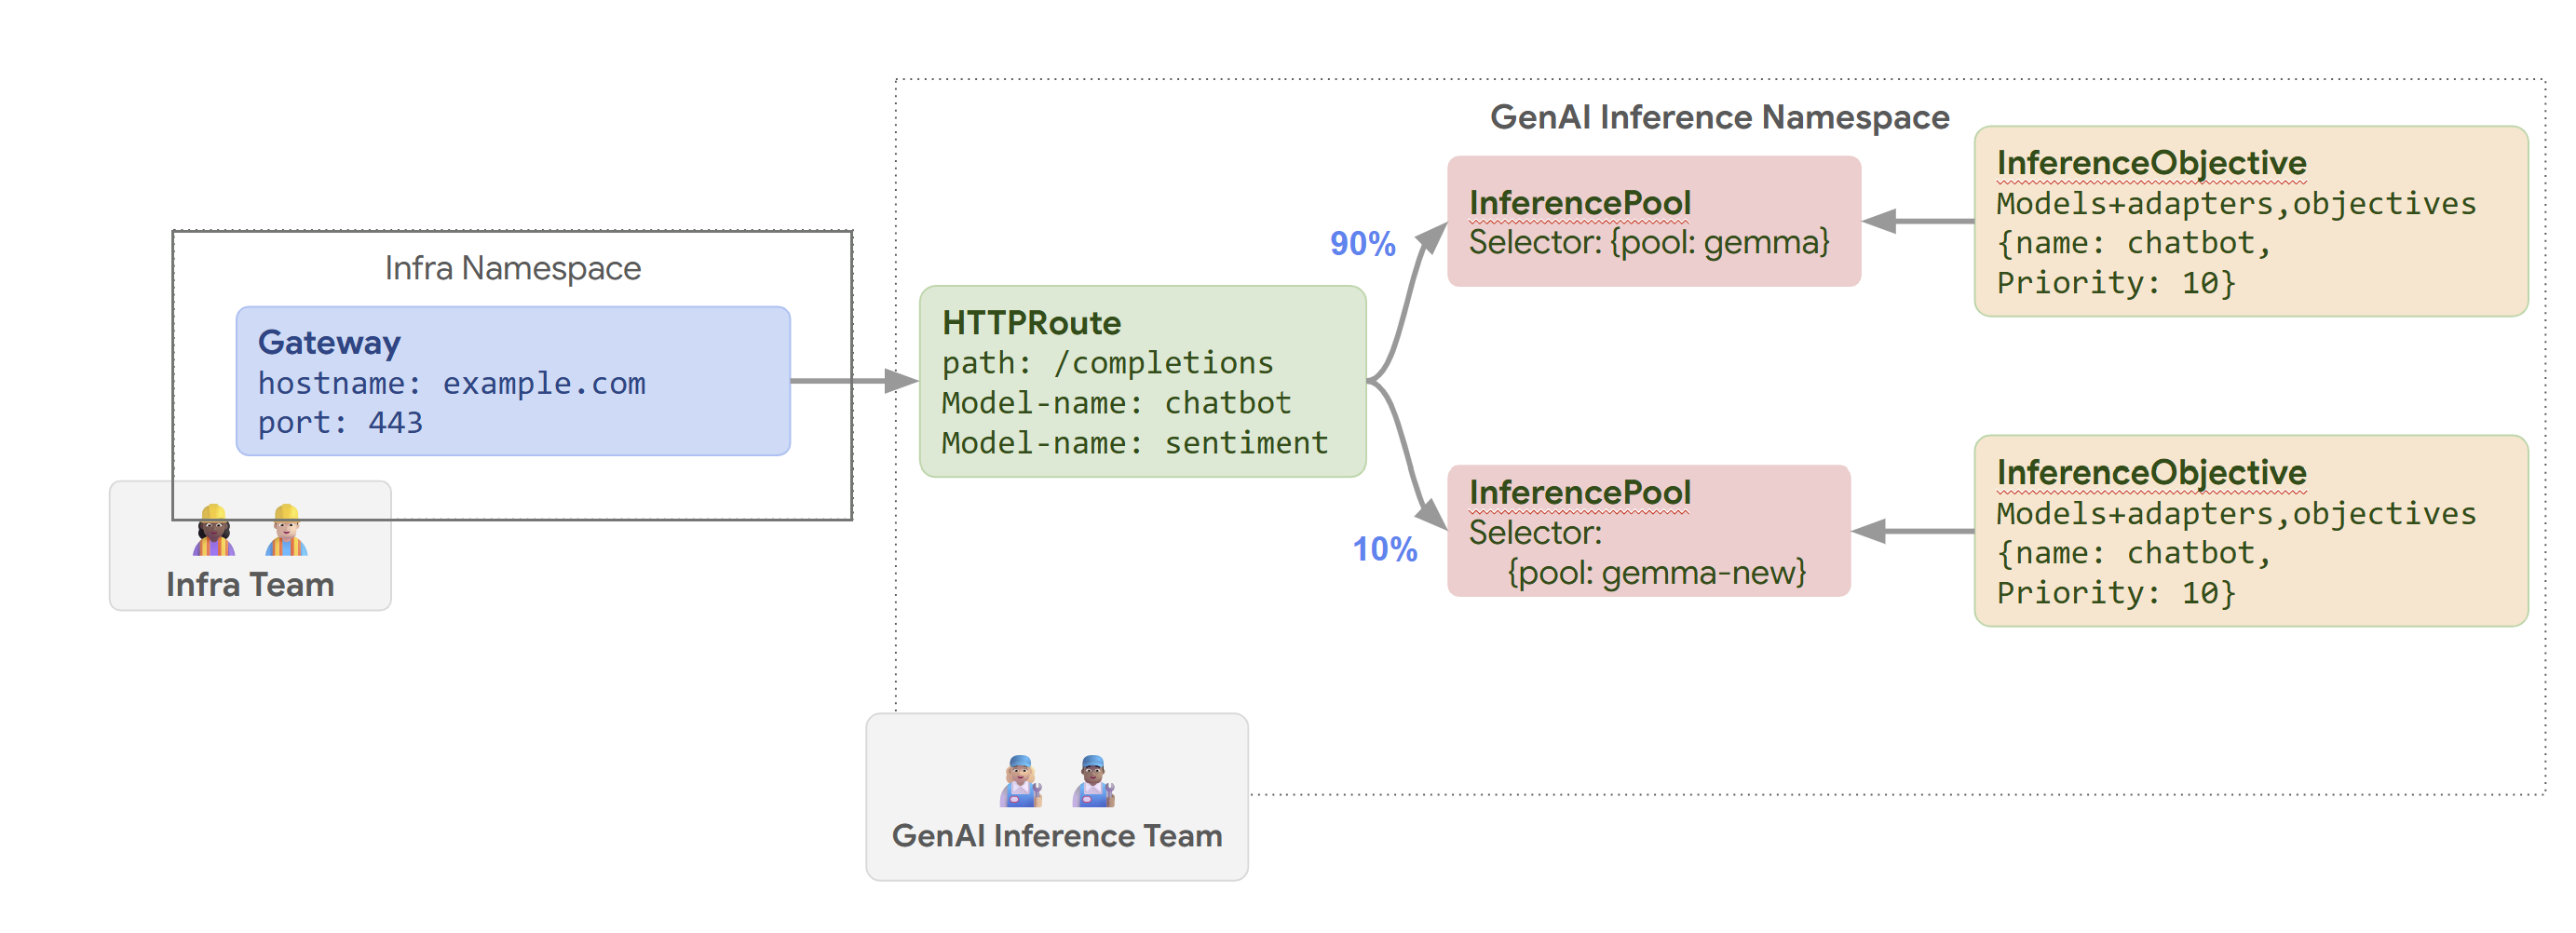
Diagram ini mengilustrasikan cara permintaan ke layanan GenAI di
example.com/completions ditangani oleh GKE Inference Gateway. Permintaan
pertama-tama mencapai Gateway di namespace Infra. Gateway ini meneruskan permintaan ke HTTPRoute di namespace GenAI Inference, yang dikonfigurasi untuk menangani permintaan model chatbot dan sentimen. Untuk model chatbot, HTTPRoute membagi traffic: 90% diarahkan ke InferencePool yang menjalankan versi model saat ini (dipilih oleh {pool: gemma}), dan 10% masuk ke pool dengan versi yang lebih baru ({pool: gemma-new}), biasanya untuk pengujian canary.
Kedua pool ditautkan ke InferenceObjective yang menetapkan Priority sebesar 10
ke permintaan untuk model chatbot, sehingga memastikan permintaan ini diperlakukan sebagai prioritas
tinggi.
Contoh 2: Menyajikan adaptor LoRA di akselerator bersama
Sebuah perusahaan ingin menayangkan LLM untuk analisis dokumen dan berfokus pada audiens dalam beberapa bahasa, seperti Inggris dan Spanyol. Mereka telah menyesuaikan model untuk setiap bahasa, tetapi perlu menggunakan kapasitas GPU dan TPU secara efisien. Anda dapat
menggunakan GKE Inference Gateway untuk men-deploy adaptor yang di-fine-tune LoRA dinamis untuk
setiap bahasa (misalnya, english-bot dan spanish-bot) pada model dasar
umum (misalnya, llm-base) dan akselerator. Dengan demikian, Anda dapat mengurangi jumlah akselerator yang diperlukan dengan mengemas beberapa model secara padat pada akselerator umum.
Diagram berikut mengilustrasikan cara GKE Inference Gateway menayangkan beberapa adaptor LoRA pada akselerator bersama.

Langkah berikutnya
- Men-deploy GKE Inference Gateway
- Menyesuaikan konfigurasi GKE Inference Gateway
- Menyajikan LLM dengan GKE Inference Gateway
- Menggunakan perutean berbasis latensi yang diprediksi dengan GKE Inference Gateway(Pratinjau)