


Ringkasan
Arsitektur Referensi Solusi (SRA) ini menentukan desain konseptual, topologi komponen, dan batas teknis untuk menghosting, menayangkan, dan memvalidasi Model Bahasa Besar (LLM) dengan bobot terbuka di cluster mandiri khusus software Distributed Cloud.
Lingkungan edge perusahaan sering kali memerlukan inferensi latensi rendah dan kedaulatan data yang ketat. Arsitektur Referensi Solusi ini menyediakan stack penyajian yang standar, aman, dan dapat diamati untuk men-deploy model Gemma 4 31B di cluster software Distributed Cloud satu node yang dilengkapi dengan GPU NVIDIA RTX PRO 6000 (VRAM 96 GB) yang disediakan pelanggan.
Fitur dan kemampuan
- Penayangan Model Lokal: Menampilkan API standar industri yang kompatibel dengan OpenAI secara lokal dalam batas cluster hanya software Distributed Cloud.
- Dukungan untuk Model Edge Besar: Dioptimalkan untuk menjalankan Gemma 4 31B dalam presisi native (BF16) atau format terkuantisasi, dengan memanfaatkan sepenuhnya kapasitas VRAM 96 GB.
- Kemampuan observasi: Terintegrasi dengan infrastruktur pemantauan software Distributed Cloud saja (Google Cloud Managed Service for Prometheus) menggunakan resource
PodMonitoringnative untuk mengekspor telemetri GPU dan metrik performa vLLM, sehingga tidak memerlukan server Prometheus lokal mandiri. - Validasi Interaktif: Men-deploy antarmuka web berbasis Gradio untuk verifikasi visual langsung atas responsivitas model.
Prinsip arsitektur
- Kesederhanaan dan Portabilitas: Menstandardisasi konstruksi native Kubernetes (Deployment, Service), bukan operator penayangan yang kompleks, sehingga memastikan kemudahan deployment dan pemeliharaan pada penyiapan satu node.
- Kedaulatan Data: Semua traffic inferensi serta data perintah dan respons tetap berada dalam batas cluster lokal.
- Isolasi Resource: Mengkhususkan akselerator GPU fisik untuk satu instance penayangan model guna mencegah persaingan resource dan menjamin latensi yang dapat diprediksi.
Arsitektur dan desain
Komponen
Komponen solusi terdiri dari:
- Customer Namespace (Cluster khusus software Distributed Cloud):
- Mesin Penayangan vLLM: Di-deploy sebagai Deployment Kubernetes yang menjalankan container vLLM. Dikonfigurasi untuk memuat bobot Gemma dari penyimpanan persisten dan mengekspos API yang kompatibel dengan OpenAI.
- UI Web Gradio: Di-deploy sebagai Deployment Kubernetes yang menyediakan antarmuka chat untuk verifikasi (Opsional: Juga dapat dijalankan secara eksternal di workstation developer atau runtime pengujian yang terhubung ke layanan vLLM cluster).
- Persistent Volume Claim (PVC): Didukung oleh software Distributed Cloud hanya penyimpanan bersama lokal
(menggunakan StorageClass
local-shared) untuk menghosting bobot model. - Layanan Kubernetes: Layanan ClusterIP untuk endpoint API vLLM; layanan NodePort atau LoadBalancer untuk UI Gradio agar dapat diekspos ke jaringan pelanggan.
- Infrastruktur (Dikelola Pelanggan):
- NVIDIA GPU Operator: Mengatur dan mengekspos resource GPU fisik ke node worker Kubernetes software Distributed Cloud saja.
- GPU NVIDIA RTX PRO 6000: Akselerator fisik yang mendasarinya (arsitektur memori GDDR7 96 GB).
- Integrasi Google Cloud:
- Google Cloud Monitoring & Logging: Agen default khusus software Distributed Cloud yang mengumpulkan dan meneruskan log sistem, log penampung, dan metrik dasar ke Google Cloud.
Ringkasan arsitektur tingkat tinggi
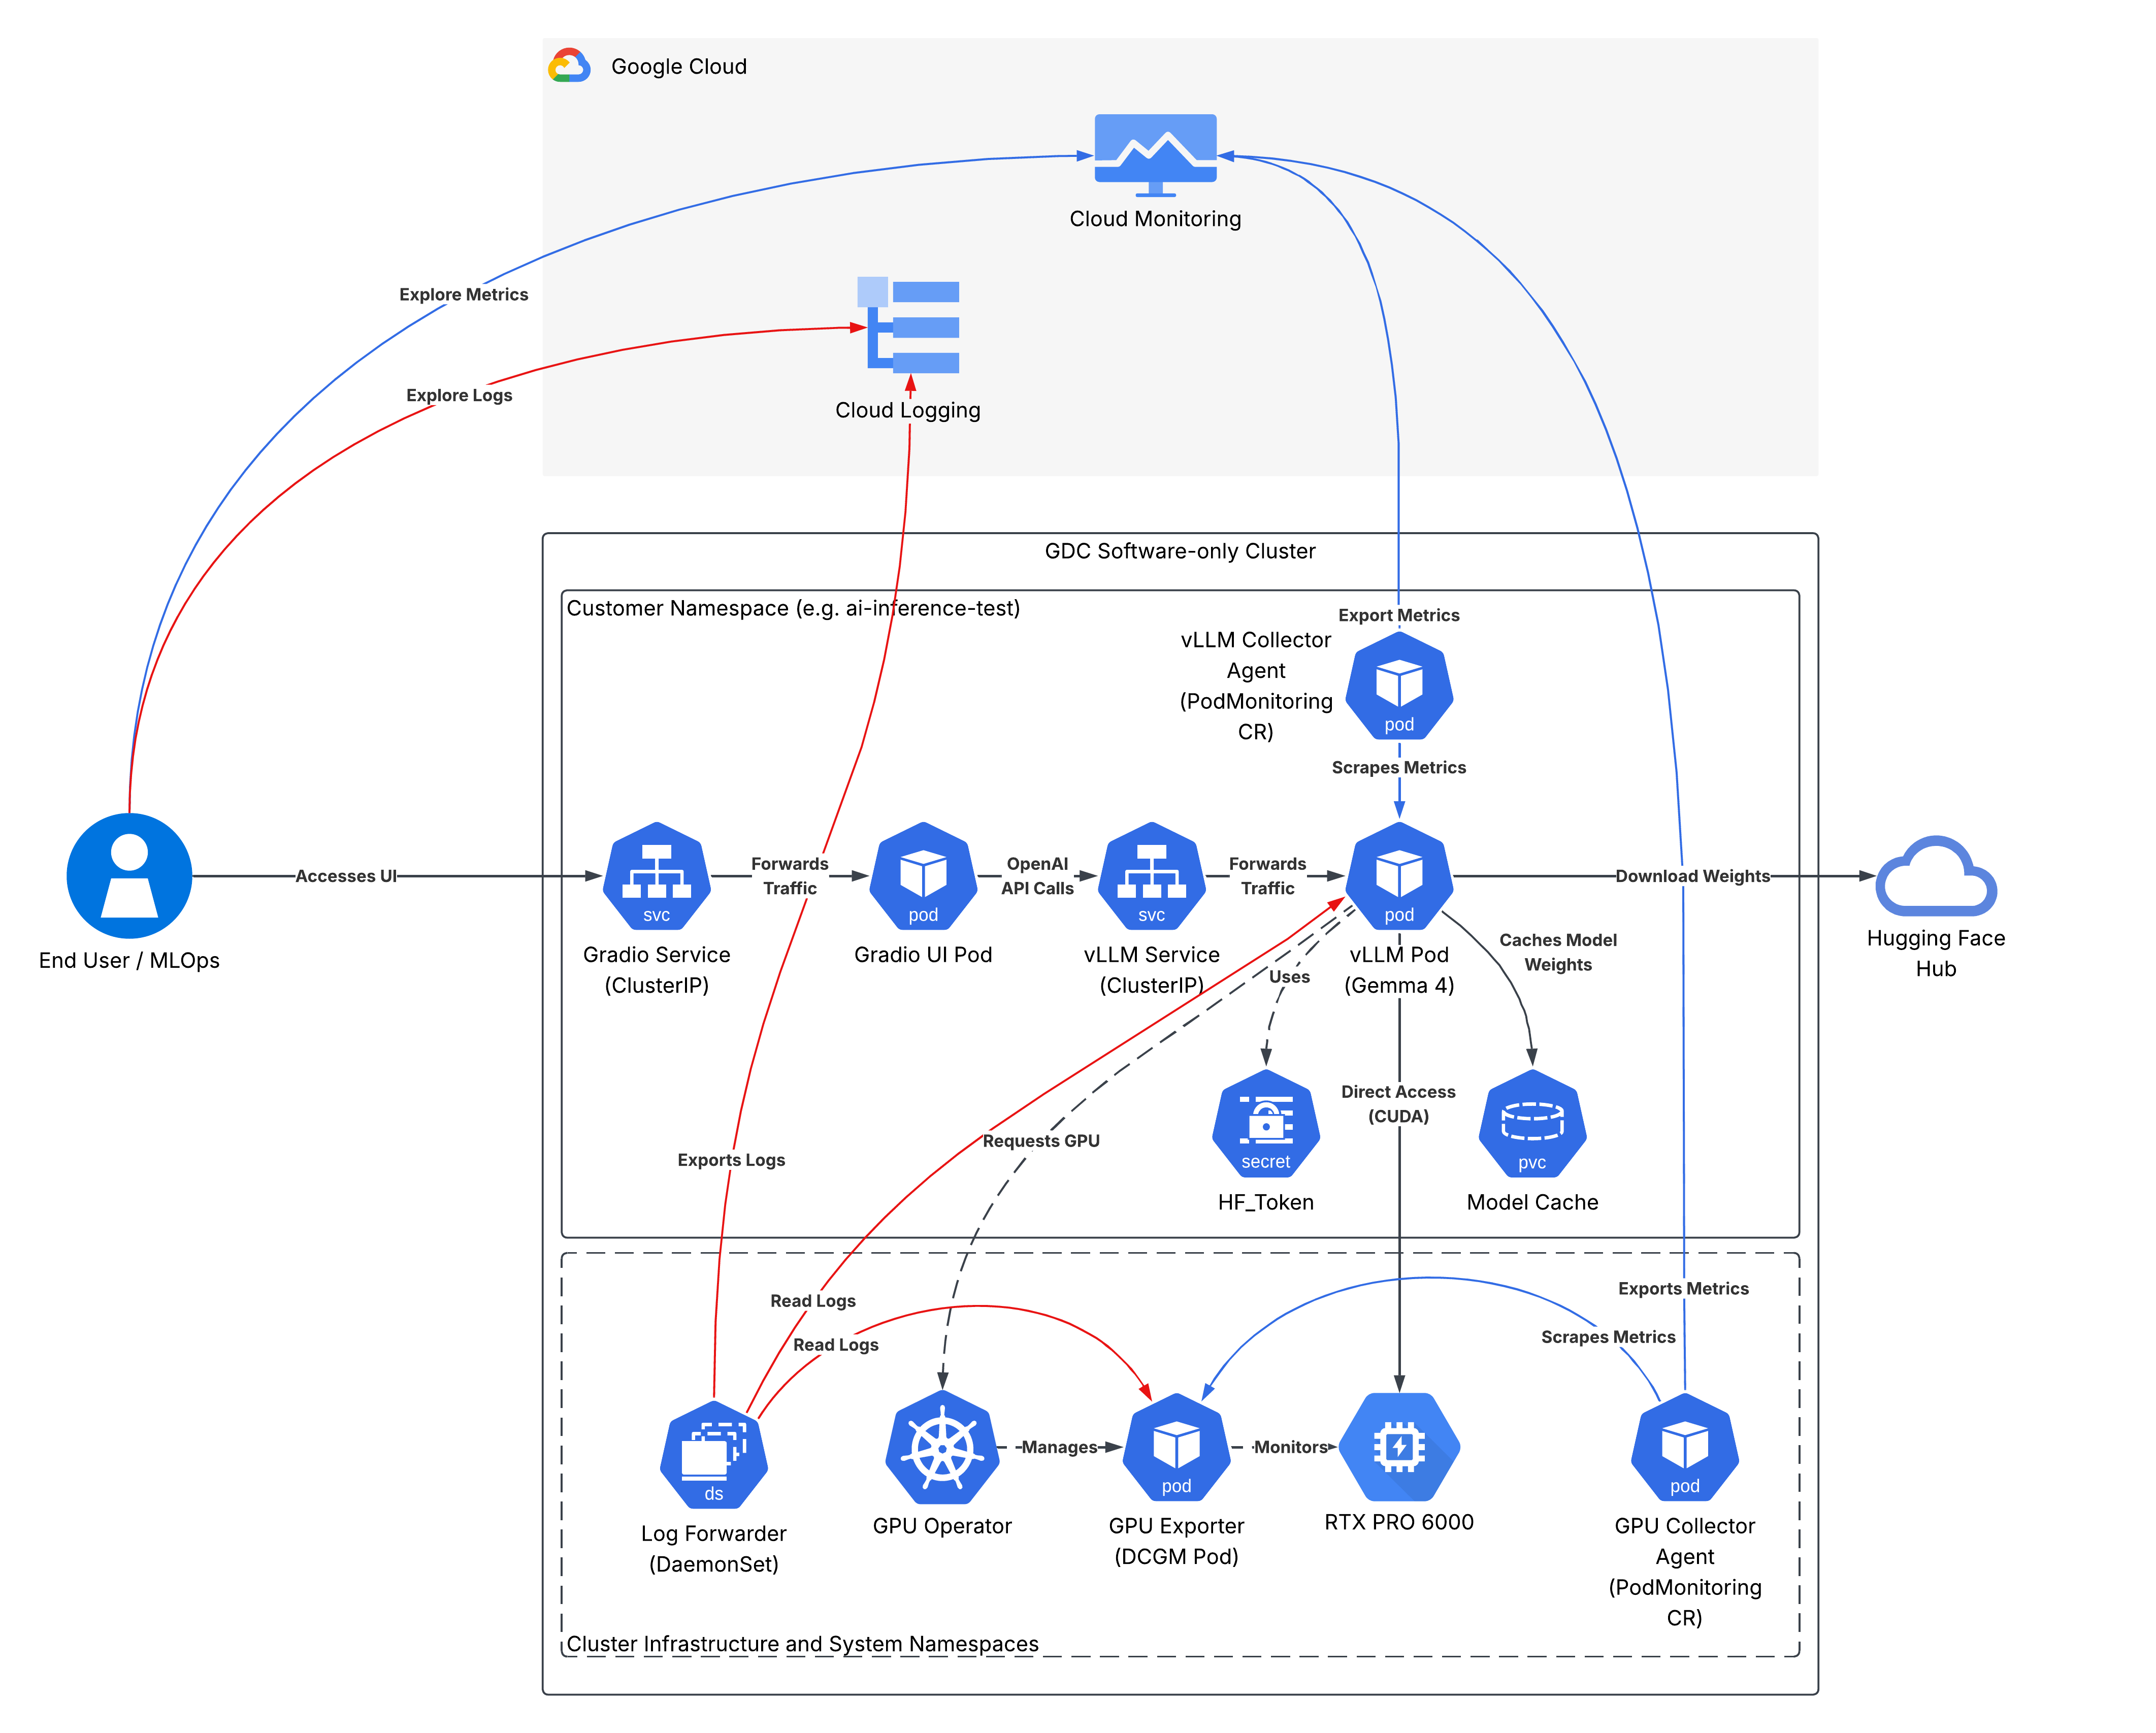
Diagram berikut mengilustrasikan alur permintaan dan interaksi komponen dalam cluster hanya software Distributed Cloud:
Batasan hardware
Solusi ini dirancang untuk hardware yang disediakan pelanggan dan dilengkapi dengan GPU NVIDIA RTX PRO 6000 Blackwell.
- Spesifikasi GPU: NVIDIA RTX PRO 6000 (Blackwell Server atau Workstation Edition).
- Arsitektur Memori: VRAM GDDR7 96 GB (dengan ECC)
- Dampak Pemilihan Model:
- VRAM 96 GB memungkinkan model target Gemma 4 31B berjalan dalam presisi BF16 native (menempati bobot ~62 GB dan menyisakan ruang kosong VRAM ~34 GB untuk cache Key-Value (KV)).
- Jika kuantisasi FP8 yang dipercepat hardware Blackwell (
--quantization=fp8) diaktifkan—seperti yang dikonfigurasi dalam implementasi referensi—penggunaan memori bobot model akan berkurang setengahnya menjadi ~31 GB, sehingga memperluas cache KV yang tersedia menjadi ~56,5 GiB (61,728token) pada--gpu-memory-utilization=0.95dan memungkinkan ukuran batch serentak yang besar atau jendela konteks yang besar tanpa mengalami error Kehabisan Memori (OOM).
Matriks dukungan (tanggung jawab)
| Komponen | Dikelola oleh | Catatan |
|---|---|---|
| Hardware & OS Fisik | Pelanggan | Hardware yang disediakan pelanggan (khususnya server atau workstation dengan GPU NVIDIA RTX PRO 6000 Blackwell). |
| Penginstalan Cluster hanya software Distributed Cloud | Pelanggan | Harus mengikuti dokumentasi penginstalan software Distributed Cloud saja yang standar. |
| Driver & Operator GPU | Pelanggan | Penginstalan Operator GPU NVIDIA dan diagram Helm. Google tidak mendukung deployment operator NVIDIA. |
| Manifes Penayangan vLLM | Google (Solusi) | Disediakan sebagai bagian dari panduan solusi ini. |
| Artefak Model | Pelanggan | Mendownload dan menghosting bobot model Gemma. |
| UI Gradio dan Kode Aplikasi | Pelanggan | Lapisan aplikasi milik pelanggan untuk validasi dan penggunaan. |
| Cloud Logging dan Cloud Monitoring | Sendi | Google menyediakan integrasi default; Pelanggan mengonfigurasi. |
Konsep dan teknologi
Bagian ini menjelaskan komponen fungsional, tanggung jawabnya, dan cara komunikasinya dalam sistem. Hal ini mengidentifikasi layanan inti, unit penyimpanan data, dan antarmuka jaringan yang diperlukan untuk mendukung kasus penggunaan target.
Infrastruktur dan platform
- GPU NVIDIA RTX PRO 6000: Menyediakan VRAM GDDR7 96 GB. GPU fisik sepenuhnya didedikasikan untuk instance penyajian model. Partisi GPU (MIG) tidak diaktifkan untuk memastikan model memiliki akses eksklusif ke VRAM dan bandwidth memori penuh, sehingga mencegah pertentangan resource.
- Operator GPU NVIDIA: Operator yang dikelola pelanggan yang mengatur dan mengekspos resource GPU fisik ke node worker Kubernetes software Distributed Cloud saja.
- Penyimpanan Lokal Node (Persistent Volume Claim): Didukung oleh software Distributed Cloud saja untuk penyimpanan lokal node guna menghosting dan mempertahankan bobot model di node. Hal ini memastikan bahwa setelah bobot model didownload, bobot tersebut akan dipertahankan secara lokal. Mulai ulang atau update pod berikutnya memuat bobot dari cache lokal ini, sehingga mengurangi waktu mulai dan melindungi dari pemadaman WAN.
- Segmen Memori Bersama (
/dev/shm): VolumeemptyDirdenganmedium: Memorydi-mount di/dev/shmdan dialokasikan 16 GiB untuk mencegah kesalahan segmentasi selama operasi tensor konkurensi tinggi di vLLM.
Layanan dan logika
- Mesin Penayangan vLLM: Di-deploy sebagai Deployment Kubernetes yang menjalankan container vLLM yang memenuhi syarat Vertex AI, diekspos melalui layanan
ClusterIP(port 8000). Parameter konfigurasi utama meliputi:--model: Jalur atau ID model Gemma (misalnya,google/gemma-4-31B-it).--tensor-parallel-size: Tetapkan ke1(batasan GPU tunggal).--dtype: Setel kebfloat16untuk memanfaatkan presisi native hardware untuk lapisan dan aktivasi yang tidak dikuantisasi.--quantization: Ditetapkan kefp8dalam penerapan referensi untuk memanfaatkan kuantisasi bobot FP8 Blackwell (~31 GB bobot, ~56,5 GiB cache KV), atau dihilangkan jika BF16 yang tidak dikuantisasi (~62 GB bobot, ~34 GB cache KV) lebih disukai.
- UI Web Gradio: Di-deploy sebagai Deployment Kubernetes yang menyediakan antarmuka chat untuk validasi, diekspos melalui layanan
ClusterIP(port 8080). Aplikasi ini terhubung ke layanan vLLM untuk interaksi perintah dan respons.
Kemampuan observasi dan Google Cloud integrasi
- Cloud Logging: Menggunakan agen logging software Distributed Cloud default saja untuk otomatis mengambil dan meneruskan log container (log aplikasi vLLM dan diagnostik GPU) ke Cloud Logging.
- Cloud Monitoring (PodMonitoring): Resource Google Cloud Managed Service for Prometheus (GMP) menargetkan pod vLLM (untuk menyajikan telemetri seperti throughput token dan penggunaan cache KV) dan pod pengekspor GPU (untuk telemetri GPU), yang mengekspor metrik ke Cloud Monitoring.
Pertimbangan
Skalabilitas dan performa
- Penggunaan GPU Khusus: GPU NVIDIA RTX PRO 6000 sepenuhnya dikhususkan untuk container vLLM. Berbagi GPU melalui MIG atau time-slicing tidak diterapkan dalam arsitektur ini untuk memastikan latensi inferensi yang dapat diprediksi dan mencegah OOM. Model Gemma 4 31B juga memerlukan sebagian besar kapasitas VRAM untuk bobot model (~62 GB) yang tidak menyisakan banyak memori untuk model lain agar dapat berjalan secara bersamaan.
- Strategi Deployment: Diterapkan sebagai
Recreate. Karena hanya memiliki satu GPU, kita tidak dapat menjalankan dua instance pod vLLM secara bersamaan selama update. Pod lama harus dihentikan untuk melepaskan kunci GPU sebelum pod baru dapat dimulai.
Pengelolaan resource
- Ruang VRAM: Meskipun NVIDIA RTX PRO 6000 96 GB sesuai dengan model Gemma 4 31B dalam presisi BF16 yang tidak terkuantisasi (~62 GB untuk bobot, sehingga menyisakan ~34 GB untuk cache KV), deployment referensi memungkinkan kuantisasi FP8 Blackwell (
--quantization=fp8) untuk mengurangi memori bobot menjadi ~31 GB dan memperluas cache KV yang tersedia menjadi ~56,5 GiB (61,728token serentak). - Penentuan Ukuran Cache KV: SRA mengasumsikan alokasi vLLM default (
--gpu-memory-utilization=0.95), yang memaksimalkan penggunaan VRAM untuk mesin.
Ketersediaan dan keandalan
- Kesiapan Cache: Penggunaan PV lokal node sangat penting. Jika node dimulai ulang, bobot yang di-cache di direktori host akan digunakan kembali.
- Caching Gambar: Karena image container vLLM berukuran besar (>10 GB), sebaiknya setel
imagePullPolicy: IfNotPresentuntuk menghindari penarikan registry yang tertunda saat pod dimulai ulang.
Kompleksitas operasional
- Visibilitas Konsol: Tidak seperti GKE, software Distributed Cloud saja tidak mendukung tampilan "Model AI/ML" berbasis konsol. Semua validasi dan pemantauan
harus dilakukan melalui
kubectlCLI, penerusan port, dan dasbor Cloud Monitoring langsung.
Keputusan desain
Mesin inferensi: vLLM versus Triton versus Ollama
- Opsi yang Dipilih: vLLM
- Alasan: vLLM menawarkan performa terbaik langsung untuk LLM melalui PagedAttention, mendukung paritas OpenAI API, dan memiliki image container yang telah memenuhi syarat dari Vertex AI.
- Alternatif Ditolak:
- Triton: Terlalu rumit untuk dikonfigurasi dan dikompilasi untuk deployment edge model tunggal.
- Ollama: Tidak memiliki endpoint telemetri lanjutan dan penyesuaian konkurensi terperinci yang diperlukan untuk pemantauan produksi.
Jalur telemetri: GMP native versus Prometheus lokal
Opsi yang Dipilih: GMP Native (PodMonitoring)
- Alasan: Software Distributed Cloud hanya mendukung integrasi native dengan Cloud Monitoring. Kita dapat merutekan metrik langsung ke Google Cloud menggunakan Managed Prometheus, sehingga mengurangi biaya operasional di cluster.
- Alternatif Ditolak:
- Stack Prometheus dan Grafana Lokal: Ditolak untuk meminimalkan penggunaan resource bidang kontrol pada cluster node tunggal.
Asumsi dan batasan
Asumsi
- Ketersediaan Operator GPU: Diasumsikan pelanggan telah berhasil menginstal Operator GPU NVIDIA dan mengonfigurasi
nvidiaRuntimeClass sebelum men-deploy solusi ini. - Akses Hugging Face: Deployment memerlukan token Hugging Face yang valid dengan akses ke repositori Gemma 4 yang tertutup, yang disimpan sebagai Secret Kubernetes.
- Jalur Jaringan: Cluster harus memiliki akses internet (atau proxy internal) untuk mendownload image container dan bobot model selama penyiapan awal.
Batasan
- Batas GPU Tunggal: Arsitektur Fase 1 dibatasi oleh kapasitas fisik satu GPU NVIDIA RTX PRO 6000. Model yang lebih besar dari ~31B (atau workload konkurensi tinggi yang memerlukan paralelisme tensor multi-GPU) tidak didukung pada Fase 1.
- Tanpa Update Bertahap: Strategi
Recreatemenyiratkan periode nonaktif sementara layanan selama update model atau perubahan konfigurasi, karena GPU tidak dapat dibagikan antara pod lama dan baru. - Penyesuaian Performa Dikecualikan: Sesuai dengan cakupan project, pengoptimalan tingkat node (pengaitan CPU, hugepage,
PerformanceTuningProfile) dikecualikan dari arsitektur ini.