


Dengan melacak tahapan upgrade Google Distributed Cloud, Anda dapat memantau progres dan
memecahkan masalah saat menjalankan perintah bmctl upgrade cluster. Seiring berjalannya upgrade, perintah ini mengoordinasikan tahap berurutan dan update komponen paralel di seluruh cluster Anda untuk menyelesaikan proses dengan aman. Dokumen ini menjelaskan komponen dan tahapan upgrade cluster.
Ringkasan
Proses upgrade memindahkan cluster Google Distributed Cloud Anda dari versi saat ini ke versi yang lebih tinggi.
Informasi versi ini disimpan di lokasi berikut sebagai bagian dari resource kustom cluster di cluster admin:
status.anthosBareMetalVersion: menentukan versi cluster saat ini.spec.anthosBareMetalVersion: menentukan versi target, dan ditetapkan saat proses upgrade mulai berjalan.
Operasi upgrade yang berhasil akan merekonsiliasi
status.anthosBareMetalVersion ke
spec.anthosBareMetalVersion sehingga keduanya menampilkan
versi target.
Penyimpangan versi cluster
Penyimpangan versi cluster adalah perbedaan versi antara cluster pengelola (hybrid atau admin) dan cluster pengguna yang dikelolanya. Saat Anda menambahkan atau mengupgrade cluster pengguna, aturan versi berikut berlaku:
1.30 dan yang lebih baru
Aturan berikut berlaku untuk cluster pengguna yang dikelola oleh cluster admin atau cluster hybrid versi 1.30 atau yang lebih baru:
Versi cluster pengguna tidak boleh lebih tinggi dari versi cluster pengelola (admin atau hybrid).
Cluster pengguna dapat memiliki hingga dua versi minor di bawah versi cluster pengelola. Misalnya, cluster admin versi 1.30 dapat mengelola cluster pengguna 1.28. Kemampuan pengelolaan penyimpangan versi n-2 ini tersedia secara umum (GA) untuk mengelola cluster pada versi 1.30.
Untuk cluster pengelolaan tertentu pada versi 1.30 atau yang lebih baru, cluster pengguna tidak perlu memiliki versi minor yang sama satu sama lain. Misalnya, cluster admin versi 1.30 dapat mengelola cluster pengguna versi 1.30, versi 1.29, dan versi 1.28.
Kemampuan pengelolaan multi-skew memberi Anda lebih banyak fleksibilitas untuk merencanakan upgrade fleet. Misalnya, Anda tidak perlu mengupgrade semua cluster pengguna versi 1.28 ke versi 1.29 sebelum dapat mengupgrade cluster admin ke versi 1.30.
1,29
Aturan berikut berlaku untuk cluster pengguna yang dikelola oleh cluster admin atau cluster hybrid versi 1.29:
Versi cluster pengguna tidak boleh lebih tinggi dari versi cluster pengelola (admin atau hybrid).
(1.29 Pratinjau) Cluster pengguna dapat memiliki hingga dua versi minor di bawah versi cluster pengelolaan. Misalnya, cluster admin versi 1.29 dapat mengelola cluster pengguna 1.16. Pengelolaan penyimpangan versi n-2 ini tersedia sebagai kemampuan Pratinjau untuk mengelola cluster pada versi 1.29.
(1.29 Pratinjau) Untuk cluster pengelolaan tertentu, cluster pengguna tidak perlu memiliki versi minor yang sama satu sama lain. Misalnya, cluster admin versi 1.29 dapat mengelola cluster pengguna versi 1.29, versi 1.28, dan versi 1.16. Pengelolaan penyimpangan versi campuran ini tersedia sebagai kemampuan Pratinjau untuk mengelola cluster pada versi 1.29.
Kemampuan pengelolaan multi-skew Pratinjau memberi Anda lebih banyak fleksibilitas untuk merencanakan upgrade fleet. Misalnya, Anda tidak perlu mengupgrade semua cluster pengguna versi 1.16 ke versi 1.28 sebelum dapat mengupgrade cluster admin ke versi 1.29.
1.28 dan yang lebih lama
Aturan berikut berlaku untuk cluster pengguna yang dikelola oleh cluster admin atau cluster hybrid versi 1.28 atau yang lebih lama:
Versi cluster pengguna tidak boleh lebih tinggi dari versi cluster pengelola (admin atau hybrid).
Cluster pengguna dapat memiliki hingga satu versi minor di bawah versi cluster pengelolaan. Misalnya, cluster admin versi 1.28 tidak dapat mengelola cluster pengguna di versi 1.15.
Untuk cluster pengelolaan tertentu, semua cluster pengguna terkelola harus berada di versi minor yang sama.
Untuk mengetahui informasi tentang aturan perbedaan versi untuk node pool, lihat Aturan pembuatan versi node pool.
Aturan versi
Saat mendownload dan menginstal bmctl versi baru, Anda dapat mengupgrade cluster admin, hybrid, mandiri, dan pengguna yang dibuat atau diupgrade dengan bmctl versi sebelumnya. Cluster tidak dapat didowngrade ke versi yang lebih rendah.
Anda hanya dapat mengupgrade cluster ke versi yang cocok dengan versi bmctl yang Anda gunakan. Artinya, jika Anda menggunakan versi
1.36.200-gke.118 dari bmctl, Anda hanya dapat mengupgrade cluster ke versi
1.36.200-gke.118.
Upgrade versi patch
Untuk versi minor tertentu, Anda dapat melakukan upgrade ke versi patch yang lebih tinggi. Artinya,
Anda dapat mengupgrade cluster versi 1.36.X
ke versi 1.36.Y selama Y lebih besar dari X. Misalnya, Anda dapat mengupgrade dari
1.35.0 ke 1.35.100 dan Anda dapat mengupgrade dari
1.35.100 ke 1.35.300. Upgrade ke versi patch terbaru yang direkomendasikan jika memungkinkan untuk memastikan cluster Anda memiliki perbaikan keamanan terbaru.
Untuk patch terbaru yang direkomendasikan, lihat Dukungan versi dan upgrade.
Upgrade versi minor
Saat mengupgrade cluster ke versi minor baru, Anda akan mendapatkan fitur dan kemampuan baru, selain perbaikan dan peningkatan. Aturan untuk upgrade versi minor bergantung pada versi:
1.33 dan yang lebih tinggi
Anda dapat mengupgrade cluster dari satu versi minor ke versi berikutnya, terlepas dari versi patch-nya. Artinya, Anda dapat mengupgrade dari 1.N.X ke 1.N+1.Y, dengan 1.N.X sebagai versi cluster Anda dan N+1 sebagai versi minor berikutnya yang tersedia. Versi patch, X dan Y, tidak memengaruhi logika upgrade dalam kasus ini. Misalnya,
Anda dapat mengupgrade dari 1.35.600-gke.141 ke
1.36.200-gke.118.
Mulai versi 1.33, Google Distributed Cloud mendukung upgrade
lewati (mengupgrade dua versi minor
dalam satu operasi). Artinya, Anda dapat mengupgrade cluster dari versi 1.N.X, dengan N adalah 31 atau yang lebih tinggi, langsung ke versi 1.N+2.Z dengan satu operasi.
Upgrade lewati tersedia untuk Pratinjau untuk versi target 1.33. Meskipun kemampuan ini masih dalam Pratinjau, sebaiknya Anda tidak melakukan upgrade lewati dari versi 1.31 ke 1.33 dengan cluster produksi. Upgrade lewati tersedia secara umum untuk versi target 1.34 dan yang lebih tinggi.
1.32 dan yang lebih rendah
Anda dapat mengupgrade cluster dari satu versi minor ke versi berikutnya, terlepas dari versi patch-nya. Artinya, Anda dapat mengupgrade dari 1.N.X ke 1.N+1.Y, dengan 1.N.X sebagai versi cluster Anda dan N+1 sebagai versi minor berikutnya yang tersedia. Versi patch, X dan Y, tidak memengaruhi logika upgrade dalam kasus ini. Misalnya,
Anda dapat mengupgrade dari 1.35.600-gke.141 ke
1.36.200-gke.118.
Sebelum rilis 1.33, Anda tidak dapat melewati versi minor saat mengupgrade cluster. Jika Anda mencoba mengupgrade ke versi minor yang dua atau lebih versi minor lebih tinggi dari versi cluster saat ini, bmctl akan menampilkan error. Misalnya, Anda tidak dapat mengupgrade cluster versi 1.30.0
ke versi 1.32.0 dalam satu langkah.
Seperti yang dijelaskan sebelumnya, cluster admin dapat mengelola cluster pengguna yang berada di versi yang sama atau lebih rendah. Perbedaan versi antara cluster pengguna dan cluster pengelolanya (terkadang disebut sebagai penyimpangan versi) bervariasi menurut versi cluster. Sebelum mengupgrade cluster pengelolaan ke versi minor baru, pastikan versi cluster pengguna terkelola akan tetap mematuhi aturan penyimpangan versi cluster untuk versi upgrade target.
Aturan pembuatan versi node pool
Saat Anda mengupgrade node pool secara selektif, aturan versi berikut berlaku:
1.30 dan yang lebih baru
Versi cluster harus lebih besar dari atau sama dengan versi worker node pool.
Perbedaan versi maksimum antara node pool worker dan cluster adalah dua versi minor.
Kumpulan worker node dapat berada di versi patch mana pun dari versi minor yang kompatibel.
1,29
Versi cluster harus lebih besar dari atau sama dengan versi worker node pool.
(1.29 GA) Penyimpangan versi maksimum antara worker node pool dan cluster adalah dua versi minor.
Worker node pool tidak boleh berada pada versi yang dirilis secara kronologis setelah versi cluster. Rilis sebelumnya tidak memiliki detail lengkap untuk rilis yang lebih baru, yang merupakan persyaratan untuk kompatibilitas.
Misalnya, versi 1.16.6 dirilis setelah versi 1.28.100-gke.146 dirilis, sehingga Anda tidak dapat mengupgrade cluster dari versi 1.16.6 ke versi 1.28.100-gke.146 dan membiarkan worker node pool di versi 1.16.6. Demikian pula, jika Anda mengupgrade cluster ke versi 1.28.100-gke.146, tetapi memilih untuk membiarkan node pool worker di versi 1.16.5, Anda tidak dapat mengupgrade node pool worker ke versi 1.16.6 saat cluster berada di versi 1.28.100-gke.146.
1,28
Versi cluster harus lebih besar dari atau sama dengan versi worker node pool.
(Pratinjau 1.28) Perbedaan versi maksimum antara node pool worker dan cluster adalah dua versi minor jika fitur Pratinjau perbedaan versi n-2 diaktifkan. Jika Anda tidak mengaktifkan kemampuan ini, ketidaksesuaian versi maksimum antara node pool worker dan cluster adalah satu versi minor.
Worker node pool tidak boleh berada pada versi yang dirilis secara kronologis setelah versi cluster. Rilis sebelumnya tidak memiliki detail lengkap untuk rilis yang lebih baru, yang merupakan persyaratan untuk kompatibilitas.
Misalnya, versi 1.16.6 dirilis setelah versi 1.28.100-gke.146 dirilis, sehingga Anda tidak dapat mengupgrade cluster dari versi 1.16.6 ke versi 1.28.100-gke.146 dan membiarkan worker node pool di versi 1.16.6. Demikian pula, jika Anda mengupgrade cluster ke versi 1.28.100-gke.146, tetapi memilih untuk membiarkan node pool worker di versi 1.16.5, Anda tidak dapat mengupgrade node pool worker ke versi 1.16.6 saat cluster berada di versi 1.28.100-gke.146.
1.16
Versi cluster harus lebih besar dari atau sama dengan versi worker node pool.
Perbedaan versi maksimum antara worker node pool dan cluster adalah satu versi minor.
Worker node pool tidak boleh berada pada versi yang dirilis secara kronologis setelah versi cluster. Rilis sebelumnya tidak memiliki detail lengkap untuk rilis yang lebih baru, yang merupakan persyaratan untuk kompatibilitas.
Misalnya, versi 1.16.6 dirilis setelah versi 1.28.100-gke.146 dirilis, sehingga Anda tidak dapat mengupgrade cluster dari versi 1.16.6 ke versi 1.28.100-gke.146 dan membiarkan worker node pool di versi 1.16.6. Demikian pula, jika Anda mengupgrade cluster ke versi 1.28.100-gke.146, tetapi memilih untuk membiarkan node pool worker di versi 1.16.5, Anda tidak dapat mengupgrade node pool worker ke versi 1.16.6 saat cluster berada di versi 1.28.100-gke.146.
Tabel berikut mencantumkan versi node pool yang didukung yang diizinkan untuk versi cluster tertentu:
1.30 dan yang lebih baru
Untuk cluster versi 1.30 dan yang lebih tinggi, versi node pool dapat lebih rendah hingga dua versi minor. Semua versi patch node pool dalam versi minor yang kompatibel juga kompatibel.
1,29
| Versi cluster (bidang kontrol) | Versi worker node pool yang didukung (versi yang ditambahkan dicetak tebal) | |||
|---|---|---|---|---|
| 1.29.1200-gke.98 |
|
|
|
|
| 1.29.1100-gke.84 |
|
|
|
|
| 1.29.1000-gke.93 |
|
|
|
|
| 1.29.900-gke.180 |
|
|
|
|
| 1.29.800-gke.111 |
|
|
|
|
| 1.29.700-gke.113 |
|
|
|
|
| 1.29.600-gke.105 |
|
|
|
|
| 1.29.500-gke.162 |
|
|
|
|
| 1.29.400-gke.86 |
|
|
|
|
| 1.29.300-gke.185 |
|
|
|
|
| 1.29.200-gke.243 |
|
|
|
|
| 1.29.100-gke.251 |
|
|
|
|
| 1.29.0-gke.1449 |
|
|
|
|
1,28
| Versi cluster (bidang kontrol) | Versi worker node pool yang didukung (versi yang ditambahkan dicetak tebal) | |||
|---|---|---|---|---|
| 1.28.1400-gke.79 |
|
|
|
|
| 1.28.1300-gke.59 |
|
|
|
|
| 1.28.1200-gke.83 |
|
|
|
|
| 1.28.1100-gke.94 |
|
|
|
|
| 1.28.1000-gke.60 |
|
|
|
|
| 1.28.900-gke.112 |
|
|
|
|
| 1.28.800-gke.111 |
|
|
|
|
| 1.28.700-gke.150 |
|
|
|
|
| 1.28.600-gke.163 |
|
|
|
|
| 1.28.500-gke.120 |
|
|
|
|
| 1.28.400-gke.77 |
|
|
|
|
| 1.28.300-gke.131 |
|
|
|
|
| 1.28.200-gke.118 |
|
|
|
|
| 1.28.100-gke.146 |
|
|
|
|
| 1.28.0-gke.425 |
|
|
|
|
1.16
| Versi cluster (bidang kontrol) | Versi worker node pool yang didukung (versi yang ditambahkan dicetak tebal) | |||
|---|---|---|---|---|
| 1.16.12 |
|
|
|
|
| 1.16.11 |
|
|
|
|
| 1.16.10 |
|
|
|
|
| 1.16.9 |
|
|
|
|
| 1.16.8 |
|
|
|
|
| 1.16.7 |
|
|
|
|
| 1.16.6 |
|
|
|
|
| 1.16.5 |
|
|
|
|
| 1.16.4 |
|
|
|
|
| 1.16.3 |
|
|
|
|
| 1.16.2 |
|
|
|
|
| 1.16.1 |
|
|
||
| 1.16.0 |
|
|
||
Mengupgrade komponen
Komponen diupgrade di tingkat node dan cluster. Di tingkat cluster, komponen berikut diupgrade:
- Komponen cluster untuk jaringan, kemampuan observasi, dan penyimpanan.
- Untuk cluster admin, hybrid, dan mandiri, pengontrol siklus proses.
gke-connect-agent.
Node dalam cluster berjalan sebagai salah satu peran berikut, dengan komponen berbeda yang diupgrade bergantung pada peran node:
| Peran node | Fungsi | Komponen yang perlu diupgrade |
|---|---|---|
| Pekerja | Menjalankan workload pengguna | Kubelet, runtime container (Docker atau containerd) |
| Bidang kontrol | Menjalankan bidang kontrol Kubernetes, pengontrol siklus proses cluster, dan add-on platform Google Cloud | Pod statis bidang kontrol Kubernetes (kubeapi-server,
kube-scheduler, kube-controller-manager, etcd)
Pengontrol siklus proses seperti lifecycle-controllers-manager dan
anthos-cluster-operatorAdd-on platform Google Cloud seperti stackdriver-log-aggregator dan
gke-connect-agent |
| Load balancer bidang kontrol | Menjalankan HAProxy dan Keepalived yang menyalurkan traffic ke
kube-apiserver, dan menjalankan speaker MetalLB untuk mengklaim alamat IP
virtual |
Pod statis load balancer bidang kontrol (HAProxy, Keepalived)
Speaker MetalLB |
Ekspektasi periode nonaktif
Tabel berikut menjelaskan perkiraan periode nonaktif dan potensi dampak saat Anda mengupgrade cluster. Tabel ini mengasumsikan bahwa Anda memiliki beberapa node cluster dan bidang kontrol HA. Jika Anda menjalankan cluster mandiri atau tidak memiliki bidang kontrol HA, perkirakan akan ada periode nonaktif tambahan. Kecuali jika disebutkan, periode nonaktif ini berlaku untuk upgrade cluster admin dan pengguna:
| Komponen | Ekspektasi periode nonaktif | Saat periode nonaktif terjadi |
|---|---|---|
Server API bidang kontrol Kubernetes (kube-apiserver),
etcd, dan penjadwal |
Tanpa periode nonaktif | T/A |
Pengontrol siklus proses dan tugas ansible-runner (khusus cluster admin) |
Tanpa periode nonaktif | T/A |
Bidang kontrol Kubernetes loadbalancer-haproxy dan
keepalived |
Periode nonaktif sementara (kurang dari 1 hingga 2 menit) saat load balancer mengalihkan traffic. | Memulai proses upgrade. |
Kemampuan observasi pipeline-stackdriver dan
metrics-server |
Operator dikosongkan dan diupgrade. Periode nonaktif akan berlangsung kurang dari 5 menit.
DaemonSet terus berfungsi tanpa periode nonaktif. |
Setelah node bidang kontrol selesai diupgrade. |
| Container network interface (CNI) | Tidak ada periode nonaktif untuk rute jaringan yang ada. DaemonSet di-deploy dua per dua tanpa periode nonaktif. Operator dikosongkan dan diupgrade. Waktu non-operasional kurang dari 5 menit. |
Setelah node bidang kontrol selesai diupgrade. |
| MetalLB (khusus cluster pengguna) | Operator dikosongkan dan diupgrade. Periode nonaktif kurang dari 5 menit.
Layanan yang ada mengalami periode nonaktif sementara (kurang dari 1 menit) saat load balancer mengalihkan traffic. |
Setelah node bidang kontrol selesai diupgrade. |
| CoreDNS dan autoscaler DNS (khusus cluster pengguna) | CoreDNS memiliki beberapa replika dengan autoscaler. Biasanya tanpa periode nonaktif. | Setelah node bidang kontrol selesai diupgrade. |
| Penyedia volume lokal | Tidak ada periode nonaktif untuk persistent volume (PV) yang disediakan yang sudah ada.
Operator mungkin mengalami periode nonaktif selama 5 menit. |
Setelah node bidang kontrol selesai diupgrade. |
| Istio / ingress | Operator Istio dikosongkan dan diupgrade. Sekitar 5 menit
periode nonaktif. Ingress yang sudah dikonfigurasi akan tetap berfungsi. |
Setelah node bidang kontrol selesai diupgrade. |
| Operator sistem lainnya | Waktu nonaktif 5 menit saat dikosongkan dan diupgrade. | Setelah node bidang kontrol selesai diupgrade. |
| Workload pengguna | Bergantung pada penyiapan, seperti apakah ketersediaannya tinggi. Tinjau deployment workload Anda sendiri untuk memahami potensi dampaknya. |
Saat worker node diupgrade. |
Detail upgrade cluster pengguna
Bagian ini menjelaskan urutan upgrade komponen dan informasi status untuk upgrade cluster pengguna. Bagian berikut menjelaskan penyimpangan dari alur ini untuk upgrade cluster admin, hybrid, atau mandiri.
Diagram berikut menunjukkan proses pemeriksaan preflight untuk upgrade cluster pengguna:

Diagram sebelumnya menjelaskan langkah-langkah yang terjadi selama upgrade:
- Perintah
bmctl upgrade clustermembuat resource kustomPreflightCheck. - Pemeriksaan preflight ini menjalankan pemeriksaan tambahan seperti pemeriksaan upgrade cluster, health check jaringan, dan health check node.
- Hasil pemeriksaan tambahan ini digabungkan untuk melaporkan kemampuan cluster agar berhasil diupgrade ke versi target.
Jika pemeriksaan preflight berhasil dan tidak ada masalah pemblokiran, komponen dalam cluster akan diupgrade dalam urutan yang ditentukan, seperti yang ditunjukkan dalam diagram berikut:

Dalam diagram sebelumnya, komponen diupgrade secara berurutan sebagai berikut:
Upgrade dimulai dengan memperbarui kolom
spec.anthosBareMetalVersion.Load balancer bidang kontrol diupgrade.
Node pool bidang kontrol diupgrade.
Setelah node pool bidang kontrol diupgrade, komponen berikut akan diupgrade secara paralel:
- Connect Agent
- Add-on cluster
- Node pool load balancer
Setelah node pool load balancer berhasil diupgrade, node pool worker akan diupgrade.
Setelah semua komponen diupgrade, health check cluster akan dijalankan.
Health check terus berjalan hingga semua pemeriksaan lulus.
Setelah semua health check lulus, upgrade selesai.
Setiap komponen memiliki kolom statusnya sendiri di dalam resource kustom Cluster. Anda dapat memeriksa status di kolom ini untuk memahami progres upgrade:
| Urutan | Nama kolom | Arti |
|---|---|---|
| 1 | status.controlPlaneNodepoolStatus |
Status disalin dari status node pool bidang kontrol. Kolom ini mencakup versi node dari node pool bidang kontrol |
| 2 | status.anthosBareMetalLifecycleControllersManifestsVersion
|
Versi lifecycles-controllers-manager yang diterapkan ke cluster. Kolom ini hanya tersedia untuk cluster admin, mandiri, atau hybrid. |
| 2 | status.anthosBareMetalManifestsVersion |
Versi cluster dari manifes terakhir yang diterapkan. |
| 2 | status.controlPlaneLoadBalancerNodepoolStatus |
Status disalin dari status node pool load balancer bidang kontrol. Kolom ini kosong jika tidak ada load balancer bidang kontrol terpisah yang
ditentukan di Cluster.Spec. |
| 3 | status.anthosBareMetalVersions |
Peta versi gabungan dari versi ke nomor node. |
| 4 | status.anthosBareMetalVersion |
Status akhir versi yang diupgrade. |
Detail upgrade cluster admin, hybrid, dan mandiri
Mulai dari bmctl versi 1.15.0, perilaku upgrade default untuk cluster yang dikelola sendiri (admin, hybrid, atau mandiri) adalah upgrade langsung.
Artinya, saat Anda mengupgrade cluster ke versi 1.15.0 atau yang lebih tinggi, upgrade
akan menggunakan pengontrol siklus proses, bukan cluster bootstrap, untuk mengelola seluruh
proses upgrade. Perubahan ini menyederhanakan proses dan mengurangi persyaratan resource, sehingga upgrade cluster menjadi lebih andal dan skalabel.
Meskipun tidak direkomendasikan untuk menggunakan cluster bootstrap untuk upgrade, opsi ini masih tersedia. Untuk menggunakan cluster bootstrap saat Anda mengupgrade, jalankan perintah bmctl upgrade dengan flag --use-bootstrap=true.
Tahapan upgrade berbeda-beda, bergantung pada metode yang Anda gunakan.
Upgrade di tempat
Proses upgrade langsung default untuk cluster yang dikelola sendiri mirip dengan proses upgrade cluster pengguna. Namun, saat Anda menggunakan proses upgrade di tempat, versi baru preflightcheck-operator akan di-deploy sebelum pemeriksaan preflight cluster dan health check dijalankan:
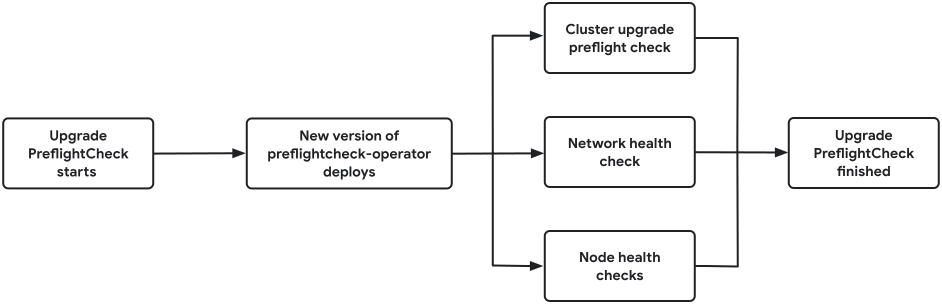
Seperti upgrade cluster pengguna, proses upgrade dimulai dengan mengupdate kolom Cluster.spec.anthosBareMetalVersion ke versi target. Dua langkah tambahan dijalankan sebelum komponen diupdate, seperti yang ditunjukkan dalam diagram berikut: lifecycle-controller-manager mengupgrade dirinya sendiri ke versi target, lalu men-deploy versi target anthos-cluster-operator. anthos-cluster-operator ini melakukan langkah-langkah yang tersisa dari proses upgrade:
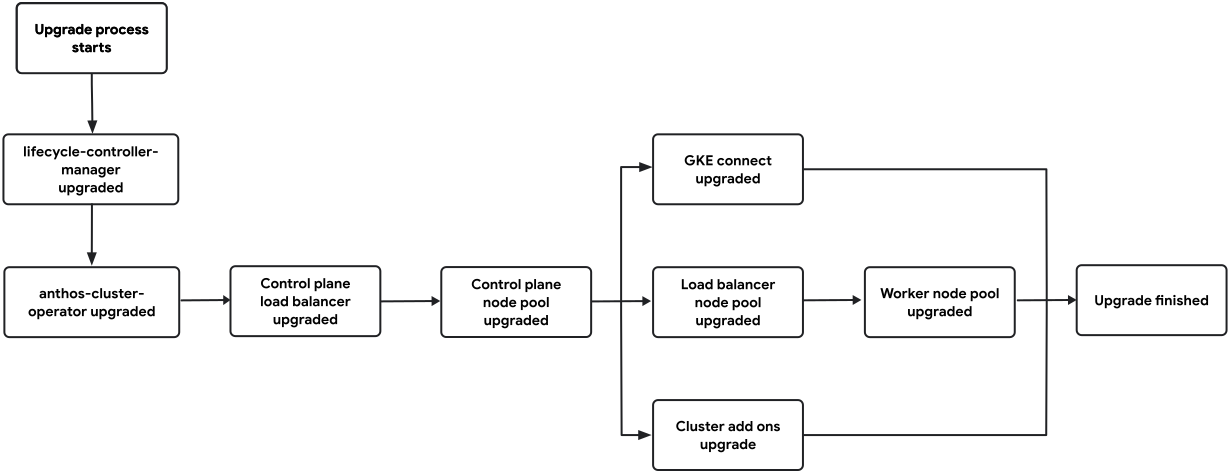
Jika berhasil, anthos-cluster-operator akan merekonsiliasi versi target dari
spec.anthosBareMetalVersion ke status.anthosBareMetalVersion.
Mengupgrade dengan cluster bootstrap
Proses untuk mengupgrade cluster admin, hybrid, atau mandiri mirip dengan cluster pengguna yang dibahas di bagian sebelumnya.
Perbedaan utamanya adalah perintah bmctl upgrade cluster memulai proses
untuk membuat cluster bootstrap. Cluster bootstrap ini adalah cluster sementara yang mengelola cluster hybrid, admin, atau mandiri selama upgrade.
Proses untuk mentransfer kepemilikan pengelolaan cluster ke cluster bootstrap disebut pivot. Proses upgrade selanjutnya sama dengan proses upgrade cluster pengguna.
Selama proses upgrade, resource di cluster target tetap tidak diperbarui. Progres upgrade hanya tercermin dalam resource cluster bootstrap.
Jika perlu, Anda dapat mengakses cluster bootstrap untuk membantu memantau dan men-debug proses upgrade. Cluster bootstrap dapat diakses melalui
bmctl-workspace/.kindkubeconfig.
Untuk mentransfer kepemilikan pengelolaan cluster kembali setelah upgrade selesai, cluster akan memutar resource dari cluster bootstrap ke cluster yang diupgrade. Tidak ada langkah manual yang Anda lakukan untuk memutar cluster selama proses upgrade. Cluster bootstrap akan dihapus setelah upgrade cluster berhasil.
Pengosongan node
Upgrade cluster Google Distributed Cloud dapat menyebabkan gangguan aplikasi saat node dikosongkan. Proses pengosongan ini menyebabkan semua Pod yang berjalan di sebuah node dimatikan dan dimulai ulang di node yang tersisa dalam cluster.
Deployment dapat digunakan untuk menoleransi gangguan tersebut. Deployment dapat menentukan beberapa replika aplikasi atau layanan yang harus dijalankan. Aplikasi dengan beberapa replika seharusnya mengalami sedikit atau tanpa gangguan selama upgrade.
PodDisruptionBudgets (PDB)
Saat Anda mengupgrade cluster, Google Distributed Cloud menggunakan alur mode pemeliharaan untuk mengosongkan node.
Mulai rilis 1.29, node dikosongkan dengan Eviction API, yang mematuhi PodDisruptionBudgets (PDB). PDB dapat digunakan untuk memastikan bahwa jumlah replika yang ditentukan selalu berjalan di cluster dalam kondisi berjalan normal.
PDB memungkinkan Anda membatasi gangguan pada workload saat Pod-nya perlu
dijadwalkan ulang. Pengosongan node berbasis pengeluaran tersedia sebagai GA untuk rilis 1.29.
Dalam rilis 1.28 dan yang lebih rendah, Google Distributed Cloud tidak mematuhi PDB saat node
dikosongkan selama upgrade. Sebagai gantinya, proses pengosongan node adalah upaya terbaik. Beberapa Pod mungkin terjebak dalam status Terminating dan menolak untuk mengosongkan node. Upgrade akan dilanjutkan, meskipun ada Pod yang macet, jika proses pengosongan pada node memerlukan waktu lebih dari 20 menit.
Untuk mengetahui informasi selengkapnya, lihat Menempatkan node ke mode pemeliharaan.
Langkah berikutnya
- Tinjau praktik terbaik untuk upgrade Google Distributed Cloud
- Mengupgrade Google Distributed Cloud
- Memecahkan masalah upgrade cluster