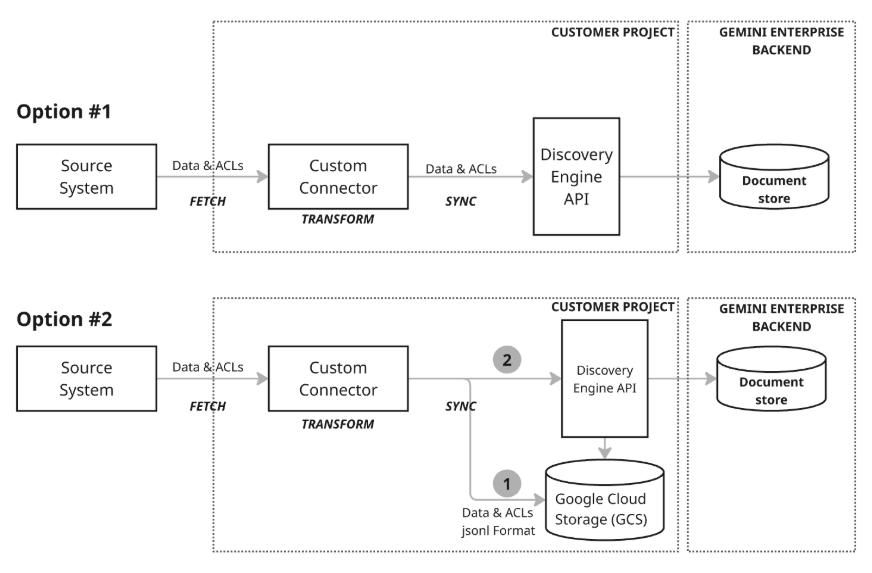
Les connecteurs personnalisés vous permettent d'intégrer des sources de données externes ne faisant pas partie de la bibliothèque de connecteurs standard de Gemini Enterprise. Les données spécifiques de votre organisation sont ainsi accessibles et interrogeables en langage naturel, grâce à Gemini et à l'intelligence de recherche avancée de Google. Le connecteur personnalisé interagit directement avec l'API Discovery Engine, qui permet de stocker, d'indexer et de rechercher des données de manière intelligente. Le connecteur convertit les informations sources au format de document standardisé basé sur JSON (en structurant le contenu, les métadonnées et les listes de contrôle d'accès (LCA)) et s'assure que ces données sont organisées dans des datastores. Ces magasins agissent comme des dépôts logiques, représentant idéalement un seul format de document, chacun avec son propre index de recherche et ses propres configurations.
Fonctionnement des connecteurs personnalisés
Les connecteurs personnalisés utilisent un pipeline de données automatisé pour effectuer trois actions clés : récupérer, transformer et synchroniser. Ce processus permet de s'assurer que les données externes sont correctement préparées et importées dans Gemini Enterprise.
Récupération : le connecteur extrait les données, y compris les documents, les métadonnées et les autorisations, du système externe à l'aide de ses API, de ses bases de données ou de ses formats de fichiers.
Transformation : le connecteur convertit les données brutes au format de document de Discovery Engine, structure le contenu et les métadonnées, et attribue un identifiant unique à chaque document. Pour les contrôles d'accès, vous pouvez utiliser directement des identités reconnues par Google, ou le mappage d'identités pour les utilisateurs externes ou les groupes personnalisés.
Synchronisation : le connecteur importe les documents dans les datastores Gemini Enterprise et les maintient à jour via des jobs planifiés. La synchronisation des données est effectuée à l'aide d'un data store créé pour une entité. Pour en savoir plus sur la création d&#data store, consultez Processus de création d'un datastore. Choisissez un mode de synchronisation en fonction de vos besoins : Incrémentiel ajoute et met à jour les données, tandis que Complet remplace l'ensemble de données entier.
LCA et mappage d'identité
Pour gérer l'accès au niveau des documents, choisissez entre deux méthodes : les LCA pures ou le mappage d'identité, en fonction du format d'identité utilisé par les données.
LCA pures (AclInfo) : cette méthode est utilisée lorsque la source de données utilise des identités basées sur l'adresse e-mail reconnues par (Google Cloud). Cette approche est idéale pour définir directement qui a accès.
Mappage d'identité : cette méthode est utilisée lorsque la source de données utilise des noms d'utilisateur, des anciens ID ou d'autres systèmes d'identité externes :
Il établit une association claire et univoque entre les groupes d'identité externes (par exemple, EXT1) et les utilisateurs ou groupes du fournisseur d'identité (IdP) interne (par exemple,
IDPUser1@example.com).Il permet au système de comprendre et d'appliquer les contrôles d'accès basés sur les groupes du système source, ce qui est utile lorsqu'une API renvoie des libellés de groupe sans appartenance complète des utilisateurs ou pour faire évoluer efficacement les LCA sans lister des milliers d'utilisateurs par document.
Le processus de mappage d'identité nécessite de résoudre toutes les structures d'identité imbriquées ou hiérarchiques en une liste plate de mappages directs, généralement dans un format JSON spécifié.
Utilisez des ID de groupe d'identités externes uniques (par exemple, EXT1) pour les identités externes afin de préserver l'intégrité du système. Pour en savoir plus et obtenir des exemples, consultez Mapper des identités externes.
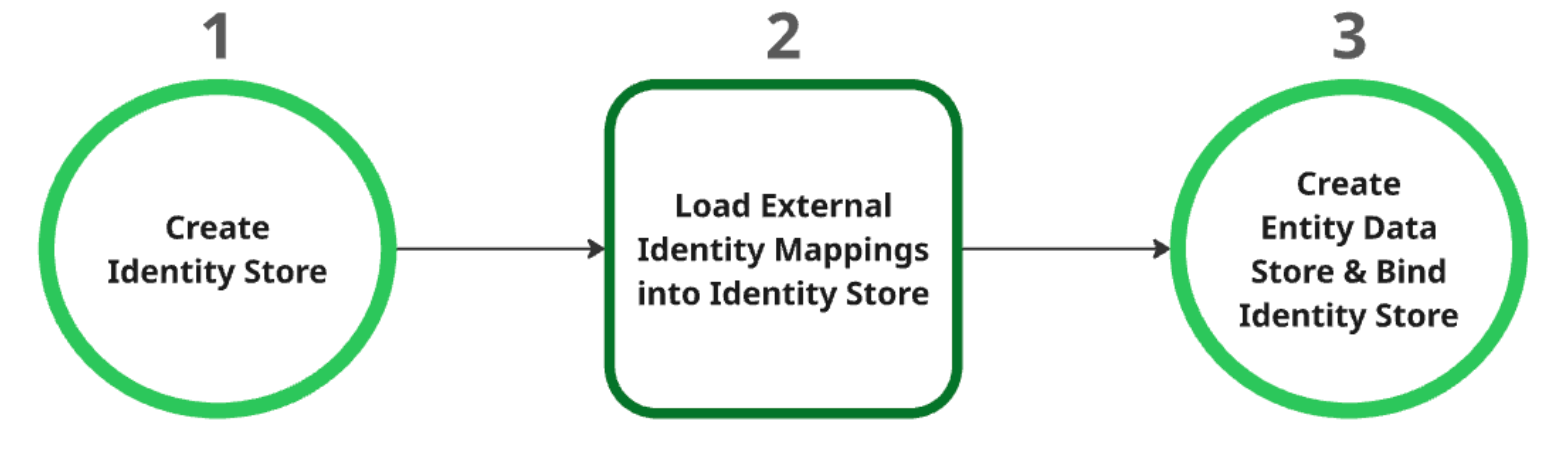
Processus de création d'un datastore
Créer le magasin d'identités : ce magasin sert de ressource parente pour tous les mappages d'identité. Lors de la création, les paramètres du fournisseur d'identité (IDP) au niveau du projet sont automatiquement récupérés. Pour en savoir plus, consultez Récupérer ou créer un magasin d'identités.
Charger les mappages d'identités externes dans le magasin d'identités : après avoir créé le magasin d'identités, chargez-y les données d'identité externes. Pour en savoir plus, consultez Ingérer le mappage d'identité dans le magasin d'identités.
Créer et lier le data store d'entités : le data store d'entités ne peut être créé qu'après la création du magasin d'identités et le chargement des mappages d'identités. Vous devez lier le magasin d'identités au data store d'entités lors de sa création. Pour en savoir plus sur la création d'data store d'entités, consultez Créer un datastore.
Synchroniser les données
Il existe deux modèles d'architecture différents pour la synchronisation des données :
Modèle d'architecture 1 : Upsert incrémentiel : l'approche d'upsert incrémentiel est la plus adaptée aux scénarios dans lesquels les données sont diffusées en continu et nécessitent des mises à jour en temps réel. Le connecteur exploite l'API Discovery Engine pour effectuer des upserts (insertion ou mise à jour de données) incrémentaux efficaces en appelant les fonctions appropriées avec de petites modifications au fur et à mesure qu'elles se produisent. Cette approche axée sur des tailles de modification minimales et un délai minimal permet de maintenir le magasin de documents à jour, même avec des données qui changent rapidement.
Modèle d'architecture 2 : synchronisation complète avec Google Cloud Storage : cette approche recommandée offre un ensemble complet de fonctionnalités de gestion des données et une grande flexibilité. Il accepte les synchronisations complètes, qui permettent d'insérer, de mettre à jour et de supprimer des données dans l'ensemble de données, ainsi que les synchronisations incrémentielles, qui ne gèrent que les insertions et les mises à jour en envoyant les modifications. Cette approche est donc robuste pour un large éventail de besoins en données, en particulier pour la gestion d'opérations de données plus volumineuses ou plus complexes. Ce modèle utilise un processus de préproduction (étape 1 du diagramme) dans lequel le connecteur écrit d'abord les données dans Google Cloud Storage (GCS), puis exploite l'API Discovery Engine pour mettre à jour le datastore de documents en appelant les fonctions d'importation nécessaires à partir de l'emplacement GCS de préproduction.
Les connecteurs personnalisés sont suffisamment flexibles pour prendre en charge une architecture hybride. Vous pouvez ainsi implémenter un upsert incrémentiel pour les données qui changent rapidement et une synchronisation complète pour les mises à jour ou suppressions complètes de données planifiées.