


Importante: defina o description do corpus ao criar um corpus RAG. Não é possível editar o description após a criação. Descrições de alta qualidade são essenciais para uma recuperação eficaz entre corpora, já que o sistema depende delas para selecionar os corpora adequados para sua consulta.
Nesta página, descrevemos duas APIs, AsyncRetrieveContexts e AskContexts, que oferecem suporte à recuperação entre corpora do RAG, com tecnologia de recuperação agêntica no back-end.
API AsyncRetrieveContexts: é uma API assíncrona que permite aos usuários recuperar contextos relevantes de vários corpora gerenciados por RAG. Essa é uma API de longa duração. Os usuários podem usar o ID da operação para conferir o status da consulta e do resultado.
API AskContexts: é uma API síncrona que gera diretamente a resposta à consulta pesquisando em vários corpora gerenciados por RAG.
Importante: para usar esse recurso, é necessário conceder o papel de Usuário da Agent Platform no seu projeto à conta de serviço do Mecanismo RAG na Gemini Enterprise Agent Platform: service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com.
Importante: esse recurso está disponível apenas em us-central1.
Arquitetura do sistema e seleção de corpus
Nesta seção, descrevemos a arquitetura do sistema de recuperação entre corpora da RAG e como ele seleciona os corpora apropriados para recuperação.
Arquitetura do sistema
O sistema de recuperação entre corpora usa uma abordagem agêntica para organizar a recuperação em vários corpora. Uma visão geral de alto nível da arquitetura inclui os seguintes componentes:
- Orquestrador/roteador: recebe a consulta do usuário e coordena o processo de recuperação.
- Agente de planejamento: analisa a consulta e determina quais corpora são mais relevantes com base em
descriptions. - Mecanismo de recuperação: realiza uma pesquisa semântica nos corpora de RAG selecionados.
- Agente de raciocínio: avalia se os contextos recuperados são suficientes para responder à consulta. Se for insuficiente, ele gera feedback para acionar outro loop de recuperação com base na Consciência de Contexto Suficiente (SCA, na sigla em inglês). Para mais detalhes, consulte o post do blog sobre SCA e o artigo de pesquisa.
- Gerador de LLM (para
AskContexts): sintetiza os contextos recuperados para gerar uma resposta final.
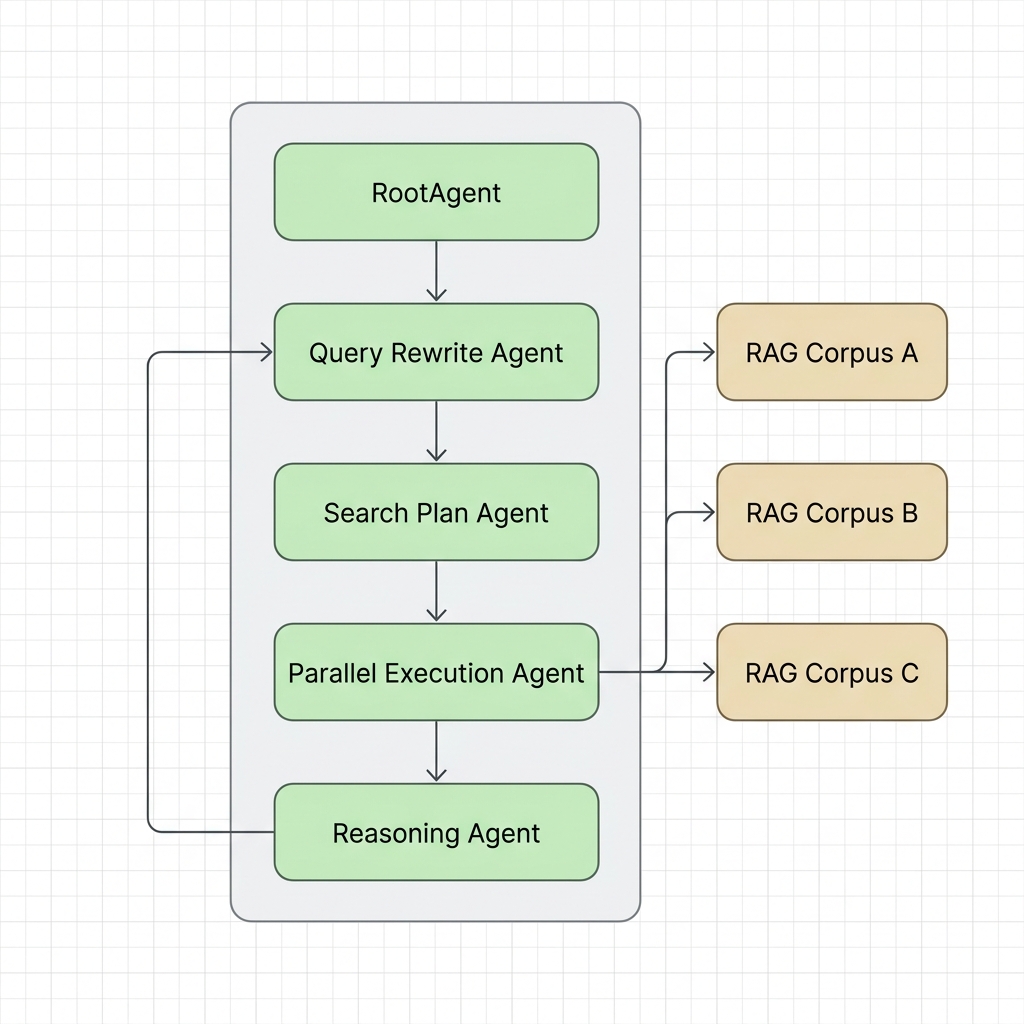
Como os corpora são selecionados
Quando uma consulta é executada em vários corpora gerenciados pela RAG, o sistema precisa determinar qual corpus contém as informações necessárias para responder à consulta. Isso é feito com a recuperação agêntica:
- Mapeamento de corpus: o sistema mantém um mapa dos corpora de RAG disponíveis, com as descrições técnicas (especificadas no campo
descriptiondo corpus de RAG). - Correspondência semântica: um agente de planejamento estratégico (com tecnologia de um modelo do Gemini) avalia a consulta do usuário em relação ao
descriptionsdos corpora disponíveis. - Roteamento direcionado: o planejador gera um plano de recuperação que mapeia partes específicas da consulta para os corpora mais relevantes, garantindo que a recuperação seja focada e eficiente, em vez de pesquisar todos os corpora de forma ingênua.
Exemplos de código
Os exemplos de código a seguir demonstram como usar as APIs de recuperação de corpus cruzado do RAG.
AsyncRetrieveContexts API
Este exemplo de código demonstra como recuperar contextos de vários corpora de RAG de forma assíncrona.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Receber resultado da operação
Como AsyncRetrieveContexts é uma operação de longa duração, use a API GetOperations para consultar o resultado usando o ID da operação.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
API AskContexts
Este exemplo de código demonstra como gerar uma resposta diretamente pesquisando em vários corpora RAG de forma síncrona.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
A seguir
- Para saber mais sobre a API RAG, consulte API RAG Engine.
- Para saber mais sobre as respostas da RAG, consulte Saída de recuperação e geração do mecanismo RAG.
- Para aprender mais sobre o mecanismo RAG, consulte a visão geral do mecanismo RAG.