


חשוב: צריך להגדיר את הקורפוס description כשיוצרים קורפוס RAG. אי אפשר לערוך את description אחרי שיוצרים אותו. תיאורים איכותיים הם חיוניים לאחזור יעיל של מידע מכמה מאגרים, כי המערכת מסתמכת עליהם כדי לבחור את המאגרים המתאימים לשאילתה שלכם.
בדף הזה מתוארים שני ממשקי API, AsyncRetrieveContexts ו-AskContexts, שתומכים באחזור RAG בין קורפוסים, באמצעות Agentic Retrieval בקצה העורפי.
AsyncRetrieveContexts API: זהו API אסינכרוני שמאפשר למשתמשים לאחזר הקשרים רלוונטיים מכמה מאגרי מידע שמנוהלים על ידי RAG. זהו API שפועל לאורך זמן. המשתמשים יכולים להשתמש במזהה הפעולה כדי לקבל את הסטטוס של השאילתה והתוצאה.
AskContexts API: זהו API סינכרוני שיוצר ישירות את התשובה לשאילתה על ידי חיפוש בכמה מאגרי מידע שמנוהלים על ידי RAG.
חשוב: כדי להשתמש בתכונה הזו, צריך להקצות את התפקיד משתמש ב-Vertex AI בפרויקט לחשבון השירות של מנוע RAG ב-Gemini Enterprise Agent Platform: service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com.
חשוב: התכונה הזו זמינה רק ב-us-central1.
ארכיטקטורת המערכת ובחירת הקורפוס
בקטע הזה מתוארת הארכיטקטורה של מערכת RAG לאחזור מידע מקורפוסים שונים, ומוסבר איך היא בוחרת את הקורפוסים המתאימים לאחזור.
ארכיטקטורת המערכת
מערכת Cross Corpus Retrieval משתמשת בגישה מבוססת-סוכנים כדי לתזמר את האחזור בכמה מאגרים. סקירה כללית ברמה גבוהה של הארכיטקטורה כוללת את הרכיבים הבאים:
- תזמור/ניתוב: מקבל את שאילתת המשתמש ומתאם את תהליך האחזור.
- סוכן תכנון: מנתח את השאילתה וקובע אילו מאגרי מידע הכי רלוונטיים על סמך
descriptionsשלהם. - מנוע אחזור: מבצע חיפוש סמנטי בקורפוסים שנבחרו ל-RAG.
- סוכן הסקת מסקנות: בודק אם ההקשרים שאוחזרו מספיקים כדי לענות על השאילתה. אם הוא לא מספיק, המודל יוצר משוב שמפעיל לולאת אחזור נוספת על סמך מודעות להקשר מספיק (SCA). פרטים נוספים זמינים בפוסט בבלוג של SCA ובמאמר המחקר.
- מחולל LLM (ל-
AskContexts): מסנתז את ההקשרים שאוחזרו כדי ליצור תשובה סופית.
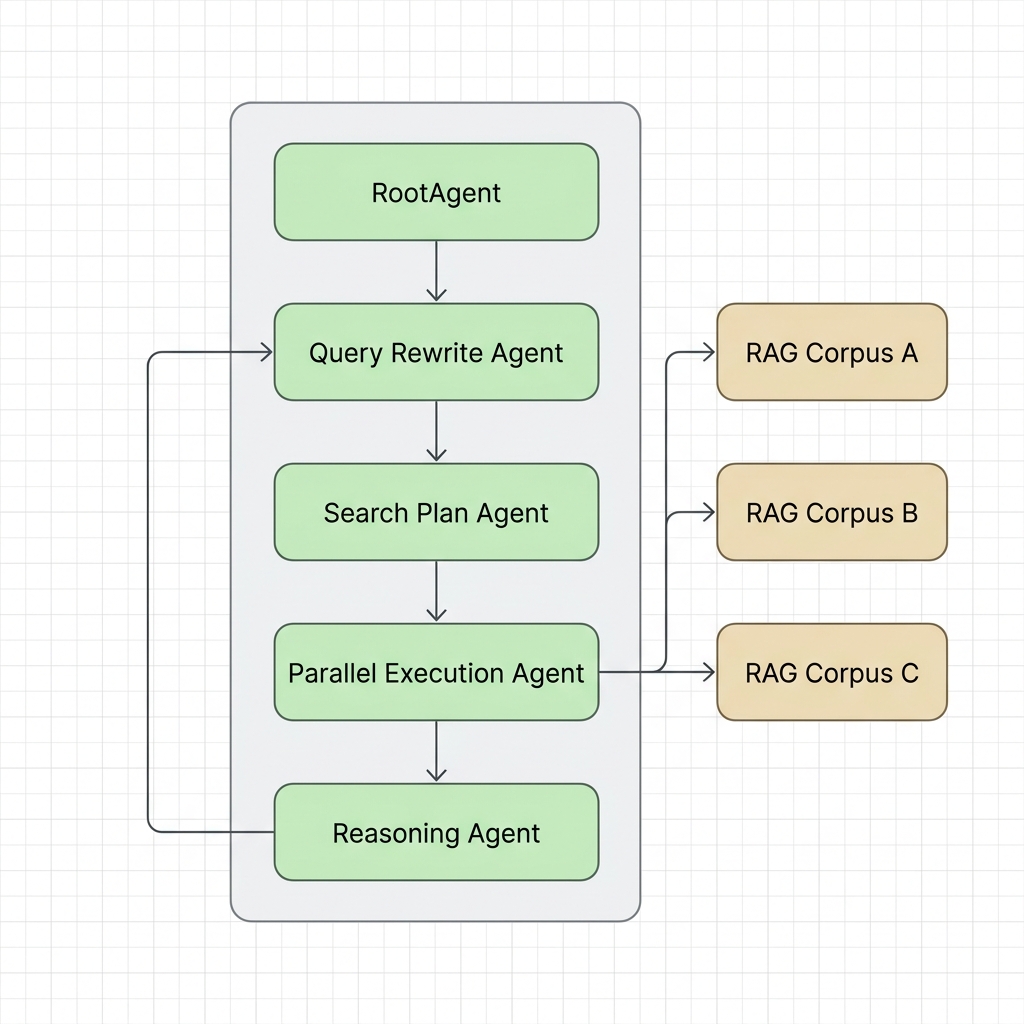
איך נבחרים מאגרי מידע
כששאילתה מופעלת בכמה קורפוסים מנוהלים של RAG, המערכת צריכה לקבוע איזה קורפוס מכיל את המידע שנדרש כדי לענות על השאילתה. כדי לעשות את זה, הוא משתמש בשליפה אג'נטית:
- מיפוי מאגרים: המערכת שומרת מפה של מאגרי RAG זמינים יחד עם התיאורים הטכניים שלהם (שמצוינים בשדה
descriptionשל מאגר ה-RAG). - התאמה סמנטית: סוכן לתכנון אסטרטגי (שמבוסס על מודל Gemini) מעריך את השאילתה של המשתמש בהשוואה ל
descriptionsשל מאגרי הנתונים הזמינים. - ניתוב ממוקד: הכלי לתכנון יוצר תוכנית אחזור שממפה חלקים ספציפיים של השאילתה לקורפוסים הרלוונטיים ביותר, כדי להבטיח שהאחזור יהיה ממוקד ויעיל במקום לחפש בכל הקורפוסים בצורה נאיבית.
דוגמאות קוד
דוגמאות הקוד הבאות ממחישות איך להשתמש בממשקי ה-API של RAG Cross Corpus Retrieval.
AsyncRetrieveContexts API
דוגמת הקוד הזו ממחישה איך לאחזר הקשרים מכמה מאגרי RAG באופן אסינכרוני.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
קבלת תוצאת הפעולה
מכיוון ש-AsyncRetrieveContexts היא פעולה ממושכת, אפשר להשתמש ב-API GetOperations כדי לדגום את התוצאה באמצעות מזהה הפעולה.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
AskContexts API
דוגמת הקוד הזו ממחישה איך ליצור תשובה ישירות על ידי חיפוש בכמה מאגרי RAG באופן סינכרוני.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
המאמרים הבאים
- מידע נוסף על RAG API זמין במאמר RAG Engine API.
- מידע נוסף על התשובות מ-RAG מופיע במאמר פלט האחזור והיצירה של RAG Engine.
- למידע ולמידה על RAG Engine, ראו את הסקירה הכללית על RAG Engine.