


このドキュメントでは、Managed Service for Apache Spark クラスタで実行されている Managed Service for Apache Spark Jobs サービス、Spark SQL CLI、または Zeppelin ウェブ インターフェースを使用して、メタデータが Lakehouse ランタイム カタログに保存された Apache Iceberg テーブルを作成する方法を示します。
始める前に
まだ作成していない場合は、 Google Cloud プロジェクト、Cloud Storage バケット、Managed Service for Apache Spark クラスタを作成します。
プロジェクトを設定する
- Google Cloud アカウントにログインします。 Google Cloudを初めて使用する場合は、 アカウントを作成して、実際のシナリオで Google プロダクトのパフォーマンスを評価してください。新規のお客様には、ワークロードの実行、テスト、デプロイができる無料クレジット $300 分も差し上げます。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init -
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init
プロジェクトの Cloud Storage バケットを作成します。
- Google Cloud コンソールで、Cloud Storage の [バケット] ページに移動します。
- [ 作成] をクリックします。
- [バケットの作成] ページでユーザーのバケット情報を入力します。次のステップに進むには、[続行] をクリックします。
- [始める] セクションで、次の操作を行います。
-
[データの保存場所の選択] セクションで、次の操作を行います。
- ロケーション タイプを選択してください。
- [ロケーション タイプ] プルダウン メニューから、バケットのデータが永続的に保存されるロケーションを選択します。
- ロケーション タイプとして [デュアルリージョン] を選択した場合は、関連するチェックボックスを使用してターボ レプリケーションを有効にすることもできます。
- クロスバケット レプリケーションを設定するには、[Storage Transfer Service 経由でクロスバケット レプリケーションを追加する] を選択し、次の手順を実施します。
クロスバケット レプリケーションを設定する
- [バケット] メニューで、バケットを選択します。
[レプリケーション設定] セクションで、[構成] をクリックして、レプリケーション ジョブの設定を構成します。
[クロスバケット レプリケーションを構成する] ペインが表示されます。
- オブジェクト名の接頭辞で複製するオブジェクトをフィルタするには、オブジェクトを追加または除外する接頭辞を入力し、 [接頭辞を追加] をクリックします。
- 複製されたオブジェクトのストレージ クラスを設定するには、[ストレージ クラス] メニューからストレージ クラスを選択します。この手順をスキップすると、複製されたオブジェクトはデフォルトで宛先バケットのストレージ クラスを使用します。
- [完了] をクリックします。
-
[データの保存場所を選択する] セクションで、次の操作を行います。
- バケットのデフォルトのストレージ クラスを選択するか、バケットデータのストレージ クラスを自動的に管理する Autoclass を選択します。
- 階層名前空間を有効にするには、[データ量が多いワークロード向けにストレージを最適化] セクションで、[このバケットで階層的な名前空間を有効にする] を選択します。
- [オブジェクトへのアクセスを制御する方法を選択する] セクションで、バケットに公開アクセスの防止を適用するかどうかを選択し、バケットのオブジェクトに使用するアクセス制御方法を選択します。
-
[オブジェクト データを保護する方法を選択する] セクションで、次の操作を行います。
- [データ保護] で、バケットに設定するオプションを選択します。
- 削除(復元可能)を有効にするには、[削除(復元可能)ポリシー(データ復元用)] チェックボックスをオンにして、削除後にオブジェクトを保持する日数を指定します。
- オブジェクトのバージョニングを設定するには、[オブジェクトのバージョニング(バージョン管理用)] チェックボックスをオンにして、オブジェクトあたりの最大バージョン数と、非現行バージョンの有効期限が切れるまでの日数を指定します。
- オブジェクトとバケットで保持ポリシーを有効にするには、[保持(コンプライアンス用)] チェックボックスをオンにして、次の操作を行います。
- オブジェクト保持ロックを有効にするには、[オブジェクト保持を有効にする] チェックボックスをオンにします。
- バケットロックを有効にするには、[バケット保持ポリシーを設定] チェックボックスをオンにして、保持期間の単位と期間を選択します。
- オブジェクト データの暗号化方法を選択するには、[データ暗号化] セクション()を開き、データの暗号化方法を選択します。
- [データ保護] で、バケットに設定するオプションを選択します。
- [作成] をクリックします。
Managed Service for Apache Spark クラスタを作成します。リソースと費用を節約するには、このドキュメントで説明する例の実行用に単一ノードの Managed Service for Apache Spark クラスタを作成します。
クラスタが作成されるリージョンのサブネットで、プライベート Google アクセス(PGA)を有効にする必要があります。
このガイドの Zeppelin ウェブ インターフェースの例を実行する場合は、Zeppelin オプション コンポーネントが有効になっている Managed Service for Apache Spark クラスタを使用または作成する必要があります。
カスタム サービス アカウントにロールを付与します(必要な場合)。デフォルトでは、Managed Service for Apache Spark クラスタ VM は Compute Engine のデフォルトのサービス アカウントを使用して Managed Service for Apache Spark とやり取りします。クラスタの作成時にカスタム サービス アカウントを指定する場合は、Managed Service for Apache Spark ワーカーロール(
roles/dataproc.worker)または必要なワーカーロール権限を持つカスタムロールが必要です。
OSS データベースと BigQuery データセットのマッピング
オープンソース データベースと BigQuery データセットの用語のマッピングは次のとおりです。
| OSS データベース | BigQuery データセット |
|---|---|
| 名前空間、データベース | データセット |
| パーティション分割ありまたはパーティション分割なしのテーブル | テーブル |
| ビュー | ビュー |
Iceberg テーブルを作成する
このセクションでは、Managed Service for Apache Spark クラスタで実行される Managed Service for Apache Spark、Spark SQL CLI、Zeppelin コンポーネント ウェブ インターフェースに Spark SQL コードを送信して、メタデータが Lakehouse ランタイム カタログに保存された Iceberg テーブルを作成する方法を示します。
Managed Service for Apache Spark ジョブ
Managed Service for Apache Spark にジョブを送信するには、Google Cloud コンソールまたは Google Cloud CLI を使用して Managed Service for Apache Spark クラスタにジョブを送信するか、HTTP REST リクエストまたはプログラムによる gRPC Managed Service for Apache Spark Cloud クライアント ライブラリで Jobs API を呼び出します。
このセクションの例では、gcloud CLI、 Google Cloud コンソール、または REST API を使用して、Managed Service for Apache Spark Spark SQL ジョブを Managed Service for Apache Spark サービスに送信し、メタデータが BigQuery に保存された Iceberg テーブルを作成する方法を示します。
ジョブファイルを準備する
次の手順で Spark SQL ジョブファイルを作成します。このファイルには、Iceberg テーブルの作成と更新を行う Spark SQL コマンドが含まれます。
ローカル ターミナル ウィンドウまたは Cloud Shell で、
viやnanoなどのテキスト エディタを使用して、次のコマンドをiceberg-table.sqlファイルにコピーし、ファイルを現在のディレクトリに保存します。USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
次のように置き換えます。
- CATALOG_NAME: Iceberg カタログ名。
- BUCKET と WAREHOUSE_FOLDER: Iceberg ウェアハウスに使用する Cloud Storage バケットとフォルダ。
gcloud CLI を使用して、ローカルの
iceberg-table.sqlを Cloud Storage のバケットにコピーします。gcloud storage cp iceberg-table.sql gs://BUCKET/
次に、iceberg-spark-runtime-3.5_2.12-1.6.1 JAR ファイルをダウンロードして Cloud Storage にコピーします。
ローカル ターミナル ウィンドウまたは Cloud Shell で次の
curlコマンドを実行して、iceberg-spark-runtime-3.5_2.12-1.6.1JAR ファイルを現在のディレクトリにダウンロードします。curl -o iceberg-spark-runtime-3.5_2.12-1.6.1.jar https://storage-download.googleapis.com/maven-central/maven2/org/apache/iceberg/iceberg-spark-runtime-3.5_2.12/1.6.1/iceberg-spark-runtime-3.5_2.12-1.6.1.jar
gcloud CLI を使用して、ローカルの
iceberg-spark-runtime-3.5_2.12-1.6.1JAR ファイルを現在のディレクトリから Cloud Storage のバケットにコピーします。gcloud storage cp iceberg-spark-runtime-3.5_2.12-1.6.1.jar gs://BUCKET/
Spark SQL ジョブを送信する
対応するタブの手順に従って、gcloud CLI、Google Cloud コンソール、または Managed Service for Apache Spark REST API を使用して Spark SQL ジョブを Managed Service for Apache Spark に送信します。
gcloud
次の gcloud dataproc jobs submit spark-sql コマンドをローカル ターミナル ウィンドウでローカルに実行するか Cloud Shell で実行して、Iceberg テーブルを作成するための Spark SQL ジョブを送信します。
gcloud dataproc jobs submit spark-sql \
    --project=PROJECT_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --jars="gs://BUCKET/1.6.1/iceberg-spark-runtime-3.5_2.12-1.6.1.jar,BIGLAKE_ICEBERG_CATALOG_JAR" \
    --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER" \
    -f="gs://BUCKETiceberg-table.sql"
注:
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。 プロジェクト ID は、 Google Cloud コンソールのダッシュボードの [プロジェクト情報] セクションに表示されます。
- CLUSTER_NAME: Managed Service for Apache Spark クラスタの名前。
- REGION: クラスタが配置されている Compute Engine リージョン。
BIGLAKE_ICEBERG_CATALOG_JAR: 使用する Iceberg カスタム カタログ プラグインの Cloud Storage URI。Iceberg のバージョン番号に応じて、次のいずれかを選択します。- Iceberg 1.9.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.9.1-1.0.1.jar - Iceberg 1.6.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.6.1-1.0.2.jar
- Iceberg 1.9.1:
- CATALOG_NAME: Iceberg カタログ名。
- BUCKET と WAREHOUSE_FOLDER: Iceberg ウェアハウスに使用する Cloud Storage バケットとフォルダ。
- LOCATION: サポートされている BigQuery のロケーション。デフォルトのロケーションは「US」です。
--jars: Lakehouse ランタイム カタログにテーブルのメタデータを作成するために必要な JAR がリストされています。--properties: カタログのプロパティ。-f: Cloud Storage のバケットにコピーしたiceberg-table.sqlジョブファイル。
ジョブが完了したら、ターミナル出力でテーブルの説明を確認します。
Time taken: 2.194 seconds
id                      int
data                    string
newDoubleCol            double
Time taken: 1.479 seconds, Fetched 3 row(s)
Job JOB_ID finished successfully.
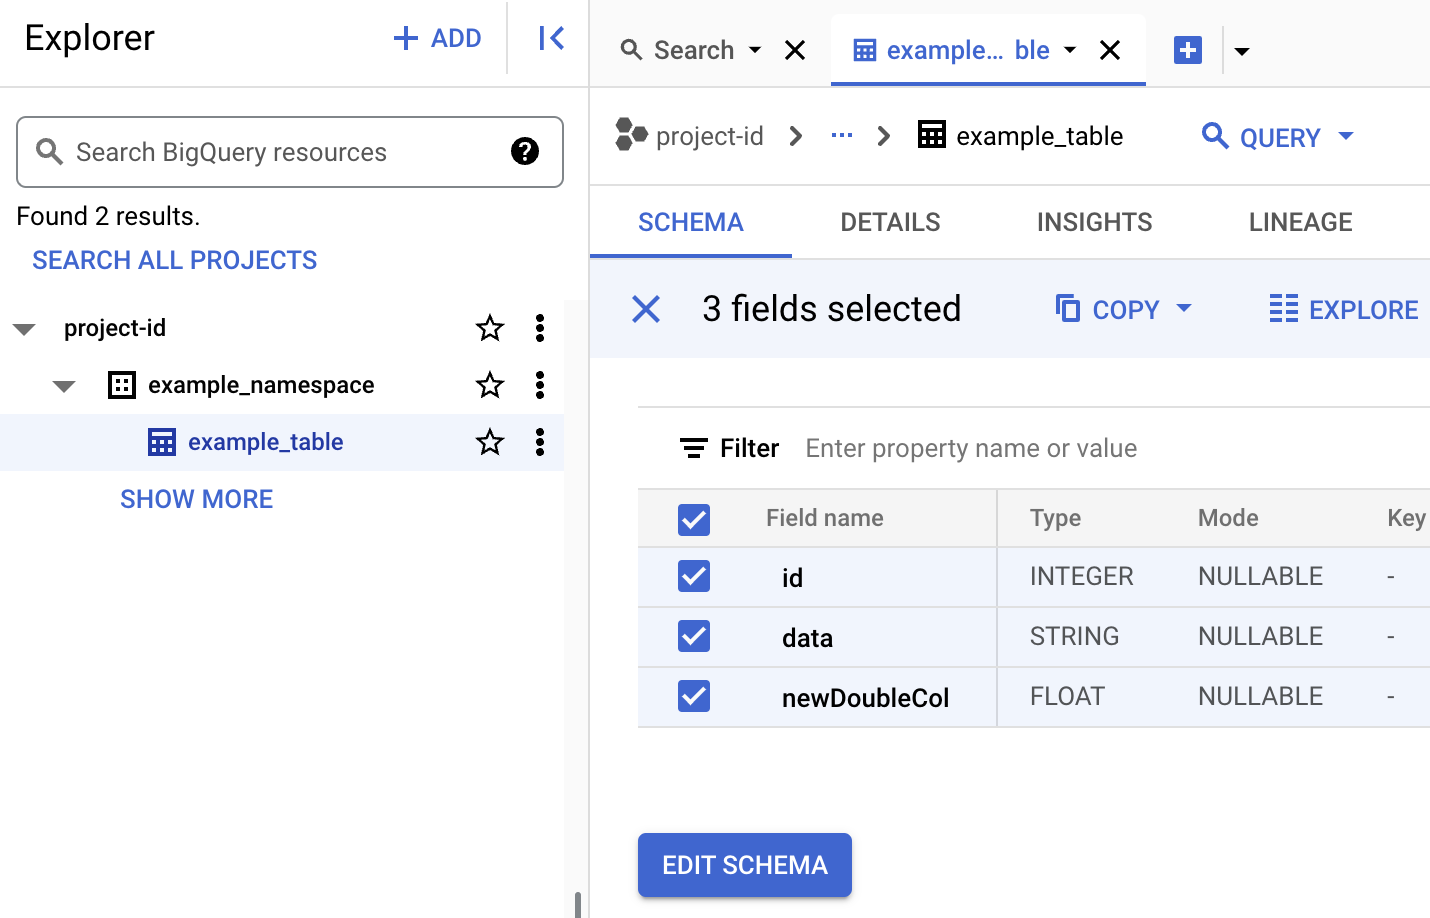
BigQuery でテーブルのメタデータを確認します。
Google Cloud コンソールで、[BigQuery] ページに移動します。
Iceberg テーブルのメタデータを確認します。
コンソール
次の手順で、 Google Cloud コンソールを使用して Spark SQL ジョブを Managed Service for Apache Spark に送信し、メタデータが Lakehouse ランタイム カタログに保存された Iceberg テーブルを作成します。
Google Cloud コンソールで、Managed Service for Apache Spark の [ジョブの送信] に移動します。
[ジョブを送信] ページに移動し、次のフィールドに入力します。
- ジョブ ID: 提示された ID を使用するか、独自の ID を挿入します。
- リージョン: クラスタが配置されているリージョンを選択します。
- クラスタ: クラスタを選択します。
- ジョブタイプ:
SparkSqlを選択します。 - クエリソースのタイプ:
Query fileを選択します。 - クエリファイル:
gs://BUCKET/iceberg-table.sqlを挿入します。 - JAR ファイル: 以下を挿入します。
gs://BUCKET/iceberg-spark-runtime-3.5_2.12-1.6.1.jar,BIGLAKE_ICEBERG_CATALOG_JAR
- BIGLAKE_ICEBERG_CATALOG_JAR: 使用する Iceberg カスタム カタログ プラグインの Cloud Storage URI。Iceberg のバージョン番号に応じて、次のいずれかを選択します。
- Iceberg 1.9.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.9.1-1.0.1.jar - Iceberg 1.6.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.6.1-1.0.2.jar
- Iceberg 1.9.1:
- プロパティ: [プロパティを追加] を 5 回クリックして 5 つの
keyvalue入力フィールドのリストを作成し、次のキーと値のペアをコピーして 5 つのプロパティを定義します。# キー 値 1. spark.sql.catalog.CATALOG_NAMEorg.apache.iceberg.spark.SparkCatalog2. spark.sql.catalog.CATALOG_NAME.catalog-implorg.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog3. spark.sql.catalog.CATALOG_NAME.gcp_projectPROJECT_ID4. spark.sql.catalog.CATALOG_NAME.gcp_locationLOCATION5. spark.sql.catalog.CATALOG_NAME.warehousegs://BUCKET/WAREHOUSE_FOLDER
注:
- CATALOG_NAME: Iceberg カタログ名。
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。 プロジェクト ID は、 Google Cloud コンソールのダッシュボードの [プロジェクト情報] セクションに表示されます。 クラスタが配置されているリージョン。
- LOCATION: サポートされている BigQuery のロケーション。デフォルトのロケーションは「US」です。
- BUCKET と WAREHOUSE_FOLDER: Iceberg ウェアハウスに使用する Cloud Storage バケットとフォルダ。
[送信] をクリックします。
ジョブの進行状況をモニタリングしてジョブ出力を確認するには、 Google Cloud コンソールで Managed Service for Apache Spark の [ジョブ] ページに移動し、
Job IDをクリックして [ジョブの詳細] ページを開きます。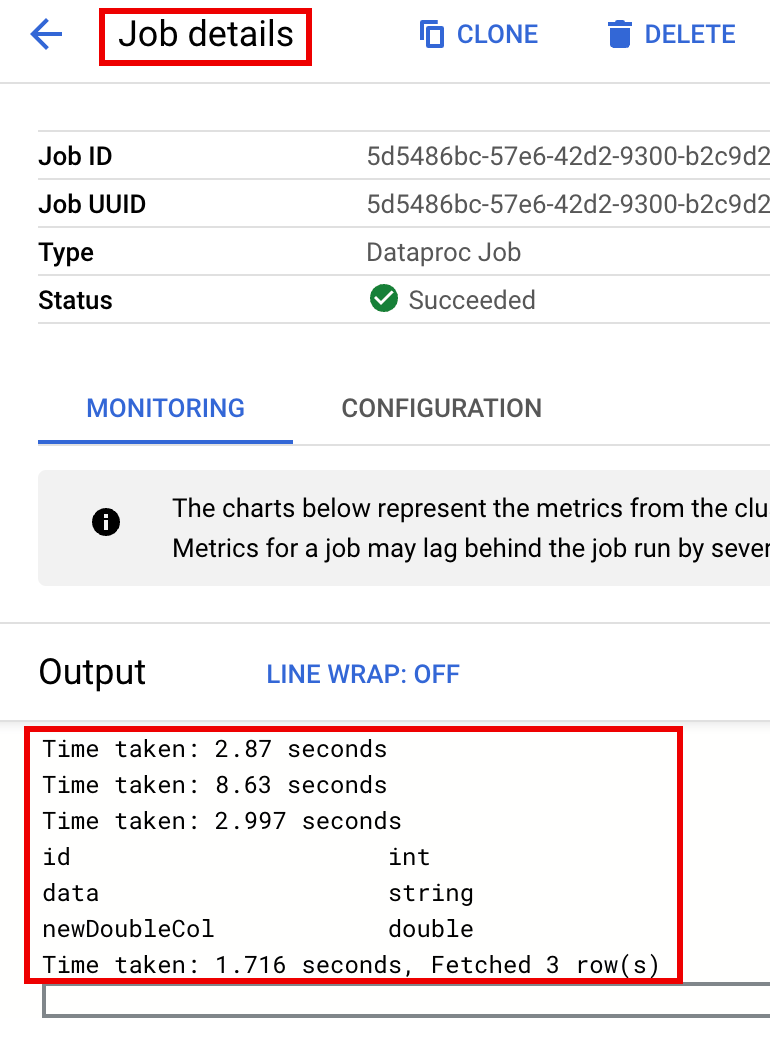
BigQuery でテーブルのメタデータを確認します。
Google Cloud コンソールで、[BigQuery] ページに移動します。
Iceberg テーブルのメタデータを確認します。
REST
Managed Service for Apache Spark jobs.submit API を使用して Spark SQL ジョブを Managed Service for Apache Spark に送信し、メタデータが Lakehouse ランタイム カタログに保存された Iceberg テーブルを作成できます。
リクエストのデータを使用する前に、次のように置き換えます。
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。 プロジェクト ID は、 Google Cloud コンソールのダッシュボードの [プロジェクト情報] セクションに表示されます。
- CLUSTER_NAME: Managed Service for Apache Spark クラスタの名前。
- REGION: クラスタが配置されている Compute Engine リージョン。
- CATALOG_NAME: Iceberg カタログ名。
- BUCKET と WAREHOUSE_FOLDER: Iceberg ウェアハウスに使用する Cloud Storage バケットとフォルダ。 LOCATION: サポートされている BigQuery のロケーション。デフォルトのロケーションは「US」です。
BIGLAKE_ICEBERG_CATALOG_JAR: 使用する Iceberg カスタム カタログ プラグインの Cloud Storage URI。Iceberg のバージョン番号に応じて、次のいずれかを選択します。- Iceberg 1.9.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.9.1-1.0.1.jar - Iceberg 1.6.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.6.1-1.0.2.jar
- Iceberg 1.9.1:
jarFileUris: BigQuery metastore にテーブルのメタデータを作成するために必要な JAR がリストされています。properties: カタログのプロパティ。queryFileUri: Cloud Storage のバケットにコピーしたiceberg-table.sqlジョブファイル。
HTTP メソッドと URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
リクエストの本文(JSON):
{
  "projectId": "PROJECT_ID",
  "job": {
    "placement": {
      "clusterName": "CLUSTER_NAME"
    },
    "statusHistory": [],
    "reference": {
      "jobId": "",
      "projectId": "PROJECT_ID"
    },
    "sparkSqlJob": {
      "properties": {
        "spark.sql.catalog."CATALOG_NAME": "org.apache.iceberg.spark.SparkCatalog",
        "spark.sql.catalog."CATALOG_NAME".catalog-impl": "org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog",
        "spark.sql.catalog."CATALOG_NAME".gcp_project": "PROJECT_ID",
        "spark.sql.catalog."CATALOG_NAME".gcp_location": "LOCATION",
        "spark.sql.catalog."CATALOG_NAME".warehouse": "gs://BUCKET/WAREHOUSE_FOLDER"
      },
      "jarFileUris": [
        "gs://BUCKET/iceberg-spark-runtime-3.5_2.12-1.6.1.jar,BIGLAKE_ICEBERG_CATALOG_JAR"
      ],
      "scriptVariables": {},
      "queryFileUri": "gs://BUCKET/iceberg-table.sql"
    }
  }
}
リクエストを送信するには、次のいずれかのオプションを展開します。
次のような JSON レスポンスが返されます。
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "..."
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "..."
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "..."
  },
  "submittedBy": "USER",
  "sparkSqlJob": {
    "queryFileUri": "gs://BUCKET/iceberg-table.sql",
    "properties": {
      "spark.sql.catalog.USER_catalog": "org.apache.iceberg.spark.SparkCatalog",
      "spark.sql.catalog.USER_catalog.catalog-impl": "org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog",
      "spark.sql.catalog.USER_catalog.gcp_project": "PROJECT_ID",
      "spark.sql.catalog.USER_catalog.gcp_location": "LOCATION",
      "spark.sql.catalog.USER_catalog.warehouse": "gs://BUCKET/WAREHOUSE_FOLDER"
    },
    "jarFileUris": [
      "gs://BUCKET/iceberg-spark-runtime-3.5_2.12-1.6.1.jar",
      "BIGLAKE_ICEBERG_CATALOG_JAR"
    ]
  },
  "driverControlFilesUri": "gs://dataproc-...",
  "driverOutputResourceUri": "gs://dataproc-.../driveroutput",
  "jobUuid": "...",
  "region": "REGION"
}
ジョブの進行状況をモニタリングしてジョブ出力を確認するには、 Google Cloud コンソールで Managed Service for Apache Spark の [ジョブ] ページに移動し、Job ID をクリックして [ジョブの詳細] ページを開きます。
BigQuery でテーブルのメタデータを確認します。
Google Cloud コンソールで、[BigQuery] ページに移動します。
Iceberg テーブルのメタデータを確認します。
Spark SQL CLI
次の手順では、Managed Service for Apache Spark クラスタのマスターノードで実行されている Spark SQL CLI を使用して、テーブル メタデータが Lakehouse ランタイム カタログに保存された Iceberg テーブルを作成する方法を示します。
SSH を使用して、Managed Service for Apache Spark クラスタのマスターノードに接続します。
SSH セッション ターミナルで、
viまたはnanoテキスト エディタを使用して、次のコマンドをiceberg-table.sqlファイルにコピーします。SET CATALOG_NAME = `CATALOG_NAME`; SET BUCKET = `BUCKET`; SET WAREHOUSE_FOLDER = `WAREHOUSE_FOLDER`; USE `${CATALOG_NAME}`; CREATE NAMESPACE IF NOT EXISTS `${CATALOG_NAME}`.example_namespace; DROP TABLE IF EXISTS `${CATALOG_NAME}`.example_namespace.example_table; CREATE TABLE `${CATALOG_NAME}`.example_namespace.example_table (id int, data string) USING ICEBERG LOCATION 'gs://${BUCKET}/${WAREHOUSE_FOLDER}'; INSERT INTO `${CATALOG_NAME}`.example_namespace.example_table VALUES (1, 'first row'); ALTER TABLE `${CATALOG_NAME}`.example_namespace.example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE `${CATALOG_NAME}`.example_namespace.example_table;次のように置き換えます。
- CATALOG_NAME: Iceberg カタログ名。
- BUCKET と WAREHOUSE_FOLDER: Iceberg ウェアハウスに使用する Cloud Storage バケットとフォルダ。
SSH セッション ターミナルで、次の
spark-sqlコマンドを実行して Iceberg テーブルを作成します。spark-sql \ --packages org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:1.6.1 \ --jars https://storage-download.googleapis.com/maven-central/maven2/org/apache/iceberg/iceberg-spark-runtime-3.5_2.12/1.6.1/iceberg-spark-runtime-3.5_2.12-1.6.1.jar,BIGLAKE_ICEBERG_CATALOG_JAR \ --conf spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog \ --conf spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog \ --conf spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID \ --conf spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION \ --conf spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER \ -f iceberg-table.sql
次のように置き換えます。
BIGLAKE_ICEBERG_CATALOG_JAR: 使用する Iceberg カスタム カタログ プラグインの Cloud Storage URI。Iceberg のバージョン番号に応じて、次のいずれかを選択します。- Iceberg 1.9.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.9.1-1.0.1.jar - Iceberg 1.6.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.6.1-1.0.2.jar
- Iceberg 1.9.1:
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。 プロジェクト ID は、 Google Cloud コンソールのダッシュボードの [プロジェクト情報] セクションに表示されます。
- LOCATION: サポートされている BigQuery のロケーション。デフォルトのロケーションは「US」です。
BigQuery でテーブルのメタデータを確認します。
Google Cloud コンソールで、[BigQuery] ページに移動します。
Iceberg テーブルのメタデータを確認します。
Zeppelin ウェブ インターフェース
次の手順では、Managed Service for Apache Spark クラスタのマスターノードで実行されている Zeppelin ウェブ インターフェースを使用して、テーブル メタデータが Lakehouse ランタイム カタログに保存された Iceberg テーブルを作成する方法を示します。
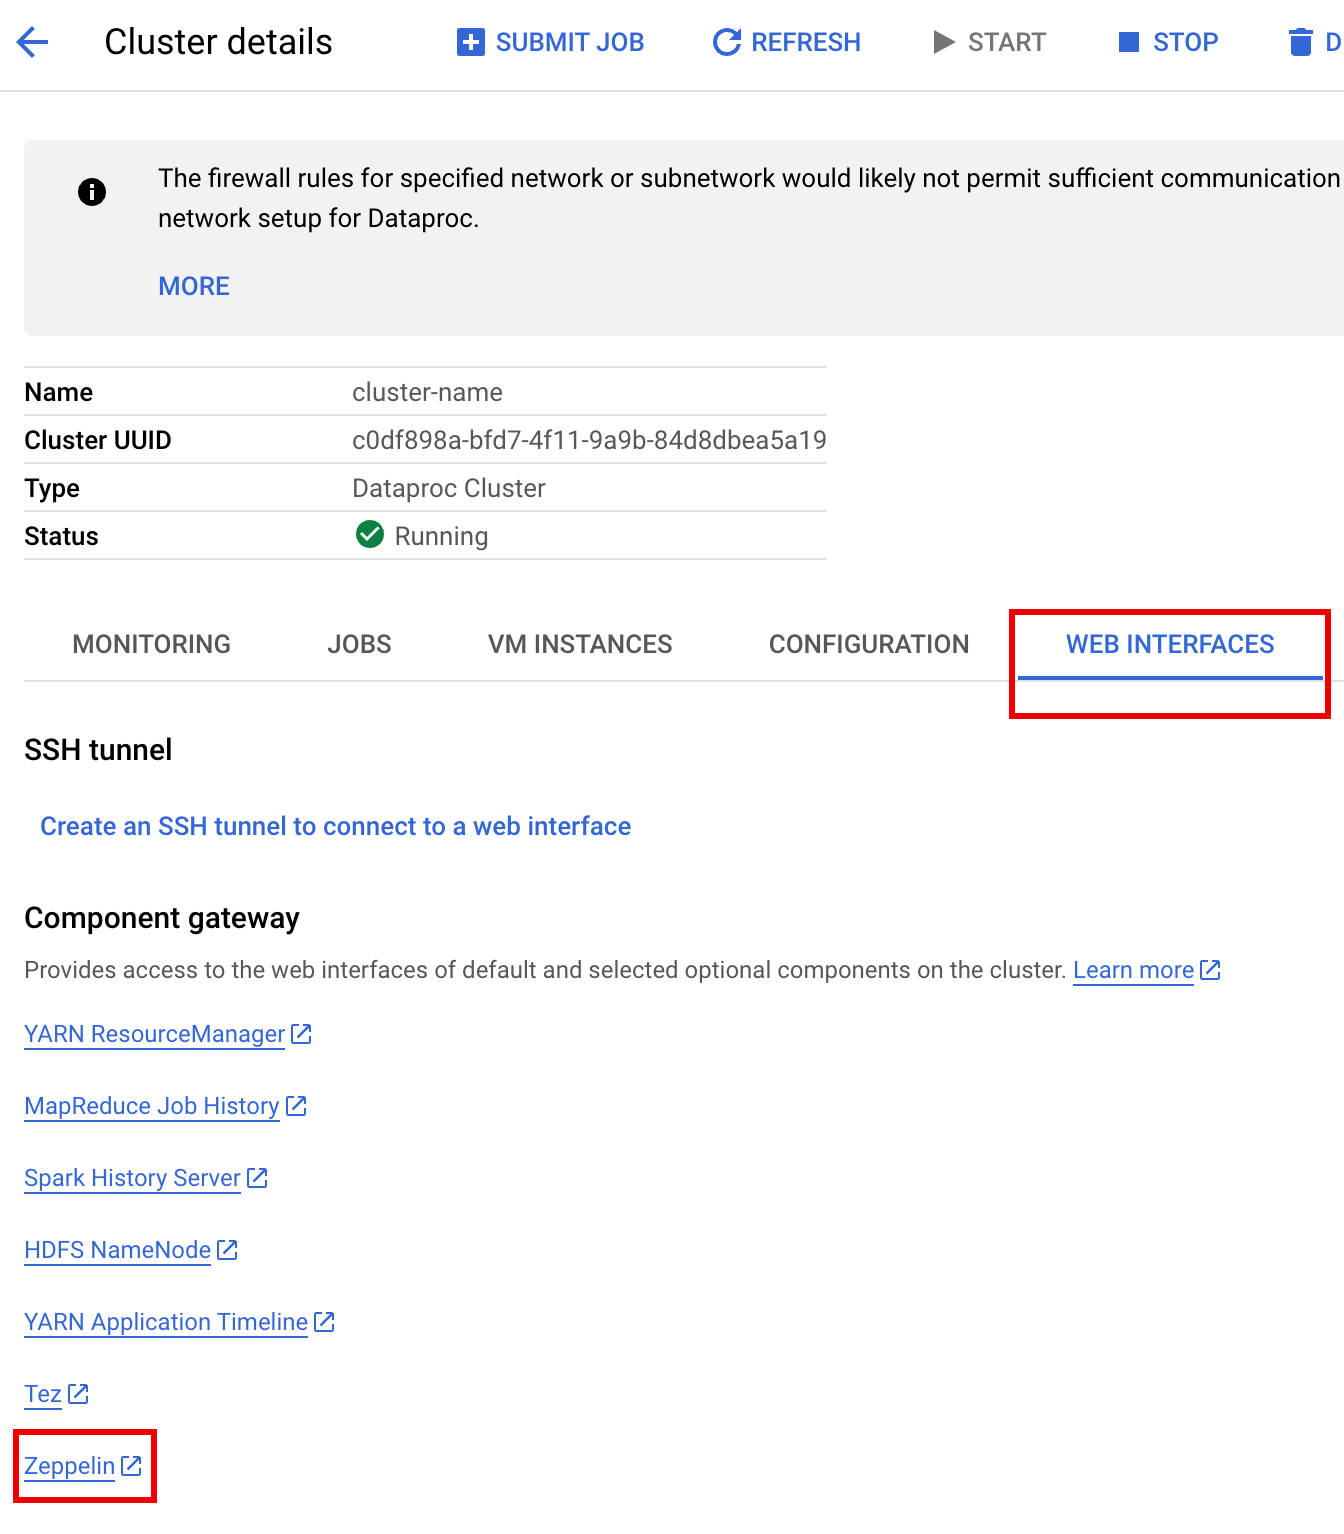
Google Cloud コンソールで、Managed Service for Apache Spark の [クラスタ] ページに移動します。
クラスタ名を選択して [クラスタの詳細] ページを開きます。
[ウェブ インターフェース] タブをクリックすると、クラスタにインストールされているデフォルト コンポーネントとオプション コンポーネントのウェブ インターフェースへのリンクのリストが [コンポーネント ゲートウェイ] に表示されます。
[Zeppelin] リンクをクリックして Zeppelin ウェブ インターフェースを開きます。
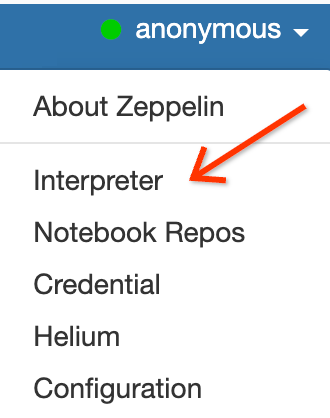
Zeppelin ウェブ インターフェースで [anonymous] メニューをクリックし、[Interpreter] をクリックして [Interpreters] ページを開きます。
次のように、2 つの JAR を Zeppelin Spark インタープリタに追加します。
- [
Search interpreters] ボックスに「Spark」と入力して、Spark インタープリタ セクションまでスクロールします。 - [edit] をクリックします。
[spark.jars] フィールドに次の内容を貼り付けます。
https://storage-download.googleapis.com/maven-central/maven2/org/apache/iceberg/iceberg-spark-runtime-3.5_2.12/1.6.1/iceberg-spark-runtime-3.5_2.12-1.6.1.jar,BIGLAKE_ICEBERG_CATALOG_JAR
次のメモを追加します。
BIGLAKE_ICEBERG_CATALOG_JAR: 使用する Iceberg カスタム カタログ プラグインの Cloud Storage URI。Iceberg のバージョン番号に応じて、次のいずれかを選択します。- Iceberg 1.9.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.9.1-1.0.1.jar - Iceberg 1.6.1:
gs://spark-lib/bigquery/iceberg-bigquery-catalog-1.6.1-1.0.2.jar
Spark インタープリタ セクションの下部にある [Save] をクリックしてから、[OK] をクリックしてインタープリタを更新し、新しい設定で Spark インタープリタを再起動します。
- [
Zeppelin ノートブックのメニューで、[Create new note] をクリックします。
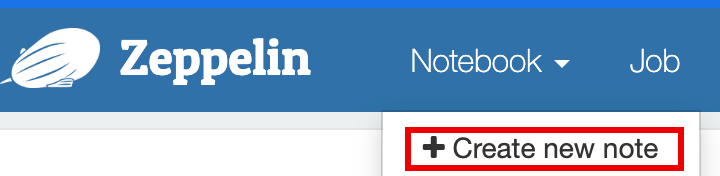
[Create new note] ダイアログでノートブックの名前を入力し、デフォルトの spark インタープリタを受け入れます。[Create] をクリックしてノートブックを開きます。
変数を入力してから、次の PySpark コードを Zeppelin ノートブックにコピーします。
%pyspark

from pyspark.sql import SparkSession

project_id = "PROJECT_ID"
catalog = "CATALOG_NAME"
namespace = "NAMESPACE"
location = "LOCATION"
warehouse_dir = "gs://BUCKET/WAREHOUSE_DIRECTORY"

spark = SparkSession.builder \
.appName("BigQuery Metastore Iceberg") \
.config(f"spark.sql.catalog.{catalog}", "org.apache.iceberg.spark.SparkCatalog") \
.config(f"spark.sql.catalog.{catalog}.catalog-impl", "org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog") \
.config(f"spark.sql.catalog.{catalog}.gcp_project", f"{project_id}") \
.config(f"spark.sql.catalog.{catalog}.gcp_location", f"{location}") \
.config(f"spark.sql.catalog.{catalog}.warehouse", f"{warehouse_dir}") \
.getOrCreate()

spark.sql(f"USE `{catalog}`;")
spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;")
spark.sql(f"USE `{namespace}`;")

\# Create table and display schema (without LOCATION)
spark.sql("DROP TABLE IF EXISTS example_iceberg_table")
spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG")
spark.sql("DESCRIBE example_iceberg_table;")

\# Insert table data.
spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');")

\# Alter table, then display schema.
spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);")

\# Select and display the contents of the table.
spark.sql("SELECT * FROM example_iceberg_table").show()
次のように置き換えます。
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。 プロジェクト ID は、 Google Cloud コンソールのダッシュボードの [プロジェクト情報] セクションに表示されます。
- CATALOG_NAME と NAMESPACE: Iceberg テーブルを識別するための Iceberg カタログ名と名前空間の組み合わせ(
catalog.namespace.table_name)。 - LOCATION: サポートされている BigQuery のロケーション。デフォルトのロケーションは「US」です。
- BUCKET と WAREHOUSE_DIRECTORY: Iceberg ウェアハウスのディレクトリとして使用する Cloud Storage バケットとフォルダ。
実行アイコンをクリックするか、
Shift-Enterキーを押してコードを実行します。ジョブが完了すると、「Spark Job Finished」というステータス メッセージが表示され、出力にテーブルの内容が表示されます。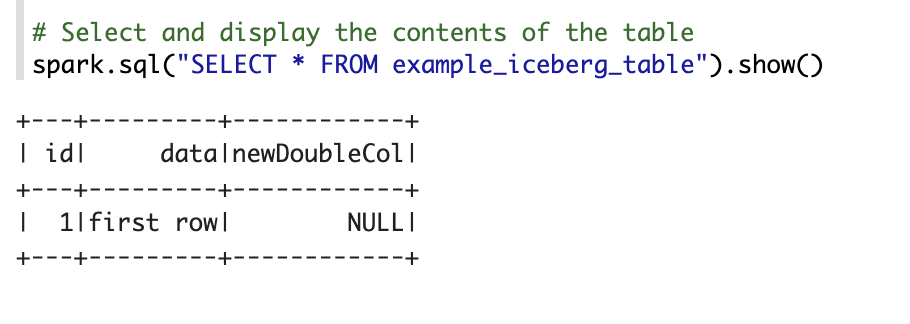
BigQuery でテーブルのメタデータを確認します。
Google Cloud コンソールで、[BigQuery] ページに移動します。
Iceberg テーブルのメタデータを確認します。