


בדף הזה מפורטות שיטות מומלצות לשימוש בפייפליין ב-Dataflow. השימוש בשיטות המומלצות האלה מניב את היתרונות הבאים:
- שיפור הנראות והביצועים של צינורות הנתונים
- שיפור הפרודוקטיביות של מפתחים
- שיפור היכולת לבדוק את צינור הנתונים
בדוגמאות הקוד של Apache Beam שבדף הזה נעשה שימוש ב-Java, אבל התוכן רלוונטי ל-Apache Beam Java, Python ו-Go SDKs.
שאלות שכדאי לחשוב עליהן
כשמעצבים את צינור המכירות, כדאי להתייחס לשאלות הבאות:
- איפה מאוחסנים נתוני הקלט של צינור הנתונים? כמה קבוצות של נתוני קלט יש לך?
- איך הנתונים שלכם נראים?
- מה רוצים לעשות עם הנתונים?
- לאן צריך להעביר את נתוני הפלט של צינור הנתונים?
- האם משימת Dataflow שלך משתמשת ב-Assured Workloads?
שימוש בתבניות
כדי לפתח צינור עיבוד נתונים מהר יותר, במקום לכתוב קוד של Apache Beam, כדאי להשתמש בתבנית Dataflow כשזה אפשרי. היתרונות של תבניות:
- אפשר לעשות שימוש חוזר בתבניות.
- תבניות מאפשרות לכם להתאים אישית כל משימה על ידי שינוי פרמטרים ספציפיים של צינורות.
- כל מי שתעניקו לו הרשאות יוכל להשתמש בתבנית כדי לפרוס את צינור הנתונים. לדוגמה, מפתח יכול ליצור משימה מתבנית, ומדען נתונים בארגון יכול לפרוס את התבנית הזו במועד מאוחר יותר.
אתם יכולים להשתמש בתבנית ש-Google סיפקה או ליצור תבנית משלכם. חלק מהתבניות ש-Google מספקת מאפשרות להוסיף לוגיקה בהתאמה אישית כשלב בצינור. לדוגמה, התבנית Pub/Sub to BigQuery מספקת פרמטר להפעלת פונקציה בהגדרת המשתמש (UDF) ב-JavaScript שמאוחסנת ב-Cloud Storage.
מכיוון שהתבניות ש-Google מספקת הן קוד פתוח ברישיון Apache 2.0, אתם יכולים להשתמש בהן כבסיס לצינורות חדשים. התבניות שימושיות גם כדוגמאות קוד. אפשר לראות את קוד התבנית במאגר GitHub.
Assured Workloads
בעזרת Assured Workloads אפשר לאכוף דרישות אבטחה ותאימות עבורGoogle Cloud לקוחות. לדוגמה, אזורים באיחוד האירופי ותמיכה עם אמצעי בקרה על ריבונות עוזרים לאכוף את ההבטחות לגבי מיקום אחסון הנתונים וריבונות הנתונים עבור לקוחות שממוקמים באיחוד האירופי. כדי לספק את התכונות האלה, חלק מהתכונות של Dataflow מוגבלות. אם אתם משתמשים ב-Assured Workloads עם Dataflow, כל המשאבים שהצינור ניגש אליהם צריכים להיות ממוקמים בפרויקט או בתיקייה של Assured Workloads בארגון שלכם. מקורות המידע האלה כוללים:
- קטגוריות של Cloud Storage
- מערכי נתונים ב-BigQuery
- נושאים ומינויים ב-Pub/Sub
- מערכי נתונים ב-Firestore
- מחברי קלט/פלט
ב-Dataflow, בכל העבודות של סטרימינג שנוצרו אחרי 7 במרץ 2024, כל נתוני המשתמשים מוצפנים באמצעות CMEK.
במשימות סטרימינג שנוצרו לפני 7 במרץ 2024, מפתחות הנתונים שמשמשים בפעולות מבוססות-מפתח, כמו חלוקה לחלונות, קיבוץ וצירוף, לא מוגנים על ידי הצפנת CMEK. כדי להפעיל את ההצפנה הזו לעבודות, צריך לנקז או לבטל את העבודה ואז להפעיל אותה מחדש. מידע נוסף זמין במאמר בנושא הצפנה של ארטיפקטים של מצב צינור הנתונים.
שיתוף נתונים בין צינורות
אין מנגנון ספציפי ל-Dataflow לתקשורת בין צינורות, לשיתוף נתונים או לעיבוד הקשר בין צינורות. אתם יכולים להשתמש באחסון עמיד כמו Cloud Storage או במטמון בזיכרון כמו App Engine כדי לשתף נתונים בין מופעים של צינורות.
תזמון משימות
אפשר להגדיר הפעלה אוטומטית של צינורות לעיבוד נתונים בדרכים הבאות:
- אפשר להשתמש בצינורות עיבוד נתונים ב-Dataflow כדי ליצור לוחות זמנים חוזרים לעבודות ולהבין איפה נעשה שימוש במשאבים במהלך ביצוע של כמה עבודות.
- להשתמש ב-Cloud Scheduler.
- משתמשים ב-Dataflow Operator של Apache Airflow, אחד מתוך כמה Google Cloud Operators בתהליך עבודה של Managed Service for Apache Airflow.
- להריץ תהליכים של משימות מותאמות אישית (cron) ב-Compute Engine.
שיטות מומלצות לכתיבת קוד של צינור עיבוד נתונים
בקטעים הבאים מפורטות שיטות מומלצות לשימוש כשיוצרים צינורות על ידי כתיבת קוד Apache Beam.
מבנה הקוד של Apache Beam
כדי ליצור צינורות, נהוג להשתמש בטרנספורמציה ParDo של Apache Beam לעיבוד מקבילי.
כשמחילים ParDo טרנספורמציה, מספקים קוד בצורה של אובייקט DoFn. DoFn היא מחלקה ב-Apache Beam SDK שמגדירה פונקציית עיבוד מבוזרת.
אפשר לחשוב על קוד DoFn כעל ישויות קטנות ועצמאיות: יכול להיות שיהיו הרבה מקרים שבהם הקוד יפעל במכונות שונות, וכל אחד מהם לא ידע על האחרים. לכן, מומלץ ליצור פונקציות טהורות, שהן אידיאליות לאופי המקביל והמבוזר של רכיבי DoFn.
לפונקציות טהורות יש את המאפיינים הבאים:
- פונקציות טהורות לא תלויות במצב מוסתר או חיצוני.
- אין להן תופעות לוואי שניתן לראות.
- הם דטרמיניסטיים.
מודל הפונקציה הטהורה לא קשיח לחלוטין. אם הקוד לא תלוי בדברים שלא מובטחים על ידי שירות Dataflow, יכול להיות שמידע על מצב או נתוני אתחול חיצוניים יהיו תקפים עבור DoFn ואובייקטים אחרים של פונקציות.
כשמבנים את ParDo הטרנספורמציות ויוצרים את רכיבי DoFn, כדאי לפעול לפי ההנחיות הבאות:
- כשמשתמשים בעיבוד של כל רכיב בדיוק פעם אחת, שירות Dataflow מעבד כל רכיב בקלט
PCollectionבאמצעות מופעDoFnבדיוק פעם אחת. - שירות Dataflow לא מבטיח כמה פעמים מופעלת הפונקציה
DoFn. - שירות Dataflow לא מבטיח בדיוק איך הרכיבים המבוזרים מקובצים. היא לא מבטיחה אילו רכיבים יעברו עיבוד ביחד, אם בכלל.
- שירות Dataflow לא מבטיח את המספר המדויק של מופעי
DoFnשנוצרו במהלך צינור נתונים. - שירות Dataflow עמיד בכשלים, ויכול להיות שהוא ינסה להריץ את הקוד שלכם כמה פעמים אם ה-workers ייתקלו בבעיות.
- יכול להיות ששירות Dataflow ייצור עותקים לגיבוי של הקוד שלכם. יכולות להיות בעיות עם תופעות לוואי ידניות, למשל אם הקוד מסתמך על קבצים זמניים עם שמות לא ייחודיים או יוצר קבצים כאלה.
- שירות Dataflow מבצע סריאליזציה של עיבוד רכיבים לכל מופע
DoFn. הקוד לא צריך להיות בטוח לשימוש בריבוי תהליכים, אבל כל מצב שמשותף בין כמה מופעים שלDoFnחייב להיות בטוח לשימוש בריבוי תהליכים.
יצירת ספריות של טרנספורמציות לשימוש חוזר
מודל התכנות של Apache Beam מאפשר לכם לעשות שימוש חוזר בטרנספורמציות. כשיוצרים ספרייה משותפת של טרנספורמציות נפוצות, אפשר לשפר את האפשרות לשימוש חוזר, את יכולת הבדיקה ואת הבעלות על הקוד של צוותים שונים.
כדאי לעיין בשתי דוגמאות הקוד הבאות ב-Java, ששתיהן קוראות אירועי תשלום. בהנחה ששני צינורות העיבוד מבצעים את אותו עיבוד, הם יכולים להשתמש באותם טרנספורמציות דרך ספרייה משותפת לשלבי העיבוד שנותרו.
הדוגמה הראשונה היא ממקור Pub/Sub לא מוגבל:
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options)

// Initial read transform
PCollection<PaymentEvent> payments =
    p.apply("Read from topic",
        PubSubIO.readStrings().withTimestampAttribute(...).fromTopic(...))
        .apply("Parse strings into payment events",
            ParDo.of(new ParsePaymentEventFn()));
הדוגמה השנייה היא ממקור של מסד נתונים רלציוני מוגבל:
PipelineOptions options = PipelineOptionsFactory.create();

Pipeline p = Pipeline.create(options);

PCollection<PaymentEvent> payments =
    p.apply(
        "Read from database table",
        JdbcIO.<PaymentEvent>read()
            .withDataSourceConfiguration(...)
            .withQuery(...)
            .withRowMapper(new RowMapper<PaymentEvent>() {
              ...
            }));
הדרך שבה מטמיעים שיטות מומלצות לשימוש חוזר בקוד משתנה בהתאם לשפת התכנות ולכלי הבנייה. לדוגמה, אם משתמשים ב-Maven, אפשר להפריד את קוד הטרנספורמציה למודול משלו. אחר כך אפשר לכלול את המודול כמודול משנה בפרויקטים גדולים עם כמה מודולים עבור צינורות שונים, כמו בדוגמה הבאה של קוד:
// Reuse transforms across both pipelines
payments
    .apply("ValidatePayments", new PaymentTransforms.ValidatePayments(...))
    .apply("ProcessPayments", new PaymentTransforms.ProcessPayments(...))
  ...
מידע נוסף זמין בדפי התיעוד הבאים של Apache Beam:
- דרישות לכתיבת קוד משתמש להמרות של Apache Beam
PTransformמדריך סגנון: מדריך סגנון לכותבים שלPTransformקולקציות חדשות לשימוש חוזר
שימוש בתורים של הודעות שלא ניתן להעביר לטיפול בשגיאות
לפעמים צינור העיבוד לא יכול לעבד רכיבים. בעיות בנתונים הן סיבה נפוצה. לדוגמה, רכיב שמכיל JSON בפורמט שגוי עלול לגרום לכשלים בניתוח.
אפשר לזהות חריגים בשיטה
DoFn.ProcessElement, לרשום את השגיאה ביומן ולהסיר את הרכיב, אבל בגישה הזו הנתונים אובדים ולא ניתן לבדוק אותם מאוחר יותר כדי לטפל בהם באופן ידני או לפתור בעיות.
במקום זאת, משתמשים בתבנית שנקראת תור הודעות שלא עברו עיבוד.
מזהים חריגים בשיטה DoFn.ProcessElement ומתעדים שגיאות. במקום להשמיט את הרכיב שנכשל, אפשר להשתמש בפלט מסועף כדי לכתוב את הרכיבים שנכשלו לאובייקט PCollection נפרד. הרכיבים האלה נכתבים ל-data sink לצורך בדיקה וטיפול בהמשך באמצעות טרנספורמציה נפרדת.
בדוגמה הבאה של קוד Java אפשר לראות איך מטמיעים את התבנית של תור הודעות שלא נקלטו.
TupleTag<Output> successTag = new TupleTag<>() {};
TupleTag<Input> deadLetterTag = new TupleTag<>() {};

PCollection<Input> input = /* ... */;

PCollectionTuple outputTuple =
    input.apply(ParDo.of(new DoFn<Input, Output>() {
      @Override
      void processElement(ProcessContext c) {
        try {
          c.output(process(c.element()));
        } catch (Exception e) {
          LOG.severe("Failed to process input {} -- adding to dead-letter file",
              c.element(), e);
          c.sideOutput(deadLetterTag, c.element());
        }
      }).withOutputTags(successTag, TupleTagList.of(deadLetterTag)));

// Write the dead-letter inputs to a BigQuery table for later analysis
outputTuple.get(deadLetterTag)
    .apply(BigQueryIO.write(...));

// Retrieve the successful elements...
PCollection<Output> success = outputTuple.get(successTag);
// and continue processing ...
משתמשים ב-Cloud Monitoring כדי להחיל מדיניות שונה של מעקב והתראות על תור ההודעות המתות של צינור הנתונים. לדוגמה, אפשר להציג באופן חזותי את המספר והגודל של הרכיבים שעברו עיבוד על ידי טרנספורמציית ההודעות שלא נמסרו, ולהגדיר התראות שיופעלו אם מתקיימים תנאי סף מסוימים.
טיפול במוטציות של סכימה
כדי לטפל בנתונים עם סכימות לא צפויות אבל תקינות, אפשר להשתמש בדפוס של הודעות שלא נמסרו (dead-letter), שכותב רכיבים שנכשלו לאובייקט PCollection נפרד.
במקרים מסוימים, יכול להיות שתרצו לטפל אוטומטית באלמנטים שמשקפים סכימה שעברה מוטציה כאלמנטים תקינים. לדוגמה, אם הסכימה של רכיב משקפת מוטציה כמו הוספה של שדות חדשים, אפשר להתאים את הסכימה של data sink כדי להתאים למוטציות.
שינוי סכימה אוטומטי מתבסס על גישת הפלט של הסתעפות שמשמשת בתבנית של הודעות שלא נמסרו. עם זאת, במקרה הזה, הוא מפעיל טרנספורמציה שמשנה את סכימת היעד בכל פעם שנתקלים בסכימות מצטברות. דוגמה לגישה הזו מופיעה במאמר How to handle mutating JSON schemas in a streaming pipeline, with Square Enix בבלוג Google Cloud .
החלטה איך לצרף מערכי נתונים
איחוד של מערכי נתונים הוא תרחיש נפוץ לשימוש בצינורות נתונים. אתם יכולים להשתמש ב-side inputs או בטרנספורמציה CoGroupByKey כדי לבצע פעולות join בצינור.
לכל אחת מהן יש יתרונות וחסרונות.
קלט צדדי
מספק דרך גמישה לפתרון בעיות נפוצות בעיבוד נתונים, כמו העשרת נתונים וחיפושים לפי מפתח. בניגוד לאובייקטים של PCollection, קלט צדדי ניתן לשינוי ואפשר לקבוע אותו בזמן הריצה. לדוגמה, יכול להיות שהערכים בקלט צדדי מחושבים על ידי ענף אחר בצינור או נקבעים על ידי קריאה לשירות מרוחק.
Dataflow תומך בקלט צדדי על ידי שמירת נתונים באחסון מתמיד, בדומה לדיסק משותף. ההגדרה הזו מאפשרת לכל העובדים לגשת לכל הקלט הצדדי.
עם זאת, גדלי הקלט הצדדי יכולים להיות גדולים מאוד, ויכול להיות שהם לא יתאימו לזיכרון של העובד. קריאה מנתוני קלט צדדיים גדולים עלולה לגרום לבעיות בביצועים אם העובדים צריכים לקרוא כל הזמן מאחסון קבוע.
הטרנספורמציה CoGroupByKey היא טרנספורמציה מרכזית של Apache Beam שממזגת (משטחת) כמה אובייקטים מסוג PCollection ומקבצת רכיבים עם מפתח משותף. בניגוד לקלט צדדי, שבו כל נתוני הקלט הצדדי זמינים לכל עובד, CoGroupByKey מבצע פעולת ערבוב (קיבוץ) כדי לחלק את הנתונים בין העובדים. לכן, CoGroupByKey הוא אידיאלי כשPCollection האובייקטים שרוצים לצרף גדולים מאוד ולא נכנסים לזיכרון של העובד.
ההנחיות הבאות יעזרו לכם להחליט אם להשתמש בקלט צדדי או ב-CoGroupByKey:
- כדאי להשתמש בקלט צדדי אם אחד מאובייקטי
PCollectionשאתם מצטרפים אליהם קטן באופן לא פרופורציונלי ביחס לאחרים, ואובייקטPCollectionהקטן נכנס לזיכרון של העובד. הוספת כל קלט הצד למטמון בזיכרון מאפשרת שליפה מהירה ויעילה של רכיבים. - משתמשים בקלט צדדי אם יש אובייקט
PCollectionשצריך לבצע בו הצטרפות כמה פעמים בצינור. במקום להשתמש בכמה טרנספורמציותCoGroupByKey, יוצרים קלט צדדי יחיד שאפשר לעשות בו שימוש חוזר בכמה טרנספורמציותParDo. - משתמשים ב-
CoGroupByKeyאם צריך לאחזר חלק גדול מאובייקטPCollectionשגדול משמעותית מזיכרון העובד.
מידע נוסף זמין במאמר פתרון בעיות שקשורות לשגיאות אין זיכרון פנוי (OOM) ב-Dataflow.
צמצום פעולות יקרות לכל רכיב
מופע של DoFn מעבד קבוצות של רכיבים שנקראות חבילות. חבילות הן יחידות עבודה אטומיות שמורכבות מאפס רכיבים או יותר. לאחר מכן, כל אחד מהרכיבים עובר עיבוד באמצעות השיטה
DoFn.ProcessElement, שמופעלת עבור כל רכיב. השיטה DoFn.ProcessElement נקראת לכל רכיב, ולכן כל פעולה שגוזלת זמן או משאבי מחשוב שמופעלת על ידי השיטה הזו מופעלת לכל רכיב שעובר עיבוד על ידי השיטה.
אם אתם צריכים לבצע פעולות יקרות רק פעם אחת עבור קבוצה של רכיבים, כדאי לכלול את הפעולות האלה בשיטה DoFn.Setup או בשיטה DoFn.StartBundle במקום ברכיב DoFn.ProcessElement. לדוגמה, הפעולות הבאות:
ניתוח קובץ תצורה ששולט בהיבט מסוים של התנהגות
DoFnהמופע. צריך להפעיל את הפעולה הזו רק פעם אחת, כשמופעDoFnמאותחל, באמצעות השיטהDoFn.Setup.יצירת מופע של לקוח לזמן קצר שנעשה בו שימוש חוזר בכל הרכיבים בחבילה, למשל כשכל הרכיבים בחבילה נשלחים דרך חיבור רשת יחיד. מפעילים את הפעולה הזו פעם אחת לכל חבילה באמצעות השיטה
DoFn.StartBundle.
הגבלת גודל האצווה והקריאות בו-זמנית לשירותים חיצוניים
כשמתקשרים לשירותים חיצוניים, אפשר לצמצם את התקורה לכל שיחה באמצעות טרנספורמציית GroupIntoBatches. הטרנספורמציה הזו יוצרת אצוות של רכיבים בגודל שצוין.
העברת נתונים בקבוצות שולחת רכיבים לשירות חיצוני כמטען ייעודי (payload) אחד במקום בנפרד.
בנוסף לאיחוד נתונים, מגבילים את המספר המקסימלי של קריאות מקבילות (בו-זמניות) לשירות החיצוני על ידי בחירת מפתחות מתאימים לחלוקת הנתונים הנכנסים. מספר המחיצות קובע את רמת ההקבלה המקסימלית. לדוגמה, אם לכל רכיב מוקצה אותו מפתח, טרנספורמציה במורד הזרם לקריאה לשירות החיצוני לא פועלת במקביל.
אפשר להשתמש באחת מהגישות הבאות כדי ליצור מפתחות לרכיבים:
- בוחרים מאפיין של מערך הנתונים לשימוש כמפתחות נתונים, כמו מזהי משתמשים.
- יוצרים מפתחות נתונים כדי לפצל רכיבים באופן אקראי על פני מספר קבוע של מחיצות, כאשר מספר ערכי המפתח האפשריים קובע את מספר המחיצות. צריך ליצור מספיק מחיצות כדי להפעיל מקביליות.
בכל מחיצה צריכים להיות מספיק אלמנטים כדי שהטרנספורמציה
GroupIntoBatchesתהיה שימושית.
בדוגמה הבאה של קוד Java אפשר לראות איך לפצל באופן אקראי רכיבים על פני עשרה מחיצות:
// PII or classified data which needs redaction.
PCollection<String> sensitiveData = ...;

int numPartitions = 10; // Number of parallel batches to create.
PCollection<KV<Long, Iterable<String>>> batchedData =
    sensitiveData
        .apply("Assign data into partitions",
            ParDo.of(new DoFn<String, KV<Long, String>>() {
              Random random = new Random();

              @ProcessElement
              public void assignRandomPartition(ProcessContext context) {
                context.output(
                  KV.of(randomPartitionNumber(), context.element()));
              }
              private static int randomPartitionNumber() {
                return random.nextInt(numPartitions);
              }
            }))
        .apply("Create batches of sensitive data",
            GroupIntoBatches.<Long, String>ofSize(100L));

// Use batched sensitive data to fully utilize Redaction API,
// which has a rate limit but allows large payloads.
batchedData
    .apply("Call Redaction API in batches", callRedactionApiOnBatch());
עיבוד מקביל של פעולות איטיות לכל רכיב
כש-DoFn מבצע פעולות איטיות לכל רכיב (כמו קריאה למודל חיצוני של למידת מכונה או ל-API של אינטרנט), ביצוע סינכרוני בתוך DoFn.ProcessElement חוסם את ה-threads של העובדים עד שכל פעולה מסתיימת.
החסימה הזו מגבילה את קצב העברת הנתונים ויכולה לגרום לפסק זמן בחבילות או לשיעורי ניסיון חוזרים גבוהים.
גם עם חלוקה למחיצות (partitioning) אופטימלית של המפתחות, סריאליזציה לכל מפתח מבטיחה שרק רכיב אחד יעובד בכל פעם לכל מפתח. עם זאת, אם עוטפים את המחלקה DoFn באמצעות AsyncWrapper, ההגבלה הזו לא תקפה כי הרכיבים מעובדים במקביל במאגר שרשורים ברקע, והשליטה מוחזרת למפעיל הראשי לפני שהעיבוד מסתיים. באמצעות מצב וטיימרים של Beam, AsyncWrapper
מתבצע עיבוד של כל נתון בדיוק פעם אחת.
כשמעצבים צינור נתונים שמשתמש ב-AsyncWrapper, חשוב לפעול לפי ההנחיות הבאות:
- חלוקת הנתונים הנכנסים באמצעות מפתחות:
AsyncWrapperנדרש קלט של צמד מפתח/ערךKV<K, InputT>. כדי לחלק את העבודה בין כמה workers ולמנוע צווארי בקבוק של סריאליזציה, צריך לחלק את קבוצת הנתונים הנכנסת למספר מתאים של מפתחות נפרדים. - הגבלת מספר הפעולות המקבילות של העובד: משתמשים בפרמטר
parallelismכדי להגדיר את המספר המקסימלי של פעולות מקבילות שמותרות לכל צומת עובד. - הבטחת בטיחות השרשור: אם מגדירים את
parallelismכערך גדול מ-1 ו-DoFnהוא בעל מצב, גםDoFnחייב להיות בטוח לשימוש בשרשור. - אל תשתמשו באגרגציה ברמת החבילה: אל תשתמשו בלוגיקה של אצווה או אגרגציה בתוך
StartBundleאוFinishBundle, כיAsyncWrapperמפעיל את שיטות מחזור החיים האלה לכל רכיב. - לא להשתמש בפלטים מתויגים: אין תמיכה בפלטים מרובים מתויגים (תגי פלט נוספים).
- התאמת הביצוע (Java): כברירת מחדל, המשימות מבוצעות ב-JVM המשותף
ForkJoinPool. מגדירים אתuseThreadPool=trueכדי לבודד את ההרצה למאגר קבוע של שרשורים ייעודיים בגודל שמותאם למידת המקביליות שהגדרתם. הגישה הזו מונעת התנגשות עם צרכניForkJoinPoolאחרים באותו JVM. - התאמת הביצוע (Python): ב-Python SDK,
AsyncWrapperתומך במצבuse_asyncio=Trueנוסף שמבצע קורוטינות בתוך לולאת אירועיםasyncioבמקום במאגר שרשורים ברקע.
בדוגמאות הקוד הבאות ב-Java אפשר לראות איך עוטפים DoFn באמצעות AsyncWrapper:
import org.apache.beam.sdk.transforms.AsyncWrapper;
import org.apache.beam.sdk.transforms.DoFn;
import org.apache.beam.sdk.transforms.ParDo;
import org.apache.beam.sdk.transforms.WithKeys;
import org.apache.beam.sdk.values.KV;
import org.apache.beam.sdk.values.PCollection;
import org.joda.time.Duration;

// Define a synchronous DoFn that makes slow external service calls.
public class CallSlowExternalServiceFn extends DoFn<String, String> {
  private transient ExternalServiceClient externalServiceClient;

  @Setup
  public void setup() {
    externalServiceClient = new ExternalServiceClient();
  }

  @ProcessElement
  public void processElement(@Element String element, OutputReceiver<String> receiver) {
    String result = externalServiceClient.call(element);
    receiver.output(result);
  }
}

// Partition incoming data across distinct keys to distribute worker load.
PCollection<KV<String, String>> keyedData = inputData.apply(
    WithKeys.of(element -> element.substring(0, 1))); // or your actual partition key

// Wrap the DoFn with AsyncWrapper.
PCollection<String> results = keyedData.apply(
    "Process Asynchronously",
    ParDo.of(
        new AsyncWrapper<String, String, String>(
            new CallSlowExternalServiceFn(),
            /* parallelism= */ 20,
            /* timerFrequency= */ Duration.standardSeconds(5),
            /* maxItemsToBuffer= */ 50,
            /* timeout= */ Duration.standardSeconds(1),
            /* maxWaitTime= */ Duration.millis(500),
            /* idFn= */ null, // defaults to element identity for deduplication
            /* useThreadPool= */ true)));
זיהוי בעיות בביצועים שנגרמות משלבים מאוחדים
Dataflow יוצר תרשים של שלבים שמייצג את צינור עיבוד הנתונים שלכם על סמך ההמרות והנתונים ששימשו ליצירת הצינור. התרשים הזה נקרא תרשים של הפעלת צינור עיבוד הנתונים.
כשפורסים את צינור הנתונים, יכול להיות ש-Dataflow ישנה את גרף הביצוע של צינור הנתונים כדי לשפר את הביצועים. לדוגמה, יכול להיות ש-Dataflow ימזג כמה פעולות יחד בתהליך שנקרא אופטימיזציה של מיזוג, כדי למנוע את ההשפעה על הביצועים והעלות של כתיבת כל אובייקט PCollection ביניים בפייפליין.
במקרים מסוימים, יכול להיות ש-Dataflow יקבע בצורה שגויה את הדרך האופטימלית לאחד פעולות בצינור, מה שיגביל את היכולת של העבודה להשתמש בכל העובדים הזמינים. במקרים כאלה, אפשר למנוע את המיזוג של הפעולות.
הנה דוגמה לקוד Apache Beam. טרנספורמציה מסוג GenerateSequence יוצרת אובייקט קטן מוגבל מסוג PCollection, שעובר עיבוד נוסף על ידי שתי טרנספורמציות מסוג ParDo בהמשך השרשרת.
ההתמרה Find Primes Less-than-N עשויה להיות יקרה מבחינת משאבי מחשוב, וסביר להניח שהיא תפעל לאט עבור מספרים גדולים. לעומת זאת, סביר להניח שהטרנספורמציה Increment Number תושלם במהירות.
import com.google.common.math.LongMath;
...

public class FusedStepsPipeline {

  final class FindLowerPrimesFn extends DoFn<Long, String> {
    @ProcessElement
    public void processElement(ProcessContext c) {
      Long n = c.element();
      if (n > 1) {
        for (long i = 2; i < n; i++) {
          if (LongMath.isPrime(i)) {
            c.output(Long.toString(i));
          }
        }
      }
    }
  }

  public static void main(String[] args) {
    Pipeline p = Pipeline.create(options);

    PCollection<Long> sequence = p.apply("Generate Sequence",
        GenerateSequence
            .from(0)
            .to(1000000));

    // Pipeline branch 1
    sequence.apply("Find Primes Less-than-N",
        ParDo.of(new FindLowerPrimesFn()));

    // Pipeline branch 2
    sequence.apply("Increment Number",
        MapElements.via(new SimpleFunction<Long, Long>() {
          public Long apply(Long n) {
            return ++n;
          }
        }));

    p.run().waitUntilFinish();
  }
}
בתרשים הבא מוצגת ייצוג גרפי של צינור העיבוד בממשק המעקב של Dataflow.
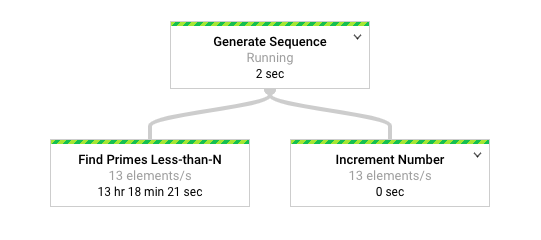
ממשק המעקב של Dataflow מראה שקצב העיבוד האיטי זהה בשני הטרנספורמציות, כלומר 13 רכיבים לשנייה. אפשר לצפות שהטרנספורמציה Increment Number תעבד את הרכיבים במהירות, אבל נראה שהיא קשורה לאותו קצב עיבוד כמו Find Primes Less-than-N.
הסיבה לכך היא ש-Dataflow מיזג את השלבים לשלב אחד, ולכן הם לא יכולים לפעול בנפרד. אפשר להשתמש בפקודה gcloud dataflow jobs describe כדי למצוא מידע נוסף:
gcloud dataflow jobs describe --full job-id --format json
בפלט שמתקבל, השלבים הממוזגים מתוארים באובייקט ExecutionStageSummary במערך ComponentTransform:
...

    "executionPipelineStage": [
      {
        "componentSource": [
          ...
        ],
        "componentTransform": [
          {
            "name": "s1",
            "originalTransform": "Generate Sequence/Read(BoundedCountingSource)",
            "userName": "Generate Sequence/Read(BoundedCountingSource)"
          },
          {
            "name": "s2",
            "originalTransform": "Find Primes Less-than-N",
            "userName": "Find Primes Less-than-N"
          },
          {
            "name": "s3",
            "originalTransform": "Increment Number/Map",
            "userName": "Increment Number/Map"
          }
        ],
        "id": "S01",
        "kind": "PAR_DO_KIND",
        "name": "F0"
      }

...
בתרחיש הזה, מכיוון שהטרנספורמציה Find Primes Less-than-N היא השלב האיטי, אסטרטגיה מתאימה היא להפסיק את המיזוג לפני השלב הזה. שיטה אחת לביטול המיזוג של השלבים היא להוסיף טרנספורמציה GroupByKey ולבטל את הקיבוץ לפני השלב, כמו שמוצג בדוגמה הבאה של קוד Java.
sequence
    .apply("Map Elements", MapElements.via(new SimpleFunction<Long, KV<Long, Void>>() {
      public KV<Long, Void> apply(Long n) {
        return KV.of(n, null);
      }
    }))
    .apply("Group By Key", GroupByKey.<Long, Void>create())
    .apply("Emit Keys", Keys.<Long>create())
    .apply("Find Primes Less-than-N", ParDo.of(new FindLowerPrimesFn()));
אפשר גם לשלב את השלבים האלה של ביטול המיזוג להמרה מורכבת שאפשר לעשות בה שימוש חוזר.
אחרי שמבטלים את המיזוג של השלבים, כשמריצים את צינור הנתונים, השלב Increment Number מסתיים תוך שניות, והטרנספורמציה Find Primes Less-than-N, שפועלת הרבה יותר זמן, מורצת בשלב נפרד.
בדוגמה הזו מבוצעת פעולת קיבוץ וביטול קיבוץ על שלבים לא מאוחדים.
אפשר להשתמש בגישות אחרות בנסיבות אחרות. במקרה כזה, הטיפול בפלט כפול לא מהווה בעיה, בהתחשב בפלט הרציף של טרנספורמציית GenerateSequence.
KV
המערכת מבטלת כפילויות של אובייקטים עם מפתחות כפולים למפתח יחיד בקבוצה
בטרנספורמציה (GroupByKey) של ungroup
ובטרנספורמציה (Keys) של ungroup. כדי לשמור על כפילויות אחרי פעולות של קיבוץ וביטול קיבוץ, צריך ליצור צמדי מפתח/ערך באמצעות השלבים הבאים:
- שימוש במפתח אקראי ובקלט המקורי כערך.
- קיבוץ באמצעות מפתח אקראי.
- הפלט הוא הערכים של כל מפתח.
אפשר גם להשתמש בטרנספורמציה Reshuffle כדי למנוע מיזוג של טרנספורמציות סמוכות. עם זאת, תופעות הלוואי של טרנספורמציית Reshuffle לא ניתנות להעברה בין מפעילים שונים של Apache Beam.
מידע נוסף על אופטימיזציה של מקביליות ומיזוג זמין במאמר בנושא מחזור החיים של צינורות.
שימוש במדדים של Apache Beam כדי לאסוף תובנות לגבי צינור עיבוד הנתונים
מדדים של Apache Beam הם מחלקה של כלי עזר שמפיקה מדדים לדיווח על המאפיינים של צינור עיבוד נתונים שפועל. כשמשתמשים ב-Cloud Monitoring, מדדי Apache Beam זמינים כמדדים מותאמים אישית של Cloud Monitoring.
בדוגמה הבאה מוצגים מדדים של Apache Beam Counterשמשמשים במחלקת משנה של DoFn.
בדוגמה של הקוד נעשה שימוש בשני מוניטורים. מונה אחד עוקב אחרי כשלים בניתוח JSON (malformedCounter), והמונה השני עוקב אחרי הודעות JSON תקינות שמכילות מטען ייעודי (payload) ריק (emptyCounter). ב-Cloud Monitoring, השמות של המדדים המותאמים אישית הם custom.googleapis.com/dataflow/malformedJson ו-custom.googleapis.com/dataflow/emptyPayload. אפשר להשתמש במדדים המותאמים אישית כדי ליצור ויזואליזציות ומדיניות התראות ב-Cloud Monitoring.
final TupleTag<String> errorTag = new TupleTag<String>(){};
final TupleTag<MockObject> successTag = new TupleTag<MockObject>(){};

final class ParseEventFn extends DoFn<String, MyObject> {

  private final Counter malformedCounter = Metrics.counter(ParseEventFn.class, "malformedJson");
  private final Counter emptyCounter = Metrics.counter(ParseEventFn.class, "emptyPayload");
  private Gson gsonParser;

  @Setup
  public setup() {
    gsonParser = new Gson();
  }

  @ProcessElement
  public void processElement(ProcessContext c) {
    try {
      MyObject myObj = gsonParser.fromJson(c.element(), MyObject.class);
      if (myObj.getPayload() != null) {
        //  Output the element if non-empty payload
        c.output(successTag, myObj);
      }
      else {
        // Increment empty payload counter
        emptyCounter.inc();
      }
    }
    catch (JsonParseException e) {
      // Increment malformed JSON counter
      malformedCounter.inc();
      // Output the element to dead-letter queue
      c.output(errorTag, c.element());
    }
  }
}
אבטחת קטגוריות של Cloud Storage מפני התקפות על צינורות
כדי לאבטח קטגוריות של Cloud Storage מפני מתקפה על צינור Dataflow, צריך להבין איך פשרה יכולה לקרות.
תוקף בדרך כלל לא יתמקד ישירות ב-Cloud Storage. במקום זאת, הם מנצלים פגיעות שנקראת הרעלת משאבי צל. בתרחיש הזה, תוקף חודר לקטגוריה של Cloud Storage שמכילה תבניות Dataflow, מטא נתונים או פונקציות בהגדרת המשתמש (UDF) ב-Python, כדי להחדיר קוד זדוני. כש-Dataflow משנה את קנה המידה באופן אוטומטי ומתחיל מכונת VM חדשה של Worker, הוא שולף את הקוד שנפרץ מ-Cloud Storage, מפעיל אותו, גונב את אסימון חשבון השירות של ה-Worker ומחלץ נתונים מקטגוריות המקור שלכם.
כדי למנוע את נקודת הכניסה הזו להתקפה, צריך לנעול את הקטגוריות של Cloud Storage שמהן מתקבלים הנתונים ל-Dataflow, לאבטח את צינורות הנתונים עצמם ולהגביל באופן משמעותי את ההרשאות בקטגוריות של Cloud Storage.
הגנה על קטגוריות של Cloud Storage
כדי להגן על נקודת ההחדרה, צריך לאבטח את דלי ה-Storage שמשמשים לתבניות Dataflow, לקבצים זמניים ולתלות בקוד. הטמעה של אמצעי בקרה מחמירים על גישת כתיבה לקטגוריות האלה מונעת מקוד לא מורשה להיכנס לסביבת העובד.
- מבודדים את הדליים: מפרידים בין דליים של נתונים לבין דליים של קוד תפעולי. Dataflow משתמש בדגלים
--stagingLocationו---tempLocation. חשוב לשמור את הנתונים האלה בדלי ייעודי עם גישה מוגבלת מאוד, בנפרד לגמרי מנתוני הקלט או הפלט הגולמיים. - אכיפת גישה אחידה ברמת הקטגוריה (UBLA): הפעלת UBLA בכל הקטגוריות שקשורות ל-Dataflow. ההגדרה הזו משביתה רשימות של בקרת גישה (ACL) מדור קודם שנוטות לשגיאות, ומבטיחה שרק כללי מדיניות מרכזיים של ניהול זהויות והרשאות גישה (IAM) יקבעו למי יש גישה לקבצים.
- הגבלת הרשאות כתיבה: נותנים לחשבון השירות של CI/CD את ההרשאה
roles/storage.objectAdmin(כתיבה/מחיקה) בקטגוריות של הטמפלטים ושל הסביבה הזמנית. מעניקים למפתחים ולחשבונות שירות אחרים הרשאתroles/storage.objectViewer(קריאה בלבד) לכל היותר. - הפעלה של ניהול גרסאות של אובייקטים ושמירת אובייקטים: מפעילים ניהול גרסאות של אובייקטים בקטגוריות של התבניות. אם גורם זדוני או חשבון שנפרץ מחליפים תבנית, אתם יכולים לקבל באופן מיידי התראה על הגרסה החדשה ולבטל את השינויים. בשילוב עם מדיניות שמירת אובייקטים, זה עוזר למנוע מגורמים זדוניים למחוק את התלויות שלכם בסביבת הפיתוח.
חיזוק סביבת ההפעלה של Dataflow
כדי לשמור על סביבת ביצוע מאובטחת ולהגן מפני גניבת נתונים, צריך להגביל את התקשורת בין העובדים.
- חסימת תעבורת נתונים יוצאת (egress) מהאינטרנט (רשת פרטית בלבד): כשמפעילים את Dataflow, מעבירים את
--usePublicIps=false. בנוסף, צריך להגדיר את כללי חומת האש של ה-VPC כך שיחסמו את כל תעבורת הנתונים היוצאת (egress) לרשת האינטרנט הציבורית מרשתות המשנה של Dataflow. אם יש פריצה לעובד, הוא לא יכול לפתוח reverse shell או לחלץ נתונים לכתובת IP חיצונית שנשלטת על ידי תוקף. - אכיפת VPC Service Controls (VPC-SC): מציבים את קטגוריות הנתונים (buckets) של Cloud Storage ואת פרויקט Dataflow בתוך מתחם אבטחה היקפית של VPC-SC. VPC-SC פועל כחומת רשת שמבטלת את הרשאות IAM. גם אם תוקף גונב טוקן תקף של חשבון שירות של Worker, VPC-SC חוסם כל בקשה להעתקת נתונים מהקטגוריה של Cloud Storage לקטגוריה מחוץ לגבולות גזרה של הארגון.
הטמעה של הרשאות מינימליות מחמירות בקטגוריות של נתונים
אם יש פגיעה בעובד Dataflow, האזור המושפע מוגדר על ידי הרשאות ה-IAM של חשבון השירות שלו.
- לא מומלץ להשתמש בחשבון השירות שמוגדר כברירת מחדל ב-Compute Engine: כברירת מחדל, לחשבון הזה יש הרשאות עריכה רחבות על כל הפרויקט. משתמשים בחשבון שירות ייעודי של עובד (worker) שמנוהל על ידי משתמש באמצעות הדגל
--serviceAccount. - תפקידי IAM ספציפיים לדלי: אל תקצו לחשבון השירות של העובד ב-Dataflow תפקידי אחסון ברמת הפרויקט, כמו
roles/storage.admin. במקום זאת, מעניקים הרשאות ישירות לדליים הספציפיים:- קטגוריית קלט: הקצאת התפקיד
roles/storage.objectViewer(קריאה בלבד). - קטגוריית פלט: צריך להעניק את התפקיד
roles/storage.objectCreator(הרשאת כתיבה בלבד, כלומר אפשר ליצור אובייקטים אבל אי אפשר לקרוא או לשכתב נתונים קיימים). - קטגוריית ביניים/זמנית: צריך להעניק את התפקידים
roles/storage.objectAdmin(קריאה, כתיבה ומחיקה).
- קטגוריית קלט: הקצאת התפקיד
אבטחת קונטיינרים בהתאמה אישית ושרשרת אספקת התוכנה
אם אתם משתמשים בקובצי אימג' מותאמים אישית של Docker לתלות של Dataflow באמצעות --sdkContainerImage, תוקף עשוי לנסות להרעיל את מאגר קובצי האימג' במקום קטגוריה של Cloud Storage.
- סריקת Artifact Registry: אחסון תמונות של עובדים בהתאמה אישית ב-Artifact Registry והפעלת סריקת נקודות חולשה.
שימוש בגיבובים (digests) של תמונות שלא ניתן לשנות: במקום להפנות לתמונה באמצעות תג שניתן לשינוי כמו
us-docker.pkg.dev/my-project/dataflow-worker:latest, מציינים באפשרויות של צינור הנתונים את הגיבוב הקריפטוגרפי המדויק של SHA שלא ניתן לשינוי:--sdkContainerImage=us-docker.pkg.dev/my-project/dataflow-worker@sha256:7b9c...`כך אפשר לוודא שהקוד המדויק שסרקתם ואישרתם ב-CI/CD הוא הקוד שמופעל ב-workers, ולחסום לחלוטין מתקפות של החלפת תמונות.
שימוש ברישום ביומן כדי לזהות אנומליות
הגדרות אבטחה עוזרות לעצור את המתקפה, אבל כדאי גם להגדיר התראות ב-Cloud Logging לגבי הטריגרים הבאים:
- אירועים בתבנית Dataflow או בקטגוריות זמניות ב-Cloud Storage שמקורם בזהות שאינה CI/CD, כמו בקשות
storage.objects.updateאוstorage.objects.create. - כמויות גדולות של בקשות
storage.objects.getמכתובות IP לא צפויות או עליות חדות לא רגילות בנפח הנתונים שעוברים דרך Dataflow, שעשויות להצביע על ניסיון פעיל להוצאת נתונים.
העברת צינור עיבוד נתונים בין פרויקטים של Google Cloud
משימות Dataflow קשורות לפרויקט ב- Google Cloud שבו הן נוצרו. אי אפשר להעביר משימה ישירות לפרויקט אחר. כדי להעביר צינור (pipeline) לפרויקט אחר, צריך לעצור את העבודה הקיימת וליצור אותה מחדש בפרויקט החדש. מדריך מפורט בנושא התהליך הזה זמין במאמר העברת משימות של צינורות עיבוד ל פרויקט Google Cloud אחר.
מידע נוסף
בדפים הבאים מוסבר איך לבנות את צינור הנתונים, איך לבחור אילו טרנספורמציות להחיל על הנתונים ומה צריך לקחת בחשבון כשבוחרים את שיטות הקלט והפלט של צינור הנתונים.
מידע נוסף על פיתוח קוד משתמש זמין במאמר בנושא דרישות לפונקציות שמשתמשים מספקים.