


בצינורות עיבוד נתונים מבוזרים של נתונים בזמן אמת, יכול להיות שיהיה לכם קשה לזהות אילו שלבים ספציפיים, קריאות לשירותים חיצוניים או ערבוב נתונים של עובדים גורמים לעליות פתאומיות בחביון, אם תשתמשו רק במדדים מצטברים. באמצעות מעקב מבוזר של OpenTelemetry ב-Dataflow, אפשר לעקוב אחרי רכיבים בודדים מקצה לקצה, בטרנספורמציות של צינורות, בגבולות רשת ובשירותים משולבים, באמצעות מזהה מעקב יחיד. התובנות האלה עוזרות לכם לזהות צווארי בקבוק בביצועים, לבצע אופטימיזציה של עלויות הביצוע של צינורות הנתונים ולפתור בעיות במשימות מורכבות של סטרימינג.
המידע הבא יעזור לכם להפעיל, להגדיר ולהשתמש במעקב מבוזר של OpenTelemetry בצינורות Apache Beam.
תרחישים לדוגמה
מעקב מבוזר ב-Dataflow שימושי במיוחד בתרחישים הבאים:
- עומסי עבודה של סטרימינג: אפשר לעקוב אחרי זמן העיבוד של כל רכיב ולזהות שלבים שגורמים להשהיה או לעליות חדות בזמן האחזור.
- מעקב אחר קריאות לשירותים חיצוניים בקוד המשתמש: מדידת משך הביצוע כשצינור הנתונים קורא למסדי נתונים חיצוניים, למיקרו-שירותים או לממשקי API של AI גנרטיבי בתוך קוד המשתמש (למשל ב-
DoFn). לדוגמה, אפשר למדוד את הזמן של קריאות למסדי נתונים חיצוניים (כמו Spanner או Bigtable), למיקרו-שירותים (באמצעות HTTP או gRPC) או לממשקי API של AI גנרטיבי (כמו Gemini). מידע נוסף זמין במאמרים בנושא כתיבת מעקבים בהתאמה אישית ב-DoFn ושילוב עם ספריות לקוח. - אופטימיזציה של העלויות והביצועים: חשיפת משכי הזמן של פעולות ספציפיות במופעי
PTransformתחת עומס בעולם האמיתי, כדי לזהות סדרות לא יעילות, שאילתות איטיות או התנגשות של תהליכי worker. - צינורות מורכבים של תהליכי עבודה וסוכנים: קבלת תצוגה של צינורות עם כמה ענפים, לולאות איטרטיביות של סוכנים וחיבורים כדי לקבוע איזה שינוי או ענף לוקח הכי הרבה זמן.
מגבלות
יש מגבלות על מעקב מבוזר ב-Dataflow:
- התכונה הזו מיועדת לצינורות סטרימינג בלבד.
- כדי להשתמש בתכונה הזו, צריך להשתמש ב-Beam SDK for Java (גרסה 2.76.0 ואילך).
- כדי להעביר הקשר בין שלבים צריך להשתמש ב-Streaming Java Runner (שנקרא בעבר Runner v1). הכלי Portable Runner (שנקרא בעבר Runner v2) מאפס את הקשר יומן המעקב בגבולות של מיון הנתונים (shuffle).
- המעקב המובנה של OpenTelemetry במחברי Beam I/O נתמך רק במחברים הבאים: Pub/Sub, Apache Kafka ו-Spanner סנכרון שינויים בזרמי נתונים. ב-Apache Kafka, מעקב נתמך רק כשמשתמשים ישירות במחבר
KafkaIO. האפשרות הזו לא נתמכת כשמשתמשים בקלט/פלט מנוהל ל-Kafka. למחברים אחרים של קלט/פלט (כמוBigtableIO) אין מעקב מובנה של מחברים. כדי לעקוב אחרי פעולות בשירותים האלה, צריך להגדיר את הקריאות בתוך קוד המשתמש (למשל ב-DoFn). - פעולות שמשלבות כמה רכיבים לאחד לא מעבירות הקשר יומן מעקב יחיד. הפעולות האלה כוללות את
GroupByKey,CoGroupByKeyו-Combine. - ההקשר לא מועבר בין הגדרת טיימר (
Timer.set()) לבין הביצוע של שיטת הקריאה החוזרת@OnTimer.
דרישות מוקדמות
כדי להשתמש במעקב מבוזר ב-Dataflow, צריך לוודא שהסביבה שלכם עומדת בדרישות הבאות:
- המשימה צריכה לעמוד בדרישות הבאות:
- זה צינור עיבוד נתונים בסטרימינג
- נעשה שימוש ב-Streaming Java Runner (לשעבר Runner v1)
- משתמש ב-Apache Beam Java SDK בגרסה 2.76.0 ומעלה
אם מייצאים נתוני מעקב ל-Cloud Trace, צריך להפעיל את Telemetry API (
telemetry.googleapis.com) בפרויקט Google Cloud .תפקידים שנדרשים להפעלת ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד 'בעלים' (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד 'אדמין בממשק Service Usage' (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידיםלחשבון השירות של העובד צריך להיות התפקיד Cloud Trace Agent (
roles/cloudtrace.agent), שכולל את ההרשאהcloudtrace.traces.patch.
מושגי ליבה
התכונה 'מעקב מבוזר' מסתמכת על המושגים הבאים של OpenTelemetry:
- מעקב
- ייצוג של עסקה או תהליך עבודה מלאים, כפי שהם מתבצעים במערכת מבוזרת. trace מורכב מspans אחד או יותר.
- Span
- אבן הבניין הבסיסית של trace, שמייצגת יחידת עבודה אחת. לדוגמה, הרצת טרנספורמציה, הפעלת method או בקשת RPC.
- הקשר
- המצב שמועבר בין השרשורים וגבולות ה-API. הנתונים כוללים את מזהה המעקב ומזהה הטווח.
- מפיץ
- המנגנון שמשמש להחדרת ייצוג הקשר ולחילוץ שלו בגבולות הרשת. לדוגמה, W3C Trace Context.
- יצואן
- רכיב ששולח את נתוני הטווח שנאספו אל עורף העקבות (tracing backend), כמו Cloud Trace או OpenTelemetry Collector שמתארח באופן עצמאי.
- סמפלר
- מנגנון ששולט בעוצמת הקול של המעקב על ידי קביעה אילו נתוני מעקב יתועדו ויוצאו. לדוגמה, תדירות דגימה של 1%.
הפעלת מעקב OpenTelemetry
כדי להפעיל מעקב OpenTelemetry עם הגדרות ברירת מחדל, צריך להגדיר את האפשרויות הנדרשות של צינור הנתונים ואת הניסויים כששולחים את העבודה. הגדרת ברירת המחדל היא ייצוא ל-Cloud Trace עם דגימה של 1%.
במאמר הגדרה ושינוי של מאפייני מעקב מוסבר איך משנים את ערכי ברירת המחדל.
מגדירים את האפשרויות של צינור עיבוד הנתונים ואת הניסויים כשמריצים את העבודה.
משימה בתבנית לא גמישה
מעבירים את ההתראות הבאות לגבי ניסויים כששולחים משימה:
--experiments=enable_otel_defaults,element_metadata_supported,disable_portable_worker
משימה של תבנית Flex
מעבירים את הניסויים באמצעות הדגל
--additional-experimentsבפקודהgcloud:gcloud dataflow flex-template run JOB_NAME \ --template-file-gcs-location=gs://BUCKET_NAME/templates/TEMPLATE_NAME.json \ --additional-experiments="enable_otel_defaults,element_metadata_supported,disable_portable_worker" \ --region=REGIONמחליפים את מה שכתוב בשדות הבאים:
- JOB_NAME: השם של משימת Dataflow.
- BUCKET_NAME: קטגוריה של Cloud Storage שמכילה את התבנית.
- TEMPLATE_NAME: השם של קובץ תבנית Flex.
- REGION: Google Cloud האזור שבו רוצים להריץ את העבודה.
הניסויים האלה מגדירים את ההתנהגויות הבאות:
-
enable_otel_defaults: הגדרת ברירות מחדל סטנדרטיות של OpenTelemetry, כולל כלי הייצוא של Cloud Trace ודגימה של 1%. -
element_metadata_supported: מאפשר סריאליזציה והפצה של מטא-נתונים (כמו הקשר יומן מעקב) בשלבים שונים של פייפליין. -
disable_portable_worker: כופה את השימוש ב-Dataflow Streaming Java Runner (שנקרא בעבר Runner v1).
אם אתם משתמשים ב-Beam SDK ל-Java בגרסאות 2.76.0 או 2.77.0, אתם צריכים להוסיף את יחסי התלות הנדרשים של OpenTelemetry להגדרת ה-build.
בגלל בעיה בגרסאות 2.76.0 ו-2.77.0, צריך להוסיף את התלויות הבאות לקובץ
pom.xmlכדי לייצא עקבות. מידע נוסף זמין במאמר בנושא ניהול יחסי תלות בצינורות.<dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-sdk-extension-autoconfigure</artifactId> <scope>compile</scope> </dependency> <dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-exporter-otlp</artifactId> <version>1.62.0</version> <scope>compile</scope> </dependency> <dependency> <groupId>org.apache.beam</groupId> <artifactId>beam-sdks-java-extensions-opentelemetry-gcp-auth-extension</artifactId> <scope>compile</scope> </dependency>מפעילים במפורש את מעקב OpenTelemetry במחברי קלט/פלט נתמכים בקוד של צינור הנתונים:
Pub/Sub
כדי להפעיל מעקב כשקוראים מ-Pub/Sub או כותבים ל-Pub/Sub:
// Reading from Pub/Sub
pipeline.apply("ReadFromPubSub",
    PubsubIO.readMessages()
        .withEnableOpenTelemetryTracing()
        .fromSubscription("projects/PROJECT_ID/subscriptions/SUBSCRIPTION_ID"));

// Writing to Pub/Sub
pipeline.apply("WriteToPubSub",
    PubsubIO.writeStrings()
        .withEnableOpenTelemetryTracing()
        .to("projects/PROJECT_ID/topics/TOPIC_ID"));
מחליפים את מה שכתוב בשדות הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Google Cloud .
- SUBSCRIPTION_ID: השם של המינוי ל-Pub/Sub.
- TOPIC_ID: השם של נושא ה-Pub/Sub.
פרטים על העברת ההקשר:
- המוציא לאור במעלה הזרם: כשמפרסמים הודעות מאפליקציה חיצונית, צריך להוסיף את ההקשר של W3C Trace למאפייני ההודעה ב-Pub/Sub. מידע נוסף על מעקב OpenTelemetry ב-Pub/Sub
- מאפיינים: Beam מצפה למאפיינים הבאים ומאכלס אותם:
-
googclient_traceparent: מכיל את הכותרת של W3Ctraceparent. -
googclient_tracestate: מכיל את הכותרתtracestateשל W3C.
-
- למידע על פורמט הכותרת, אפשר לעיין במפרט של W3C Trace Context.
Apache Kafka
כדי להפעיל מעקב כשקוראים מ-Apache Kafka או כותבים ל-Apache Kafka:
// Reading from Kafka
pipeline.apply("ReadFromKafka",
    KafkaIO.<String, String>read()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );

// Writing to Kafka
pipeline.apply("WriteToKafka",
    KafkaIO.<String, String>write()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );
פרטים על העברת ההקשר:
-
KafkaIOמשתמש בכותרות רגילות של רשומות Kafka כדי להעביר את ההקשר. - הוא מצפה לכותרות שתואמות למפרט של W3C Trace Context ומזריק אותן:
-
traceparent: מזהה את הקשר של יומן המעקב הנכנס. -
tracestate: מספק מטא-נתונים נוספים של ניתוב וסינון שספציפיים לספק.
-
Spanner
כדי להפעיל מעקב כשקוראים מזרמי שינויים ב-Spanner:
pipeline.apply("ReadChangeStream",
    SpannerIO.readChangeStream()
        .withSpannerConfig(spannerConfig)
        .withEnableOpenTelemetryTracing(true)
        .withChangeStreamName("CHANGE_STREAM_NAME"));
מחליפים את מה שכתוב בשדות הבאים:
- CHANGE_STREAM_NAME: השם של זרם השינויים ב-Spanner.
פרטי יצירת טווח:
- הפעלת מעקב מתחילה מעקב חדש וטווח חדש לכל רשומה של שינוי במסד הנתונים שנקראת על ידי קורא ה-CDC (לכידת נתוני שינוי).
- יכול להיות שגם מחזורי סקר של קורא Spanner שלא מחזירים רשומות חדשות יפיקו טווחי מעקב שאפשר לסנן בממשק המשתמש של Cloud Trace.
הגדרה ושינוי של מאפייני מעקב
כשמציינים enable_otel_defaults, Dataflow מחיל את מאפייני ברירת המחדל הבאים:
| מאפיין (property) | ערך ברירת המחדל | תיאור |
|---|---|---|
otel.traces.exporter |
otlp |
מייצאת מעקבים באמצעות OpenTelemetry Protocol (OTLP). |
otel.exporter.otlp.endpoint |
https://telemetry.googleapis.com |
מכוון למקלט OTLP של Cloud Trace. |
google.cloud.project |
מזהה הפרויקט | Google Cloud הפרויקט שבו מאוחסנים העקבות. |
otel.traces.sampler.arg |
0.01 (1%) |
הכלי מתעד 1 מתוך כל 100 עקבות. |
otel.service.name |
options.getAppName() |
שם השירות שמשויך לטווחים, שנגזר מהאפשרות appName של צינור עיבוד הנתונים. |
כדי להתאים אישית את ההגדרה של OpenTelemetry, מעבירים רשימה של מאפיינים שמופרדים באמצעות נקודה-פסיק לאפשרות --openTelemetryProperties pipeline.
בדוגמה הבאה מוגדרים כל מאפייני ברירת המחדל באופן מפורש:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.01;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
הגדרת שם שירות בהתאמה אישית
כברירת מחדל, שם שירות המעקב נגזר מהאפשרות appName של צינור עיבוד הנתונים (--appName=YourPipelineName). אפשר לשנות את הערך הזה על ידי הגדרת המאפיין otel.service.name:
--openTelemetryProperties="otel.service.name=CUSTOM_SERVICE_NAME"
שינוי קצב הדגימה והמאפיינים
הגדרה של קצב דגימה גבוה יותר מספקת מידע מעקב מהימן יותר.
עם זאת, תדירויות דגימה גבוהות (כמו 1.0 או always_on) מגדילות באופן משמעותי את נפח נתוני המעקב שנשלחים אל Cloud Trace, מה שיכול להגדיל את Google Cloud העלויות. כדאי להשתמש בשיעורי דגימה גבוהים רק לניפוי באגים לטווח קצר, ולהקטין אותם עבור עומסי עבודה בסביבת ייצור.
בדוגמה הבאה מוגדר קצב הדגימה באופן מפורש. במקרה כזה, צריך לספק רשימה מלאה של ארגומנטים:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.02;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
ייצוא למערכות עורפיות של צד שלישי
כדי לשלוח עקבות ל-backend חיצוני לניהול עקבות או ל-OpenTelemetry Collector באירוח עצמי במקום ל-Cloud Trace:
- השמטת הניסוי הבא:
--experiments=enable_otel_defaults. הגדרה ידנית של מאפייני כלי הייצוא באמצעות
--openTelemetryProperties:--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=http://COLLECTOR_HOST:4317;otel.traces.sampler=parentbased_always_on"
Google Cloud תוסף אימות
סביבת זמן הריצה של Beam כוללת תוסף Google Cloud אימות שמאמת באופן אוטומטי בקשות של OpenTelemetry Protocol (OTLP) שנשלחות ל-Google APIs, כמו telemetry.googleapis.com.
- כשמשתמשים בערכי ברירת מחדל: Google Cloud האימות מופעל אוטומטית.
- כשמייצאים לנקודות קצה שאינן של Google: אם לא מציינים את
enable_otel_defaults, Beam משבית את תוסף האימות Google Cloud על ידי הגדרת מאפיין המערכתgoogle.otel.auth.target.signals=none. - הגדרה ידנית: אפשר להגדיר את מאפיין המערכת
google.otel.auth.target.signalsלערךnone(מושבת) אוtrace(מופעל רק למעקב).
כתיבת עקבות בהתאמה אישית ב-DoFn
אפשר ליצור טווחים בהתאמה אישית בתוך קוד המשתמש, למשל בתוך DoFn, כדי למדוד פעולות ספציפיות. החישוב הזה כולל קריאות לממשקי API חיצוניים או לוגיקה שדורשת הרבה משאבי מחשוב.
דוגמה להטמעה של DoFn
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.StatusCode;
import io.opentelemetry.api.trace.Tracer;
import io.opentelemetry.context.Scope;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class InvestigateTransactionDoFn extends DoFn<Transaction, RiskAssessment> {
  private transient Tracer tracer;

  @Setup
  public void setup(PipelineOptions options) {
    // Obtain the Tracer instance from SdkHarnessOptions
    this.tracer = options
        .as(SdkHarnessOptions.class)
        .getOpenTelemetry()
        .getTracer("org.apache.beam.examples.adk.aml");
  }

  @ProcessElement
  public void processElement(@Element Transaction tx, OutputReceiver<RiskAssessment> out) {
    // Create and start a custom span as a child of the active context
    Span span = tracer.spanBuilder("InvestigateTransactionDoFn:Analyze")
        .setAttribute("transaction.id", tx.getId())
        .setAttribute("transaction.amount", tx.getAmount())
        .startSpan();

    // Make the span current in the execution thread
    try (Scope scope = span.makeCurrent()) {
      // Perform your logic (such as calling an external service)
      RiskAssessment assessment = analyzeTransactionWithLLM(tx);
      out.output(assessment);
    } catch (Exception e) {
      // Record exception details and set error status on the span
      span.recordException(e);
      span.setStatus(StatusCode.ERROR, e.getMessage());
      throw e;
    } finally {
      // Always end the span
      span.end();
    }
  }

  private RiskAssessment analyzeTransactionWithLLM(Transaction tx) {
    // Application analysis logic
    return new RiskAssessment();
  }
}
שילוב עם ספריות לקוח
כש-DoFn מפעיל ספריות חיצוניות שתומכות גם ב-OpenTelemetry, כמו
Google Cloud ספריות לקוח, צריך להגדיר את הלקוח כך שישתמש במופע OpenTelemetry
של צינור העיבוד, כדי שטווחים צאצאים יקושרו ישירות למעקב של צינור העיבוד.
דוגמה ללקוח Spanner Java
כדי להריץ שאילתות Spanner ידניות בתוך DoFn ולקשר את טווחי הזמן האלה למעקב אחר צינורות פעיל, צריך לאתחל את SpannerOptions באמצעות מופע OpenTelemetry של צינורות:
import com.google.cloud.spanner.DatabaseClient;
import com.google.cloud.spanner.DatabaseId;
import com.google.cloud.spanner.ResultSet;
import com.google.cloud.spanner.Spanner;
import com.google.cloud.spanner.SpannerOptions;
import com.google.cloud.spanner.Statement;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class SpannerEnrichmentDoFn extends DoFn<String, String> {
  private transient Spanner spanner;
  private transient DatabaseClient dbClient;
  private final String instanceId;
  private final String databaseId;

  public SpannerEnrichmentDoFn(String instanceId, String databaseId) {
    this.instanceId = instanceId;
    this.databaseId = databaseId;
  }

  @Setup
  public void setup(PipelineOptions pipelineOptions) {
    // Build SpannerOptions leveraging the pipeline's active OpenTelemetry instance
    SpannerOptions options =
        SpannerOptions.newBuilder()
            .setOpenTelemetry(pipelineOptions
                .as(SdkHarnessOptions.class)
                .getOpenTelemetry())
            .setEnableEndToEndTracing(true)
            .setEnableExtendedTracing(true)
            .build();

    this.spanner = options.getService();
    DatabaseId db = DatabaseId.of(options.getProjectId(), instanceId, databaseId);
    this.dbClient = spanner.getDatabaseClient(db);
  }

  @ProcessElement
  public void processElement(@Element String inputId, OutputReceiver<String> out) {
    Statement statement = Statement.newBuilder(
        "SELECT Details FROM AccountTable WHERE AccountId = @id")
        .bind("id").to(inputId)
        .build();

    // Spanner queries automatically generate child spans linked to the active trace
    try (ResultSet rs = dbClient.singleUse().executeQuery(statement)) {
      while (rs.next()) {
        out.output(rs.getString("Details"));
      }
    }
  }

  @Teardown
  public void tearDown() {
    if (spanner != null) {
      spanner.close();
    }
  }
}
העברת הקשר בין שלבים
בצינורות נתונים מבוזרים, חשוב להעביר את הקשר יומן המעקב בין גבולות ה-worker ופעולות מיון הנתונים (shuffle) כדי לקבל שקיפות מקצה לקצה.
כשמוסיפים את Redistribute.arbitrarily() לפייפליין, הקשר יומן המעקב הפעיל עובר סריאליזציה למטא-נתונים של הרכיב, מועבר ברשת ועובר דה-סריאליזציה ב-worker VM המקבל. כך אפשר לוודא שהמעקב ימשיך בצורה רציפה בין השלבים.
בדוגמה הבאה אפשר לראות איך הקשר יומן מעקב עובר בין שלבים בפייפליין:
- חילוץ הקשר יומן מעקב:
KafkaIO.read()קורא רשומה נכנסת ומחלץ את הקשר יומן המעקב מכותרות ההודעות. - עיבוד ויצירה של טווחים:
DoFn Aמעבד את הרכיב בטווח פעיל של מעקב. - הפצה בין workers:
Redistribute.arbitrarily()מבצע סריאליזציה של הקשר יומן המעקב הפעיל למטא-נתונים של הרכיב ומערבב את הרכיב ברשת. - המשך יומן המעקב:
DoFn Bהרכיב מתקבל ב-worker VM, הקשר יומן המעקב עובר דה-סריאליזציה והעיבוד נמשך עם אותו מזהה יומן מעקב.
צפייה בנתוני מעקב ב-Cloud Trace
אחרי שמפעילים את האפשרות 'מעקב', אפשר לראות את המעקב אחר צינור עיבוד הנתונים במסוף: Google Cloud
נכנסים לדף Trace explorer במסוף Google Cloud .
בתיבת הסינון, מסננים לפי
Service: SERVICE_NAME. ה-SERVICE_NAME הזה תואם לצינורappNameאו ל-otel.service.nameשהגדרתם.אפשר גם לחפש מזהה מעקב ספציפי.
בוחרים מעקב מרשימת התוצאות כדי לראות את ציר הזמן המפורט שלו.
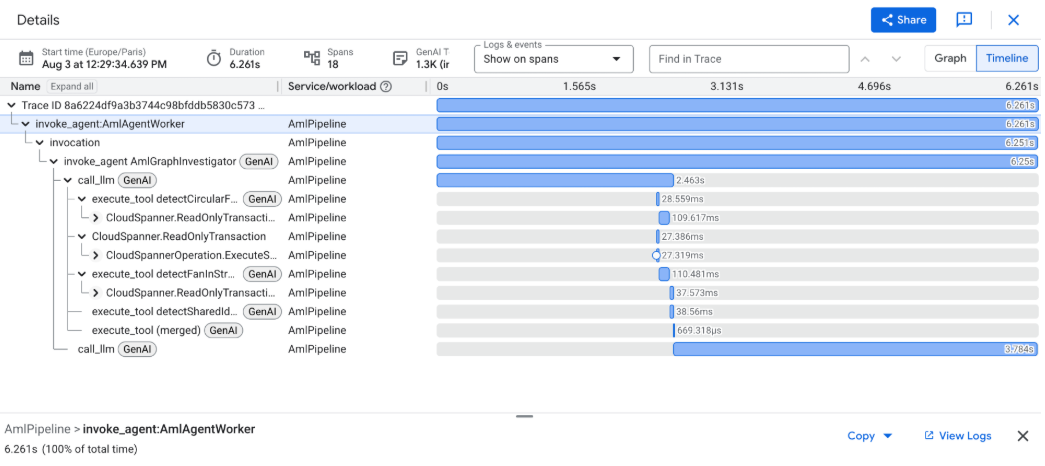
בתרשים ציר הזמן מוצגים:
- מרווחי זמן של Runner: מרווחי זמן שנוצרו על ידי זמן הריצה של Beam.
לדוגמה,
PubSubIO.Readו-ProcessElement. - טווחים בהתאמה אישית: טווחים שנוצרו בתוך הטמעות של
DoFn. לדוגמה,InvestigateTransactionDoFn:Analyze. טווחים של ספריות לקוח: טווחי צאצא שנוצרו על ידי ספריות לקוח משולבות. לדוגמה, שאילתות Spanner RPC.
- מרווחי זמן של Runner: מרווחי זמן שנוצרו על ידי זמן הריצה של Beam.
לדוגמה,
המאמרים הבאים
- מידע נוסף על עיון בניתוח של עקבות מבוזרים זמין במאמרי העזרה של Cloud Trace.
- אפשר לעקוב אחרי הודעות משלב ההטמעה ועד לעיבוד באמצעות מעקב OpenTelemetry ב-Pub/Sub.
- אפשר לעקוב אחרי התפוקה של צינור עיבוד הנתונים, השימוש ב-CPU ופרטי ההפעלה באמצעות ממשק המעקב של Dataflow.
- אפשר להציג יומנים תפעוליים ולאבחן שגיאות באמצעות יומנים של צינורות עיבוד נתונים ב-Dataflow.
- כדי לחקור ולפתור בעיות בביצועים, אפשר לעיין במאמרים פתרון בעיות של עבודות איטיות או תקועות וזיהוי צווארי בקבוק בצינורות ופתרון שלהם.