Google 會運用 AI 技術將內容翻譯成你偏好的語言,但可能會出錯。
提供意見
用途:控管其他專案中 Managed Service for Apache Spark 叢集的存取權
透過集合功能整理內容
你可以依據偏好儲存及分類內容。
本頁面說明在另一個 Google Cloud 專案中部署及執行使用 Managed Service for Apache Spark 叢集的管道時,如何管理存取控管。
情境
根據預設,在Google Cloud 專案中啟動 Cloud Data Fusion 執行個體時,系統會使用同一專案中的 Managed Service for Apache Spark 叢集部署及執行管道。不過,貴機構可能要求您使用其他專案中的叢集。如要使用這項功能,您必須管理專案之間的存取權。下頁說明如何變更基準 (預設) 設定,以及套用適當的存取權控管。
事前準備
如要瞭解這個用途的解決方案,您需要下列背景資訊:
假設和範圍
這個用途有下列需求:
注意: 這個使用情境不會顯示來源和接收器位於其他虛擬私有雲的網路情境。 解決方案
這項解決方案會比較基準和特定用途的架構與設定。
架構
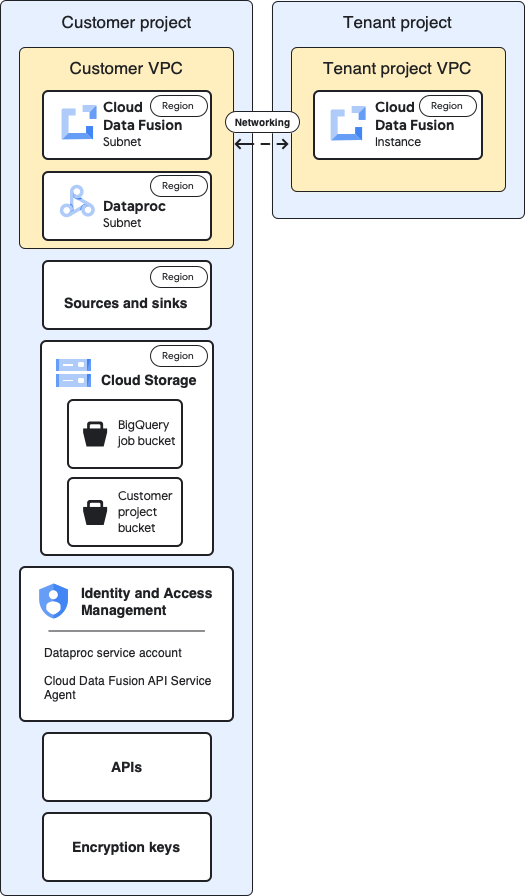
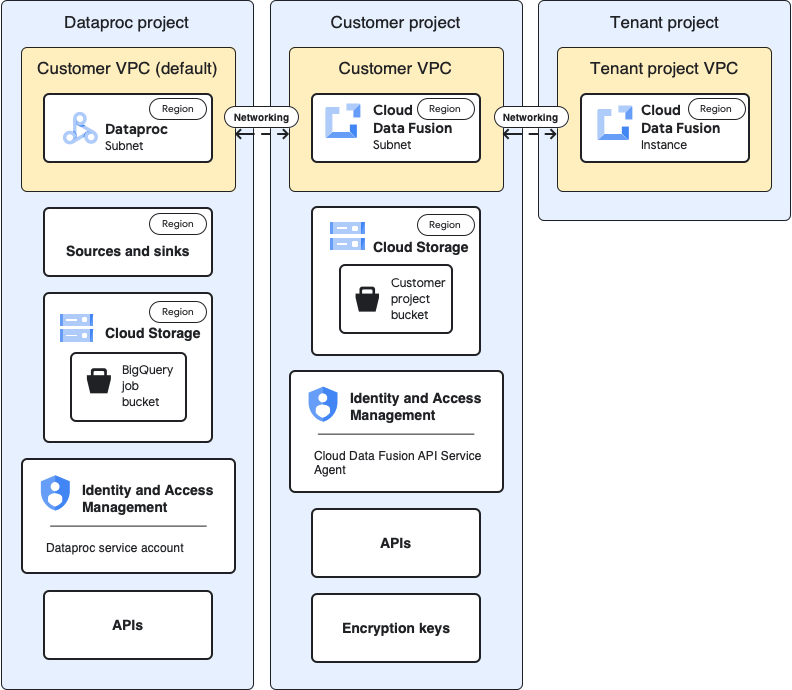
下圖比較了在同一個專案 (基準) 中使用叢集,以及透過租戶專案 VPC 在不同專案中使用叢集時,建立 Cloud Data Fusion 執行個體和執行管道的專案架構。
基準架構
下圖顯示專案的基準架構:
如要進行基準設定,請建立 Cloud Data Fusion 私人執行個體,並執行管道,無須進行額外自訂:
使用其中一個內建運算設定檔
來源和接收器與執行個體位於相同專案
未將其他角色授予任何服務帳戶
如要進一步瞭解租戶和客戶專案,請參閱「網路 」。
應用實例架構
下圖顯示在其他專案中使用叢集時的專案架構:
設定
以下各節會比較基準設定與特定用途的設定,以便透過預設的租戶專案 VPC,在不同專案中使用 Managed Service for Apache Spark 叢集。
在下列用途說明中,「客戶專案」
注意: 用途設定假設您在 Managed Service for Apache Spark 專案中使用預設的 Compute Engine 服務帳戶,執行 Managed Service for Apache Spark 工作。 租戶專案虛擬私有雲和執行個體
基準
用途
在上述基準架構圖中,租戶專案包含下列元件:
系統自動建立的預設虛擬私有雲。
Cloud Data Fusion 執行個體的實際部署作業。
這個用途不需要額外設定。
客戶專案
基準
用途
您會在 Google Cloud 專案中部署及執行管道。
根據預設,執行管道時,Managed Service for Apache Spark 叢集會在這個專案中啟動。
在本使用案例中,您會管理兩個專案。在本頁面中,「客戶專案」Managed Service for Apache Spark 專案 是指啟動 Managed Service for Apache Spark 叢集的專案。
客戶虛擬私有雲
基準
用途
從客戶的角度來看,客戶 VPC 是 Cloud Data Fusion 邏輯上所在的位置。
重點:
前往虛擬私有雲網路
這個用途不需要額外設定。
Cloud Data Fusion 子網路
基準
用途
從客戶的角度來看,這個子網路是 Cloud Data Fusion 的邏輯位置。
重點: 這個用途不需要額外設定。
Managed Service for Apache Spark 子網路
基準
用途
執行管道時,啟動 Managed Service for Apache Spark 叢集的子網路。
重點摘要:
在這個基準設定中,Managed Service for Apache Spark 與 Cloud Data Fusion 執行個體位於相同子網路。
Cloud Data Fusion 會在與執行個體和 Cloud Data Fusion 子網路相同的區域中,找出子網路。如果這個區域只有一個子網路,則子網路相同。
Managed Service for Apache Spark 子網路必須具備 Private Google Access。
這是新的子網路,當您執行管道時,系統會啟動 Managed Service for Apache Spark 叢集。
重點摘要:
為這個新子網路將 Private Google Access 設為「啟用」
Managed Service for Apache Spark 子網路不必與 Cloud Data Fusion 執行個體位於相同位置。
來源和接收器
基準
用途
擷取資料的來源和載入資料的接收端,例如 BigQuery 來源和接收端。
重點:
擷取及載入資料的工作必須在與資料集相同的位置處理,否則會發生錯誤。
本頁的存取控管設定適用於 BigQuery 來源和接收器。
Cloud Storage
基準
用途
客戶專案中的儲存空間 bucket,可協助在 Cloud Data Fusion 和 Managed Service for Apache Spark 之間轉移檔案。
重點摘要:
您可以在暫時性叢集的「Compute Profile」
如果是批次和即時管道,或是複製工作:
如果未在運算設定檔中指定 bucket,
Cloud Data Fusion 會在與執行個體相同的專案中建立 bucket,以供此用途使用。
即使是靜態 Managed Service for Apache Spark 叢集,在這個基準設定中,bucket 也是由 Cloud Data Fusion 建立,且與 Managed Service for Apache Spark 暫存和臨時 bucket 不同。
Cloud Data Fusion API 服務代理程式 具有內建權限,可在包含 Cloud Data Fusion 執行個體的專案中建立這個值區。
這個用途不需要額外設定。
來源和接收器使用的臨時 bucket
基準
用途
外掛程式為來源和接收器建立的暫存值區,例如 BigQuery 接收器外掛程式啟動的載入工作。
重點摘要:
設定來源和接收器外掛程式屬性時,可以定義這些值區。
如未定義 bucket,系統會在 Managed Service for Apache Spark 執行的專案中建立 bucket。
如果資料集是多地區,系統會在相同範圍內建立值區。
如果您在外掛程式設定中定義值區,值區的地區必須與資料集的地區相符。
如果您未在外掛程式設定中定義 bucket,系統會在管道完成時刪除為您建立的 bucket。
在本例中,您可以在任何專案中建立 bucket。
外掛程式的資料來源或接收器值區
基準
用途
客戶 bucket,您可以在外掛程式 (例如 Cloud Storage 外掛程式和 FTP to Cloud Storage 外掛程式) 的設定中指定。
這個用途不需要額外設定。
IAM:Cloud Data Fusion API 服務代理
基準
用途
啟用 Cloud Data Fusion API 時,系統會自動將 Cloud Data Fusion API 服務代理角色 (roles/datafusion.serviceAgent) 授予
Cloud Data Fusion 服務帳戶 (主要服務代理人)。
重點摘要:
這個角色包含與執行個體位於同一專案中的服務權限,例如 BigQuery 和 Managed Service for Apache Spark。如要查看所有支援的服務,請參閱角色詳細資料 。
Cloud Data Fusion 服務帳戶會執行下列動作:
資料平面 (管道設計和執行) 與其他服務的通訊 (例如在設計階段與 Cloud Storage、BigQuery 和 Datastream 通訊)。
佈建 Managed Service for Apache Spark 叢集。
如果您是從 Oracle 來源複製資料,這個服務帳戶也必須在工作所在的專案中,具備 Datastream 管理員和 Storage 管理員角色。本頁面未說明複製用途。
針對這個用途,請將 Cloud Data Fusion API 服務代理角色授予 Managed Service for Apache Spark 專案中的服務帳戶。然後在該專案中授予下列角色:
Compute 網路使用者角色
Dataproc 編輯者角色
IAM:Managed Service for Apache Spark 服務帳戶
基準
用途
用於在 Managed Service for Apache Spark 叢集中以工作形式執行管道的服務帳戶。根據預設,這是 Compute Engine 服務帳戶。
選用:在基準設定中,您可以將預設服務帳戶變更為同一專案中的其他服務帳戶。將下列 IAM 角色授予新的服務帳戶:
Cloud Data Fusion Runner 角色。這個角色可讓 Managed Service for Apache Spark 與 Cloud Data Fusion API 通訊。
Dataproc Worker 角色。這個角色可讓工作在 Managed Service for Apache Spark 叢集上執行。
重點摘要:
必須將 Managed Service for Apache Spark 服務帳戶的「服務帳戶使用者」角色授予新服務的 API 代理服務帳戶,服務 API 代理才能使用該帳戶啟動 Managed Service for Apache Spark 叢集。
這個使用案例範例假設您使用 Managed Service for Apache Spark 專案的預設 Compute Engine 服務帳戶 (PROJECT_NUMBER -compute@developer.gserviceaccount.com
在 Managed Service for Apache Spark 專案中,將下列角色授予預設的 Compute Engine 服務帳戶。
注意: 如要使用其他服務帳戶執行 Cloud Data Fusion 管道,請在 Managed Service for Apache Spark 專案中,將角色授予該服務帳戶。
Dataproc Worker 角色
「儲存空間管理員」角色 (或至少是 `storage.buckets.create` 權限),讓 Managed Service for Apache Spark 為 BigQuery 建立臨時 bucket。
BigQuery 工作使用者角色。這個角色可讓 Managed Service for Apache Spark 建立載入工作。工作預設會在 Managed Service for Apache Spark 專案中建立。
BigQuery 資料集編輯者角色。這個角色可讓 Managed Service for Apache Spark 在載入資料時建立資料集。
在 Managed Service for Apache Spark 專案的預設 Compute Engine 服務帳戶中,將服務帳戶使用者角色授予 Cloud Data Fusion 服務帳戶。這項動作必須在 Managed Service for Apache Spark 專案中執行。
將 Managed Service for Apache Spark 專案的預設 Compute Engine 服務帳戶新增至 Cloud Data Fusion 專案。同時授予下列角色:
「Storage 物件檢視者」角色,可從 Cloud Data Fusion Consumer bucket 擷取管道工作相關構件。
Cloud Data Fusion Runner 角色,因此 Managed Service for Apache Spark 叢集可以在執行時與 Cloud Data Fusion 通訊。
API
基準
用途
啟用 Cloud Data Fusion API 時,系統也會啟用下列 API。如要進一步瞭解這些 API,請前往專案的「API 和服務」頁面。前往「API 與服務」頁面
Cloud Autoscaling API
Dataproc API
Cloud Dataproc Control API
Cloud DNS API
Cloud OS Login API
Pub/Sub API
Compute Engine API
Container Filesystem API
Container Registry API
Service Account Credentials API
Identity and Access Management API
Kubernetes Engine API
啟用 Cloud Data Fusion API 時,系統會自動將下列服務帳戶新增至專案:
Google API 服務代理
Compute Engine 服務代理人
Kubernetes Engine 服務代理
Google Container Registry 服務代理
Google Cloud Dataproc 服務代理
Cloud KMS 服務代理人
Cloud Pub/Sub 服務帳戶
在這個用途中,如果專案尚未啟用下列 API,請在包含 Managed Service for Apache Spark 專案的專案中啟用這些 API:
Compute Engine API
Dataproc API
Cloud Resource Manager API
加密金鑰
基準
用途
在基準設定中,加密金鑰可以是 Google 代管或 CMEK
重點摘要: 如果您使用 CMEK,基準設定必須符合下列條件:
金鑰必須是區域金鑰,且與 Cloud Data Fusion 執行個體位於相同區域。
在建立金鑰的專案中,於金鑰層級 (而非 Google Cloud 控制台的 IAM 頁面),將 Cloud KMS CryptoKey Encrypter/Decrypter 角色授予下列服務帳戶:
Cloud Data Fusion API 服務帳戶
Managed Service for Apache Spark 服務帳戶,預設為 Compute Engine 服務代理程式 (service-PROJECT_NUMBER @compute-system.iam.gserviceaccount.com)
Google Cloud Dataproc 服務代理
(service-PROJECT_NUMBER @dataproc-accounts.iam.gserviceaccount.com)
Cloud Storage 服務代理
(service-PROJECT_NUMBER @gs-project-accounts.iam.gserviceaccount.com)
視管道中使用的服務 (例如 BigQuery 或 Cloud Storage) 而定,服務帳戶也必須獲得 Cloud KMS CryptoKey Encrypter/Decrypter 角色:
BigQuery 服務帳戶 (bq-PROJECT_NUMBER @bigquery-encryption.iam.gserviceaccount.com)
Pub/Sub 服務帳戶 (service-PROJECT_NUMBER @gcp-sa-pubsub.iam.gserviceaccount.com)
Spanner 服務帳戶 (service-PROJECT_NUMBER @gcp-sa-spanner.iam.gserviceaccount.com)
如果您未使用 CMEK,則無須針對這個用途進行額外變更。
如果您使用 CMEK,則必須在建立金鑰的專案中,將 Cloud KMS CryptoKey Encrypter/Decrypter 角色授予下列服務帳戶:
Cloud Storage 服務代理
(service-PROJECT_NUMBER @gs-project-accounts.iam.gserviceaccount.com)
視管道中使用的服務而定 (例如 BigQuery 或 Cloud Storage),其他服務帳戶也必須在金鑰層級獲得 Cloud KMS CryptoKey 加密者/解密者角色。例如:
BigQuery 服務帳戶 (bq-PROJECT_NUMBER @bigquery-encryption.iam.gserviceaccount.com)
Pub/Sub 服務帳戶 (service-PROJECT_NUMBER @gcp-sa-pubsub.iam.gserviceaccount.com)
Spanner 服務帳戶 (service-PROJECT_NUMBER @gcp-sa-spanner.iam.gserviceaccount.com)
完成這些特定用途的設定後,資料管道就能開始在其他專案的叢集上執行。
後續步驟
提供意見
除非另有註明,否則本頁面中的內容是採用創用 CC 姓名標示 4.0 授權 ,程式碼範例則為阿帕契 2.0 授權 。詳情請參閱《Google Developers 網站政策 》。Java 是 Oracle 和/或其關聯企業的註冊商標。
上次更新時間:2026-10-11 (世界標準時間)。
想進一步說明嗎?
[[["容易理解","easyToUnderstand","thumb-up"],["確實解決了我的問題","solvedMyProblem","thumb-up"],["其他","otherUp","thumb-up"]],[["難以理解","hardToUnderstand","thumb-down"],["資訊或程式碼範例有誤","incorrectInformationOrSampleCode","thumb-down"],["缺少我需要的資訊/範例","missingTheInformationSamplesINeed","thumb-down"],["翻譯問題","translationIssue","thumb-down"],["其他","otherDown","thumb-down"]],["上次更新時間:2026-10-11 (世界標準時間)。"],[],[]]