


Esta página descreve como gerenciar o controle de acesso ao implantar e executar um pipeline que usa clusters do Serviço Gerenciado para Apache Spark em outro projeto Google Cloud .
Cenário
Por padrão, quando uma instância do Cloud Data Fusion é iniciada em um projetoGoogle Cloud , ela implanta e executa pipelines usando clusters do serviço gerenciado para Apache Spark no mesmo projeto. No entanto, sua organização pode exigir que você use clusters em outro projeto. Nesse caso de uso, é necessário gerenciar o acesso entre os projetos. A página a seguir descreve como mudar as configurações de base (padrão) e aplicar os controles de acesso adequados.
Antes de começar
Para entender as soluções neste caso de uso, você precisa do seguinte contexto:
- Familiaridade com os conceitos básicos do Cloud Data Fusion
- Familiaridade com o Identity and Access Management (IAM) para o Cloud Data Fusion
- Familiaridade com a rede do Cloud Data Fusion
Premissas e escopo
Esse caso de uso tem os seguintes requisitos:
- Uma instância particular do Cloud Data Fusion. Por motivos de segurança, uma organização pode exigir que você use esse tipo de instância.
- Uma origem e um coletor do BigQuery.
- Controle de acesso com o IAM, não com o controle de acesso baseado em papéis (RBAC).
Solução
Essa solução compara a arquitetura e a configuração de base e de caso de uso específico.
Arquitetura
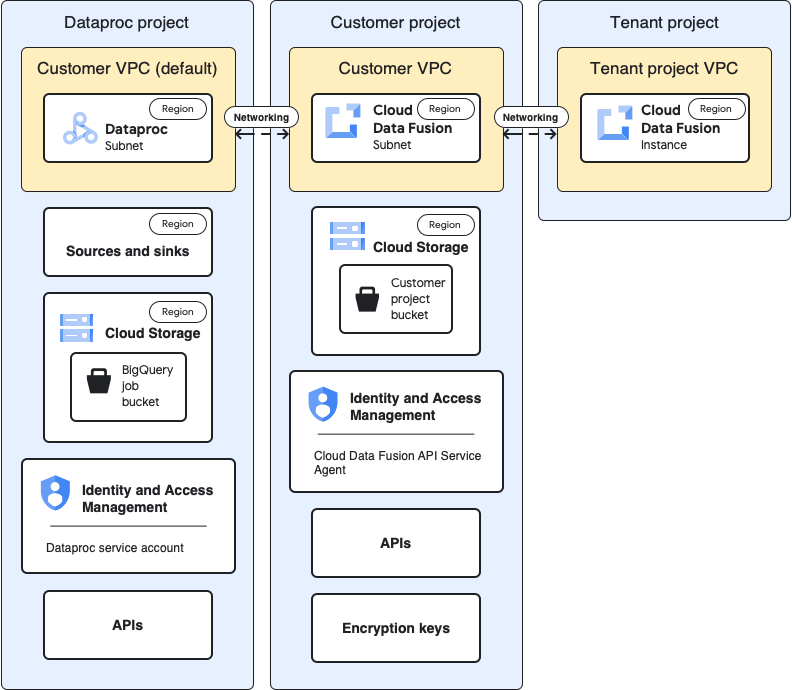
Os diagramas a seguir comparam a arquitetura do projeto para criar uma instância do Cloud Data Fusion e executar pipelines quando você usa clusters no mesmo projeto (referência) e em um projeto diferente pela VPC do projeto de locatário.
Arquitetura de valor de referência
Este diagrama mostra a arquitetura de base dos projetos:
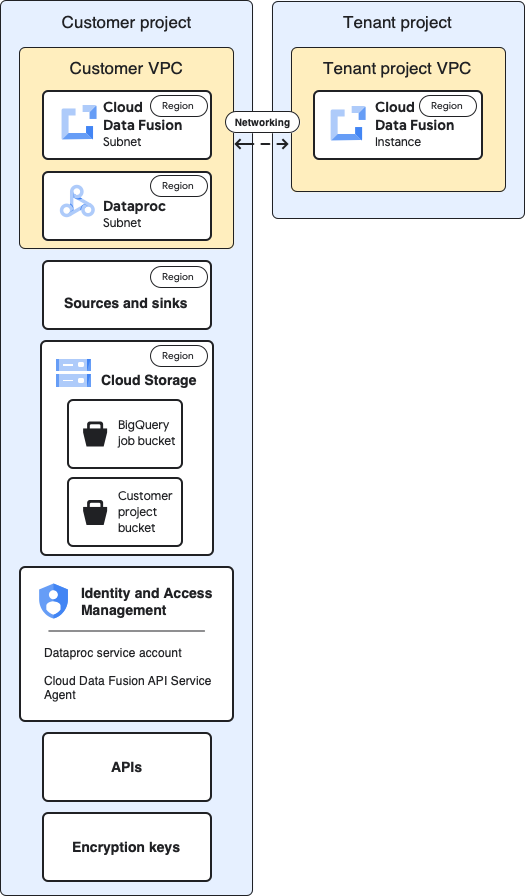
Para a configuração de base, crie uma instância particular do Cloud Data Fusion e execute um pipeline sem personalização adicional:
- Você usa um dos perfis de computação integrados
- A origem e o destino estão no mesmo projeto da instância.
- Nenhum papel adicional foi concedido a nenhuma das contas de serviço
Para mais informações sobre projetos de locatário e cliente, consulte Rede.
Arquitetura de caso de uso
Este diagrama mostra a arquitetura do projeto ao usar clusters em outro projeto:
Configurações
As seções a seguir comparam as configurações de base com as configurações específicas do caso de uso para usar clusters do Serviço Gerenciado para Apache Spark em um projeto diferente pela VPC padrão do projeto do locatário.
Nas descrições de caso de uso a seguir, o projeto do cliente é onde a instância do Cloud Data Fusion é executada, e o projeto do Serviço Gerenciado para Apache Spark é onde o cluster do Serviço Gerenciado para Apache Spark é iniciado.
VPC e instância do projeto de locatário
| Valor de referência | Caso de uso |
|---|---|
No diagrama de arquitetura de referência anterior, o projeto de locatário
contém os seguintes componentes:
|
Nenhuma configuração adicional é necessária para esse caso de uso. |
Projeto do cliente
| Valor de referência | Caso de uso |
|---|---|
| O projeto Google Cloud é onde você implanta e executa pipelines. Por padrão, os clusters do Serviço Gerenciado para Apache Spark são iniciados nesse projeto quando você executa os pipelines. | Neste caso de uso, você gerencia dois projetos. Nesta página, o projeto do cliente se refere a onde a instância do Cloud Data Fusion é executada. O projeto do Serviço Gerenciado para Apache Spark se refere a onde os clusters do Serviço Gerenciado para Apache Spark são iniciados. |
VPC do cliente
| Valor de referência | Caso de uso |
|---|---|
Do seu ponto de vista (do cliente), a VPC do cliente é onde o Cloud Data Fusion está logicamente localizado. Principal conclusão: você encontra os detalhes da VPC do cliente na página de redes VPC do seu projeto. |
Nenhuma configuração adicional é necessária para esse caso de uso. |
Sub-rede do Cloud Data Fusion
| Valor de referência | Caso de uso |
|---|---|
Do seu ponto de vista (do cliente), essa sub-rede é onde o Cloud Data Fusion está localizado logicamente. Principal conclusão: a região dessa sub-rede é a mesma que o local da instância do Cloud Data Fusion no projeto do locatário. |
Nenhuma configuração adicional é necessária para esse caso de uso. |
Sub-rede do Serviço Gerenciado para Apache Spark
| Valor de referência | Caso de uso |
|---|---|
A sub-rede em que os clusters do Serviço Gerenciado para Apache Spark são iniciados quando você executa um pipeline. Principais conclusões:
|
Esta é uma nova sub-rede em que os clusters do Serviço Gerenciado para Apache Spark são iniciados quando você executa um pipeline. Principais conclusões:
|
Origens e coletores
| Valor de referência | Caso de uso |
|---|---|
As origens de onde os dados são extraídos e os coletores em que são carregados, como origens e coletores do BigQuery. Ponto-chave:
|
As configurações de controle de acesso específicas do caso de uso nesta página são para origens e destinos do BigQuery. |
Cloud Storage
| Valor de referência | Caso de uso |
|---|---|
O bucket de armazenamento no projeto do cliente que ajuda a transferir arquivos entre o Cloud Data Fusion e o Serviço Gerenciado para Apache Spark. Principais conclusões:
|
Nenhuma configuração adicional é necessária para esse caso de uso. |
Buckets temporários usados pela origem e pelo coletor
| Valor de referência | Caso de uso |
|---|---|
Os buckets temporários criados por plug-ins para suas origens e destinos, como os jobs de carregamento iniciados pelo plug-in de destino do BigQuery. Principais conclusões:
|
Para este caso de uso, o bucket pode ser criado em qualquer projeto. |
Buckets que são fontes ou coletores de dados para plug-ins
| Valor de referência | Caso de uso |
|---|---|
| Buckets do cliente, que você especifica nas configurações de plug-ins, como o plug-in do Cloud Storage e o plug-in de FTP para Cloud Storage. | Nenhuma configuração adicional é necessária para esse caso de uso. |
IAM: agente de serviço da API Cloud Data Fusion
| Valor de referência | Caso de uso |
|---|---|
Quando a API Data Fusion é ativada, a
função de agente de serviço da API Data
Fusion
( Principais conclusões:
|
Para esse caso de uso, conceda o papel de agente de serviço da API Cloud Data Fusion à conta de serviço no projeto do Serviço gerenciado para Apache Spark. Em seguida, conceda os seguintes papéis nesse projeto:
|
IAM: conta de serviço do Serviço Gerenciado para Apache Spark
| Valor de referência | Caso de uso |
|---|---|
A conta de serviço usada para executar o pipeline como um job no cluster do Serviço Gerenciado para Apache Spark. Por padrão, é a conta de serviço do Compute Engine. Opcional: na configuração de comparativo, é possível mudar a conta de serviço padrão para outra do mesmo projeto. Conceda os seguintes papéis do IAM à nova conta de serviço:
|
Este exemplo de caso de uso pressupõe que você use a conta de serviço padrão do Compute Engine ( Conceda os seguintes papéis à conta de serviço padrão do Compute Engine no projeto do Serviço Gerenciado para Apache Spark.
Conceda o papel de usuário da conta de serviço à conta de serviço do Cloud Data Fusion na conta de serviço padrão do Compute Engine do projeto do Serviço gerenciado para Apache Spark. Essa ação precisa ser realizada no projeto do Serviço Gerenciado para Apache Spark. Adicione a conta de serviço padrão do Compute Engine do projeto do Serviço gerenciado para Apache Spark ao projeto do Cloud Data Fusion. Conceda também os seguintes papéis:
|
APIs
| Valor de referência | Caso de uso |
|---|---|
Quando você ativa a API Cloud Data Fusion, as seguintes APIs também são ativadas: Para mais informações sobre essas APIs, acesse a página
"APIs e serviços" no seu projeto.
Quando você ativa a API Cloud Data Fusion, as seguintes contas de serviço são adicionadas automaticamente ao seu projeto:
|
Para esse caso de uso, ative as seguintes APIs no projeto que
contém o projeto do Serviço Gerenciado para Apache Spark, se elas ainda não estiverem
ativadas:
|
Chaves de criptografia
| Valor de referência | Caso de uso |
|---|---|
Na configuração básica, as chaves de criptografia podem ser gerenciadas pelo Google ou CMEK . Principais conclusões: Se você usa a CMEK, a configuração de base exige o seguinte:
Dependendo dos serviços usados no pipeline, como BigQuery ou Cloud Storage, as contas de serviço também precisam receber o papel de criptografador/descriptografador de CryptoKey do Cloud KMS:
|
Se você não usa a CMEK, não é necessário fazer outras mudanças para esse caso de uso. Se você usar a CMEK, o papel de criptografia/descriptografia do CryptoKey do Cloud KMS precisará ser fornecido à seguinte conta de serviço no nível da chave no projeto em que ela foi criada:
Dependendo dos serviços usados no pipeline, como BigQuery ou Cloud Storage, outras contas de serviço também precisam receber o papel de criptografador/descriptografador de CryptoKey do Cloud KMS no nível da chave. Exemplo:
|
Depois de fazer essas configurações específicas do caso de uso, seu pipeline de dados poderá começar a ser executado em clusters em outro projeto.
A seguir
- Saiba mais sobre redes no Cloud Data Fusion.
- Consulte a Referência dos papéis básicos e predefinidos do IAM.