


本指南說明如何部署、設定及執行使用 SAP OData 外掛程式的資料管道。
您可以使用開放資料通訊協定 (OData),在 Cloud Data Fusion 中將 SAP 做為批次式資料擷取的來源。SAP OData 外掛程式可協助您設定及執行 SAP OData 目錄服務的資料轉移作業,完全不必編寫程式碼。
如要進一步瞭解支援的 SAP OData 目錄服務和資料來源,請參閱支援詳細資料。如要進一步瞭解Google Cloud上的 SAP,請參閱「 Google Cloud上的 SAP 總覽」。
目標
- 設定 SAP ERP 系統 (在 SAP 中啟用資料來源)。
- 在 Cloud Data Fusion 環境中部署外掛程式。
- 從 Cloud Data Fusion 下載 SAP 轉移作業,並在 SAP 中安裝。
- 使用 Cloud Data Fusion 和 SAP OData 建立資料管道,整合 SAP 資料。
事前準備
如要使用這個外掛程式,您必須具備下列領域的專業知識:
- 在 Cloud Data Fusion 中建構管道
- 使用 IAM 管理存取權
- 設定 SAP Cloud 和內部部署的企業資源規劃 (ERP) 系統
使用者角色
本頁面的工作由 Google Cloud 或 SAP 系統中具有下列角色的使用者執行:
| 使用者類型 | 說明 |
|---|---|
| Google Cloud 管理員 | 獲派此角色的使用者是 Google Cloud 帳戶的管理員。 |
| Cloud Data Fusion 使用者 | 獲派此角色的使用者有權設計及執行資料管道。他們至少會獲得 Data Fusion 檢視者 (
roles/datafusion.viewer) 角色。如果您使用角色式存取權控管,可能需要其他角色。 |
| SAP 管理員 | 獲派此角色的使用者是 SAP 系統的管理員。他們可以從 SAP 服務網站下載軟體。並非 IAM 角色。 |
| SAP 使用者 | 指派此角色的使用者可連線至 SAP 系統。這不是 IAM 角色。 |
OData 擷取作業的必要條件
OData 目錄服務必須在 SAP 系統中啟用。
資料必須填入 OData 服務。
SAP 系統的必要條件
在 SAP NetWeaver 7.02 至 SAP NetWeaver 7.31 版中,OData 和 SAP Gateway 功能隨附於下列 SAP 軟體元件:
IW_FNDGW_COREIW_BEP
在 SAP NetWeaver 7.40 以上版本中,所有功能都位於
SAP_GWFND元件中,必須在 SAP NetWeaver 中提供。
選用:安裝 SAP 傳輸檔案
系統會以 SAP 傳輸檔案的形式提供負載平衡呼叫 SAP 時所需的 SAP 元件,並將這些檔案封存為 zip 檔 (一個傳輸要求,包含一個 cofile 和一個資料檔案)。您可以根據 SAP 中的可用工作程序,使用這個步驟限制對 SAP 的多個平行呼叫。
在 Cloud Data Fusion Hub 中部署外掛程式後,即可下載 ZIP 檔案。
將傳輸檔案匯入 SAP 時,系統會建立下列 SAP OData 專案:
OData 專案
/GOOG/GET_STATISTIC/GOOG/TH_WPINFO
ICF 服務節點:
GOOG
如要安裝 SAP 傳輸,請按照下列步驟操作:
步驟 1:上傳傳輸要求檔案
- 登入 SAP 執行個體的作業系統。
- 使用 SAP 交易代碼
AL11取得DIR_TRANS資料夾的路徑。通常路徑為/usr/sap/trans/。 - 將 cofiles 複製到
DIR_TRANS/cofiles資料夾。 - 將資料檔案複製到
DIR_TRANS/data資料夾。 - 將資料和共用檔案的使用者和群組設為
<sid>adm和sapsys。
步驟 2:匯入傳輸要求檔案
SAP 管理員可以使用下列任一選項匯入傳輸要求檔案:
方法 1:使用 SAP 傳輸管理系統匯入傳輸要求檔案
- 以 SAP 管理員身分登入 SAP 系統。
- 輸入交易 STMS。
- 依序點選「總覽」>「匯入」。
- 在「佇列」欄中,按兩下目前的 SID。
- 依序點選「額外」>「其他要求」>「新增」。
- 選取運送要求 ID,然後按一下「繼續」。
- 在匯入佇列中選取運送要求,然後依序點選「要求」>「匯入」。
- 輸入客戶編號。
在「Options」分頁中,選取「Overwrite originals」和「Ignore invalid component version」 (如果有的話)。
(選用) 如要將傳輸重新匯入作業排定在日後執行,請選取「將傳輸要求留在佇列中,以便日後匯入」和「再次匯入傳輸要求」。這對於 SAP 系統升級和備份還原作業非常實用。
按一下「繼續」。
如要驗證匯入作業,請使用任何交易,例如
SE80和SU01。
方法 2:在作業系統層級匯入傳輸要求檔案
- 以 SAP 系統管理員身分登入 SAP 系統。
執行下列指令,將適當要求新增至匯入緩衝區:
tp addtobuffer TRANSPORT_REQUEST_ID SID例如:
tp addtobuffer IB1K903958 DD1請執行下列指令,匯入運輸要求:
tp import TRANSPORT_REQUEST_ID SID client=NNN U1238將
NNN替換為客戶編號。例如:tp import IB1K903958 DD1 client=800 U1238使用任何適當的交易 (例如
SE80和SU01),確認函式模組和授權角色是否已成功匯入。
取得 SAP 目錄服務的可篩選資料欄清單
只有部分資料來源欄可用於篩選條件 (這是 SAP 的設計限制)。
如要取得 SAP 目錄服務的可篩選資料欄清單,請按照下列步驟操作:
- 登入 SAP 系統。
- 前往交易代碼
SEGW。 輸入 OData 專案名稱,這是服務名稱的子字串。例如:
- 服務名稱:
MM_PUR_POITEMS_MONI_SRV - 專案名稱:
MM_PUR_POITEMS_MONI
- 服務名稱:
按一下 Enter 鍵。
前往要篩選的實體,然後選取「屬性」。
您可以使用「屬性」中顯示的欄位做為篩選器。支援的作業為「等於」和「介於」 (範圍)。
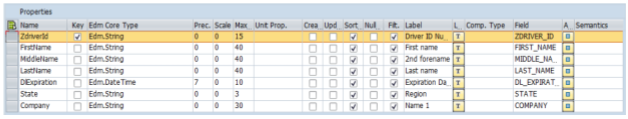
如需運算式語言支援的運算子清單,請參閱 OData 開放原始碼說明文件:URI Conventions (OData Version 2.0)。
附帶篩選器的 URI 範例:
/sap/opu/odata/sap/MM_PUR_POITEMS_MONI_SRV/C_PurchaseOrderItemMoni(P_DisplayCurrency='USD')/Results/?$filter=(PurchaseOrder eq '4500000000')
設定 SAP ERP 系統
SAP OData 外掛程式會使用在每個擷取資料的 SAP 伺服器上啟用的 OData 服務。這個 OData 服務可以是 SAP 提供的標準服務,也可以是在 SAP 系統上開發的自訂 OData 服務。
步驟 1:安裝 SAP Gateway 2.0
SAP (Basis) 管理員必須視 NetWeaver 版本而定,確認 SAP 來源系統中是否提供 SAP Gateway 2.0 元件。如要進一步瞭解如何安裝 SAP Gateway 2.0,請登入 SAP ONE Support Launchpad,並參閱注意事項 1569624 (需要登入)。
步驟 2:啟用 OData 服務
在來源系統上啟用必要的 OData 服務。詳情請參閱「前端伺服器:啟用 OData 服務」。
步驟 3:建立授權角色
如要連線至 DataSource,請在 SAP 中建立具有必要授權的授權角色,然後授予 SAP 使用者。
如要在 SAP 中建立授權角色,請按照下列步驟操作:
- 在 SAP GUI 中,輸入交易代碼 PFCG,開啟「Role Maintenance」(角色維護) 視窗。
在「角色」欄位中,輸入角色名稱。
例如:
ZODATA_AUTH按一下「單一角色」。
「建立角色」視窗隨即開啟。
在「Description」(說明) 欄位輸入說明,然後按一下「Save」(儲存)。
例如:
Authorizations for SAP OData plugin。按一下「授權」分頁標籤。 視窗標題會變更為「變更角色」。
在「編輯授權資料並產生設定檔」下方,按一下「變更授權資料」。
系統會開啟「選擇範本」視窗。
按一下「不要選取範本」。
「變更角色:授權」視窗會隨即開啟。
按一下「手動」。
請提供下表 SAP 授權中顯示的授權。
按一下 [儲存]。
如要啟用授權角色,請按一下「產生」圖示。
SAP 授權
| 物件類別 | 物件類別文字 | 授權物件 | 授權物件文字 | 授權 | 文字 | 值 |
|---|---|---|---|---|---|---|
| AAAB | 跨應用程式授權物件 | S_SERVICE | 在外部服務啟動時檢查 | SRV_NAME | 程式、交易或函式模組名稱 | * |
| AAAB | 跨應用程式授權物件 | S_SERVICE | 在外部服務啟動時檢查 | SRV_TYPE | 檢查標記類型和授權預設值 | HT |
| FI | 財務會計 | F_UNI_HIER | 通用階層存取權 | ACTVT | 活動 | 03 |
| FI | 財務會計 | F_UNI_HIER | 通用階層存取權 | HRYTYPE | 階層類型 | * |
| FI | 財務會計 | F_UNI_HIER | 通用階層存取權 | HRYID | 階層 ID | * |
如要在 Cloud Data Fusion 中設計及執行資料管道 (以 Cloud Data Fusion 使用者身分),您需要 SAP 使用者憑證 (使用者名稱和密碼),才能設定外掛程式來連線至 DataSource。
SAP 使用者必須是 Communications 或 Dialog 類型。為避免使用 SAP 對話方塊資源,建議使用 Communications 型別。使用者可使用 SAP 交易代碼 SU01 建立。
選用步驟 4:保護連線
您可以保護私人 Cloud Data Fusion 執行個體與 SAP 之間的網路通訊。
如要確保連線安全,請按照下列步驟操作:
- SAP 管理員必須產生 X509 憑證。如要產生憑證,請參閱「建立 SSL 伺服器 PSE」。
- Google Cloud 管理員必須將 X509 檔案複製到 Cloud Storage 值區 (該值區必須可讀取,且與 Cloud Data Fusion 執行個體位於同一個專案),然後將值區路徑提供給 Cloud Data Fusion 使用者,讓他們在設定外掛程式時輸入路徑。
- Google Cloud 管理員必須授予 Cloud Data Fusion 使用者 X509 檔案的讀取權限,該使用者負責設計及執行管道。
選用:步驟 5:建立自訂 OData 服務
您可以在 SAP 中建立自訂 OData 服務,自訂資料的擷取方式:
- 如要建立自訂 OData 服務,請參閱「Creation of OData services for beginners」(為初學者建立 OData 服務)。
- 如要使用核心資料服務 (CDS) 檢視區塊建立自訂 OData 服務,請參閱如何建立 OData 服務,並將 CDS 檢視區塊公開為 OData 服務。
- 任何自訂 OData 服務都必須支援
$top、$skip和$count查詢。外掛程式可透過這些查詢分割資料,以便循序和並行擷取資料。如果使用,也必須支援$filter、$expand或$select查詢。
設定 Cloud Data Fusion
確認 Cloud Data Fusion 執行個體與 SAP 伺服器之間的通訊已啟用。如果是私有執行個體,請設定網路對等互連。與 SAP 系統代管專案建立網路對等互連後,您無須進行額外設定,即可連線至 Cloud Data Fusion 執行個體。SAP 系統和 Cloud Data Fusion 執行個體都必須位於同一個專案中。
步驟 1:設定 Cloud Data Fusion 環境
如要為外掛程式設定 Cloud Data Fusion 環境,請按照下列步驟操作:
前往執行個體詳細資料:
在 Google Cloud 控制台中,前往 Cloud Data Fusion 頁面。
按一下「Instances」(執行個體) ,然後點選執行個體名稱,前往「Instance details」(執行個體詳細資料) 頁面。
確認執行個體已升級至 6.4.0 以上版本。如果執行個體是舊版,請升級。
按一下「查看執行個體」。Cloud Data Fusion UI 開啟後,按一下「中樞」。
依序選取「SAP」分頁標籤 >「SAP OData」。
如果沒有看到「SAP」分頁,請參閱「排解 SAP 整合問題」。
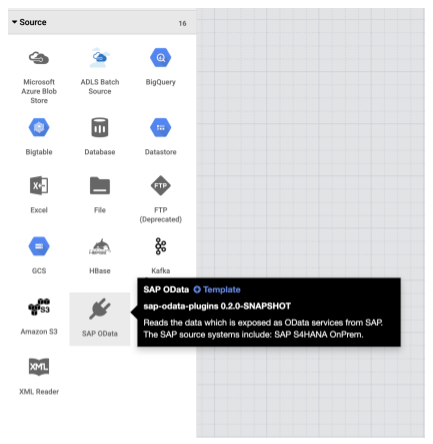
按一下「Deploy SAP OData Plugin」(部署 SAP OData 外掛程式)。
外掛程式現在會顯示在 Studio 頁面的「來源」選單中。
步驟 2:設定外掛程式
SAP OData 外掛程式會讀取 SAP DataSource 的內容。
如要篩選記錄,您可以在「SAP OData Properties」頁面中設定下列屬性。
| 屬性名稱 | 說明 |
|---|---|
| 基本版 | |
| 參照名稱 | 用於明確識別這個來源的名稱,以利處理歷程或註解中繼資料。 |
| SAP OData 基礎網址 | SAP Gateway OData 基準網址 (使用完整網址路徑,類似於 https://ADDRESS:PORT/sap/opu/odata/sap/)。 |
| OData 版本 | 支援的 SAP OData 版本。 |
| 服務名稱 | 要從中擷取實體的 SAP OData 服務名稱。 |
| 實體名稱 | 要擷取的實體名稱,例如 Results。你可以使用前置字串,例如 C_PurchaseOrderItemMoni/Results。這個欄位支援「類別」和「實體」參數。示例:
|
| 憑證* | |
| SAP 類型 | 基本 (透過使用者名稱和密碼)。 |
| SAP 登入使用者名稱 | SAP 使用者名稱 建議:如果 SAP 登入使用者名稱會定期變更,請使用 巨集。 |
| SAP 登入密碼 | SAP 使用者密碼 建議做法:針對密碼等機密值,使用 安全巨集。 |
| SAP X.509 用戶端憑證 (請參閱「 在 SAP NetWeaver 應用程式伺服器上使用 X.509 用戶端憑證 (適用於 ABAP)」一文)。 |
|
| GCP 專案 ID | 專案的全域專屬 ID。如果「X.509 憑證 Cloud Storage 路徑」欄位未包含巨集值,則必須填寫這個欄位。 |
| GCS 路徑 | 包含使用者上傳 X.509 憑證的 Cloud Storage bucket 路徑,對應於 SAP 應用程式伺服器,可根據您的需求進行安全呼叫 (請參閱「確保連線安全」步驟)。 |
| 通關密語 | 與提供的 X.509 憑證相符的密碼。 |
| 「取得結構定義」按鈕 | 根據 SAP 的中繼資料產生結構定義,並自動將 SAP 資料型別對應至相應的 Cloud Data Fusion 資料型別 (與「驗證」按鈕的功能相同)。 |
| [進階] | |
| 篩選器選項 | 指出欄位必須具有的值,才能讀取。使用這個篩選條件可限制輸出資料量。例如:`Price Gt 200` 會選取 `Price` 欄位值大於 `200` 的記錄。(請參閱「取得 SAP 目錄服務的可篩選欄清單」一文)。 |
| 選取欄位 | 要保留在擷取資料中的欄位 (例如:類別、價格、名稱、供應商/地址)。 |
| 展開欄位 | 要在擷取的輸出資料中展開的複雜欄位清單 (例如:產品/供應商)。 |
| 要略過的列數 | 要略過的總列數 (例如 10)。 |
| 要擷取的列數 | 要擷取的總列數。 |
| 要產生的分割數量 | 用於分割輸入資料的分割數。增加分割區可提高平行處理程度,但需要更多資源和額外負擔。 如果留空,外掛程式會選擇最佳值 (建議)。 |
| 批次大小 | 每次對 SAP 進行網路呼叫時要擷取的資料列數。如果大小過小,就會導致網路呼叫頻繁,重複相關聯的額外負荷。如果大小過大,可能會導致 SAP 擷取資料的速度變慢,並造成資源用量過高。如果值設為 0,預設值為 2500,且每個批次要擷取的資料列數上限為 5000。 |
| 讀取逾時 | 等待 SAP OData 服務的時間 (以秒為單位)。預設值為 300。如要設為不限時間,請選取 0。 |
支援的 OData 類型
下表顯示 SAP 應用程式使用的 OData v2 資料類型與 Cloud Data Fusion 資料類型之間的對應關係。
| OData 類型 | 說明 (SAP) | Cloud Data Fusion 資料類型 |
|---|---|---|
| 數字 | ||
| SByte | 帶正負號的 8 位元整數值 | int |
| Byte | 不帶正負號的 8 位元整數值 | int |
| Int16 | 帶正負號的 16 位元整數值 | int |
| Int32 | 帶正負號的 32 位元整數值 | int |
| Int64 | 帶正負號的 64 位元整數值,並附加「L」字元 範例: 64L、-352L |
long |
| 單一 | 精確度為 7 位數的浮點數,可表示的值範圍約為 ± 1.18e -38 到 ± 3.40e +38,並附加字元「f」 範例: 2.0f |
float |
| 雙精度值 | 浮點數,精確度為 15 位數,可表示的值約為 ± 2.23e -308 到 ± 1.79e +308,並附加字元「d」 範例: 1E+10d、2.029d、2.0d |
double |
| 小數 | 具有固定精確度和比例的數值,描述介於負 10^255 + 1 到正 10^255 -1 之間的數值,並附加字元「M」或「m」 範例: 2.345M |
decimal |
| 字元 | ||
| Guid | 16 位元組 (128 位元) 的專屬 ID 值,開頭為「guid」字元: 範例: guid'12345678-aaaa-bbbb-cccc-ddddeeeeffff' |
string |
| 字串 | 以 UTF-8 編碼的固定或變數長度字元資料 | string |
| Byte | ||
| 二進位檔 | 固定或變數長度的二進位資料,開頭為「X」或「binary」(兩者皆區分大小寫) 範例: X'23AB'、binary'23ABFF' |
bytes |
| 邏輯 | ||
| 布林值 | 二元值邏輯的數學概念 | boolean |
| 日期/時間 | ||
| 日期/時間 | 日期和時間,值介於 1753 年 1 月 1 日上午 12:00:00 至 9999 年 12 月 31 日下午 11:59:59 | timestamp |
| 時間 | 一天中的時間,值介於 0:00:00.x 到 23:59:59.y 之間,其中「x」和「y」取決於精確度 | time |
| DateTimeOffset | 日期和時間 (以格林威治標準時間為準,以分鐘為單位),值範圍為 1753 年 1 月 1 日凌晨 12:00:00 至 9999 年 12 月 31 日晚上 11:59:59 | timestamp |
| 複雜 | ||
| 導覽和非導覽屬性 (多重性 = *) | 某類型的集合,多重性為一對多。 | array、string、int。 |
| 屬性 (多重性 = 0.1) | 參照多重性為一對一的其他複雜型別 | record |
驗證
按一下右上方的「驗證」或「取得結構化資料」。
外掛程式會驗證屬性,並根據 SAP 的中繼資料產生結構定義。系統會自動將 SAP 資料類型對應至相應的 Cloud Data Fusion 資料類型。
執行資料管道
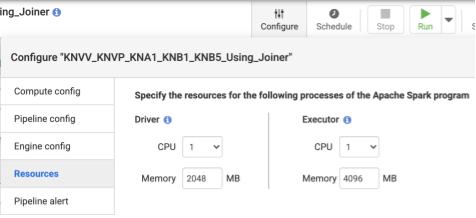
- 部署管道後,按一下頂端中央面板的「設定」。
- 選取「資源」。
- 如有需要,請根據整體資料大小和管道中使用的轉換次數,變更 Executor CPU 和記憶體。
- 按一下 [儲存]。
- 如要啟動資料管道,請按一下「執行」。
效能
外掛程式會使用 Cloud Data Fusion 的平行化功能。您可以參考下列指南設定執行階段環境,為執行階段引擎提供充足資源,以達到預期的平行處理程度和效能。
最佳化外掛程式設定
建議:除非您熟悉 SAP 系統的記憶體設定,否則請將「Number of Splits to Generate」(要產生的分割數) 和「Batch Size」(批次大小) 留空 (未指定)。
如要在執行管道時獲得更佳效能,請使用下列設定:
要產生的分割數:建議使用
8到16之間的值。但只要在 SAP 端進行適當設定 (為 SAP 中的工作程序分配適當的記憶體資源),這些值就能增加到32,甚至是64。這項設定可提升 Cloud Data Fusion 端的平行處理能力。執行階段引擎會在擷取記錄時,建立指定數量的分區 (和 SAP 連線)。如果設定服務 (匯入 SAP 傳輸檔案時會隨外掛程式一併匯入) 可用,外掛程式會預設使用 SAP 系統的設定。分割比例為 SAP 中可用對話工作程序的 50%。注意:設定服務只能從 S4HANA 系統匯入。
如果無法使用 Configuration Service,預設值為
7splits。無論是哪種情況,如果您指定不同的值,系統都會採用您提供的值,而非預設分割值,但上限為 SAP 中可用的對話程序,減去兩個分割。
如果要擷取的記錄數量少於
2500,則分割次數為1。
批次大小:這是指每次對 SAP 進行網路呼叫時要擷取的記錄數量。如果批量較小,就會頻繁發出網路呼叫,重複相關的額外負擔。預設的最低數量為
1000,最高數量為50000。
詳情請參閱「OData 實體限制」。
Cloud Data Fusion 資源設定
建議: 每個執行器使用 1 個 CPU 和 4 GB 記憶體 (這個值適用於每個執行器程序)。在「設定」>「資源」對話方塊中設定這些項目。
Managed Service for Apache Spark 叢集設定
建議: 至少要分配的 CPU 總數 (跨工作站) 大於預期的分割數 (請參閱「外掛程式設定」)。
在 Managed Service for Apache Spark 設定中,每個 CPU 必須分配 6.5 GB 以上的記憶體 (這表示每個 Cloud Data Fusion 執行器可用的記憶體為 4 GB 以上)。其他設定則可保留預設值。
建議: 使用持續性 Apache Spark 代管服務叢集,縮短資料管道執行時間 (這會消除佈建步驟,可能需要幾分鐘以上)。在 Compute Engine 設定部分中設定此項目。
範例設定和輸送量
以下各節說明範例開發和正式版設定,以及處理量。
開發和測試設定範例
- Managed Service for Apache Spark 叢集,內含 8 個工作站,每個工作站有 4 個 CPU 和 26 GB 記憶體。最多可產生 28 個分割畫面。
- Managed Service for Apache Spark 叢集,內含 2 個工作站,每個工作站有 8 個 CPU 和 52 GB 記憶體。最多可生成 12 個分割畫面。
實際工作環境設定和處理量範例
- Managed Service for Apache Spark 叢集,內含 8 個工作站,每個工作站有 8 個 CPU 和 32 GB 記憶體。最多可產生 32 個分割畫面 (可用 CPU 的一半)。
- Managed Service for Apache Spark 叢集,內含 16 個工作站,每個工作站有 8 個 CPU 和 32 GB 記憶體。最多可產生 64 個分割畫面 (可用 CPU 的一半)。
SAP S4HANA 1909 實際運作來源系統的樣本輸送量
下表列出處理量範例。除非另有指定,否則顯示的總處理量不含篩選選項。使用篩選器選項時,輸送量會減少。
| 批量 | 分段 | OData 服務 | 總列數 | 擷取的列數 | 處理量 (每秒資料列數) |
|---|---|---|---|---|---|
| 1000 | 4 | ZACDOCA_CDS | 537 萬 | 537 萬 | 1069 |
| 2500 | 10 | ZACDOCA_CDS | 537 萬 | 537 萬 | 3384 |
| 5000 | 8 | ZACDOCA_CDS | 537 萬 | 537 萬 | 4630 |
| 5000 | 9 | ZACDOCA_CDS | 537 萬 | 537 萬 | 4817 |
SAP S4HANA 雲端實際運作來源系統的樣本輸送量
| 批量 | 分段 | OData 服務 | 總列數 | 擷取的列數 | 處理量 (GB/小時) |
|---|---|---|---|---|---|
| 2500 | 40 | TEST_04_UOM_ODATA_CDS/ | 2.01 億 | 10 M | 25.48 |
| 5000 | 50 | TEST_04_UOM_ODATA_CDS/ | 2.01 億 | 10 M | 26.78 |
支援詳情
這個外掛程式支援下列用途。
支援的 SAP 產品和版本
支援的來源包括 SAP S4/HANA 1909 以上版本、SAP 雲端上的 S4/HANA,以及任何可公開 OData 服務的 SAP 應用程式。
您必須在 S4/HANA 1909 以上版本中,匯入包含自訂 OData 服務的傳輸檔案,才能平衡對 SAP 的呼叫。這項服務可協助計算外掛程式可平行讀取的分割數 (資料分割) (請參閱「分割數」)。
支援 OData 第 2 版。
我們已在 Google Cloud上部署的 SAP S/4HANA 伺服器測試過這個外掛程式。
支援擷取 SAP OData 目錄服務
外掛程式支援下列 DataSource 類型:
- 交易資料
- 透過 OData 公開的 CDS 檢視畫面
主要資料
- 屬性
- 文字
- 階層
SAP 附註
擷取資料前不需要 SAP 注意事項,但 SAP 系統必須提供 SAP Gateway。詳情請參閱附註 1560585 (這個外部網站需要 SAP 登入)。
資料量或記錄寬度超出限制
系統不會限制擷取的資料量。我們已測試過,單次呼叫最多可擷取 600 萬列,記錄寬度為 1 KB。對於雲端上的 SAP S4/HANA,我們已測試過一次呼叫最多可擷取 1 千萬列資料,記錄寬度為 1 KB。
預期的外掛程式處理量
如果環境是按照「效能」一節的指南設定,外掛程式每小時可擷取約 38 GB 的資料。實際效能可能會因 Cloud Data Fusion 和 SAP 系統負載或網路流量而異。
差異 (變更的資料) 擷取
不支援差異擷取。
錯誤情況
在執行階段,外掛程式會在 Cloud Data Fusion 資料管道記錄中寫入記錄項目。這些項目會加上 CDF_SAP 前置字元,方便識別。
在設計階段驗證外掛程式設定時,系統會在「屬性」分頁中顯示訊息,並以紅色醒目顯示。
以下列出部分錯誤:
| 郵件 ID | 訊息 | 建議做法 |
|---|---|---|
| 無 | Required property 'CONNECTION_PROPERTY' for connection
type 'CONNECTION_PROPERTY_SETTING'. |
輸入實際值或巨集變數。 |
| 無 | Invalid value for property 'PROPERTY_NAME'. |
請輸入非負整數 (大於或等於 0,不含小數) 或巨集變數。 |
| CDF_SAP_ODATA_01505 | Failed to prepare the Cloud Data Fusion output schema. Please
check the provided runtime macros value. |
確認提供的巨集值正確無誤。 |
| 不適用 | SAP X509 certificated 'STORAGE_PATH' is missing. Please
make sure the required X509 certificate is uploaded to your specified
Cloud Storage bucket 'BUCKET_NAME'. |
確認提供的 Cloud Storage 路徑正確無誤。 |
| CDF_SAP_ODATA_01532 | 與 SAP OData 連線問題相關的任何一般錯誤碼Failed to call given SAP OData service. Root Cause:
MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01534 | 與 SAP OData 服務錯誤相關的一般錯誤代碼。Service validation failed. Root Cause: MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01503 | Failed to fetch total available record count from
SAP_ODATA_SERVICE_ENTITY_NAME. Root Cause: MESSAGE.
|
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01506 | No records found to extract in
SAP_ODATA_SERVICE_ENTITY_NAME.
Please ensure that the provided entity contains records. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01537 | Failed to process records for
SAP_ODATA_SERVICE_ENTITY_NAME.
Root Cause: MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01536 | Failed to pull records from
SAP_ODATA_SERVICE_ENTITY_NAME. Root Cause:
MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01504 | Failed to generate the encoded metadata string for the given OData
service SAP_ODATA_SERVICE_NAME. Root Cause:
MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
| CDF_SAP_ODATA_01533 | Failed to decode the metadata from the given encoded metadata
string for service SAP_ODATA_SERVICE_NAME. Root Cause:
MESSAGE. |
查看訊息中顯示的根本原因,並採取適當行動。 |
後續步驟
- 進一步瞭解 Cloud Data Fusion。
- 進一步瞭解 SAP on Google Cloud。