


Cloud Data Fusion 的轉換下推功能可讓您在 BigQuery (而非 Spark) 中執行管道轉換。直接在 BigQuery 中執行轉換,有助於提高管道執行速度,並最佳化運算資源成本。
詳情請參閱「轉換下推總覽」。
事前準備
轉換下推功能適用於 6.5.0 以上版本。如果管道在舊版環境中執行,可以將執行個體升級至最新版本。
在管道啟用轉換下推
控制台
如要為已部署的管道啟用轉換下推功能,請按照下列步驟操作:
前往執行個體:
在 Google Cloud 控制台中,前往 Cloud Data Fusion 頁面。
如要在 Cloud Data Fusion Studio 中開啟執行個體,請依序按一下「Instances」和「View instance」。
依序按一下 「選單」 > 「清單」。
已部署的管道分頁隨即開啟。
按一下要開啟的已部署管道,在 Pipeline Studio 中開啟。
依序點選「Configure」(設定) >「Transformation Pushdown」(轉換下推)。
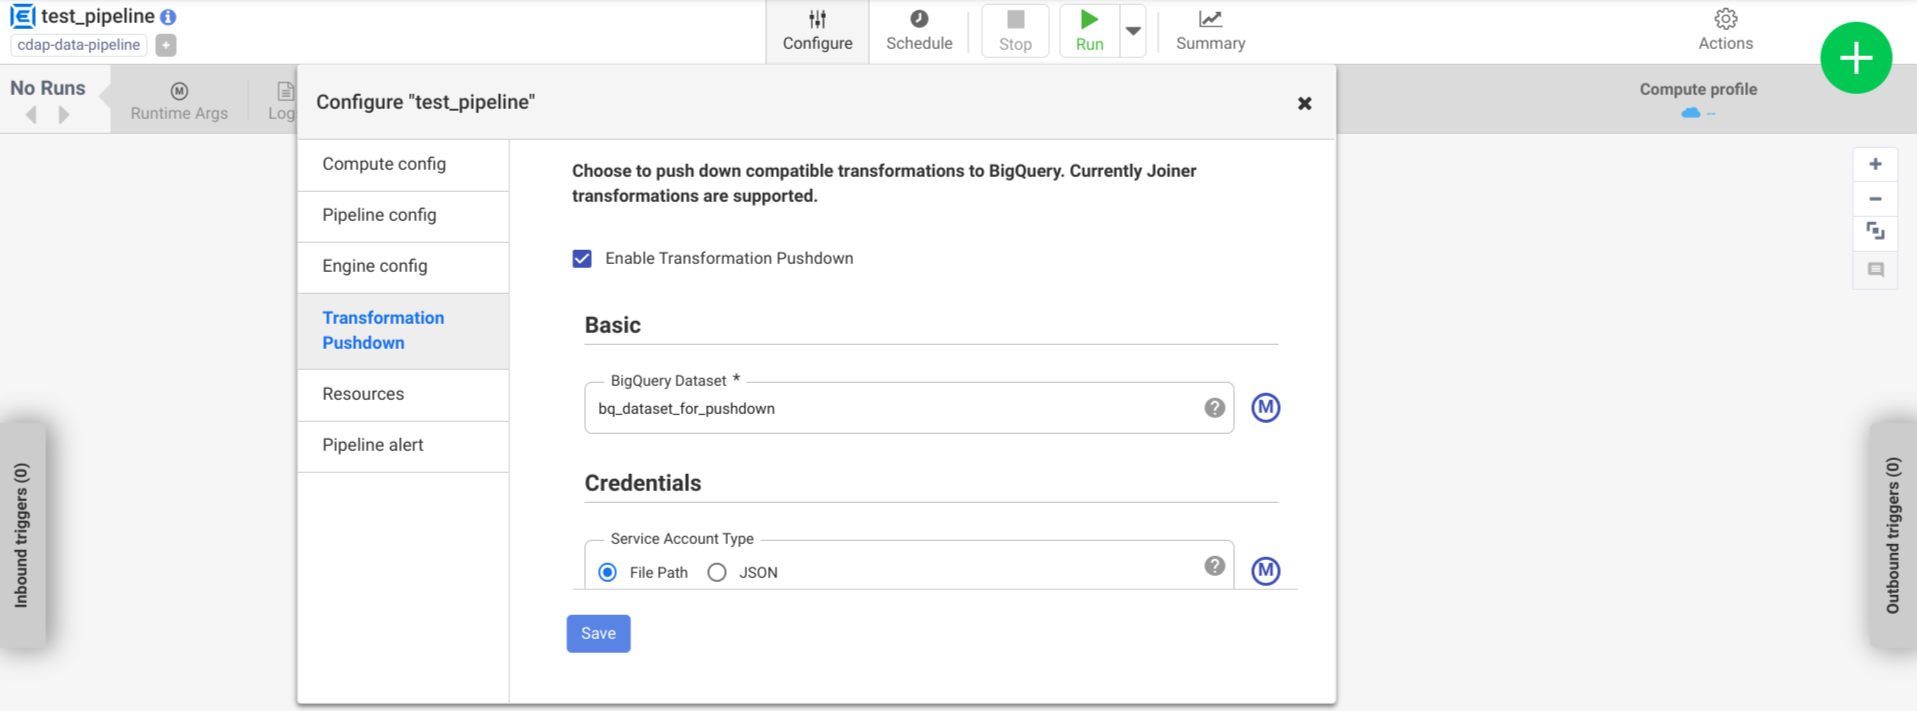
按一下「Enable Transformation Pushdown」(啟用轉換下推)。
在「Dataset」(資料集) 欄位中,輸入 BigQuery 資料集名稱。
選用:如要使用巨集,請按一下「M」。詳情請參閱「資料集」。
選用:視需要調整選項。
按一下 [儲存]。
選用設定
.| 屬性 | 支援巨集 | 支援的 Cloud Data Fusion 版本 | 說明 |
|---|---|---|---|
| 使用連線 | 否 | 6.7.0 以上版本 | 是否使用現有連線。 |
| 連線 | 是 | 6.7.0 以上版本 | 連線名稱。這個連線會提供專案和服務帳戶資訊。 選用:使用巨集函式 ${conn(connection_name)}。 |
| 資料集專案 ID | 是 | 6.5.0 | 如果資料集與 BigQuery 工作執行的專案不同,請輸入資料集的專案 ID。如未提供值,系統預設會使用執行工作的專案 ID。 |
| 專案 ID | 是 | 6.5.0 | Google Cloud 專案 ID。 |
| 服務帳戶類型 | 是 | 6.5.0 | 選取下列其中一個選項:
|
| 服務帳戶檔案路徑 | 是 | 6.5.0 | 本機檔案系統中,用於授權的服務帳戶金鑰路徑。在 Managed Service for Apache Spark 叢集上執行時,這個值會設為 auto-detect。在其他叢集上執行時,叢集中的每個節點都必須有這個檔案。預設為 auto-detect。 |
| 服務帳戶 JSON | 是 | 6.5.0 | 服務帳戶 JSON 檔案的內容。 |
| 臨時 bucket 名稱 | 是 | 6.5.0 | 儲存暫存資料的 Cloud Storage bucket。如果不存在,系統會自動建立,但不會自動刪除。Cloud Storage 資料載入 BigQuery 後就會刪除。如未提供這個值,系統會建立專屬 bucket,並在管道執行完畢後刪除。服務帳戶必須具備在設定的專案中建立 bucket 的權限。 |
| 位置 | 是 | 6.5.0 | 建立 BigQuery 資料集的位置。如果資料集或臨時 bucket 已存在,系統會忽略這個值。預設值為 US 多區域。 |
| 加密金鑰名稱 | 是 | 6.5.1/0.18.1 | 客戶自行管理的加密金鑰 (CMEK),用於加密外掛程式建立的任何 bucket、資料集或資料表寫入的資料。如果 bucket、資料集或資料表已存在,系統會忽略這個值。 |
| 完成後保留 BigQuery 資料表 | 是 | 6.5.0 | 是否要保留管道執行期間建立的所有 BigQuery 臨時資料表,以便偵錯及驗證。預設為「No」(否)。 |
| 臨時資料表存留時間 (以小時為單位) | 是 | 6.5.0 | 設定 BigQuery 臨時資料表的存留時間 (以小時為單位)。如果管道取消且清除程序中斷 (例如執行叢集突然關閉),這項功能可做為安全防護機制。將這個值設為 0,即可停用資料表存留時間。預設值為 72 (3 天)。 |
| 工作優先順序 | 是 | 6.5.0 | 執行 BigQuery 工作的優先順序。選取下列其中一個選項:
|
| 強制下推的階段 | 是 | 6.7.0 | 一律在 BigQuery 中執行的支援階段。每個階段名稱必須單獨一行。 |
| 略過下推的階段 | 是 | 6.7.0 | 不應在 BigQuery 執行的支援階段。每個階段名稱都必須位於獨立的一行。 |
| 使用 BigQuery Storage Read API | 是 | 6.7.0 | 在管道執行期間,是否要使用 BigQuery Storage Read API 從 BigQuery 擷取記錄。這個選項可以提升轉換下推的效能,但會產生額外費用。執行環境必須安裝 Scala 2.12。 |
監控記錄中的成效變化
管道執行階段記錄包含訊息,顯示在 BigQuery 中執行的 SQL 查詢。您可以監控哪些階段的資料會推送至 BigQuery。
以下範例顯示管道執行作業開始時的記錄項目。記錄顯示,管道中的 JOIN 作業已推送至 BigQuery 執行:
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'Users' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'Users'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'UserPurchases' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'Purchases'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'UserPurchases'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'MostPopularNames' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'FirstNameCounts'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'MostPopularNames'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@193] - Starting pull for dataset 'MostPopularNames'
以下範例顯示下推執行作業中,各個資料集會指派的資料表名稱:
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset Purchases stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserDetails stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset FirstNameCounts stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserProfile stored in table <TABLE_ID>
隨著執行作業繼續進行,記錄會顯示推送階段完成,最後執行 JOIN 作業。例如:
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@235] - Executing join operation for dataset Users
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@118] - Creating table `<TABLE_ID>` using job: <JOB_ID> with SQL statement: SELECT `UserDetails`.id AS `id` , `UserDetails`.first_name AS `first_name` , `UserDetails`.last_name AS `last_name` , `UserDetails`.email AS `email` , `UserProfile`.phone AS `phone` , `UserProfile`.profession AS `profession` , `UserProfile`.age AS `age` , `UserProfile`.address AS `address` , `UserProfile`.score AS `score` FROM `your_project.your_dataset.<DATASET_ID>` AS `UserProfile` LEFT JOIN `your_project.your_dataset.<DATASET_ID>` AS `UserDetails` ON `UserProfile`.id = `UserDetails`.id
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@151] - Created BigQuery table `<TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@245] - Executed join operation for dataset Users
所有階段都完成後,系統會顯示訊息,指出 Pull 作業已完成。這表示 BigQuery Export 程序已觸發,且這項匯出工作開始後,記錄就會開始讀入管道。例如:
DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@196] - Completed pull for dataset 'MostPopularNames'
如果管道執行時發生錯誤,記錄中會說明錯誤。
如要瞭解 BigQuery JOIN 作業的執行詳情,例如資源使用率、執行時間和錯誤原因,您可以使用工作記錄中顯示的工作 ID 查看 BigQuery 工作資料。
查看管道指標
如要進一步瞭解 Cloud Data Fusion 為在 BigQuery 中執行的管道部分提供的指標,請參閱「BigQuery 下推管道指標」。
後續步驟
- 進一步瞭解 Cloud Data Fusion 中的轉換下推。