


Memahami performa
Halaman ini menjelaskan perkiraan performa yang dapat diberikan Bigtable dalam kondisi optimal, faktor yang dapat memengaruhi performa, serta tips untuk menguji dan memecahkan masalah performa Bigtable.
Performa untuk workload umum
Bigtable memberikan performa yang sangat dapat diprediksi dan dapat diskalakan secara linear. Jika Anda menghindari penyebab performa yang lebih lambat yang dijelaskan di halaman ini, setiap node Bigtable dapat memberikan perkiraan throughput berikut, bergantung pada jenis penyimpanan yang digunakan cluster:
| Paket penyimpanan | Baca | Tulis | Pemindaian | ||
|---|---|---|---|---|---|
| Tingkat dalam memori (Pratinjau) | hingga 120.000 baris per detik1 | atau | hingga 10.000 baris per detik2 | T/A | |
| SSD | hingga 17.000 baris per detik | atau | hingga 14.000 baris per detik | atau | hingga 220 MBps |
| HDD | hingga 500 baris per detik | atau | hingga 10.000 baris per detik | atau | hingga 180 MBps |
| Penyimpanan akses jarang | hingga 100 baris per detik | atau | hingga 10.000 baris per detik | atau | hingga 36 MBps |
Estimasi ini mengasumsikan setiap baris berisi 1 KB.
1 Node Enterprise Plus mencakup 40.000 baris per detik dan dapat diskalakan secara vertikal hingga 120.000 baris per detik per node dalam kelipatan 40.000. Untuk informasi selengkapnya, lihat Paket dalam memori.
2 Penulisan baris per detik yang tinggi ke data di tingkat dalam memori dapat memengaruhi throughput tulis.
Secara umum, performa cluster diskalakan secara linear saat Anda menambahkan node ke cluster. Misalnya, jika Anda membuat cluster SSD dengan 10 node, cluster tersebut dapat mendukung hingga 140.000 baris per detik untuk workload hanya baca atau hanya tulis standar tanpa mengaktifkan tingkat dalam memori. Dengan mengaktifkan tingkat dalam memori, cluster dapat mendukung throughput baca hingga 1,2 juta baris per detik.
Merencanakan kapasitas Bigtable Anda
Saat merencanakan cluster Bigtable, tentukan apakah Anda ingin mengoptimalkan latensi atau throughput. Misalnya, untuk tugas pemrosesan data batch, Anda mungkin lebih mementingkan throughput daripada latensi. Sebaliknya, untuk layanan online yang melayani permintaan pengguna, Anda mungkin memprioritaskan latensi yang lebih rendah daripada throughput. Anda dapat mencapai angka di bagian Performa untuk workload umum saat mengoptimalkan throughput.
Paket dalam memori
Dengan mengaktifkan paket dalam memori, setiap node menyertakan 40.000 baris per detik. Menambahkan node secara horizontal akan meningkatkan total kapasitas cluster. Selain itu, setiap node dapat diskalakan secara vertikal hingga maksimum 120.000 baris per detik per node untuk mendukung throughput baca dalam memori. Saat batas penskalaan vertikal tercapai, penskalaan otomatis Bigtable akan menambahkan node tambahan untuk melakukan penskalaan secara horizontal. Cluster dengan penskalaan manual mendukung penskalaan vertikal dalam memori hingga kapasitas throughput tercapai. Penskalaan vertikal di atas batas dasar 40.000 baris per detik ditagih dengan menerapkan pengali pada biaya per jam node. Untuk informasi selengkapnya, buka Harga.
Setiap node dalam memori mencakup kapasitas penyimpanan sebesar 8 GB. Meskipun throughput dapat diskalakan secara vertikal, kapasitas penyimpanan tetap per node. Namun, penskalaan horizontal menambahkan memori tambahan sebesar 8 GB untuk setiap node baru. Karena penyimpanan tidak meningkat selama penskalaan vertikal, rasio kegagalan workload dapat meningkat saat node menskalakan throughput dalam memorinya secara vertikal.
Pemakaian CPU
Dalam hampir semua kasus, sebaiknya gunakan penskalaan otomatis, yang memungkinkan Bigtable menambahkan atau menghapus node berdasarkan penggunaan. Untuk mengetahui informasi selengkapnya, lihat Penskalaan otomatis.
Gunakan panduan berikut saat mengonfigurasi target penskalaan otomatis atau jika Anda memilih alokasi node manual. Panduan ini berlaku terlepas dari jumlah cluster yang dimiliki instance Anda. Untuk cluster dengan alokasi node manual, Anda harus memantau pemakaian CPU cluster dengan tujuan menjaga pemakaian CPU di bawah nilai ini untuk performa yang optimal.
| Sasaran pengoptimalan | Pemakaian CPU maksimum |
|---|---|
| Throughput | 90% |
| Latensi | 60% |
Untuk mengetahui informasi selengkapnya tentang pemantauan, lihat Pemantauan.
Pemanfaatan penyimpanan
Penyimpanan adalah pertimbangan lain dalam perencanaan kapasitas. Kapasitas penyimpanan cluster ditentukan oleh jenis penyimpanan dan jumlah node dalam cluster. Saat jumlah data yang disimpan dalam cluster meningkat, Bigtable mengoptimalkan penyimpanan dengan mendistribusikan data ke semua node dalam cluster.
Saat memperkirakan persyaratan penyimpanan dan jumlah node cluster untuk perencanaan kapasitas, dasarkan penghitungan Anda pada ukuran data terkompresi yang diharapkan, bukan data sumber yang tidak dikompresi. Bigtable mengompresi data secara otomatis saat menulis ke penyimpanan. Bergantung pada desain skema dan pola data Anda, kompresi dapat mengurangi jejak penyimpanan fisik di disk secara signifikan. Untuk panduan tentang kompresibilitas data, lihat Kompresi data.
Anda dapat menentukan penggunaan penyimpanan per node dengan membagi penggunaan penyimpanan (byte) cluster dengan jumlah node dalam cluster. Misalnya, pertimbangkan cluster yang memiliki tiga node HDD dan data sebesar 9 TB. Setiap node menyimpan sekitar 3 TB, yang merupakan 18,75% dari penyimpanan HDD per batas node sebesar 16 TB.
Saat pemakaian penyimpanan meningkat, workload dapat mengalami peningkatan latensi pemrosesan kueri meskipun cluster memiliki cukup node untuk memenuhi kebutuhan CPU secara keseluruhan. Hal ini karena makin tinggi penyimpanan per node, makin banyak pekerjaan latar belakang seperti pengindeksan yang diperlukan. Peningkatan tugas latar belakang untuk menangani lebih banyak penyimpanan dapat mengakibatkan latensi yang lebih tinggi dan throughput yang lebih rendah.
Mulailah dengan hal berikut saat mengonfigurasi setelan penskalaan otomatis. Jika Anda memilih alokasi node manual, pantau pemakaian penyimpanan cluster dan tambahkan atau hapus node untuk mempertahankan hal berikut.
| Sasaran pengoptimalan | Pemakaian penyimpanan maksimum |
|---|---|
| Throughput | 70% |
| Latensi | 60% |
Untuk mengetahui informasi selengkapnya, lihat Penyimpanan per node.
Menjalankan workload Anda di Bigtable
Selalu jalankan workload Anda terhadap cluster Bigtable saat melakukan perencanaan kapasitas untuk menentukan alokasi resource terbaik bagi aplikasi Anda.
PerfKit Benchmarker Google menggunakan YCSB untuk mengukur layanan cloud. Anda dapat mengikuti tutorial PerfKitBenchmarker untuk Bigtable guna membuat pengujian untuk workload Anda. Saat melakukannya, sesuaikan parameter dalam file YAML konfigurasi tolok ukur untuk memastikan tolok ukur yang dihasilkan mencerminkan karakteristik produksi berikut:
- Ukuran total tabel Anda (proporsional, tetapi minimal 100 GB).
- Bentuk data baris (ukuran row key, jumlah kolom, ukuran data baris, dll.)
- Pola akses data (distribusi row key)
- Campuran operasi baca dan tulis
Lihat Menguji performa dengan Bigtable untuk mengetahui praktik terbaik lainnya.
Penyebab performa yang lebih lambat
Faktor-faktor berikut dapat menyebabkan Bigtable berperforma lebih lambat dari perkiraan:
- Anda membaca sejumlah besar row key atau rentang baris yang tidak berurutan dalam satu permintaan baca. Bigtable memindai tabel dan membaca baris yang diminta secara berurutan. Kurangnya paralelisme ini memengaruhi latensi keseluruhan, dan pembacaan yang mencapai hot node dapat meningkatkan latensi tail. Lihat Pembacaan dan performa untuk mengetahui detailnya.
- Skema tabel Anda tidak dirancang dengan benar. Untuk mendapatkan performa yang baik dari Bigtable, Anda harus mendesain skema yang memungkinkan distribusi pembacaan dan penulisan secara merata di setiap tabel. Selain itu, hotspot di satu tabel dapat memengaruhi performa tabel lain dalam instance yang sama. Lihat Praktik terbaik desain skema untuk mengetahui informasi selengkapnya.
- Baris dalam tabel Bigtable Anda berisi data dalam jumlah besar. Estimasi performa mengasumsikan bahwa setiap baris berisi 1 KB data. Anda dapat membaca dan menulis data dalam jumlah yang lebih besar per baris, tetapi meningkatkan jumlah data per baris juga akan mengurangi jumlah baris per detik.
- Baris dalam tabel Bigtable Anda berisi sel dalam jumlah yang sangat besar. Bigtable memerlukan waktu untuk memproses setiap sel dalam satu baris. Selain itu, setiap sel menambahkan beberapa overhead ke jumlah data yang disimpan dalam tabel dan dikirim melalui jaringan. Misalnya, jika Anda menyimpan data sebesar 1 KB (1.024 byte), akan jauh lebih hemat ruang jika data tersebut disimpan dalam satu sel, daripada menyebarkan data ke 1.024 sel yang masing-masing berisi 1 byte. Jika Anda membagi data ke lebih banyak sel daripada yang diperlukan, Anda mungkin tidak akan mendapatkan performa terbaik. Jika baris berisi banyak sel karena kolom berisi beberapa versi data yang diberi stempel waktu, pertimbangkan untuk hanya menyimpan nilai terbaru. Opsi lain untuk tabel yang ada adalah mengirim penghapusan untuk semua versi sebelumnya dengan setiap penulisan ulang.
Cluster tidak memiliki cukup node. Node cluster menyediakan komputasi untuk cluster guna menangani pembacaan dan penulisan yang masuk, melacak penyimpanan, dan melakukan tugas pemeliharaan seperti pemadatan. Anda harus memastikan bahwa cluster Anda memiliki node yang cukup untuk memenuhi batas yang direkomendasikan untuk komputasi dan penyimpanan. Gunakan alat pemantauan untuk memeriksa apakah cluster kelebihan beban.
- Komputasi - Jika CPU cluster Bigtable Anda kelebihan beban, menambahkan lebih banyak node akan meningkatkan performa dengan menyebarkan workload ke lebih banyak node.
- Penyimpanan - Jika penggunaan penyimpanan per node lebih tinggi dari yang direkomendasikan, tambahkan lebih banyak node untuk mempertahankan latensi dan throughput yang optimal, meskipun cluster memiliki CPU yang cukup untuk memproses permintaan. Hal ini karena meningkatkan jumlah penyimpanan per node akan meningkatkan jumlah pekerjaan pemeliharaan latar belakang per node. Untuk mengetahui informasi selengkapnya, lihat Kompromi antara penggunaan penyimpanan dan performa.
Cluster Bigtable baru-baru ini ditingkatkan atau diperkecil skalanya. Setelah penskalaan otomatis meningkatkan jumlah node dalam cluster, perlu waktu hingga 20 menit dalam pemuatan sebelum performa meningkat secara signifikan. Bigtable menskalakan node cluster berdasarkan beban yang dialami.
Saat Anda mengurangi jumlah node dalam cluster untuk memperkecil skala, usahakan untuk tidak mengurangi ukuran cluster lebih dari 10% dalam periode 10 menit untuk meminimalkan lonjakan latensi.
Cluster Bigtable menggunakan disk HDD. Dalam sebagian besar kasus, cluster Anda harus menggunakan disk SSD, yang memiliki performa jauh lebih baik daripada disk HDD. Lihat Memilih antara penyimpanan SSD dan HDD untuk mengetahui detailnya.
Ada masalah dengan koneksi jaringan. Masalah jaringan dapat mengurangi throughput dan menyebabkan operasi baca dan tulis memerlukan waktu lebih lama dari biasanya. Secara khusus, Anda mungkin melihat masalah jika klien Anda tidak berjalan di zona yang sama dengan cluster Bigtable, atau jika klien Anda berjalan di luar Google Cloud.
Anda menggunakan replikasi, tetapi aplikasi Anda menggunakan library klien yang sudah tidak berlaku. Jika Anda mengamati peningkatan latensi setelah mengaktifkan replikasi, pastikan library klien Cloud Bigtable yang digunakan aplikasi Anda sudah yang terbaru. Library klien versi sebelumnya mungkin tidak dioptimalkan untuk mendukung replikasi. Lihat library klien Cloud Bigtable untuk menemukan repositori GitHub library klien Anda, tempat Anda dapat memeriksa versi dan mengupgrade jika perlu.
Anda mengaktifkan replikasi, tetapi tidak menambahkan lebih banyak node ke cluster. Dalam instance yang menggunakan replikasi, setiap cluster harus menangani pekerjaan replikasi selain beban yang diterimanya dari aplikasi. Cluster yang kurang disediakan dapat menyebabkan peningkatan latensi. Anda dapat memverifikasinya dengan memeriksa diagram penggunaan CPU instance di konsol Google Cloud .
Karena workload yang berbeda dapat menyebabkan performa yang bervariasi, lakukan pengujian dengan workload Anda untuk mendapatkan tolok ukur yang paling akurat.
Cold start dan QPS rendah
Cold start dan QPS rendah dapat meningkatkan latensi. Bigtable berperforma terbaik dengan tabel besar yang sering diakses. Oleh karena itu, jika Anda mulai mengirim permintaan setelah periode tidak digunakan (cold start), Anda mungkin akan melihat latensi tinggi saat Bigtable membuat ulang koneksi. Latensi juga lebih tinggi saat QPS rendah.
Jika QPS Anda rendah, atau jika Anda tahu bahwa Anda terkadang akan mengirim permintaan ke tabel Bigtable setelah periode tidak aktif, coba strategi berikut untuk menjaga koneksi tetap aktif dan mencegah latensi tinggi.
- Kirim traffic buatan dengan kecepatan rendah ke tabel setiap saat.
- Konfigurasikan pool koneksi untuk membantu memastikan bahwa QPS yang stabil membuat pool tetap aktif.
Selama periode QPS rendah, jumlah error yang ditampilkan Bigtable lebih relevan daripada persentase operasi yang menampilkan error.
Cold start pada waktu inisialisasi klien. Jika Anda menggunakan versi klien Cloud Bigtable untuk Java yang lebih lama dari versi 2.17.1, Anda dapat mengaktifkan pemuatan ulang saluran. Pada versi yang lebih baru, pemuatan ulang saluran diaktifkan secara default. Pemuatan ulang saluran melakukan dua hal:
- Saat melakukan inisialisasi, klien menyiapkan saluran sebelum mengirim permintaan pertama.
- Server memutuskan koneksi yang berjalan lama setiap jam. Priming saluran secara preemptif menggantikan saluran yang akan habis masa berlakunya.
Namun, hal ini tidak membuat saluran tetap aktif saat ada periode tidak aktif.
Cara Bigtable mengoptimalkan data Anda dari waktu ke waktu
Untuk menyimpan data pokok untuk setiap tabel, Bigtable melakukan sharding data ke dalam beberapa tablet, yang dapat dipindahkan di antara node dalam cluster Bigtable Anda. Metode penyimpanan ini memungkinkan Bigtable menggunakan dua strategi untuk mengoptimalkan data dari waktu ke waktu:
- Bigtable menyimpan jumlah data yang kurang lebih sama di setiap node Bigtable.
- Bigtable mendistribusikan operasi baca dan tulis secara merata ke semua node Bigtable.
Terkadang strategi ini bertentangan. Misalnya, jika baris satu tablet dibaca sangat sering, Bigtable mungkin menyimpan tablet tersebut di nodenya sendiri, meskipun hal ini menyebabkan beberapa node menyimpan lebih banyak data daripada yang lain.
Sebagai bagian dari proses ini, Bigtable mungkin membagi tablet menjadi dua atau beberapa tablet yang lebih kecil untuk mengurangi ukurannya atau untuk mengisolasi baris yang sering diakses dalam tablet yang ada.
Bagian berikut menjelaskan setiap strategi ini secara lebih mendetail.
Mendistribusikan jumlah data di seluruh node
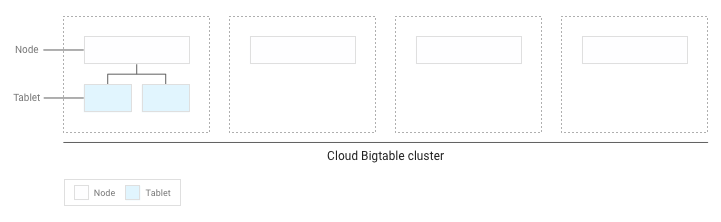
Saat Anda menulis data ke tabel Bigtable, Bigtable akan melakukan sharding data tabel ke dalam tablet. Setiap tablet berisi rentang baris yang berdekatan dalam tabel.
Jika Anda telah menulis data kurang dari beberapa GB ke tabel, Bigtable akan menyimpan semua tablet di satu node dalam cluster Anda:
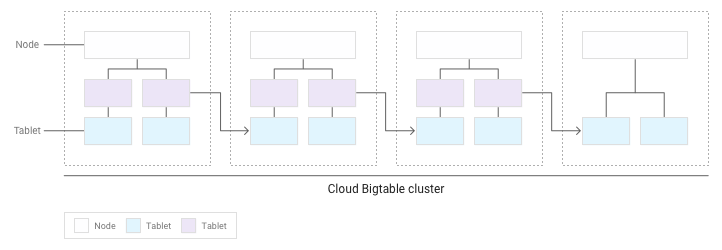
Seiring bertambahnya jumlah tablet, Bigtable memindahkan beberapa tablet ke node lain dalam cluster untuk menyeimbangkan jumlah data secara lebih merata di seluruh cluster:
Mendistribusikan operasi baca dan tulis secara merata di seluruh node
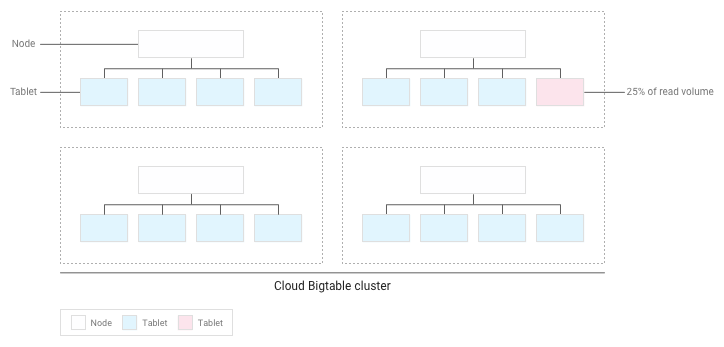
Jika Anda telah mendesain skema dengan benar, operasi baca dan tulis akan didistribusikan secara merata di seluruh tabel. Namun, ada beberapa kasus di mana Anda tidak dapat menghindari akses ke baris tertentu lebih sering daripada baris lainnya. Bigtable membantu Anda menangani kasus ini dengan mempertimbangkan pembacaan dan penulisan saat menyeimbangkan tablet di seluruh node.
Misalnya, anggaplah 25% pembacaan mengarah ke sejumlah kecil tablet dalam sebuah cluster, dan pembacaan tersebar merata di semua tablet lainnya:
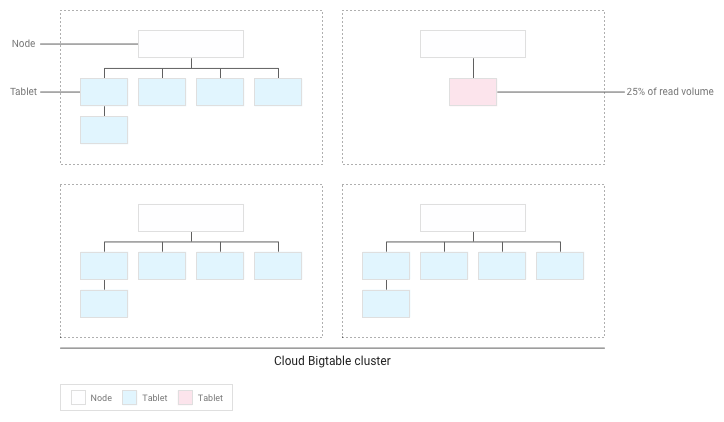
Bigtable akan mendistribusikan ulang tablet yang ada sehingga pembacaan tersebar serata mungkin di seluruh cluster:
Menguji performa dengan Bigtable
Jika Anda menjalankan uji performa untuk aplikasi yang bergantung pada Bigtable, ikuti panduan berikut saat merencanakan dan menjalankan pengujian:
- Lakukan pengujian dengan data yang memadai.
- Jika tabel dalam instance produksi Anda berisi total 100 GB data atau kurang per node, uji dengan tabel yang memiliki jumlah data yang sama.
- Jika tabel berisi lebih dari 100 GB data per node, uji dengan tabel yang berisi setidaknya 100 GB data per node. Misalnya, jika instance produksi Anda memiliki satu cluster empat node, dan tabel dalam instance berisi total 1 TB data, jalankan pengujian menggunakan tabel minimal 400 GB.
- Menguji dengan satu tabel.
- Tetap di bawah penggunaan penyimpanan yang direkomendasikan per node. Untuk mengetahui detailnya, lihat Penggunaan penyimpanan per node.
- Sebelum menguji, jalankan pra-pengujian berat selama beberapa menit. Langkah ini memungkinkan Bigtable menyeimbangkan data di seluruh node berdasarkan pola akses yang diamatinya.
- Jalankan pengujian Anda minimal selama 10 menit. Langkah ini memungkinkan Bigtable mengoptimalkan data Anda lebih lanjut, dan membantu memastikan bahwa Anda akan menguji pembacaan dari disk serta pembacaan yang di-cache dari memori.
- Untuk pengujian tingkat dalam memori (Pratinjau), pastikan durasi pengujian cukup untuk mengisi tingkat dalam memori dengan pembacaan.
Memecahkan masalah performa
Jika Anda merasa Bigtable mungkin menyebabkan bottleneck performa di aplikasi Anda, pastikan untuk memeriksa semua hal berikut:
- Periksa pemindaian Key Visualizer untuk tabel Anda. Alat Key Visualizer untuk Bigtable menghasilkan data pemindaian baru setiap 15 menit yang menunjukkan pola penggunaan untuk setiap tabel dalam cluster. Key Visualizer memungkinkan Anda memeriksa apakah pola penggunaan Anda menyebabkan hasil yang tidak diinginkan, seperti hotspot pada baris tertentu atau penggunaan CPU yang berlebihan. Untuk mengetahui informasi selengkapnya, lihat Menggunakan Key Visualizer.
- Jadikan kode yang menjalankan pembacaan dan penulisan Bigtable sebagai komentar. Jika masalah performa hilang, Anda mungkin menggunakan Bigtable dengan cara yang menghasilkan performa yang kurang optimal. Jika masalah performa tetap ada, masalah ini mungkin tidak berkaitan dengan Bigtable.
Pastikan Anda membuat klien sesedikit mungkin. Membuat klien untuk Bigtable adalah operasi yang relatif mahal. Oleh karena itu, Anda harus membuat jumlah klien sekecil mungkin:
- Jika Anda menggunakan replikasi, atau jika Anda menggunakan profil aplikasi untuk mengidentifikasi berbagai jenis traffic ke instance, buat satu klien per profil aplikasi dan bagikan klien di seluruh aplikasi Anda.
- Jika Anda tidak menggunakan replikasi atau profil aplikasi, buat satu klien dan bagikan ke seluruh aplikasi Anda.
Jika Anda menggunakan klien HBase untuk Java, buat objek
Connection, bukan klien, jadi buat koneksi sesedikit mungkin.Pastikan Anda membaca dan menulis berbagai baris dalam tabel. Bigtable berperforma terbaik saat operasi baca dan tulis didistribusikan secara merata di seluruh tabel, yang membantu Bigtable mendistribusikan workload ke semua node dalam cluster Anda. Jika operasi baca dan tulis tidak dapat didistribusikan ke semua node Bigtable Anda, performa akan menurun.
Jika Anda menyadari bahwa Anda hanya membaca dan menulis baris dalam jumlah kecil, Anda mungkin perlu merancang ulang skema agar pembacaan dan penulisan didistribusikan secara lebih merata.
Pastikan Anda melihat performa yang kurang lebih sama untuk baca dan tulis. Jika Anda mendapati bahwa operasi baca jauh lebih cepat daripada tulis, Anda mungkin mencoba membaca row key yang tidak ada, atau berbagai macam row key yang hanya berisi sedikit baris.
Untuk membuat perbandingan yang valid antara operasi baca dan tulis, usahakan agar minimal 90% operasi baca Anda menampilkan hasil yang valid. Selain itu, jika Anda membaca rentang row key yang besar, ukur performa berdasarkan jumlah baris sebenarnya dalam rentang tersebut, bukan jumlah baris maksimum yang mungkin ada.
Gunakan jenis permintaan tulis yang tepat untuk data Anda. Memilih cara yang optimal untuk menulis data akan membantu mempertahankan performa tinggi.
Periksa latensi untuk satu baris. Jika Anda mengamati latensi yang tidak terduga saat mengirim permintaan
ReadRows, Anda dapat memeriksa latensi baris pertama permintaan untuk mempersempit penyebabnya. Secara default, latensi keseluruhan untuk permintaanReadRowsmencakup latensi untuk setiap baris dalam permintaan serta waktu pemrosesan antarbaris. Jika latensi keseluruhan tinggi, tetapi latensi baris pertama rendah, hal ini menunjukkan bahwa latensi disebabkan oleh jumlah permintaan atau waktu pemrosesan, bukan karena masalah pada Bigtable.Jika menggunakan library klien Bigtable untuk Java, Anda dapat melihat metrik
read_rows_first_row_latencydi Metrics Explorer konsolGoogle Cloud setelah mengaktifkan metrik sisi klien.Gunakan profil aplikasi terpisah untuk setiap workload. Jika Anda mengalami masalah performa setelah menambahkan workload baru, buat profil aplikasi baru untuk workload baru. Kemudian, Anda dapat memantau metrik untuk profil aplikasi secara terpisah guna memecahkan masalah lebih lanjut. Lihat Cara kerja profil aplikasi untuk mengetahui detail alasan penggunaan beberapa profil aplikasi merupakan praktik terbaik.
Aktifkan metrik sisi klien. Anda dapat menyiapkan metrik sisi klien untuk membantu mengoptimalkan dan memecahkan masalah performa. Misalnya, karena Bigtable berfungsi paling baik dengan QPS tinggi yang terdistribusi secara merata, peningkatan latensi P100 (maksimum) untuk sebagian kecil permintaan tidak selalu mengindikasikan masalah performa yang lebih besar pada Bigtable. Metrik sisi klien dapat memberi Anda insight tentang bagian mana dari siklus proses permintaan yang mungkin menyebabkan latensi.
Pastikan aplikasi Anda menggunakan permintaan baca sebelum waktu tunggu habis. Jika aplikasi Anda memproses data selama aliran baca, Anda berisiko mengalami waktu tunggu permintaan habis sebelum menerima semua respons dari panggilan. Hal ini menghasilkan pesan
ABORTED. Jika Anda melihat error ini, kurangi jumlah pemrosesan selama aliran baca.
Konektivitas langsung
Bigtable mendukung konektivitas langsung untuk traffic aplikasi yang memenuhi kriteria tertentu, sehingga mengabaikan frontend Google dan mengoptimalkan performa. Mengupgrade ke library klien versi terbaru untuk memanfaatkan konektivitas langsung dapat meningkatkan throughput dan latensi. Konektivitas langsung disediakan untuk aplikasi dengan karakteristik berikut:
- Berjalan di virtual machine Compute Engine atau Google Kubernetes Engine (GKE) dalam jaringan Virtual Private Cloud (VPC)
- Menggunakan library klien Bigtable yang didukung
- Menggunakan profil aplikasi standar (bukan Data Boost)
- Dalam jaringan yang dikonfigurasi dengan rute dan aturan firewall yang mengizinkan traffic egress
untuk menjangkau
34.126.0.0/18dan2001:4860:8040::/42
Konektivitas langsung didukung dan diaktifkan secara default saat Anda menggunakan salah satu library klien Bigtable berikut:
- Java versi 2.76.0 atau yang lebih baru
- Adaptor HBase versi 2.17.0 atau yang lebih baru
- Go versi 1.50.1 atau yang lebih baru
IPv4 dan IPv6 didukung. Untuk mengetahui informasi selengkapnya, lihat Konektivitas langsung ke API dan layanan dalam dokumentasi VPC.
Langkah berikutnya
- Pelajari cara mendesain skema Bigtable.
- Cari tahu cara memantau performa Bigtable.
- Pelajari cara memecahkan masalah dengan Key Visualizer.
- Pelajari cara memecahkan masalah latensi.
- Lihat kode contoh untuk menambahkan node secara terprogram ke cluster Bigtable.