


Ringkasan Bigtable
Bigtable adalah tabel yang diisi secara tersebar dan dapat diskalakan hingga miliaran baris dan ribuan kolom, sehingga Anda dapat menyimpan data berukuran terabyte atau bahkan petabyte. Bigtable ideal untuk menyimpan data dengan satu kunci dalam jumlah besar dengan latensi rendah. Bigtable mendukung throughput baca dan tulis yang tinggi pada latensi rendah, serta merupakan sumber data yang ideal untuk operasi MapReduce.
Bigtable diekspos ke aplikasi melalui beberapa library klien, termasuk ekstensi yang didukung ke library Apache HBase untuk Java. Hasilnya, Dataproc terintegrasi dengan ekosistem Apache yang ada untuk software big data open source.
Server backend Bigtable yang andal menawarkan beberapa keunggulan utama:
- Skalabilitas yang luar biasa. Bigtable melakukan penskalaan secara proporsional dengan jumlah mesin di cluster Anda. Penginstalan HBase yang dikelola sendiri memiliki bottleneck desain yang membatasi performa setelah batas tertentu tercapai. Bigtable tidak memiliki bottleneck ini, sehingga Anda dapat meningkatkan skala cluster untuk menangani lebih banyak operasi baca dan tulis.
- Administrasi yang sederhana. Bigtable menangani upgrade dan mulai ulang secara transparan, serta otomatis mempertahankan ketahanan data yang tinggi. Untuk mereplikasi data, tambahkan cluster kedua ke instance Anda, dan replikasi akan dimulai secara otomatis. Tidak perlu lagi mengelola replika atau region; cukup desain skema tabel Anda, dan Bigtable akan menangani sisanya untuk Anda.
- Pengubahan ukuran cluster tanpa periode nonaktif. Anda dapat meningkatkan ukuran cluster Bigtable selama beberapa jam untuk menangani beban yang besar, lalu mengurangi ukuran cluster lagi—semuanya tanpa periode nonaktif. Setelah Anda mengubah ukuran cluster, Bigtable biasanya hanya memerlukan waktu beberapa menit dalam kondisi beban untuk menyeimbangkan performa di semua node dalam cluster Anda.
- Penyimpanan bertingkat (Pratinjau). Anda dapat menyimpan data yang jarang diakses di tingkat penyimpanan terpisah yang lebih murah. Penyimpanan bertingkat memungkinkan Anda memilih tingkat penyimpanan yang paling sesuai dengan kebutuhan akses data Bigtable Anda.
- Autoscaling. Anda dapat mengonfigurasi Bigtable untuk terus memantau kapasitas CPU cluster dan otomatis menyesuaikan jumlah node dalam cluster jika diperlukan.
- Uji coba gratis. Anda dapat menjelajahi fitur dan kemampuan Bigtable tanpa biaya selama 10 hari, dengan opsi untuk memperpanjang uji coba gratis hingga 90 hari. Bigtable menyediakan instance Bigtable uji coba gratis dengan penyimpanan SSD hingga 500 GB dan cluster 1 node, sehingga Anda dapat menguji performa aplikasi dengan menjalankan operasi baca dan tulis bervolume tinggi pada tabel Bigtable untuk melihat cara Bigtable menangani operasi dengan performa yang didukung SSD.
- Tingkat dalam memori (Pratinjau). Anda dapat mencapai latensi baca sub-milidetik dan throughput tinggi untuk data penting yang sensitif terhadap waktu. Paket dalam memori memperluas solid-state drive (SSD) persisten Bigtable yang ada dan penyimpanan bertingkat yang hemat biaya dengan penyimpanan paket dalam memori (RAM) untuk menyediakan tingkatan data terintegrasi dalam layanan terpadu.
Edisi Bigtable
Edisi Bigtable adalah model harga yang memberikan berbagai kemampuan pada berbagai titik harga. Anda dapat memilih antara edisi Enterprise standar dan Enterprise Plus premium. Untuk mengetahui informasi selengkapnya, lihat Ringkasan edisi.
Efektif untuk
Bigtable ideal untuk aplikasi yang memerlukan throughput tinggi dan skalabilitas untuk data kunci-nilai, dengan setiap nilai biasanya tidak lebih dari 10 MB. Bigtable juga unggul sebagai mesin penyimpanan untuk operasi MapReduce batch, stream processing/analisis, dan aplikasi machine learning.
Anda dapat menggunakan Bigtable untuk menyimpan dan mengkueri semua jenis data berikut:
- Data deret waktu, seperti penggunaan memori dan CPU dari waktu ke waktu untuk banyak server.
- Data marketing, seperti histori pembelian dan preferensi pelanggan.
- Data keuangan, seperti histori transaksi, harga saham, dan nilai tukar mata uang.
- Data Internet of Things, seperti laporan penggunaan dari meteran energi dan peralatan rumah tangga.
- Data grafik, seperti informasi tentang cara pengguna terhubung dengan satu sama lain.
Model penyimpanan Bigtable
Bigtable menyimpan data dalam tabel yang sangat skalabel, yang masing-masing merupakan peta nilai kunci yang diurutkan. Tabel terdiri dari baris, yang masing-masing biasanya menggambarkan satu entity, dan kolom, yang berisi nilai individu untuk setiap baris. Satu nilai di setiap baris diindeks. Nilai ini dikenal sebagai row key. Kolom yang terkait satu sama lain biasanya dikelompokkan ke dalam grup kolom. Setiap kolom diidentifikasi dengan kombinasi grup kolom dan penentu kolom, yang merupakan nama unik dalam grup kolom.
Setiap persimpangan baris dan kolom dapat berisi beberapa sel. Setiap sel berisi versi data yang diberi stempel waktu unik untuk baris dan kolom tersebut. Menyimpan beberapa sel dalam kolom memberikan catatan tentang bagaimana data yang disimpan untuk baris dan kolom tersebut telah berubah dari waktu ke waktu. Tabel Bigtable renggang; jika kolom tidak digunakan dalam baris tertentu, kolom tersebut tidak akan menggunakan ruang apa pun.
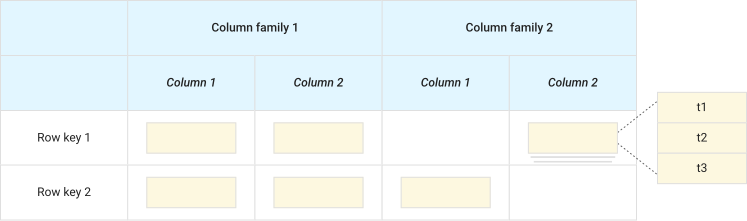
Beberapa hal yang perlu diperhatikan dalam ilustrasi ini:
- Kolom dapat tidak digunakan dalam satu baris.
- Setiap sel dalam baris dan kolom tertentu memiliki stempel waktu (t) yang unik.
Arsitektur Bigtable
Diagram berikut menunjukkan versi sederhana dari keseluruhan arsitektur resource Bigtable:
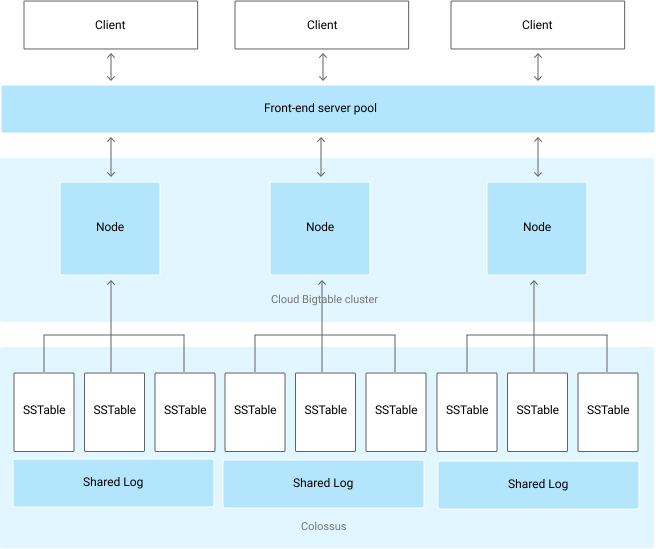
Seperti yang diilustrasikan dalam diagram, semua permintaan klien melewati server frontend sebelum dikirim ke node Bigtable. (Dalam makalah Bigtable asli, node ini disebut "server tablet".) Node diatur ke dalam cluster Bigtable, yang termasuk dalam instance Bigtable, container untuk cluster.
Setiap node dalam cluster menangani subset permintaan ke cluster. Dengan menambahkan node ke cluster, Anda dapat meningkatkan jumlah permintaan serentak yang dapat ditangani cluster. Menambahkan node juga akan meningkatkan throughput maksimum untuk cluster. Jika mengaktifkan replikasi dengan menambahkan cluster tambahan, Anda juga dapat mengirim berbagai jenis traffic ke cluster yang berbeda. Kemudian, jika satu cluster menjadi tidak tersedia, Anda dapat melakukan failover ke cluster lain.
Tabel Bigtable di-sharding menjadi blok baris yang berdekatan, yang disebut tablet, untuk membantu menyeimbangkan workload kueri. (Tablet mirip dengan region HBase.) Tablet disimpan di Colossus, sistem file yang dikembangkan Google, dalam format SSTable. SSTable menyediakan peta persisten yang tersusun dan tidak dapat diubah dari kunci ke nilai, di mana kunci dan nilai adalah string byte arbitrer. Setiap tablet dikaitkan dengan node Bigtable tertentu. Selain file SSTable, semua penulisan disimpan di log bersama Colossus segera setelah diakui oleh Bigtable, sehingga memberikan ketahanan yang lebih tinggi.
Yang penting, data tidak pernah disimpan di node Bigtable itu sendiri; setiap node memiliki pointer ke kumpulan tablet yang disimpan di Colossus. Hasilnya:
- Penyeimbangan ulang tablet dari satu node ke node lain terjadi dengan cepat, karena data sebenarnya tidak disalin. Bigtable memperbarui pointer untuk setiap node.
- Pemulihan dari kegagalan node Bigtable berlangsung cepat, karena hanya metadata yang harus dimigrasikan ke node pengganti.
- Jika node Bigtable gagal, tidak ada data yang hilang.
Untuk mengetahui informasi selengkapnya tentang cara menggunakan elemen penyusun dasar ini, lihat Instance, cluster, dan node. Untuk mengetahui detail tentang cara berinteraksi dengan data Anda di seluruh tingkat ini, lihat Mengakses data.
Load balancing
Setiap zona Bigtable dikelola oleh proses utama, yang menyeimbangkan workload dan volume data dalam cluster. Proses ini membagi tablet yang lebih sibuk atau lebih besar menjadi dua dan menggabungkan tablet yang lebih jarang diakses/lebih kecil, serta mendistribusikannya kembali di antara node sesuai kebutuhan. Jika tablet tertentu mendapatkan lonjakan traffic, Bigtable akan membagi tablet menjadi dua, lalu memindahkan salah satu tablet baru ke node lain. Bigtable mengelola pemisahan, penggabungan, dan penyeimbangan ulang secara otomatis, sehingga Anda tidak perlu mengelola tablet secara manual. Memahami performa memberikan detail selengkapnya tentang proses ini.
Untuk mendapatkan performa penulisan terbaik dari Bigtable, penting untuk mendistribusikan penulisan secara merata di seluruh node. Salah satu cara untuk mencapai sasaran ini adalah dengan menggunakan row key yang tidak mengikuti urutan yang dapat diprediksi. Misalnya, nama pengguna cenderung didistribusikan kurang lebih secara merata di seluruh alfabet, sehingga menyertakan nama pengguna di awal row key akan cenderung mendistribusikan penulisan secara merata.
Pada saat yang sama, sebaiknya kelompokkan baris terkait agar bersebelahan, sehingga pembacaan beberapa baris sekaligus menjadi jauh lebih efisien. Misalnya, jika Anda menyimpan berbagai jenis data cuaca dari waktu ke waktu,
row key Anda mungkin adalah lokasi tempat data dikumpulkan, diikuti dengan
stempel waktu (misalnya, WashingtonDC#201803061617). Jenis row key ini akan
mengelompokkan semua data dari satu lokasi ke dalam rentang baris yang berdekatan. Untuk lokasi lain, baris akan dimulai dengan ID yang berbeda; dengan banyak lokasi yang mengumpulkan data pada tingkat yang sama, penulisan akan tetap tersebar secara merata di seluruh tablet.
Lihat Memilih row key untuk mengetahui detail selengkapnya tentang cara memilih row key yang sesuai untuk data Anda.
Compute
Bigtable menyediakan berbagai opsi komputasi, bergantung pada persyaratan workload Anda. Secara default, Bigtable menggunakan node cluster untuk penyimpanan dan komputasi.
Untuk tugas baca dengan throughput tinggi, Anda dapat menggunakan Data Boost untuk Bigtable untuk komputasi. Data Boost memungkinkan Anda mengirim tugas baca dan kueri berukuran besar menggunakan komputasi serverless, sementara aplikasi inti Anda terus menggunakan node cluster untuk komputasi. Enterprise Plus memperluas kemampuan tugas ini untuk menyertakan dukungan SQL, serta akses ke data penyimpanan HDD dan bertingkat. Untuk mengetahui informasi selengkapnya, lihat Ringkasan Bigtable Data Boost.
Untuk workload khusus yang memerlukan throughput tinggi dan latensi pembacaan titik sub-milidetik, Anda dapat mengaktifkan paket dalam memori untuk node Bigtable.
Jenis data yang didukung
Bigtable memperlakukan semua data sebagai string byte mentah untuk sebagian besar tujuan. Satu-satunya waktu Bigtable mencoba menentukan jenis adalah untuk operasi penambahan, dengan target harus berupa bilangan bulat 64-bit yang dienkode sebagai nilai big-endian 8 byte.
Penggunaan memori dan disk
Bagian berikut menjelaskan pengaruh beberapa komponen Bigtable terhadap penggunaan memori dan disk untuk instance Anda.
Kolom yang tidak digunakan
Kolom yang tidak digunakan dalam baris Bigtable tidak menggunakan ruang apa pun di baris tersebut. Setiap baris pada dasarnya adalah kumpulan entri nilai kunci, dengan kunci yang merupakan kombinasi dari grup kolom, penentu kolom, dan stempel waktu. Jika baris tidak menyertakan nilai untuk kolom tertentu, entri nilai kunci tidak akan ada.
Penentu kolom
Penentu kolom menggunakan ruang dalam baris, karena setiap penentu kolom yang digunakan dalam baris disimpan dalam baris tersebut. Oleh karena itu, penggunaan penentu kolom sebagai data sering kali efisien.
Untuk mengetahui informasi selengkapnya tentang penentu kolom, lihat Kolom.
Pemadatan
Bigtable secara berkala menulis ulang tabel Anda untuk menghapus entri yang dihapus, mengatur ulang data Anda agar pembacaan dan penulisan lebih efisien, dan memindahkan data sebagai bagian dari penyimpanan bertingkat. Proses ini dikenal sebagai pemadatan. Tidak ada setelan konfigurasi untuk pemadatan—Bigtable memadatkan data Anda secara otomatis. Rata-rata, diperlukan waktu seminggu untuk menyelesaikan pemadatan dan menjalankan tugas seperti penghapusan data atau pemindahan data ke penyimpanan bertingkat.Pemadatan melakukan penghapusan yang diidentifikasi oleh proses pembersihan sampah memori. Pemadatan tidak memulai kompresi data; Bigtable mengompresi blok data secara otomatis saat dipertahankan ke penyimpanan. Untuk informasi selengkapnya, lihat Kompresi data dan Pembersihan sampah memori. Untuk informasi selengkapnya tentang pemadatan di penyimpanan bertingkat, lihat Cara kerja penyimpanan bertingkat.
Mutasi dan penghapusan
Mutasi, atau perubahan, pada baris memerlukan ruang penyimpanan tambahan, karena Bigtable menyimpan mutasi secara berurutan dan hanya memadatkannya secara berkala. Saat memadatkan tabel, Bigtable akan menghapus nilai yang tidak lagi diperlukan. Jika Anda memperbarui nilai dalam sel, nilai asli dan nilai baru akan disimpan di disk selama beberapa waktu hingga data dipadatkan.
Penghapusan juga menggunakan ruang penyimpanan tambahan, setidaknya dalam jangka pendek, karena penghapusan sebenarnya adalah jenis mutasi khusus. Hingga tabel dipadatkan, penghapusan akan menggunakan penyimpanan tambahan, bukan mengosongkan ruang.
Kompresi data
Bigtable mengompresi data Anda secara otomatis menggunakan algoritma cerdas saat data dipertahankan ke disk. Anda tidak dapat mengonfigurasi setelan kompresi untuk tabel.
Kompresi versus pemadatan
Kompresi data berbeda dengan pemadatan tabel:
Kompresi terjadi secara otomatis saat data ditulis dan dipertahankan ke penyimpanan. Kompresi mengurangi ukuran byte fisik blok data pada disk. Metrik pemakaian penyimpanan dan biaya penagihan mencerminkan ukuran terkompresi ini, bukan ukuran data logis yang tidak dikompresi.
Pemadatan adalah proses pemeliharaan latar belakang asinkron. Pemadatan secara berkala menggabungkan file penyimpanan dan menghapus data yang dihapus dan sudah tidak berlaku secara permanen. Pemadatan tidak memulai kompresi data; data Anda sudah disimpan dalam bentuk terkompresi.
Sebaiknya ketahui cara menyimpan data agar dapat dikompresi secara efisien:
Data acak tidak dapat dikompresi seefisien data berpola. Data berpola mencakup teks, seperti halaman yang sedang Anda baca saat ini.
Kompresi berfungsi paling baik jika nilai yang identik berdekatan, baik di baris yang sama maupun di baris yang berdekatan. Jika Anda mengatur row key sehingga baris dengan potongan data yang identik berada bersebelahan, data dapat dikompresi secara efisien.
Bigtable mengompresi nilai yang berukuran hingga 1 MiB. Jika Anda menyimpan nilai yang lebih besar dari 1 MiB, kompresi nilai tersebut sebelum menuliskannya ke Bigtable, sehingga Anda dapat menghemat siklus CPU, memori server, dan bandwidth jaringan.
Ketahanan data
Saat Anda menggunakan Bigtable, data Anda disimpan di Colossus, sistem file yang sangat tahan lama dan dikembangkan oleh Google, menggunakan perangkat penyimpanan di pusat dataGoogle Cloud. Anda tidak perlu menjalankan cluster HDFS atau sistem file lainnya untuk menggunakan Bigtable. Di balik layar, Colossus menggunakan metode penyimpanan eksklusif untuk mencapai ketahanan data di luar yang disediakan oleh replikasi tiga arah HDFS standar.
Daya tahan akan lebih ditingkatkan saat menggunakan replikasi. Bigtable menyimpan salinan data Anda secara terpisah di lokasi yang Anda pilih untuk setiap cluster instance yang direplikasi.
Model konsistensi
Instance Bigtable cluster tunggal memberikan konsistensi kuat. Secara default, instance yang memiliki lebih dari satu cluster memberikan konsistensi tertunda, tetapi untuk beberapa kasus penggunaan, instance tersebut dapat dikonfigurasi untuk memberikan konsistensi baca-tulis atau konsistensi kuat, bergantung pada workload dan setelan profil aplikasi.
Keamanan
Akses ke tabel Bigtable Anda dikontrol oleh project Google Cloud Anda dan peran Identity and Access Management (IAM) yang Anda tetapkan kepada pengguna. Misalnya, Anda dapat menetapkan peran IAM yang mencegah pengguna individu membaca dari tabel, menulis ke tabel, atau membuat instance baru. Jika seseorang tidak memiliki akses ke project Anda atau tidak memiliki peran IAM dengan izin yang sesuai untuk Bigtable, dia tidak dapat mengakses tabel Anda.
Anda juga dapat mengontrol akses ke data tabel dengan membuat tampilan tabel yang diotorisasi yang mewakili subset data tabel. Kemudian, Anda dapat memberikan izin tingkat tampilan yang diotorisasi kepada beberapa pengguna tanpa memberi mereka izin tingkat tabel. Anda dapat mengelola keamanan di level project, instance, tabel, atau tampilan yang diizinkan. Bigtable tidak mendukung batasan keamanan tingkat baris, tingkat kolom, atau tingkat sel.Enkripsi
Secara default, semua data yang disimpan dalam Google Cloud, termasuk data dalam tabel Bigtable, dienkripsi dalam penyimpanan menggunakan sistem pengelolaan kunci yang telah melalui proses hardening yang sama dengan yang kami gunakan untuk data terenkripsi milik kami.
Jika Anda menginginkan kontrol lebih besar atas kunci yang digunakan untuk mengenkripsi data Bigtable dalam penyimpanan, Anda dapat menggunakan kunci enkripsi yang dikelola pelanggan (CMEK).
Cadangan
Cadangan Bigtable memungkinkan Anda menyimpan salinan skema dan data tabel, lalu memulihkannya ke tabel baru di lain waktu. Dengan menggunakan cadangan dan salinan cadangan, Anda dapat memulihkan ke tabel baru di region atau project mana pun tempat Anda memiliki instance Bigtable, terlepas dari lokasi tabel sumber.
Pengambilan data perubahan
Bigtable menyediakan pengambilan data perubahan (CDC) dalam bentuk aliran data perubahan. Aliran perubahan memungkinkan Anda menangkap dan men-streaming perubahan data ke tabel saat perubahan terjadi. Anda dapat membaca aliran data perubahan menggunakan layanan seperti Dataflow untuk mendukung kasus penggunaan, termasuk analisis data, audit, persyaratan pengarsipan, dan pemicuan logika aplikasi downstream. Untuk mengetahui informasi selengkapnya, lihat Ringkasan aliran perubahan.
Pemilihan rute permintaan dengan profil aplikasi
Kebijakan perutean profil aplikasi memungkinkan Anda mengontrol cluster mana yang menangani permintaan masuk dari aplikasi Anda. Bigtable menawarkan jenis profil aplikasi berikut berdasarkan model komputasi yang digunakan:
Profil aplikasi standar: menggunakan node cluster yang disediakan untuk menangani permintaan. Keduanya mendukung kebijakan perutean berikut:
Perutean cluster tunggal: mengirimkan semua permintaan ke satu cluster.
Anda dapat mengaktifkan tingkat dalam memori (Pratinjau) hanya untuk profil aplikasi yang menggunakan pemilihan rute cluster tunggal. Saat Anda mengonfigurasi profil aplikasi untuk menggunakan paket dalam memori di cluster, semua traffic pembacaan titik yang memenuhi syarat akan menggunakan paket dalam memori.
Perutean multi-cluster ke cluster mana pun: mengirim permintaan ke cluster terdekat yang tersedia dalam instance, baik di antara semua cluster maupun grup cluster yang ditentukan.
Profil aplikasi Data Boost: menggunakan komputasi serverless, bukan node cluster, untuk mengisolasi tugas baca dengan throughput tinggi dari traffic aplikasi inti Anda. Profil ini dibatasi untuk kebijakan perutean cluster tunggal.
Opsi penyimpanan dan database lainnya
Bigtable bukanlah database relasional tradisional. Meskipun mendukung kueri SQL, kasus penggunaan tertentu mungkin lebih cocok untuk opsi database lain.
- Jika Anda harus menyimpan objek yang sangat terstruktur dalam database dokumen, dengan dukungan untuk transaksi ACID dan kueri mirip SQL, pertimbangkan Firestore.
- Untuk menyinkronkan data antarpengguna secara real time, pertimbangkan Firebase Realtime Database.
- Jika Anda memerlukan kueri interaktif dalam sistem pemrosesan analisis online (OLAP), pertimbangkan BigQuery.
Untuk mengetahui informasi selengkapnya tentang opsi database lainnya, lihat ringkasan layanan database. Google Cloud juga memiliki berbagai opsi penyimpanan.
Langkah berikutnya
- Coba panduan memulai Bigtable menggunakan
cbtCLI , alat command line untuk Bigtable. - Selesaikan codelab Bigtable.
- Pelajari instance, cluster, dan node Bigtable.
- Pelajari penyimpanan bertingkat Bigtable.
- Pelajari edisi Bigtable.
- Pelajari tingkat dalam memori Bigtable.
- Pelajari cara membuat instance Bigtable.
- Pelajari cara bermigrasi ke Bigtable.
- Pelajari library klien untuk Cloud Bigtable.
- Baca makalah OSDI asli tentang Bigtable.