


Leistung nachvollziehen
Auf dieser Seite finden Sie Informationen zur ungefähren Leistung, die Bigtable unter optimalen Bedingungen bereitstellen kann, zu Faktoren, die sich auf die Leistung auswirken können, und Tipps zum Testen und zur Fehlerbehebung bei Leistungsproblemen in Bigtable.
Leistung bei typischer Arbeitslast
Bigtable bietet eine äußerst vorhersehbare Leistung, die linear skalierbar ist. Wenn Sie die auf dieser Seite beschriebenen Ursachen für eine langsamere Leistung vermeiden, kann jeder Bigtable-Knoten je nach Speichertyp des Clusters den folgenden ungefähren Durchsatz bieten:
| Speicherstufe | Lesevorgänge | Schreibvorgänge | Scans | ||
|---|---|---|---|---|---|
| In-Memory-Stufe (Vorabversion) | bis zu 120.000 Zeilen pro Sekunde1 | oder | bis zu 10.000 Zeilen pro Sekunde2 | – | |
| SSD | bis zu 17.000 Zeilen pro Sekunde | oder | bis zu 14.000 Zeilen pro Sekunde | oder | bis zu 220 MB/s |
| HDD | bis zu 500 Zeilen pro Sekunde | oder | bis zu 10.000 Zeilen pro Sekunde | oder | bis zu 180 MB/s |
| Selten genutzter Speicher | bis zu 100 Zeilen pro Sekunde | oder | bis zu 10.000 Zeilen pro Sekunde | oder | bis zu 36 MB/s |
Bei diesen Schätzungen wird davon ausgegangen, dass jede Zeile 1 KB enthält.
1 Ein Enterprise Plus-Knoten umfasst 40.000 Zeilen pro Sekunde und kann vertikal auf 120.000 Zeilen pro Sekunde pro Knoten in Schritten von 40.000 skaliert werden. Weitere Informationen finden Sie unter In-Memory-Stufe.
2 Eine hohe Anzahl von Schreibvorgängen pro Sekunde für Daten in der In-Memory-Stufe kann sich auf den Schreibdurchsatz auswirken.
Grundsätzlich erhöht sich die Leistung eines Clusters linear mit der Anzahl der Knoten im Cluster. Wenn Sie beispielsweise einen SSD-Cluster mit 10 Knoten erstellen, kann der Cluster bis zu 140.000 Zeilen pro Sekunde für eine typische schreib- oder lesegeschützte Arbeitslast ohne aktivierte In-Memory-Stufe unterstützen. Wenn die In-Memory-Stufe aktiviert ist, kann der Cluster einen Lesedurchsatz von bis zu 1,2 Millionen Zeilen pro Sekunde unterstützen.
Bigtable-Kapazität planen
Entscheiden Sie bei der Planung Ihrer Bigtable-Cluster, ob Sie die Latenz oder den Durchsatz optimieren möchten. Beispielsweise kann bei einem Batchdatenverarbeitungsjob der Durchsatz wichtiger sein als die Latenz. Bei einem Onlinedienst, der Nutzeranfragen verarbeitet, müssen Sie möglicherweise eine geringere Latenz vor dem Durchsatz priorisieren. Die Werte im Abschnitt Leistung für typische Arbeitslasten können Sie erreichen, wenn Sie den Durchsatz optimieren.
In-Memory-Stufe
Wenn die In-Memory-Stufe aktiviert ist, enthält jeder Knoten 40.000 Zeilen pro Sekunde. Durch das horizontale Hinzufügen von Knoten wird die Gesamtkapazität des Clusters erhöht. Darüber hinaus kann jeder Knoten vertikal auf maximal 120.000 Zeilen pro Sekunde und Knoten skaliert werden, um den Lesedurchsatz im Arbeitsspeicher zu unterstützen. Wenn das Limit für die vertikale Skalierung erreicht ist, fügt Bigtable Autoscaling zusätzliche Knoten hinzu, um horizontal zu skalieren. Ein Cluster mit manueller Skalierung unterstützt die vertikale In-Memory-Skalierung, bis die Durchsatzkapazität erreicht ist. Die vertikale Skalierung über die Basis von 40.000 Zeilen pro Sekunde hinaus wird durch Anwendung eines Multiplikators auf die stündlichen Kosten des Knotens abgerechnet. Weitere Informationen finden Sie unter Preise.
Jeder In-Memory-Knoten hat eine Speicherkapazität von 8 GB. Der Durchsatz kann zwar vertikal skaliert werden, die Speicherkapazität pro Knoten bleibt jedoch fest. Bei der horizontalen Skalierung werden jedoch für jeden neuen Knoten zusätzliche 8 GB Arbeitsspeicher hinzugefügt. Da der Speicher bei der vertikalen Skalierung nicht erhöht wird, kann die Fehlerrate einer Arbeitslast steigen, wenn ein Knoten seinen In-Memory-Durchsatz vertikal skaliert.
CPU-Auslastung
In fast allen Fällen empfehlen wir die Verwendung von Autoscaling, damit Bigtable Knoten je nach Nutzung hinzufügen oder entfernen kann. Weitere Informationen finden Sie unter Autoscaling.
Beachten Sie die folgenden Richtlinien, wenn Sie Ihre Autoscaling-Ziele konfigurieren oder die manuelle Knotenzuweisung auswählen. Diese Richtlinien gelten unabhängig von der Anzahl der Cluster, die Ihre Instanz hat. Bei einem Cluster mit manueller Knotenzuweisung müssen Sie die CPU-Auslastung des Clusters im Auge behalten, um die CPU-Auslastung für eine optimale Leistung unter diesen Werten zu halten.
| Optimierungsziel | Maximale CPU-Auslastung |
|---|---|
| Durchsatz | 90 % |
| Latenz | 60 % |
Weitere Informationen zum Monitoring finden Sie unter Monitoring.
Speicherauslastung
Ein weiterer Aspekt bei der Kapazitätsplanung ist der Speicher. Die Speicherkapazität eines Clusters wird durch den Speichertyp und die Anzahl der Knoten im Cluster bestimmt. Wenn die Menge der in einem Cluster gespeicherten Daten zunimmt, optimiert Bigtable den Speicher, indem die Daten auf alle Knoten im Cluster verteilt werden.
Wenn Sie den Speicherbedarf und die Anzahl der Clusterknoten für die Kapazitätsplanung schätzen, sollten Sie Ihre Berechnungen auf die erwartete Größe der komprimierten Daten und nicht auf die unkomprimierten Quelldaten stützen. Bigtable komprimiert Daten automatisch, wenn sie in den Speicher geschrieben werden. Je nach Schemadesign und Datenmuster kann die Komprimierung den physischen Speicherbedarf auf dem Laufwerk erheblich reduzieren. Richtlinien zur Datenkomprimierbarkeit finden Sie unter Datenkomprimierung.
Sie können die Speichernutzung pro Knoten ermitteln, indem Sie die Speicherauslastung (Byte) des Clusters durch die Anzahl der Knoten im Cluster teilen. Beispiel: Ein Cluster hat drei HDD-Knoten und 9 TB an Daten. Jeder Knoten speichert ungefähr 3 TB, was 18,75 % des HDD-Speicherlimits pro Knoten von 16 TB entspricht.
Wenn die Speicherauslastung zunimmt, können Arbeitslasten eine höhere Latenz bei der Abfrageverarbeitung aufweisen, auch wenn der Cluster genügend Knoten hat, um die gesamten CPU-Anforderungen zu erfüllen. Das liegt daran, das umso mehr Hintergrundarbeit wie für die Indexierung erforderlich ist, je größer der Speicher pro Knoten ist. Die Erhöhung der Hintergrundarbeit, um mehr Speicher zu bewältigen, kann zu einer höheren Latenz und einem geringeren Durchsatz führen.
Beginnen Sie mit den folgenden Schritten, wenn Sie die Autoscaling-Einstellungen konfigurieren. Wenn Sie die manuelle Knotenzuweisung auswählen, überwachen Sie die Speicherauslastung des Clusters und fügen Sie Knoten hinzu oder entfernen Sie sie, um Folgendes zu gewährleisten.
| Optimierungsziel | Maximale Speicherauslastung |
|---|---|
| Durchsatz | 70 % |
| Latenz | 60 % |
Weitere Informationen finden Sie unter Speicher pro Knoten.
Arbeitslasten in Bigtable ausführen
Führen Sie Ihre Arbeitslasten bei der Kapazitätsplanung immer für einen Bigtable-Cluster aus, um die beste Ressourcenzuweisung für Ihre Anwendungen zu ermitteln.
PerfKit Benchmarker von Google nutzt YCSB, um Cloud-Dienste zu vergleichen. Sie können der PerfKitBenchmarker-Anleitung für Bigtable folgen, um Tests für Ihre Arbeitslasten zu erstellen. Passen Sie dabei die Parameter in den YAML-Dateien für die Benchmarking-Konfiguration an, damit der generierte Benchmark die folgenden Produktionsmerkmale widerspiegelt:
- Gesamtgröße der Tabelle (proportional, aber mindestens 100 GB).
- Zeilendatenform (Zeilenschlüsselgröße, Anzahl der Spalten, Zeilendatengrößen usw.)
- Datenzugriffsmuster (Verteilung der Zeilenschlüssel)
- Mischung aus Lese- und Schreibvorgängen
Weitere Best Practices finden Sie unter Leistungstest mit Bigtable.
Ursachen einer niedrigeren Leistung
Die folgenden Faktoren können dazu führen, dass Bigtable langsamer als geschätzt ist:
- Sie lesen eine große Anzahl nicht zusammenhängender Zeilenschlüssel oder Zeilenbereiche in einer einzigen Leseanfrage. Bigtable scannt die Tabelle und liest die angeforderten Zeilen sequenziell. Dieser Mangel an Parallelität wirkt sich auf die Gesamtlatenz aus und Lesevorgänge, die einen Hotspot-Knoten betreffen, können die Tail-Latenz erhöhen. Weitere Informationen finden Sie unter Lesevorgänge und Leistung.
- Das Schema der Tabelle ist nicht korrekt entworfen. Für eine gute Schreibleistung von Bigtable ist es entscheidend, ein Schema zu entwerfen, mit dem Lese- und Schreibvorgänge gleichmäßig auf alle Tabellen verteilt werden können. Außerdem können Hotspots in einer Tabelle die Leistung anderer Tabellen in derselben Instanz beeinträchtigen. Weitere Informationen finden Sie unter Best Practices für das Schemadesign.
- Die Zeilen der Bigtable-Tabelle enthalten große Datenmengen. Bei den Leistungsschätzungen wird davon ausgegangen, dass jede Zeile 1 KB Daten enthält. Sie können größere Datenmengen pro Zeile lesen und schreiben, eine höhere Datenmenge pro Zeile reduziert jedoch die Anzahl an Zeilen pro Sekunde.
- Die Zeilen der Bigtable-Tabelle enthalten sehr viele Zellen. Bigtable benötigt Zeit für die Verarbeitung der einzelnen Zellen in einer Zeile. Außerdem bedeutet jede Zelle eine zusätzliche Datenmenge, die in der Tabelle gespeichert und über das Netzwerk gesendet wird. Wenn Sie beispielsweise 1 KB (1.024 Byte) Daten speichern, ist es sehr viel platzsparender, diese Daten in einer einzelnen Zelle zu speichern als in 1.024 Zellen mit jeweils 1 Byte. Wenn Sie die Daten auf mehr Zellen als nötig aufteilen, erhalten Sie ggf. nicht die bestmögliche Leistung. Wenn Zeilen eine große Anzahl Zellen enthalten, da Spalten mehrere Zeitstempelversionen beinhalten, sollten Sie nur den aktuellsten Wert beibehalten. Eine weitere Option für eine vorhandene Tabelle besteht darin, bei jedem Neuschreiben einen Löschvorgang für alle vorherigen Versionen zu senden.
Der Cluster hat nicht genug Knoten. Die Knoten eines Clusters bieten Rechenleistung für den Cluster, um eingehende Lese- und Schreibvorgänge zu verarbeiten, den Speicher zu verfolgen und Wartungsaufgaben wie die Verdichtung durchzuführen. Achten Sie darauf, dass Ihr Cluster genügend Knoten hat, um die empfohlenen Limits für Computing und Speicher einzuhalten. Mit den Monitoringtools sehen Sie, ob Ihr Cluster überlastet ist.
- Computing: Wenn die CPU Ihres Bigtable-Clusters überlastet ist, können Sie die Leistung verbessern, indem Sie weitere Knoten hinzufügen und die Arbeitslast so auf mehr Knoten verteilen.
- Speicher: Wenn Ihre Speichernutzung pro Knoten höher ist als empfohlen, fügen Sie weitere Knoten hinzu, um eine optimale Latenz und einen optimalen Durchsatz zu gewährleisten, auch wenn der Cluster genügend CPU hat, um Anfragen zu verarbeiten. Dies liegt daran, dass durch Erhöhen des Speichers pro Knoten die Hintergrundwartungsarbeit pro Knoten erhöht wird. Weitere Informationen finden Sie unter Kompromisse zwischen Speichernutzung und Leistung.
Der Bigtable-Cluster wurde vor kurzer Zeit vergrößert oder verkleinert. Nachdem die Anzahl der Knoten in einem Cluster durch Autoscaling erhöht wurde, kann es bis zu 20 Minuten unter Last dauern, bis sich die Leistung deutlich verbessert. Bigtable skaliert Clusterknoten basierend auf der Last, der sie ausgesetzt sind.
Wenn Sie die Anzahl der Knoten in einem Cluster reduzieren, um ihn herunterzuskalieren, sollten Sie die Clustergröße in einem Zeitraum von 10 Minuten nicht um mehr als 10% reduzieren, um Latenzspitzen zu minimieren.
Der Bigtable Cluster nutzt HDD-Festplatten. In den meisten Fällen sollte Ihr Cluster SSD-Festplatten verwenden, die eine deutlich bessere Leistung als HDD-Festplatten liefern. Genaueres erfahren Sie unter Zwischen SSD- und HDD-Speicher wählen.
Es liegen Probleme mit der Netzwerkverbindung vor. Netzwerkprobleme können den Durchsatz reduzieren und dazu führen, dass Lesen und Schreiben länger als gewöhnlich dauert. Probleme treten insbesondere dann auf, wenn die Clients nicht in derselben Zone wie der Bigtable-Cluster oder außerhalb von Google Cloudausgeführt werden.
Sie verwenden die Replikation, aber Ihre Anwendung verwendet eine veraltete Clientbibliothek. Wenn Sie nach dem Aktivieren der Replikation eine erhöhte Latenz beobachten, prüfen Sie, ob die von Ihrer Anwendung verwendete Cloud Bigtable-Clientbibliothek auf dem neuesten Stand ist. Ältere Versionen der Clientbibliotheken sind möglicherweise nicht für die Unterstützung der Replikation optimiert. Unter Cloud Bigtable-Clientbibliotheken finden Sie das GitHub-Repository Ihrer Clientbibliothek, wo Sie die Version prüfen und bei Bedarf ein Upgrade ausführen können.
Sie haben die Replikation aktiviert, aber keine weiteren Knoten zu Ihren Clustern hinzugefügt. In einer Instanz mit Replikation muss jeder Cluster zusätzlich zu der von Anwendungen empfangenen Last die Arbeit der Replikation bewältigen. Unzureichend konfigurierte Cluster können zu erhöhter Latenz führen. Sie können dies in den Diagrammen der Instanz zur CPU-Nutzung in der Google Cloud Console überprüfen.
Da verschiedene Arbeitslasten Leistungsschwankungen verursachen können, sollten Sie Tests mit Ihren Arbeitslasten ausführen, um die genauesten Vergleichswerte zu erhalten.
Kaltstarts und niedrige QPS
Kaltstarts und niedrige QPS-Werte können die Latenz erhöhen. Bigtable funktioniert am besten mit großen Tabellen, auf die häufig zugegriffen wird. Wenn Sie nach einem Zeitraum der Nichtnutzung Anfragen senden (ein Kaltstart), kann es daher zu hoher Latenz kommen, während Bigtable Verbindungen wiederherstellt. Die Latenz ist auch höher, wenn die Abfragen pro Sekunde niedrig sind.
Wenn Ihre Abfragen pro Sekunde niedrig sind oder Sie wissen, dass Sie nach einer Inaktivitätsphase manchmal Anfragen an eine Bigtable-Tabelle senden, können Sie mit den folgenden Strategien Ihre Verbindung warm halten und eine hohe Latenz vermeiden.
- Senden Sie jederzeit eine niedrige Rate künstlicher Zugriffe an die Tabelle.
- Konfigurieren Sie den Verbindungspool, um dafür zu sorgen, dass stabile Abfragen pro Sekunde den Pool aktiv halten.
In Zeiten mit geringer Abfragen pro Sekunde ist die Anzahl der Fehler, die Bigtable zurückgibt, relevanter als der Prozentsatz der Vorgänge, die einen Fehler zurückgeben.
Kaltstart bei der Clientinitialisierung. Wenn Sie eine Version des Cloud Bigtable-Clients für Java verwenden, die älter als Version 2.17.1 ist, können Sie die Kanalaktualisierung aktivieren. In späteren Versionen ist die Kanalaktualisierung standardmäßig aktiviert. Die Kanalaktualisierung hat zwei Funktionen:
- Wenn der Client initialisiert wird, bereitet er den Kanal vor, bevor er die ersten Anfragen sendet.
- Der Server trennt langlebige Verbindungen jede Stunde. Beim Channel-Priming werden ablaufende Kanäle präventiv ersetzt.
Dadurch wird der Kanal jedoch nicht aktiv gehalten, wenn er inaktiv ist.
Wie Bigtable meine Daten mit der Zeit optimiert
Zum Speichern der zugrunde liegenden Daten für jede Ihrer Tabellen teilt Bigtable die Daten in mehrere Tabellenreihen, die zwischen Knoten in Ihrem Bigtable-Cluster verschoben werden können. Diese Speichermethode ermöglicht es Bigtable, zwei Strategien zur Optimierung von Daten im Laufe der Zeit zu verwenden:
- Bigtable speichert auf jedem Bigtable-Knoten ungefähr dieselbe Datenmenge.
- Bigtable verteilt die Lese- und Schreibvorgänge gleichmäßig auf alle Bigtable-Knoten.
Manchmal stehen diese Strategien im Widerspruch zueinander. Wenn beispielsweise die Zeilen eines Tablets extrem häufig gelesen werden, speichert Bigtable dieses Tablet möglicherweise auf einem eigenen Knoten, auch wenn dadurch auf einigen Knoten mehr Daten gespeichert werden als auf anderen.
Im Rahmen dieses Prozesses kann Bigtable ein Tablet in zwei oder mehr kleinere Tablets aufteilen, um die Größe zu reduzieren oder um Hot Rows innerhalb eines vorhandenen Tablets zu isolieren.
Im folgenden Teil werden diese Strategien detaillierter erläutert.
Datenmenge auf Knoten verteilen
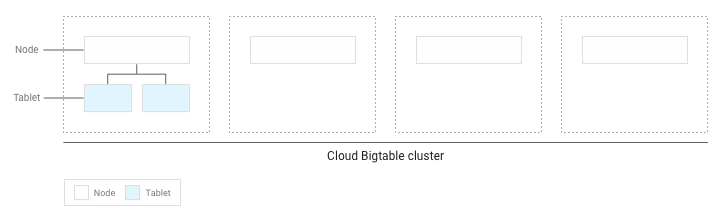
Wenn Sie Daten in eine Bigtable-Tabelle schreiben, teilt Bigtable die Daten in Tabellenreihen. Jede Tabellenreihe enthält einen fortlaufenden Bereich an Zeilen innerhalb der Tabelle.
Sollten Sie weniger als mehrere GB Daten in die Tabelle geschrieben haben, speichert Bigtable alle Tablets auf einem einzigen Knoten in Ihrem Cluster:
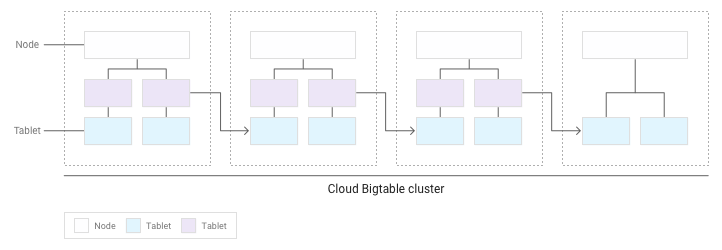
Nachdem sich mehr Tablets angesammelt haben, wird Bigtable einige von ihnen zu anderen Knoten verschieben, sodass die Datenmenge gleichmäßiger über den Cluster verteilt ist:
Lese- und Schreibvorgänge gleichmäßig auf Knoten verteilen
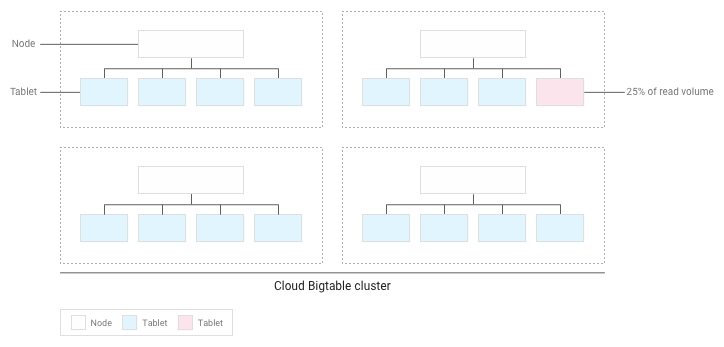
Wenn Sie Ihr Schema korrekt entworfen haben, sollten Lese- und Schreibvorgänge gleichmäßig auf die gesamte Tabelle verteilt sein. Es gibt aber Fälle, in denen Sie es nicht verhindern können, auf manche Zeilen öfter zuzugreifen als auf andere. Bigtable hilft Ihnen an dieser Stelle, da es Lese- und Schreibvorgänge berücksichtigt, wenn es Tabellenreihen auf Knoten verteilt.
Angenommen, 25% der Lesevorgänge werden auf eine kleine Anzahl von Tablets innerhalb eines Clusters verteilt und die Lesevorgänge werden gleichmäßig auf alle anderen Tablets verteilt:
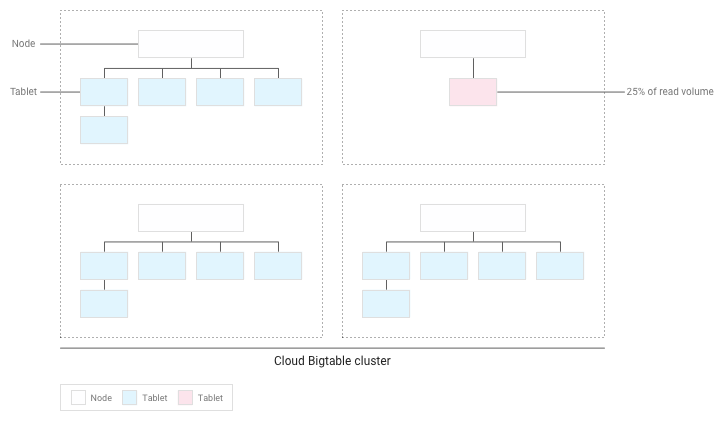
Bigtable wird die vorhandenen Tabellenreihen umverteilen, sodass Lesevorgänge so gleichmäßig wie möglich auf den gesamten Cluster verteilt sind:
Leistung mit Bigtable testen
Wenn Sie einen Leistungstest für eine Anwendung ausführen, die von Bigtable abhängig ist, beachten Sie beim Planen und Ausführen des Tests die folgenden Richtlinien:
- Testen Sie mit genügend Daten.
- Wenn die Tabellen in Ihrer Produktionsinstanz insgesamt maximal 100 GB Daten pro Knoten enthalten, testen Sie mit einer Tabelle mit derselben Datenmenge.
- Wenn die Tabellen mehr als 100 GB Daten pro Knoten enthalten, testen Sie mit einer Tabelle, die mindestens 100 GB Daten pro Knoten enthält. Wenn die Produktionsinstanz beispielsweise einen Cluster mit vier Knoten hat und die Tabellen in der Instanz insgesamt 1 TB Daten enthalten, führen Sie den Test mit einer Tabelle von mindestens 400 GB aus.
- Testen Sie mit einer einzelnen Tabelle.
- Unter der empfohlenen Speicherauslastung pro Knoten bleiben. Weitere Informationen finden Sie unter Speicherauslastung pro Knoten.
- Einen intensiven Vortest ausführen. In diesem Schritt kann Bigtable die Daten basierend auf den beobachteten Zugriffsmustern auf Ihre Knoten verteilen.
- Den Test mindestens 10 Minuten ausführen. Dieser Schritt ermöglicht die weitere Optimierung Ihrer Daten durch Bigtable. Außerdem wird dafür gesorgt, dass sowohl Lesevorgänge von der Festplatte als auch im Cache gespeicherte Lesevorgänge aus dem Arbeitsspeicher getestet werden.
- Für Tests der In-Memory-Stufe (Vorabversion) muss die Testdauer ausreichen, um die In-Memory-Stufe mit Lesevorgängen zu füllen.
Leistungsprobleme beheben
Wenn Sie der Meinung sind, dass Bigtable möglicherweise einen Leistungsengpass in Ihrer Anwendung verursacht, prüfen Sie Folgendes:
- Sehen Sie sich die Key Visualizer-Scans für die Tabelle an. Das Key Visualizer-Tool für Bigtable generiert alle 15 Minuten neue Scandaten, die die Nutzungsmuster der einzelnen Tabellen in einem Cluster anzeigen. Mit Key Visualizer können Sie überprüfen, ob die Nutzungsmuster die Ursache von unerwünschten Ergebnissen sind, z. B. Hotspots bei bestimmten Zeilen oder eine übermäßig hohe CPU-Auslastung. Weitere Informationen finden Sie unter Key Visualizer verwenden.
- Kommentieren Sie den Code aus, der die Lese- und Schreibvorgänge von Bigtable durchführt. Wenn sich das Leistungsproblem löst, nutzen Sie Bigtable wahrscheinlich auf eine Art, die in unzulänglicher Leistung resultiert. Wenn das Leistungsproblem weiterhin besteht, liegt das Problem wahrscheinlich nicht an Bigtable.
Achten Sie darauf, möglichst wenig Clients zu erstellen. Das Erstellen eines Clients für Bigtable ist ein relativ teurer Vorgang. Deshalb sollten Sie so wenig Clients wie möglich erstellen.
- Wenn Sie die Replikation verwenden oder mithilfe von Anwendungsprofilen unterschiedliche Arten von Traffic für die Instanz ermitteln möchten, erstellen Sie einen Client pro Anwendungsprofil und geben die Clients für die gesamte Anwendung frei.
- Wenn Sie keine Replikation und keine Anwendungsprofile verwenden, erstellen Sie einen einzigen Client und geben Sie ihn in Ihrer gesamten Anwendung frei.
Wenn Sie den HBase-Client für Java verwenden, erstellen Sie ein
Connection-Objekt anstelle eines Clients. Erstellen Sie daher so wenige Verbindungen wie möglich.Schreiben und lesen Sie in möglichst vielen verschiedenen Zeilen Ihrer Tabelle. Bigtable funktioniert am besten, wenn Lese- und Schreibvorgänge gleichmäßig auf die ganze Tabelle verteilt sind. Dies hilft Bigtable dabei, die Arbeitslast auf alle Knoten im Cluster zu verteilen. Wenn Lese- und Schreibvorgänge nicht auf alle Knoten in Bigtable verteilt werden können, beeinträchtigt das die Leistung.
Wenn Sie feststellen, dass Sie nur eine kleine Anzahl von Zeilen lesen und schreiben, müssen Sie möglicherweise das Schema so neu entwerfen, dass Lese- und Schreibvorgänge gleichmäßiger verteilt sind.
Prüfen Sie, ob Sie die gleiche Leistung für Lese- und Schreibvorgänge sehen. Wenn Sie feststellen, dass Lesevorgänge viel schneller als Schreibvorgänge sind, versuchen Sie möglicherweise, nicht vorhandene Zeilenschlüssel oder einen großen Bereich von Zeilenschlüsseln zu lesen, der nur eine kleine Anzahl von Zeilen enthält.
Für einen aussagekräftigen Vergleich zwischen Lese- und Schreibvorgängen sollten mindestens 90% der Lesevorgänge gültige Ergebnisse liefern. Außerdem sollten Sie beim Lesen einer großen Anzahl an Zeilenschlüsseln die Leistung anhand der tatsächlichen Anzahl an Zeilen in dem Bereich messen und nicht anhand der maximalen Anzahl an Zeilen, die existieren könnten.
Verwenden Sie die richtigen Schreibanfragen für Ihre Daten. Durch Auswahl des optimalen Schreibvorgangs Ihrer Daten können Sie eine hohe Leistung erzielen.
Prüfen Sie die Latenz für eine einzelne Zeile. Wenn beim Senden von
ReadRows-Anfragen unerwartete Latenzen auftreten, können Sie die Latenz der ersten Zeile der Anfrage prüfen, um die Ursache einzugrenzen. Standardmäßig umfasst die Gesamtlatenz für eineReadRows-Anfrage die Latenz für jede Zeile in der Anfrage sowie die Verarbeitungszeit zwischen Zeilen. Wenn die Gesamtlatenz hoch ist, aber die Latenz der ersten Zeile niedrig ist, lässt dies darauf schließen, dass die Latenz durch die Anzahl der Anfragen oder durch die Verarbeitungszeit und nicht durch ein Problem mit Bigtable verursacht wird.Wenn Sie die Bigtable-Clientbibliothek für Java verwenden, können Sie den Messwert
read_rows_first_row_latencyim Metrics Explorer derGoogle Cloud Console ansehen, nachdem Sie clientseitige Messwerte aktiviert haben.Separates Anwendungsprofil für jede Arbeitslast verwenden Wenn nach dem Hinzufügen einer neuen Arbeitslast Leistungsprobleme auftreten, erstellen Sie ein neues Anwendungsprofil für die neue Arbeitslast. Anschließend können Sie die Messwerte für Ihre Anwendungsprofile separat überwachen, um weitere Fehler zu beheben. Unter Funktionsweise von Anwendungsprofilen erfahren Sie, warum es sich empfiehlt, mehrere Anwendungsprofile zu verwenden.
Clientseitige Messwerte aktivieren Sie können clientseitige Messwerte einrichten, um Leistungsprobleme zu optimieren und zu beheben. Da Bigtable am besten mit gleichmäßig verteilten, hohen Abfragen pro Sekunde funktioniert, deutet eine erhöhte P100-Latenz (max.) für einen kleinen Prozentsatz von Anfragen nicht unbedingt auf ein größeres Leistungsproblem mit Bigtable hin. Clientseitige Messwerte geben Aufschluss darüber, welcher Teil des Anfragelebenszyklus die Latenz verursacht.
Achten Sie darauf, dass Ihre Anwendung Leseanfragen verarbeitet, bevor sie das Zeitlimit überschreiten. Wenn Ihre Anwendung Daten während eines Lesestreams verarbeitet, besteht das Risiko, dass die Anfrage abläuft, bevor Sie alle Antworten vom Aufruf erhalten haben. Dies führt zu einer
ABORTED-Nachricht. Wenn dieser Fehler angezeigt wird, reduzieren Sie die Verarbeitung während des Lesestreams.
Direkte Verbindung
Bigtable unterstützt direkte Verbindungen für Anwendungstraffic, der bestimmte Kriterien erfüllt. Dabei wird das Google-Frontend umgangen und die Leistung optimiert. Wenn Sie ein Upgrade auf die aktuelle Version Ihrer Clientbibliothek durchführen, um die direkte Verbindung zu nutzen, können Sie den Durchsatz und die Latenz verbessern. Für Anwendungen mit den folgenden Merkmalen wird eine direkte Verbindung bereitgestellt:
- Ausführung auf einer Compute Engine- oder Google Kubernetes Engine-VM (GKE) in einem VPC-Netzwerk (Virtual Private Cloud)
- Unterstützte Bigtable-Clientbibliothek verwenden
- Standard-Anwendungsprofil (nicht Data Boost) verwenden
- In einem Netzwerk, das mit Routen und Firewallregeln konfiguriert ist, die ausgehenden Traffic zu
34.126.0.0/18und2001:4860:8040::/42zulassen
Direkte Verbindungen werden unterstützt und sind standardmäßig aktiviert, wenn Sie eine der folgenden Bigtable-Clientbibliotheken verwenden:
- Java-Version 2.76.0 oder höher
- HBase-Adapter-Version 2.17.0 oder höher
- Go-Version 1.50.1 oder höher
Sowohl IPv4 als auch IPv6 werden unterstützt. Weitere Informationen finden Sie unter Direkte Verbindung zu APIs und Diensten in der VPC-Dokumentation.
Nächste Schritte
- Bigtable-Schema erstellen
- Bigtable-Leistung beobachten
- Probleme in Key Visualizer beheben
- Informationen zur Fehlerbehebung bei Latenz
- Sehen Sie sich Beispielcode für das programmatische Hinzufügen von Knoten zu einem Bigtable-Cluster an