


Bigtable
Bigtable ist eine dünnbesetzte Tabelle, die auf Milliarden von Zeilen und Tausende von Spalten skaliert werden kann. Dadurch können Datenmengen im Terabyte- oder sogar Petabytebereich gespeichert werden. Bigtable ist ideal für die Speicherung großer einfach verschlüsselter Datenmengen bei niedriger Latenz. Cloud Bigtable unterstützt einen hohen Durchsatz an Lese- und Schreibvorgängen bei kleiner Latenz und ist die ideale Datenquelle für MapReduce-Vorgänge.
Anwendungen können über mehrere Clientbibliotheken, darunter eine unterstützte Erweiterung der Apache HBase-Bibliothek für Java, auf Bigtable zugreifen. Daher fügt es sich in das bestehende Apache-System der Open-Source-Software für Big Data ein.
Die leistungsstarken Backend-Server von Bigtable bieten einige entscheidende Vorteile:
- Unglaublich hohe Skalierbarkeit. Bigtable skaliert direkt proportional zur Anzahl der Maschinen in Ihrem Cluster. Eine selbstverwaltete HBase-Installation hat einen Designengpass, der die Leistung nach Erreichen eines bestimmten Schwellenwerts einschränkt. Bigtable hat diesen Engpass nicht, sodass Sie Ihren Cluster skalieren können, um mehr Lese- und Schreibvorgänge zu verarbeiten.
- Einfache Verwaltung. Bigtable verarbeitet Aktualisierungen und Neustarts transparent und sorgt automatisch für die Langlebigkeit der Daten. Wenn Sie Ihre Daten replizieren möchten, fügen Sie Ihrer Instanz einen zweiten Cluster hinzu. Die Replikation wird dann automatisch gestartet. Sie müssen keine Replikate oder Regionen mehr verwalten. Entwerfen Sie einfach Ihre Tabellenschemas und Bigtable erledigt den Rest für Sie.
- Größenänderung des Clusters ohne Ausfallzeiten. Sie können die Größe eines Bigtable-Clusters für einige Stunden erhöhen, um eine große Last zu bewältigen, und dann die Größe des Clusters wieder reduzieren – ohne Ausfallzeiten. Nach der Änderung der Clustergröße dauert es unter Last meist nur wenige Minuten, bis Bigtable die Leistung auf alle Knoten im Cluster verteilt.
- Mehrstufiger Speicher (Vorabversion). Sie können selten aufgerufene Daten in einer separaten, kostengünstigeren Speicherstufe speichern. Mit gestuftem Speicher können Sie die Speicherstufe auswählen, die Ihren Anforderungen an den Zugriff auf Bigtable-Daten am besten entspricht.
- Autoscaling: Sie können Bigtable so konfigurieren, dass die CPU-Kapazität des Clusters kontinuierlich überwacht und die Anzahl der Knoten in einem Cluster bei Bedarf automatisch angepasst wird.
- Kostenloser Testzeitraum. Sie können die Features und Funktionen von Bigtable 10 Tage lang kostenlos kennenlernen. Außerdem haben Sie die Möglichkeit, den kostenlosen Testzeitraum auf 90 Tage zu verlängern. Bigtable bietet eine kostenlose Bigtable-Testinstanz mit bis zu 500 GB SSD-Speicher und einem Cluster mit einem Knoten. Damit können Sie die Leistung Ihrer Anwendung testen, indem Sie Lese- und Schreibvorgänge mit hohem Volumen für Ihre Bigtable-Tabellen ausführen, um zu sehen, wie Bigtable Vorgänge mit SSD-gestützter Leistung verarbeitet.
- In-Memory-Stufe (Vorschau). Sie können für Ihre kritischen, zeitkritischen Daten eine Leselatenz von weniger als einer Millisekunde und einen hohen Durchsatz erreichen. Die In-Memory-Stufe erweitert den vorhandenen nichtflüchtigen SSD-Speicher und den kostengünstigen mehrstufigen Speicher von Bigtable um den In-Memory-Speicher (RAM), um integriertes Data Tiering innerhalb eines einheitlichen Dienstes zu ermöglichen.
Bigtable-Versionen
Bigtable-Editionen sind ein Preismodell, das verschiedene Funktionen zu unterschiedlichen Preispunkten bietet. Sie können zwischen der Standard-Enterprise- und der Premium-Enterprise Plus-Version wählen. Weitere Informationen finden Sie unter Versionen – Übersicht.
Einsatzmöglichkeit
Bigtable eignet sich ideal für Anwendungen, die einen hohen Durchsatz und eine hohe Skalierbarkeit für Schlüssel/Wert-Paar-Daten erfordern, bei denen in der Regel kein Wert größer als 10 MB ist. Bigtable überzeugt außerdem als Speicher-Engine für Batch-MapReduce-Vorgänge, Streamverarbeitung/Analyse und Anwendungen im Bereich des maschinellen Lernens.
Sie können Bigtable verwenden, um die folgenden Datentypen zu speichern und abzufragen:
- Zeitachsendaten wie CPU- und Speicherauslastung im Zeitablauf für mehrere Server
- Marketingdaten wie Einkaufsverlauf und Kundenpräferenzen
- Finanzdaten wie Transaktionsverlauf, Aktienkurse und Währungskurse
- Internet der Dinge-Daten,z. B. Nutzungsberichte von Stromzählern und Haushaltsgeräten.
- Grafikdaten wie Informationen darüber, wie Nutzer miteinander verbunden sind
Bigtable-Speichermodell
Bigtable speichert Daten in sehr skalierbaren Tabellen aus sortierten Schlüssel/Wert-Paaren. Die Tabelle besteht aus Zeilen, von denen jede typischerweise eine einzelne Entität beschreibt, und Spalten, die für jede Zeile individuelle Werte beinhalten. Ein einzelner Wert in jeder Zeile ist indexiert. Dieser Wert wird als Zeilenschlüssel bezeichnet. Spalten, die miteinander zusammenhängen, werden normalerweise in einer Spaltenfamilie gruppiert. Jede Spalte ist durch eine Kombination aus der Spaltenfamilie und einem Spaltenqualifizierer identifizierbar, bei dem es sich um einen eindeutigen Namen innerhalb der Spaltenfamilie handelt.
Jeder Schnittpunkt einer Zeile und einer Spalte kann mehrere Zellen enthalten. Jede Zelle enthält eine eindeutige Zeitstempelversion der Daten für diese Zeile und Spalte. Durch Speichern mehrerer Zellen in einer Spalte wird erfasst, wie sich die gespeicherten Daten für diese Zeile und Spalte im Laufe der Zeit geändert haben. Bigtable-Tabellen sind dünnbesetzt, wenn eine Spalte in einer bestimmten Zeile nicht verwendet wird, belegt sie keinen Platz.
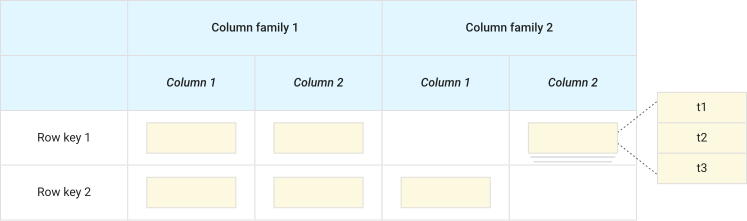
In dieser Abbildung gibt es ein paar Dinge zu beachten:
- Spalten können in einer Zeile unbenutzt sein.
- Jede Zelle in einer bestimmten Zeile und Spalte hat einen eindeutigen Zeitstempel (t).
Bigtable-Architektur
Das folgende Diagramm zeigt eine vereinfachte Version der gesamten Ressourcenarchitektur von Bigtable:
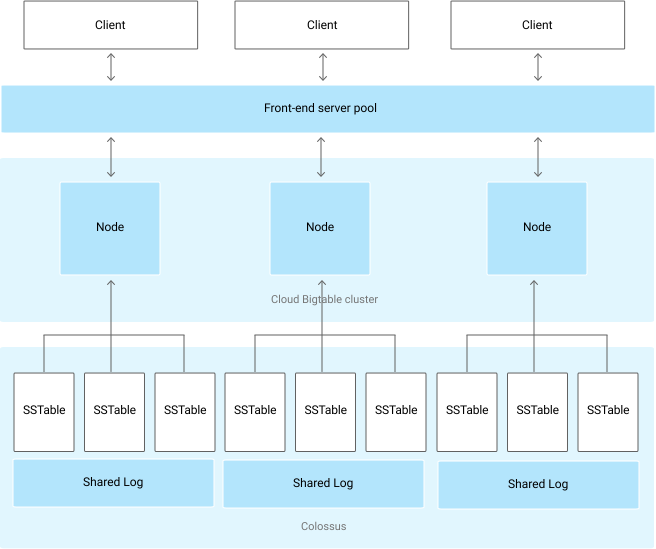
Wie im Diagramm gezeigt, laufen alle Clientanfragen durch einen Frontend-Server, bevor sie an einen Knoten in Bigtable gesendet werden. Im ursprünglichen Bigtable-Artikel werden diese Knoten als "Tablet-Server" (Tabellenreihenserver) bezeichnet. Die Knoten sind in einem Bigtable-Cluster organisiert, der zu einer Bigtable-Instanz gehört, einem Container für den Cluster.
Jeder Knoten im Cluster verarbeitet einen Teil der Anfragen an den Cluster. Wenn Sie einem Cluster Knoten hinzufügen, können Sie die Anzahl der gleichzeitigen Anfragen erhöhen, die der Cluster verarbeiten kann. Durch das Hinzufügen von Knoten wird auch der maximale Durchsatz für den Cluster erhöht. Wenn Sie die Replikation durch Hinzufügen zusätzlicher Cluster aktivieren, können Sie auch verschiedene Arten von Traffic an verschiedene Cluster senden. Wenn ein Cluster nicht mehr verfügbar ist, kann ein Failover auf einen anderen Cluster erfolgen.
Eine Bigtable-Tabelle ist in Blöcke von fortlaufenden Zeilen unterteilt, die Tabellenreihen genannt werden. (Tabellenreihen sind HBase-Regionen ähnlich.) Tablets werden in Colossus, einem von Google entwickelten Dateisystem, im SSTable-Format gespeichert. Eine SSTable ist eine dauerhafte, sortierte, unveränderliche Zuordnung von Schlüsseln und Werten aus beliebigen Bytestrings. Jedes Tablet ist einem bestimmten Bigtable-Knoten zugeordnet. Zusätzlich zu den SSTable-Dateien werden alle Schreibvorgänge im freigegebenen Log von Colossus gespeichert, sobald sie von Bigtable bestätigt wurden. Dies sorgt für eine höhere Langlebigkeit.
Wichtig: Daten werden nie in Knoten von Bigtable selbst gespeichert. Jeder Knoten enthält Verweise auf einen in Colossus gespeicherten Satz von Tabellenreihen. Deshalb gilt:
- Das Neuausgleichen von Tablets von einem Knoten zu einem anderen erfolgt schnell, da die eigentlichen Daten nicht kopiert werden. Bigtable aktualisiert die Verweise für jeden Knoten.
- Die Wiederherstellung nach dem Ausfall eines Bigtable-Knotens erfolgt schnell, da nur Metadaten zum Ersatzknoten migriert werden müssen.
- Wenn ein Knoten in Bigtable fehlschlägt, gehen keine Daten verloren.
Weitere Informationen zur Verwendung dieser grundlegenden Bausteine finden Sie unter Instanzen, Cluster und Knoten. Weitere Informationen zur Interaktion mit Ihren Daten auf diesen Stufen finden Sie unter Auf Daten zugreifen.
Load Balancing
Jede Zone in Bigtable wird von einem Primärvorgang verwaltet, der die Arbeitslast und das Datenvolumen im Cluster ausgleicht. Bei diesem Vorgang werden stärker ausgelastete oder größere Tablets halbiert und weniger häufig aufgerufene/kleinere Tablets zusammengeführt. Bei Bedarf werden sie dann auf die Knoten verteilt. Wenn eine bestimmte Tabellenreihe Trafficspitzen erfährt, halbiert Bigtable die Tabellenreihe und verschiebt eine der neuen Tabellenreihen auf einen anderen Knoten. Bigtable verwaltet das Aufteilen, Zusammenführen und Neuausgleichen automatisch, sodass Sie Ihre Tablets nicht manuell verwalten müssen. Weitere Informationen zu diesem Prozess finden Sie unter Leistung verstehen.
Für die beste Schreibleistung von Bigtable ist es wichtig, Schreibvorgänge so gleichmäßig wie möglich auf Knoten zu verteilen. Eine Möglichkeit, dieses Ziel zu erreichen, ist die Verwendung von Zeilenschlüsseln, die keiner vorhersehbaren Reihenfolge folgen. Nutzernamen sind beispielsweise mehr oder weniger gleichmäßig im Alphabet verteilt, sodass ein Nutzername am Anfang des Zeilenschlüssels normalerweise für eine gleichmäßige Verteilung der Schreibvorgänge sorgt.
Gleichzeitig ist es sinnvoll, zusammengehörige Zeilen so zu gruppieren, dass sie nebeneinander liegen, wodurch es viel effizienter ist, mehrere Zeilen gleichzeitig zu lesen. Wenn Sie beispielsweise verschiedene Arten von Wetterdaten über einen Zeitraum speichern, könnte der Zeilenschlüssel aus dem Ort, an dem die Daten gesammelt wurden, und aus einem Zeitstempel bestehen (Beispiel: WashingtonDC#201803061617). Dieser Zeilenschlüsseltyp würde alle Daten von einem Ort in einen zusammenhängenden Bereich von Zeilen gruppieren. Für andere Orte würde der Zeilenschlüssel mit einer anderen Kennzeichnung beginnen. Wenn an vielen Orten Daten im gleichen Rhythmus gesammelt werden, wären sie immer noch gleichmäßig über alle Tabellenreihen verteilt.
Weitere Information über die Auswahl eines passenden Zeilenschlüssels für Ihre Daten finden Sie unter Zeilenschlüssel wählen.
Compute
Bigtable bietet je nach Ihren Arbeitslastanforderungen verschiedene Computing-Optionen. Standardmäßig verwendet Bigtable Clusterknoten sowohl für die Speicherung als auch für die Verarbeitung.
Für Lesejobs mit hohem Durchsatz können Sie Data Boost für Bigtable für die Rechenleistung verwenden. Mit Data Boost können Sie große Lesejobs und Abfragen über serverloses Computing senden, während Ihre Kernanwendung weiterhin Clusterknoten für das Computing verwendet. Enterprise Plus erweitert die Funktionen dieser Jobs um SQL-Unterstützung sowie Zugriff auf HDD- und mehrstufige Speicherdaten. Weitere Informationen finden Sie unter Bigtable Data Boost – Übersicht.
Für spezielle Arbeitslasten, die einen hohen Durchsatz und eine Punktleselatenz von weniger als einer Millisekunde erfordern, können Sie die In-Memory-Stufe für Ihre Bigtable-Knoten aktivieren.
Unterstützte Datentypen
Bigtable behandelt alle Daten für die meisten Anwendungen als unverarbeitete Bytestrings. Die einzige Situation, in der Bigtable versucht, den Typ zu ermitteln, ist bei Inkrementierungsvorgängen, bei denen das Ziel eine als 8-Byte-Big-Endian-Wert codierte 64-Bit-Ganzzahl sein muss.
Speicher- und Laufwerksauslastung
In den folgenden Abschnitten wird dargestellt, wie mehrere Komponenten von Bigtable die Speicher- und Laufwerksauslastung Ihrer Instanz beeinflussen.
Nicht verwendete Spalten:
Spalten, die in einer Bigtable-Zeile nicht verwendet werden, belegen in dieser Zeile keinen Speicherplatz. Jede Zeile ist im Wesentlichen eine Sammlung von Schlüssel/Wert-Einträgen, wobei der Schlüssel eine Kombination aus Spaltenfamilie, Spaltenqualifizierer und Zeitstempel ist. Wenn eine Zeile keinen Wert für eine bestimmte Spalte enthält, ist der Schlüssel/Wert-Eintrag nicht vorhanden.
Spaltenqualifizierer
Spaltenqualifizierer belegen Platz in einer Zeile, da jeder Spaltenqualifizierer, der in einer Zeile genutzt wird, in dieser Zeile gespeichert ist. Daher ist es oft effizient, Spaltenqualifizierer als Daten zu verwenden.
Weitere Informationen zu Spalten-Qualifizierern finden Sie unter Spalten.
Verdichtungen
Bigtable schreibt Ihre Tabellen regelmäßig neu, um gelöschte Einträge zu entfernen, Ihre Daten so zu reorganisieren, dass Lese- und Schreibvorgänge effizienter sind, und Daten im Rahmen von mehrstufigem Speicher zu verschieben. Dieser Vorgang wird als Kompaktierung bezeichnet. Es gibt keine Konfigurationseinstellungen für Verdichtungen. Bigtable verdichtet Ihre Daten automatisch. Im Durchschnitt dauert es eine Woche, bis eine Komprimierung abgeschlossen ist und Aufgaben wie das Löschen von Daten oder das Verschieben von Daten in einen gestuften Speicher ausgeführt werden.Bei der Komprimierung werden die durch den automatischen Speicherbereinigungsprozess identifizierten Löschvorgänge ausgeführt. Durch die Verdichtung wird keine Datenkomprimierung initiiert. Bigtable komprimiert Datenblöcke automatisch, wenn sie im Speicher beibehalten werden. Weitere Informationen finden Sie unter Datenkomprimierung und automatische Speicherbereinigung. Weitere Informationen zu Komprimierungen in gestaffeltem Speicher finden Sie unter Funktionsweise von gestaffeltem Speicher.
Mutationen und Löschungen
Mutationen oder Änderungen beanspruchen mehr Speicherplatz, da Mutationen von Bigtable sequenziell gespeichert und nur von Zeit zu Zeit verdichtet werden. Wenn Bigtable eine Tabelle verdichtet, werden alle Werte entfernt, die nicht mehr benötigt werden. Wenn Sie den Wert in einer Zelle aktualisieren, sind für einen gewissen Zeitraum sowohl der alte als auch der neue Wert auf dem Laufwerk gespeichert, bis die Daten verdichtet werden.
Löschungen erfordern ebenfalls zusätzlichen Speicherplatz, zumindest für eine kurze Zeit, da Löschungen genau genommen ein spezieller Mutationstyp sind. Bis die Tabelle verdichtet wird, benötigt das Löschen also mehr Platz, nicht weniger.
Datenkompression
Bigtable komprimiert Ihre Daten automatisch mit einem intelligenten Algorithmus, wenn Daten auf dem Laufwerk gespeichert werden. Sie können die Komprimierungseinstellungen für Ihre Tabelle nicht konfigurieren.
Komprimierung im Vergleich zur Verdichtung
Die Datenkomprimierung unterscheidet sich von der Tabellenkomprimierung:
Die Komprimierung erfolgt automatisch, wenn Daten in den Speicher geschrieben und dort gespeichert werden. Durch die Komprimierung wird die physische Bytegröße von Datenblöcken auf dem Laufwerk reduziert. Messwerte zur Speichernutzung und Abrechnungsgebühren spiegeln diese komprimierte Größe wider, nicht die unkomprimierte logische Datengröße.
Die Kompaktierung ist ein asynchroner Hintergrundwartungsprozess. Bei der Komprimierung werden Speicherdateien regelmäßig zusammengeführt und gelöschte und abgelaufene Daten dauerhaft entfernt. Durch die Komprimierung wird keine Datenkomprimierung initiiert. Ihre Daten werden bereits in komprimierter Form gespeichert.
Es ist nützlich zu wissen, wie Daten gespeichert werden, damit sie effizient komprimiert werden können:
Zufällige Daten können nicht so effizient komprimiert werden wie Daten mit Mustern. Unter Daten, die einem Muster folgen, fallen Texte wie die Seite, die Sie gerade lesen.
Die Komprimierung funktioniert am besten, wenn identische Werte nahe beieinander liegen, entweder in derselben Zeile oder in benachbarten Zeilen. Wenn Sie Ihre Zeilenschlüssel so anordnen, dass Zeilen mit identischen Datenblöcken nebeneinander liegen, können die Daten effizient komprimiert werden.
Bigtable komprimiert Werte, die bis zu 1 MiB groß sind. Wenn Sie Werte speichern, die größer als 1 MiB sind, komprimieren Sie sie, bevor Sie sie in Bigtable schreiben. So können Sie CPU-Zyklen, Serverspeicher und Netzwerkbandbreite sparen.
Datenhaltbarkeit
Wenn Sie Bigtable verwenden, werden Ihre Daten in Colossus, einem von Google entwickelten, äußerst langlebigen Dateisystem, gespeichert. Dabei werden Speichergeräte in Rechenzentren vonGoogle Cloudverwendet. Sie müssen keinen HDFS-Cluster oder ein anderes Dateisystem betreiben, wenn Sie Bigtable nutzen. Hinter den Kulissen nutzt Colossus proprietäre Speichermethoden, um eine Datenlanglebigkeit zu erreichen, die über den Werten liegt, die eine standardmäßige dreifache HDFS-Replikation bietet.
Die Langlebigkeit wird bei der Verwendung der Replikation weiter verbessert. Bigtable verwaltet eine separate Kopie Ihrer Daten an dem Standort, den Sie für jeden Cluster einer replizierten Instanz auswählen.
Konsistenzmodell
Single-Cluster-Bigtable-Instanzen bieten strikte Konsistenz. Standardmäßig bieten Instanzen mit mehr als einem Cluster Eventual Consistency. Sie können jedoch für einige Anwendungsfälle eine Read-Your-Writes-Konsistenz oder strikte Konsistenz konfigurieren, je nach den Einstellungen für Arbeitslast und Anwendungsprofil.
Sicherheit
Der Zugriff auf Ihre Bigtable-Tabellen wird über Ihr Google Cloud-Projekt und die IAM-Rollen (Identity and Access Management) gesteuert, die Sie Nutzern zuweisen. Sie können beispielsweise IAM-Rollen zuweisen, die verhindern, dass einzelne Nutzer Tabellen lesen, in Tabellen schreiben oder neue Instanzen erstellen. Wenn jemand keinen Zugriff auf Ihr Projekt hat oder keine IAM-Rolle mit den entsprechenden Berechtigungen für Bigtable besitzt, kann er auf keine Ihrer Tabellen zugreifen.
Sie können den Zugriff auf Tabellendaten auch steuern, indem Sie eine autorisierte Ansicht einer Tabelle erstellen, die eine Teilmenge der Tabellendaten darstellt. Anschließend können Sie einigen Nutzern Berechtigungen auf der Ebene der autorisierten Ansicht gewähren, ohne ihnen Berechtigungen auf Tabellenebene zu erteilen. Sie können die Sicherheit auf Projekt-, Instanz-, Tabellen- oder autorisierter Ansichtsebene verwalten. Bigtable unterstützt keine Sicherheitseinschränkungen auf Zeilen-, Spalten- oder Zellebene.Verschlüsselung
Standardmäßig werden alle in Google Cloudgespeicherten Daten, einschließlich der Daten in Bigtable-Tabellen, im Ruhezustand verschlüsselt. Dies geschieht mit denselben gehärteten Schlüsselverwaltungssystemen, die wir für unsere eigenen verschlüsselten Daten verwenden.
Wenn Sie mehr Kontrolle über die Schlüssel haben, die zum Verschlüsseln Ihrer inaktiven Bigtable-Daten verwendet werden, können Sie kundenverwaltete Verschlüsselungsschlüssel (Customer-Managed Encryption Keys, CMEK) verwenden.
Sicherungen
Mit Bigtable-Sicherungen können Sie eine Kopie des Schemas und der Daten einer Tabelle speichern und später in einer neuen Tabelle wiederherstellen. Mit Sicherungen und Sicherungskopien können Sie eine neue Tabelle in jeder Region oder jedem Projekt wiederherstellen, in dem Sie eine Bigtable-Instanz haben, unabhängig davon, wo sich die Quelltabelle befindet.
Change Data Capture
Bigtable bietet Change Data Capture (CDC) in Form von Änderungsstreams. Mit Änderungsstreams können Sie Datenänderungen an einer Tabelle erfassen und streamen, sobald die Änderungen vorgenommen werden. Sie können einen Änderungsstream mit einem Dienst wie Dataflow lesen, um Anwendungsfälle wie Datenanalysen, Audits, Archivierungsanforderungen und das Auslösen von nachgelagerter Anwendungslogik zu unterstützen. Weitere Informationen finden Sie unter Übersicht über Änderungsstreams.
Routing mit Anwendungsprofilen anfordern
Mit den Routingrichtlinien für Anwendungsprofile können Sie steuern, welche Cluster eingehende Anfragen von Ihren Anwendungen verarbeiten. Bigtable bietet die folgenden Arten von Anwendungsprofilen basierend auf dem verwendeten Rechenmodell:
Standardanwendungsprofile: Verwenden bereitgestellte Clusterknoten, um Anfragen zu verarbeiten. Sie unterstützen die folgenden Routingrichtlinien:
Single-Cluster-Routing: Sendet alle Anfragen an einen einzelnen Cluster.
Sie können die In-Memory-Stufe (Vorschau) nur für Anwendungsprofile aktivieren, die Single-Cluster-Routing verwenden. Wenn Sie ein Anwendungsprofil so konfigurieren, dass die In-Memory-Stufe in einem Cluster verwendet wird, wird der gesamte zulässige Point-Read-Traffic über die In-Memory-Stufe abgewickelt.
Multi-Cluster-Routing an einen beliebigen Cluster: Sendet Anfragen an den nächsten verfügbaren Cluster in einer Instanz, entweder unter allen Clustern oder einer angegebenen Clustergruppe.
Data Boost-Anwendungsprofile: Verwenden serverloses Computing anstelle der Clusterknoten, um Lesejobs mit hohem Durchsatz von Ihrem Hauptanwendungstraffic zu isolieren. Diese Profile sind auf eine Routingrichtlinie für einen einzelnen Cluster beschränkt.
Andere Speicherungs- und Datenbankoptionen
Bigtable ist keine herkömmliche relationale Datenbank. SQL-Abfragen werden zwar unterstützt, für bestimmte Anwendungsfälle ist jedoch möglicherweise eine andere Datenbankoption besser geeignet.
- Wenn Sie stark strukturierte Objekte in einer Dokumentendatenbank mit Unterstützung für ACID-Transaktionen und SQL-ähnliche Abfragen speichern müssen, sollten Sie sich Firestore ansehen.
- Wenn Sie Daten zwischen Nutzern in Echtzeit synchronisieren möchten, verwenden Sie Firebase Realtime Database.
- Wenn Sie interaktive Abfragen in einem System für die analytische Onlineverarbeitung (OLAP) benötigen, ist BigQuery möglicherweise das Richtige für Sie.
Weitere Informationen zu anderen Datenbankoptionen finden Sie in der Übersicht der Datenbankdienste. Google Cloud bietet außerdem verschiedene Speicheroptionen.
Nächste Schritte
- Bigtable-Kurzanleitung mit der
cbt-Befehlszeile testen, dem Befehlszeilentool für Bigtable. - Bigtable-Codelab durcharbeiten.
- Informationen zu Bigtable-Instanzen, ‑Clustern und ‑Knoten
- Mehrstufiger Speicher in Bigtable
- Bigtable-Versionen
- Informationen zur In-Memory-Stufe von Bigtable
- Mehr zum Erstellen einer Bigtable-Instanz.
- Informationen zur Migration zu Bigtable
- Mehr über die Clientbibliotheken für Cloud Bigtable lesen
- Ursprüngliches OSDI-Whitepaper zu Bigtable