


I template di inferenza pre-addestrati per l'AI in Application Design Center ti consentono di eseguire il provisioning dell'infrastruttura Google Kubernetes Engine (GKE) e di eseguire il deployment dei workload di erogazione del modello. Puoi utilizzare il template Cluster GKE di inferenza preaddestrato AI per configurare un cluster GKE privato e sicuro per l'inferenza ad alte prestazioni. Puoi quindi utilizzare il modello di workload GKE di inferenza preaddestrata AI (anteprima) per eseguire il deployment di un modello Gemma preaddestrato con un chart Helm e il motore di gestione vLLM. Il workload configura le richieste di risorse GPU e un HorizontalPodAutoscaler (HPA) che scala in base all'utilizzo della CPU.
Ad esempio, puoi eseguire il deployment dei template di cluster e workload per soddisfare le seguenti esigenze aziendali:
| Esempio | Esigenza aziendale | Implementazione |
|---|---|---|
| Analisi video in tempo reale | Un'azienda di sicurezza deve elaborare stream video da centinaia di videocamere per rilevare anomalie o oggetti specifici in tempo reale. | Esegui il deployment dei modelli di elaborazione video nel pool di nodi abilitato per GPU. Le GPU possono elaborare le richieste di throughput elevato e bassa latenza degli stream video simultanei. |
| Elaborazione di documenti specializzati | Una compagnia assicurativa deve estrarre automaticamente le informazioni da migliaia di moduli di richiesta di risarcimento giornalieri, che contengono layout e scrittura a mano diversi. | Utilizza il cluster GKE per ospitare modelli personalizzati e assicurati che i dati non lascino mai l'ambiente sicuro durante l'elaborazione. |
| Motore per suggerimenti ad alto volume | Una piattaforma di e-commerce deve fornire consigli personalizzati sui prodotti agli utenti durante i periodi di picco degli acquisti per le festività. | Utilizza l'API Gateway di Google Kubernetes Engine per instradare volumi elevati di traffico degli utenti ai modelli di suggerimento. L'API Gateway può gestire picchi di traffico improvvisi senza compromettere la latenza. |
Architettura
La seguente immagine mostra i componenti e le connessioni nel modello:
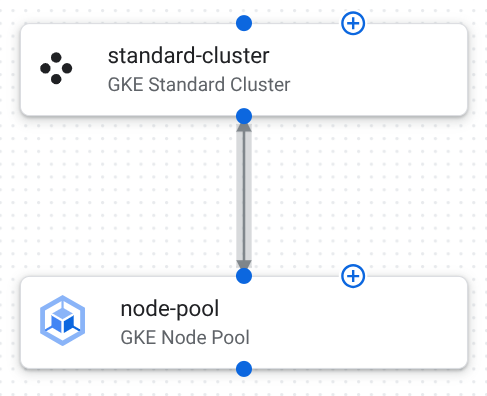
Di seguito sono descritte le configurazioni dei componenti in questo template:
Cluster GKE Standard: un cluster sicuro e privato in cui viene eseguito il workload AI.
La tabella seguente descrive la configurazione del cluster in questo template:
Configurazione Finalità node_locationsè impostato su["us-central1-a", "us-central1-b", "us-central1-c"].Garantisce alta affidabilità e resilienza distribuendo i nodi del cluster in tre zone nella regione us-central1.enable_intranode_visibilityè impostato sutrue.Abilita la visibilità del traffico tra i pod nello stesso nodo nei log di flusso VPC. Questa visibilità è necessaria per il monitoraggio della rete, la risoluzione dei problemi e l'analisi della sicurezza. gateway_api_configè abilitato utilizzando{"channel":"CHANNEL_STANDARD"}.L'API GKE Inference Gateway ti aiuta a gestire il traffico in entrata verso i tuoi servizi Kubernetes. L'API ti aiuta a configurare il routing granulare, il bilanciamento del carico avanzato e il collegamento centralizzato delle policy. private_cluster_config.enable_private_endpointè impostato sufalse.private_cluster_config.enable_private_nodesètrue.control_plane_endpoints_config.dns_endpoint_config.allow_external_trafficè impostato sutrue.Garantisce che i nodi worker su cui vengono eseguiti i modelli di AI abbiano indirizzi IP privati. In questo modo i nodi vengono isolati dalla rete internet pubblica. Il control plane di GKE è configurato in modo da essere accessibile pubblicamente per consentirti di gestire il cluster all'esterno della tua rete Virtual Private Cloud (VPC). release_channelè impostato su{"channel":"REGULAR"}.Garantisce che il cluster GKE riceva aggiornamenti stabili e prevedibili, offrendo un equilibrio tra nuove funzionalità e affidabilità. Node pool GKE: un gruppo di nodi worker che eseguono i container dell'applicazione.
La tabella seguente descrive le configurazioni dei pool di nodi in questo template:
Configurazione Finalità autoscaling.min_node_countè impostato su0.autoscaling.max_node_countè impostato su3(il valore predefinito è100).Il pool di nodi può fare lo scale down completo quando non sono in esecuzione workload di AI, riducendo i costi durante i periodi di inattività. Il limite massimo per la scalabilità consente di controllare i costi e il consumo delle risorse. Il parametro node_config.guest_acceleratorviene aggiunto.gpu_driver_installation_config.gpu_driver_version:è impostato su"LATEST".gpu_sharing_configè abilitato conTIME_SHARING.max_shared_clients_per_gpu:è impostato su2.Specifica l'utilizzo delle GPU NVIDIA L4 per le attività di inferenza AI. I driver GPU necessari vengono installati automaticamente. Più workload di dimensioni ridotte possono condividere una singola GPU. node_config.machine_typeè stato modificato in"g2-standard-8".Il tipo di macchina è progettato specificamente per integrare le GPU L4. Le vCPU (8) e la memoria (32 GB) sono create per supportare la GPU ed eseguire le tue applicazioni di inferenza AI. node_config.oauth_scopesincludehttps://www.googleapis.com/auth/cloud-platform.Il account di servizio del nodo ha un ampio accesso ai servizi Google Cloud , consentendo l'interazione con l'API per attività come il logging, il monitoraggio e il pull delle immagini container. node_config.shielded_instance_config.enable_secure_bootè impostato sutrue.L'avvio protetto aiuta a proteggere i nodi dal malware a livello di avvio verificando le firme crittografiche del bootloader e del kernel prima della loro esecuzione.
Configurazione del chart Helm
La tabella seguente elenca le configurazioni dei chart Helm, che sono state personalizzate per il deployment e la scalabilità di un servizio di inferenza AI su GKE.
| Configurazione | Finalità |
|---|---|
replicaCount: 1 |
Crea una singola replica iniziale. |
image.repository: vllm/vllm-openai |
Utilizza un'immagine vLLM, una libreria ottimizzata per l'inferenza di modelli linguistici di grandi dimensioni (LLM), esposta utilizzando un'API compatibile con OpenAI. |
model.id: google/gemma-7b-it |
Definisce il modello Gemma 7B ottimizzato per le istruzioni come modello da utilizzare. |
model.hfSecret: hf-secret |
Indica che il modello richiede l'autenticazione utilizzando un secret di Kubernetes per la gestione sicura delle credenziali. |
resources.limits e requests per nvidia.com/gpu: "1" |
Garantisce che ogni pod riceva una GPU dedicata. |
nodeSelector.cloud.google.com/gke-accelerator: nvidia-l4 |
Garantisce che i pod del modello di AI siano pianificati esclusivamente su nodi GKE Standard dotati di GPU NVIDIA L4, ideali per un'inferenza economica e ad alte prestazioni. |
hpa.enabled: true |
Abilita Horizontal Pod Autoscaler, che consente all'applicazione di scalare automaticamente il numero di pod (tra minReplicas: 1 e maxReplicas: 10) in base a targetCPUUtilizationPercentage: 80%. Garantisce le prestazioni durante i picchi di carico e l'efficienza dei costi durante i periodi di utilizzo ridotto. |
tensorParallelSize: 1 |
Indica che il modello non è suddiviso su più GPU all'interno di un singolo pod. |
maxModelLen: 512 |
Controlla la lunghezza massima della sequenza che il modello Gemma 7B può elaborare. |
service.type: ClusterIP |
Il servizio è configurato per l'accesso interno al cluster. |
pdb.enabled: true e minAvailable: 1 |
È abilitato un budget di interruzione dei pod per garantire l'alta affidabilità. Almeno una replica del modello di AI rimane disponibile durante le interruzioni volontarie, come la manutenzione dei nodi. |
Crea la tua applicazione AI
Utilizza i modelli Cluster e cluster GKE di inferenza preaddestrata AI per eseguire il deployment della tua applicazione AI.
Esegui il deployment della tua infrastruttura AI
Configura ed esegui il deployment del template Cluster GKE di inferenza preaddestrata AI per creare l'infrastruttura di base in cui viene eseguito il workload di AI.
Duplica ed esegui il deployment del template cluster GKE per inferenza pre-addestrata con AI come applicazione.
Viene creato un cluster GKE nel progetto di deployment che scegli.
Configura i componenti. Per ulteriori informazioni, consulta le seguenti risorse:
Fai clic su Esegui il deployment. Il deployment dell'applicazione viene eseguito dopo alcuni minuti.
Nel riquadro Dettagli applicazione, fai clic sulla scheda Output.
Identifica il cluster_id della tua applicazione. Utilizzerai queste informazioni quando eseguirai il deployment del chart Helm.
Esegui il deployment del tuo workload AI
Utilizza il template Workload GKE di inferenza preaddestrata AI per eseguire il deployment del workload AI nel cluster che hai creato. Eseguirai il deployment di un chart Helm che include la configurazione del workload di AI.
Nella pagina Modelli Google, fai clic su Crea nuova applicazione nel modello Workload GKE di inferenza pre-addestrata AI.
Nel campo Nome, inserisci un nome univoco per l'applicazione.
Nell'area Destinazione deployment GKE, segui questi passaggi:
Dall'elenco Progetto, seleziona il progetto in cui hai eseguito il deployment del cluster GKE dall'applicazione AI Pre-trained Inference GKE cluster.
Dall'elenco Regione, seleziona la regione in cui hai eseguito il deployment del cluster GKE.
Dall'elenco Cluster, seleziona il cluster GKE di cui è stato eseguito il deployment.
Nel campo Spazio dei nomi, inserisci lo spazio dei nomi per il tuo workload. Se non hai modificato il nome, inserisci
default.Fai clic su Crea applicazione.
L'applicazione viene creata e vengono visualizzati i file di configurazione.
Nel riquadro Chart Helm, segui questi passaggi:
Esamina i dettagli di configurazione.
(Facoltativo) Personalizza la configurazione in base alle tue esigenze specifiche.
Per eseguire il deployment del chart Helm nel cluster, fai clic su Esegui il deployment.
Per i passaggi dettagliati, consulta Esegui il deployment delle applicazioni.
Dopo alcuni minuti, viene eseguito il deployment della configurazione del chart Helm nel cluster GKE.
Passaggi successivi
- Per scoprire come duplicare e personalizzare i modelli, consulta Guida rapida: personalizza ed esegui il deployment di un modello Google.
- Definisci le tue configurazioni progettando i template di applicazione.
- Identifica le best practice generali per l'architettura con il framework di architetturaGoogle Cloud .