


תבניות ההסקה שאומנו מראש באמצעות AI ב-Application Design Center מאפשרות להקצות תשתית של Google Kubernetes Engine (GKE) ולפרוס עומסי עבודה של פרסום מודלים. אתם יכולים להשתמש בתבנית AI Pre-trained Inference GKE cluster כדי להגדיר אשכול GKE פרטי ומאובטח להסקת מסקנות עם ביצועים גבוהים. אחרי זה תוכלו להשתמש בתבנית AI Pre-trained Inference GKE workload (גרסת טרום-השקה (Preview)) כדי לפרוס מודל Gemma שעבר אימון מראש עם תרשים Helm ומנוע השירות vLLM. עומס העבודה מגדיר בקשות למשאבי GPU ו-Horizontal Pod Autoscaler (HPA) שמשתנה בהתאם לניצול ה-CPU.
לדוגמה, אפשר לפרוס את התבניות של האשכולות ועומסי העבודה כדי לתת מענה לצרכים העסקיים הבאים:
| דוגמה | הצורך העסקי | הטמעה |
|---|---|---|
| ניתוח סרטונים בזמן אמת | חברת אבטחה צריכה לעבד שידורי וידאו ממאות מצלמות כדי לזהות חריגות או אובייקטים ספציפיים בזמן אמת. | פורסים מודלים של עיבוד וידאו במאגר הצמתים שתומך ב-GPU. מעבדים גרפיים יכולים לעבד את הדרישות של שידורי וידאו בו-זמניים עם תפוקה גבוהה וזמן אחזור קצר. |
| עיבוד מסמכים מיוחדים | חברת ביטוח צריכה לחלץ באופן אוטומטי מידע מאלפי טופסי תביעה יומיים, שמכילים פריסות וכתבי יד שונים. | משתמשים באשכול GKE כדי לארח מודלים בהתאמה אישית, ומוודאים שהנתונים לא יוצאים מהסביבה המאובטחת במהלך העיבוד. |
| מנוע המלצות בנפח גבוה | פלטפורמת מסחר אלקטרוני צריכה להציג למשתמשים המלצות מותאמות אישית למוצרים במהלך אירועי קניות בשיא עונת החגים. | משתמשים ב-Google Kubernetes Engine Gateway API כדי לנתב נפחים גדולים של תנועת משתמשים למודלים של ההמלצות. Gateway API יכול להתמודד עם עליות פתאומיות בתנועה בלי לפגוע בזמן האחזור. |
ארכיטקטורה
בתמונה הבאה מוצגים הרכיבים והחיבורים בתבנית:
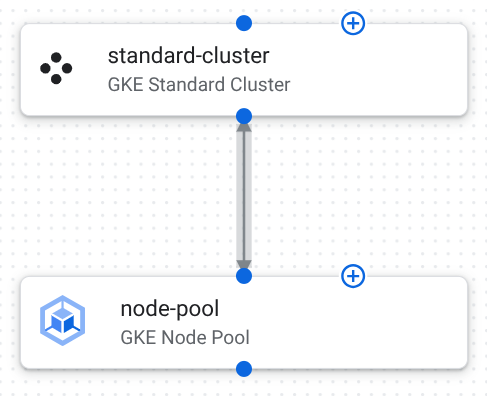
ההגדרות של הרכיבים בתבנית הזו:
אשכול GKE Standard: אשכול מאובטח ופרטי שבו פועל עומס העבודה של ה-AI.
בטבלה הבאה מתוארת הגדרת האשכול בתבנית הזו:
הגדרות אישיות מטרה הערך של node_locationsהוא["us-central1-a", "us-central1-b", "us-central1-c"].מבטיח זמינות גבוהה ועמידות על ידי פיזור הצמתים של האשכול על פני שלושה אזורים באזור us-central1.הערך של enable_intranode_visibilityהואtrue.מאפשרת לראות את התנועה בין Pods באותו צומת ביומני הזרימה של VPC. החשיפה הזו נדרשת למעקב אחרי הרשת, לפתרון בעיות ולניתוח אבטחה. gateway_api_configמופעל באמצעות{"channel":"CHANNEL_STANDARD"}.GKE Inference Gateway API עוזר לנהל את תעבורת הנתונים הנכנסת (ingress) לשירותי Kubernetes. ה-API עוזר להגדיר ניתוב מפורט, איזון עומסים מתקדם וצירוף מדיניות מרכזי. הערך של private_cluster_config.enable_private_endpointהואfalse. private_cluster_config.enable_private_nodesהיאtrue. הערך שלcontrol_plane_endpoints_config.dns_endpoint_config.allow_external_trafficהואtrue.מוודא שלצומתי העובדים שבהם פועלים מודלי ה-AI יש כתובות IP פרטיות. כך הצמתים מבודדים מהאינטרנט הציבורי. מישור הבקרה של GKE מוגדר כך שהוא נגיש באופן ציבורי, כדי שתוכלו לנהל את האשכול מחוץ לרשת הענן הפרטי הווירטואלי (VPC). הערך של release_channelהוא{"channel":"REGULAR"}.מבטיח שאשכול ה-GKE יקבל עדכונים יציבים וצפויים, תוך שמירה על איזון בין תכונות חדשות לבין אמינות. מאגר צמתים של GKE: קבוצה של צומתי עובדים שמריצים את הקונטיינרים של האפליקציה.
בטבלה הבאה מתוארות ההגדרות של מאגר הצמתים בתבנית הזו:
הגדרות אישיות מטרה הערך של autoscaling.min_node_countהוא0. הערך שלautoscaling.max_node_countמוגדר כ-3(ברירת המחדל היא100).כשלא פועלים עומסי עבודה של AI, אפשר לצמצם אנכית את מאגר הצמתים לחלוטין, וכך להפחית את העלויות בתקופות של חוסר פעילות. הגבול העליון של ההתאמה לעומס עוזר לשלוט בעלויות ובצריכת המשאבים. הפרמטר node_config.guest_acceleratorנוסף. הערך שלgpu_driver_installation_config.gpu_driver_version:הוא"LATEST". gpu_sharing_configמופעל עםTIME_SHARING. הערך שלmax_shared_clients_per_gpu:הוא2.מציינת את השימוש במעבדי NVIDIA L4 GPU למשימות של הסקת מסקנות באמצעות AI. מנהלי ההתקנים הנדרשים של ה-GPU מותקנים באופן אוטומטי. כמה עומסי עבודה קטנים יותר יכולים לחלוק GPU אחד. הערך node_config.machine_typeהשתנה ל-"g2-standard-8".סוג המכונה תוכנן במיוחד כדי להשלים את מעבדי ה-GPU מסוג L4. מעבדי ה-vCPU (8) והזיכרון (32GB) נוצרו כדי לתמוך במעבד ה-GPU ולהריץ את אפליקציות הסקת ה-AI. node_config.oauth_scopesכולל אתhttps://www.googleapis.com/auth/cloud-platform.לחשבון השירות של הצומת יש גישה רחבה לשירותי Google Cloud , שמאפשרת אינטראקציה עם ה-API למשימות כמו רישום ביומן, מעקב ומשיכת קובצי אימג' של קונטיינרים. הערך של node_config.shielded_instance_config.enable_secure_bootהואtrue.התכונה "אתחול מאובטח" עוזרת להגן על הצמתים מפני תוכנות זדוניות ברמת האתחול, על ידי אימות החתימות הקריפטוגרפיות של תוכנת האתחול ושל הליבה לפני שהן מופעלות.
הגדרת תרשים Helm
בטבלה הבאה מפורטות ההגדרות של תרשים Helm, שהותאמו אישית לפריסה ולשינוי קנה המידה של שירות הסקת AI ב-GKE.
| הגדרות אישיות | מטרה |
|---|---|
replicaCount: 1 |
יוצרת רפליקה ראשונית אחת. |
image.repository: vllm/vllm-openai |
הוא משתמש בתמונת vLLM, ספרייה שעברה אופטימיזציה להסקת מסקנות של מודל שפה גדול (LLM), שנחשפת באמצעות API שתואם ל-OpenAI. |
model.id: google/gemma-7b-it |
מגדיר את המודל Gemma 7B שעבר כוונון לפי הוראות כמודל שיוצג. |
model.hfSecret: hf-secret |
מציין שהמודל דורש אימות באמצעות Kubernetes Secret לניהול מאובטח של פרטי כניסה. |
resources.limits ו-requests עבור nvidia.com/gpu: "1" |
ההגדרה הזו מבטיחה שכל pod יקבל GPU ייעודי. |
nodeSelector.cloud.google.com/gke-accelerator: nvidia-l4 |
מוודא שהפודים של מודל ה-AI מתוזמנים רק בצומתי GKE Standard שמצוידים במעבדי NVIDIA L4 GPU, שמתאימים במיוחד להסקת מסקנות חסכונית ובעלת ביצועים גבוהים. |
hpa.enabled: true |
הפעלת Horizontal Pod Autoscaler (HPA), שמאפשר לאפליקציה לבצע התאמה אוטומטית לעומס של מספר ה-Pods (בין minReplicas: 1 ל-maxReplicas: 10) על סמך targetCPUUtilizationPercentage: 80%. הוא מבטיח ביצועים טובים בעומסי שיא וחיסכון בעלויות כשהשימוש נמוך. |
tensorParallelSize: 1 |
מציין שהמודל לא מפוצל בין כמה יחידות GPU ב-Pod אחד. |
maxModelLen: 512 |
המדיניות קובעת את אורך הרצף המקסימלי שמודל Gemma 7B יכול לעבד. |
service.type: ClusterIP |
השירות מוגדר לגישה פנימית בתוך האשכול. |
pdb.enabled: true וגם minAvailable: 1 |
כדי להבטיח זמינות גבוהה, מופעל תקציב לשיבוש Pod. לפחות רפליקה אחת של מודל ה-AI נשארת זמינה במהלך שיבושים יזומים, כמו תחזוקת צמתים. |
יצירת אפליקציית AI
משתמשים בתבניות AI Pre-trained Inference GKE cluster and workload כדי לפרוס את אפליקציית ה-AI.
פריסת תשתית ה-AI
מגדירים ופורסים את התבנית AI Pre-trained Inference GKE cluster כדי ליצור את התשתית הבסיסית שבה פועל עומס העבודה של ה-AI.
משכפלים ופורסים את התבנית AI Pre-trained Inference אשכול GKE כאפליקציה.
אשכול GKE נוצר בפרויקט הפריסה שבחרתם.
מגדירים את הרכיבים. למידע נוסף, קראו את המאמרים הבאים:
לוחצים על Deploy. האפליקציה נפרסת אחרי כמה דקות.
בחלונית Application details, לוחצים על הכרטיסייה Outputs.
מזהים את ה-cluster_id של האפליקציה. תצטרכו את המידע הזה כשתפרסו את תרשים ה-Helm.
פריסת עומס העבודה של ה-AI
משתמשים בתבנית AI Pre-trained Inference GKE workload כדי לפרוס את עומס העבודה של ה-AI באשכול שיצרתם. תפרסו תרשים Helm שכולל את הגדרת עומס העבודה של ה-AI.
בדף Google templates, בתבנית AI Pre-trained Inference GKE workload, לוחצים על Create new application.
בשדה Name, מזינים שם ייחודי לאפליקציה.
באזור GKE Deployment Target:
ברשימה Project, בוחרים את הפרויקט שבו פרסתם את אשכול GKE מהאפליקציה AI Pre-trained Inference GKE cluster.
ברשימה Region, בוחרים את האזור שבו פרסתם את אשכול GKE.
ברשימה Clusters, בוחרים את אשכול GKE שנפרס.
בשדה Namespace, מזינים את מרחב השמות של עומס העבודה. אם לא שיניתם את השם, הזינו
default.לוחצים על Create application.
האפליקציה נוצרת ומוצגים קובצי התצורה.
בחלונית Helm chart:
בודקים את פרטי ההגדרות.
אופציונלי: התאמה אישית של ההגדרות בהתאם לצרכים הייחודיים שלכם.
כדי לפרוס את תרשים Helm באשכול, לוחצים על Deploy.
אחרי כמה דקות, ההגדרות של תרשים Helm יתפרסו באשכול GKE.
המאמרים הבאים
- במאמר מדריך למתחילים: התאמה אישית ופריסה של תבנית Google מוסבר איך לשכפל ולהתאים אישית תבניות.
- להגדיר הגדרות משלכם באמצעות עיצוב תבניות של אפליקציות.
- לזהות שיטות מומלצות כלליות לארכיטקטורה באמצעות Google Cloud Architecture Framework.