


Les modèles d'inférence pré-entraînés d'IA dans Application Design Center vous permettent de provisionner l'infrastructure Google Kubernetes Engine (GKE) et de déployer des charges de travail de mise en service de modèles. Vous pouvez utiliser le modèle de cluster GKE d'inférence pré-entraîné par l'IA pour configurer un cluster GKE privé et sécurisé pour l'inférence hautes performances. Vous pouvez ensuite utiliser le modèle de charge de travail GKE d'inférence pré-entraînée d'IA (preview) pour déployer un modèle Gemma pré-entraîné avec un graphique Helm et le moteur de diffusion vLLM. La charge de travail configure les requêtes de ressources GPU et un autoscaler horizontal des pods (AHP) qui effectue un scaling en fonction de l'utilisation du processeur.
Par exemple, vous pouvez déployer les modèles de cluster et de charge de travail pour répondre aux besoins métier suivants :
| Exemple | Besoin | Implémentation |
|---|---|---|
| Analyse vidéo en temps réel | Une entreprise de sécurité doit traiter les flux vidéo de centaines de caméras pour détecter des anomalies ou des objets spécifiques en temps réel. | Déployer des modèles de traitement de vidéos sur le pool de nœuds compatible GPU. Les GPU peuvent traiter les exigences de débit élevé et de faible latence des flux vidéo simultanés. |
| Traitement de documents spécialisés | Une compagnie d'assurance doit extraire automatiquement des informations de milliers de formulaires de réclamation quotidiens, qui présentent des mises en page et des écritures manuscrites variées. | Utiliser le cluster GKE pour héberger des modèles personnalisés et s'assurer que les données ne quittent jamais l'environnement sécurisé pendant le traitement. |
| Moteur de recommandations à volume élevé | Une plate-forme d'e-commerce doit proposer des recommandations de produits personnalisées aux utilisateurs pendant les pics d'achats des fêtes. | Utilisez l'API Google Kubernetes Engine Gateway pour acheminer des volumes élevés de trafic utilisateur vers les modèles de recommandation. L'API Gateway peut gérer les pics de trafic soudains sans dégradation de la latence. |
Architecture
L'image suivante montre les composants et les connexions du modèle :
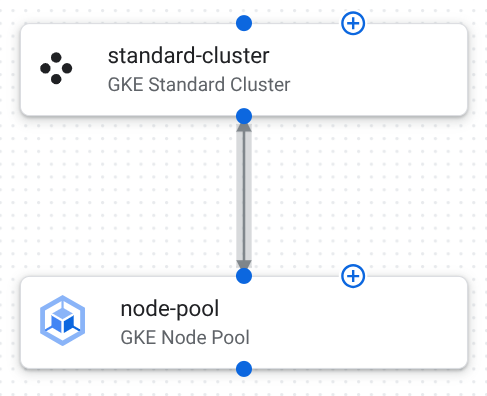
Voici les configurations des composants de ce modèle :
Cluster GKE Standard : cluster sécurisé et privé dans lequel s'exécute votre charge de travail d'IA.
Le tableau suivant décrit la configuration du cluster dans ce modèle :
Configuration Objectif La propriété node_locationsest définie sur["us-central1-a", "us-central1-b", "us-central1-c"].Garantit une haute disponibilité et une résilience en répartissant les nœuds du cluster sur trois zones de la région us-central1.La propriété enable_intranode_visibilityest définie surtrue.Active la visibilité du trafic entre pods sur le même nœud dans les journaux de flux VPC. Cette visibilité est requise pour la surveillance du réseau, le dépannage et l'analyse de la sécurité. gateway_api_configest activé à l'aide de{"channel":"CHANNEL_STANDARD"}.L'API GKE Inference Gateway vous aide à gérer le trafic d'entrée vers vos services Kubernetes. L'API vous aide à configurer un routage ultraprécis, un équilibrage de charge avancé et l'association de règles centralisée. La propriété private_cluster_config.enable_private_endpointest définie surfalse.private_cluster_config.enable_private_nodesest défini surtrue.control_plane_endpoints_config.dns_endpoint_config.allow_external_trafficest défini surtrue.Garantit que les nœuds de calcul sur lesquels vos modèles d'IA s'exécutent disposent d'adresses IP privées. Cela permet d'isoler vos nœuds de l'Internet public. Le plan de contrôle GKE est configuré pour être accessible publiquement afin de vous permettre de gérer le cluster en dehors de votre réseau de cloud privé virtuel (VPC). La propriété release_channelest définie sur{"channel":"REGULAR"}.Il garantit que votre cluster GKE reçoit des mises à jour stables et prévisibles, offrant un équilibre entre nouvelles fonctionnalités et fiabilité. Pool de nœuds GKE : groupe de nœuds de calcul qui exécutent les conteneurs de l'application.
Le tableau suivant décrit les configurations de pool de nœuds de ce modèle :
Configuration Objectif La propriété autoscaling.min_node_countest définie sur0.autoscaling.max_node_countest défini sur3(la valeur par défaut est100).Le pool de nœuds peut effectuer un scaling à la baisse complet lorsqu'aucune charge de travail d'IA n'est en cours d'exécution, ce qui réduit les coûts pendant les périodes d'inactivité. La limite supérieure de scaling permet de contrôler les coûts et la consommation de ressources. Le paramètre node_config.guest_acceleratorest ajouté.gpu_driver_installation_config.gpu_driver_version:est défini sur"LATEST".gpu_sharing_configest activé avecTIME_SHARING.max_shared_clients_per_gpu:est défini sur2.Spécifie l'utilisation de GPU NVIDIA L4 pour les tâches d'inférence d'IA. Les pilotes de GPU nécessaires sont installés automatiquement. Plusieurs charges de travail plus petites peuvent partager un même GPU. node_config.machine_typedevient"g2-standard-8".Le type de machine est spécialement conçu pour compléter les GPU L4. Les processeurs virtuels (8) et la mémoire (32 Go) sont créés pour prendre en charge le GPU et exécuter vos applications d'inférence d'IA. node_config.oauth_scopesincluthttps://www.googleapis.com/auth/cloud-platform.Le compte de service du nœud dispose d'un accès étendu aux services Google Cloud , ce qui permet l'interaction avec l'API pour des tâches telles que la journalisation, la surveillance et l'extraction d'images de conteneurs. La propriété node_config.shielded_instance_config.enable_secure_bootest définie surtrue.Le démarrage sécurisé permet de protéger vos nœuds contre les logiciels malveillants au niveau du démarrage en vérifiant les signatures cryptographiques du chargeur d'amorçage et du noyau avant leur exécution.
Configuration du chart Helm
Le tableau suivant répertorie les configurations de chart Helm, qui ont été personnalisées pour déployer et faire évoluer un service d'inférence d'IA sur GKE.
| Configuration | Objectif |
|---|---|
replicaCount: 1 |
Crée une seule instance répliquée initiale. |
image.repository: vllm/vllm-openai |
Utilise une image vLLM, une bibliothèque optimisée pour l'inférence de grands modèles de langage (LLM), exposée à l'aide d'une API compatible avec OpenAI. |
model.id: google/gemma-7b-it |
Définit le modèle Gemma 7B adapté aux instructions comme modèle à diffuser. |
model.hfSecret: hf-secret |
Indique que le modèle nécessite une authentification à l'aide d'un secret Kubernetes pour une gestion sécurisée des identifiants. |
resources.limits et requests pour nvidia.com/gpu: "1" |
S'assure que chaque pod dispose d'un GPU dédié. |
nodeSelector.cloud.google.com/gke-accelerator: nvidia-l4 |
S'assure que vos pods de modèle d'IA sont planifiés exclusivement sur des nœuds GKE Standard équipés de GPU NVIDIA L4, qui sont idéaux pour une inférence économique et hautes performances. |
hpa.enabled: true |
Active l'autoscaler horizontal des pods, qui permet à l'application d'ajuster automatiquement le nombre de pods (entre minReplicas: 1 et maxReplicas: 10) en fonction de targetCPUUtilizationPercentage: 80%. Assure les performances lors des pics de charge et la rentabilité en cas de faible utilisation. |
tensorParallelSize: 1 |
Indique que le modèle n'est pas réparti sur plusieurs GPU au sein d'un même pod. |
maxModelLen: 512 |
Contrôle la longueur maximale de la séquence que le modèle Gemma 7B peut traiter. |
service.type: ClusterIP |
Le service est configuré pour un accès interne au sein du cluster. |
pdb.enabled: true et minAvailable: 1 |
Un budget d'interruptions de pods est activé pour assurer une haute disponibilité. Au moins une instance répliquée de votre modèle d'IA reste disponible lors des interruptions volontaires, comme la maintenance des nœuds. |
Créer votre application d'IA
Utilisez les modèles cluster GKE et charge de travail d'inférence pré-entraînée d'IA pour déployer votre application d'IA.
Déployer votre infrastructure d'IA
Configurez et déployez le modèle de cluster GKE d'inférence d'IA pré-entraîné pour créer l'infrastructure de base sur laquelle s'exécute votre charge de travail d'IA.
Dupliquez et déployez le modèle Cluster GKE d'inférence pré-entraîné par l'IA en tant qu'application.
Un cluster GKE est créé dans le projet de déploiement que vous choisissez.
Configurez les composants. Pour en savoir plus, consultez les ressources suivantes :
Cliquez sur Déployer. L'application est déployée après plusieurs minutes.
Dans le panneau Détails de l'application, cliquez sur l'onglet Sorties.
Identifiez l'cluster_id de votre application. Vous utiliserez ces informations lorsque vous déploierez votre chart Helm.
Déployer votre charge de travail d'IA
Utilisez le modèle de charge de travail GKE d'inférence pré-entraînée d'IA pour déployer votre charge de travail d'IA dans le cluster que vous avez créé. Vous allez déployer un chart Helm qui inclut la configuration de votre charge de travail d'IA.
Sur la page Catalogue Google, dans le modèle Charge de travail GKE d'inférence pré-entraînée d'IA, cliquez sur Créer une application.
Dans le champ Nom, saisissez un nom unique pour votre application.
Dans la zone Cible de déploiement GKE, procédez comme suit :
Dans la liste des projets, sélectionnez le projet dans lequel vous avez déployé le cluster GKE à partir de votre application Cluster GKE d'inférence pré-entraînée d'IA.
Dans la liste Région, sélectionnez la région dans laquelle vous avez déployé le cluster GKE.
Dans la liste Clusters, sélectionnez le cluster GKE déployé.
Dans la liste Espace de noms, saisissez l'espace de noms dans lequel vous avez déployé votre cluster GKE. Si vous n'avez pas modifié le nom, saisissez
default.Cliquez sur Créer une application.
L'application est créée et les fichiers de configuration s'affichent.
Dans le panneau Graphique Helm, procédez comme suit :
Vérifiez les détails de la configuration.
Facultatif : personnalisez la configuration pour répondre à vos besoins spécifiques.
Pour déployer le chart Helm sur votre cluster, cliquez sur Déployer.
Pour connaître la procédure détaillée, consultez Déployer des applications.
Après quelques minutes, la configuration du chart Helm est déployée sur votre cluster GKE.
Étapes suivantes
- Pour savoir comment dupliquer et personnaliser des modèles, consultez Guide de démarrage rapide : Personnaliser et déployer un modèle Google.
- Définissez vos propres configurations en concevant des modèles d'application.
- Identifiez les bonnes pratiques générales d'architecture avec le Google Cloud framework d'architecture.