


Mit den vortrainierten KI-Inferenzvorlagen im Application Design Center können Sie die Google Kubernetes Engine-Infrastruktur (GKE) bereitstellen und Arbeitslasten für die Modellbereitstellung bereitstellen. Mit der Vorlage AI Pre-trained Inference GKE cluster können Sie einen sicheren, privaten GKE-Cluster für leistungsstarke Inferenz einrichten. Anschließend können Sie die Vorlage AI Pre-trained Inference GKE workload (Vorschau) verwenden, um ein vortrainiertes Gemma-Modell mit einem Helm-Diagramm und der vLLM-Bereitstellungs-Engine bereitzustellen. Die Arbeitslast konfiguriert GPU-Ressourcenanfragen und einen Horizontal Pod Autoscaler (HPA), der basierend auf der CPU-Auslastung skaliert.
Sie können die Cluster- und Arbeitslastvorlagen beispielsweise bereitstellen, um die folgenden geschäftlichen Anforderungen zu erfüllen:
| Beispiel | Geschäftliche Anforderung | Implementierung |
|---|---|---|
| Echtzeit-Videoanalyse | Ein Sicherheitsunternehmen muss Videostreams von Hunderten von Kameras verarbeiten, um Anomalien oder bestimmte Objekte in Echtzeit zu erkennen. | Videoverarbeitungsmodelle im GPU-fähigen Knotenpool bereitstellen GPUs können die Anforderungen an hohen Durchsatz und niedrige Latenz von gleichzeitigen Videostreams erfüllen. |
| Spezialisierte Dokumentverarbeitung | Eine Versicherungsgesellschaft muss täglich Informationen aus Tausenden von Antragsformularen mit unterschiedlichen Layouts und Handschriften extrahieren. | Verwenden Sie den GKE-Cluster, um benutzerdefinierte Modelle zu hosten, und sorgen Sie dafür, dass Daten während der Verarbeitung die sichere Umgebung nie verlassen. |
| Empfehlungssystem für große Datenmengen | Eine E-Commerce-Plattform muss Nutzern während der Haupteinkaufszeiten an Feiertagen personalisierte Produktempfehlungen bereitstellen. | Verwenden Sie die Google Kubernetes Engine Gateway API, um große Mengen an Nutzertraffic an die Empfehlungsmodelle weiterzuleiten. Die Gateway API kann plötzliche Trafficspitzen ohne Latenzverschlechterung bewältigen. |
Architektur
Die folgende Abbildung zeigt die Komponenten und Verbindungen in der Vorlage:
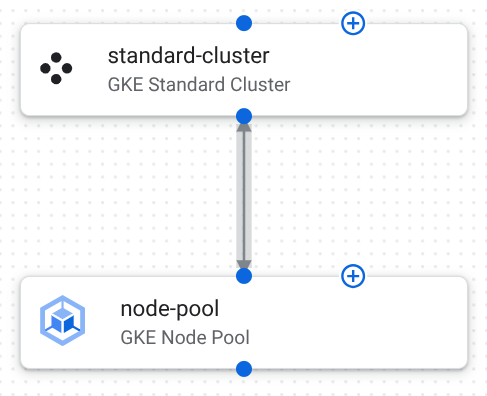
Im Folgenden werden die Komponentenkonfigurationen in dieser Vorlage beschrieben:
GKE-Standardcluster: Ein sicherer und privater Cluster, in dem Ihre KI-Arbeitslast ausgeführt wird.
In der folgenden Tabelle wird die Clusterkonfiguration in dieser Vorlage beschrieben:
Konfiguration Zweck node_locationsist auf["us-central1-a", "us-central1-b", "us-central1-c"]gesetzt.Sorgt für Hochverfügbarkeit und Ausfallsicherheit, indem die Knoten des Clusters auf drei Zonen in der Region us-central1verteilt werden.enable_intranode_visibilityist auftruegesetzt.Ermöglicht die Sichtbarkeit von Pod-zu-Pod-Traffic auf demselben Knoten in VPC-Flusslogs. Diese Sichtbarkeit ist für das Netzwerkmonitoring, die Fehlerbehebung und die Sicherheitsanalyse erforderlich. gateway_api_configwird mit{"channel":"CHANNEL_STANDARD"}aktiviert.Mit der GKE Inference Gateway API können Sie eingehenden Traffic zu Ihren Kubernetes-Diensten verwalten. Mit der API können Sie detailliertes Routing, erweitertes Load Balancing und zentralisiertes Anhängen von Richtlinien konfigurieren. private_cluster_config.enable_private_endpointist auffalsegesetzt.private_cluster_config.enable_private_nodesisttrue.control_plane_endpoints_config.dns_endpoint_config.allow_external_trafficist auftruegesetzt.Sorgt dafür, dass die Worker-Knoten, auf denen Ihre KI-Modelle ausgeführt werden, private IP-Adressen haben. Dadurch werden Ihre Knoten vom öffentlichen Internet isoliert. Die GKE-Steuerungsebene ist so konfiguriert, dass sie öffentlich zugänglich ist, damit Sie den Cluster außerhalb Ihres VPC-Netzwerks (Virtual Private Cloud) verwalten können. release_channelist auf{"channel":"REGULAR"}gesetzt.Sorgt dafür, dass Ihr GKE-Cluster stabile und vorhersehbare Updates erhält, und bietet ein ausgewogenes Verhältnis zwischen neuen Funktionen und Zuverlässigkeit. GKE-Knotenpool: Eine Gruppe von Worker-Knoten, auf denen die Container der Anwendung ausgeführt werden.
In der folgenden Tabelle werden die Knotenpoolkonfigurationen in dieser Vorlage beschrieben:
Konfiguration Zweck autoscaling.min_node_countist auf0gesetzt.autoscaling.max_node_countist auf3festgelegt (Standardwert ist100).Der Knotenpool kann vollständig herunterskaliert werden, wenn keine KI-Arbeitslasten ausgeführt werden. Dadurch werden die Kosten in inaktiven Zeiten gesenkt. Die Obergrenze für die Skalierung hilft, Kosten und Ressourcenverbrauch zu kontrollieren. Der Parameter node_config.guest_acceleratorwird hinzugefügt.gpu_driver_installation_config.gpu_driver_version:ist auf"LATEST"gesetzt.gpu_sharing_configist mitTIME_SHARINGaktiviert.max_shared_clients_per_gpu:ist auf2gesetzt.Gibt die Verwendung von NVIDIA L4-GPUs für KI-Inferenzaufgaben an. Die erforderlichen GPU-Treiber werden automatisch installiert. Mehrere kleinere Arbeitslasten können sich eine einzelne GPU teilen. „ node_config.machine_type“ wird zu „"g2-standard-8"“ geändert.Der Maschinentyp ist speziell auf die L4-GPUs abgestimmt. vCPUs (8) und Arbeitsspeicher (32 GB) sind so konzipiert, dass sie die GPU unterstützen und Ihre KI-Inferenzanwendungen ausführen können. node_config.oauth_scopesenthälthttps://www.googleapis.com/auth/cloud-platform.Das Dienstkonto des Knotens hat umfassenden Zugriff auf Google Cloud -Dienste, was die API-Interaktion für Aufgaben wie Logging, Monitoring und das Abrufen von Container-Images ermöglicht. node_config.shielded_instance_config.enable_secure_bootist auftruegesetzt.Mit Secure Boot können Sie Knoten besser vor Malware auf Boot-Ebene schützen, indem die kryptografischen Signaturen des Bootloaders und des Kernels vor der Ausführung überprüft werden.
Helm-Diagrammkonfiguration
In der folgenden Tabelle sind die Helm-Diagrammkonfigurationen aufgeführt, die für die Bereitstellung und Skalierung eines KI-Inferenzdienstes in GKE angepasst wurden.
| Konfiguration | Zweck |
|---|---|
replicaCount: 1 |
Erstellt ein einzelnes erstes Replikat. |
image.repository: vllm/vllm-openai |
Verwendet ein vLLM-Image, eine optimierte Bibliothek für die Inferenz von Large Language Models (LLMs), die über eine OpenAI-kompatible API bereitgestellt wird. |
model.id: google/gemma-7b-it |
Definiert das für Anweisungen abgestimmte Gemma 7B-Modell als das bereitzustellende Modell. |
model.hfSecret: hf-secret |
Gibt an, dass das Modell eine Authentifizierung mit einem Kubernetes-Secret für die sichere Verwaltung von Anmeldedaten erfordert. |
resources.limits und requests für nvidia.com/gpu: "1" |
Sorgt dafür, dass jeder Pod eine dedizierte GPU erhält. |
nodeSelector.cloud.google.com/gke-accelerator: nvidia-l4 |
Stellt sicher, dass Ihre KI-Modell-Pods ausschließlich auf GKE Standard-Knoten mit NVIDIA L4-GPUs geplant werden, die sich ideal für kostengünstige und leistungsstarke Inferenzen eignen. |
hpa.enabled: true |
Aktiviert das horizontale Pod-Autoscaling, mit dem die Anwendung die Anzahl der Pods (zwischen minReplicas: 1 und maxReplicas: 10) basierend auf targetCPUUtilizationPercentage: 80% automatisch skalieren kann. Sorgt für Leistung bei Spitzenlasten und Kosteneffizienz bei geringer Nutzung. |
tensorParallelSize: 1 |
Gibt an, dass das Modell nicht auf mehrere GPUs innerhalb eines einzelnen Pods aufgeteilt ist. |
maxModelLen: 512 |
Steuert die maximale Sequenzlänge, die das Gemma 7B-Modell verarbeiten kann. |
service.type: ClusterIP |
Der Dienst ist für den internen Zugriff innerhalb des Clusters konfiguriert. |
pdb.enabled: true und minAvailable: 1 |
Ein Budget für Pod-Störungen ist aktiviert, um Hochverfügbarkeit zu gewährleisten. Bei freiwilligen Unterbrechungen wie der Knotenwartung bleibt mindestens ein Replikat Ihres KI-Modells verfügbar. |
KI-Anwendung erstellen
Verwenden Sie die Vorlagen AI Pre-trained Inference GKE-Cluster and workload, um Ihre KI-Anwendung bereitzustellen.
KI-Infrastruktur bereitstellen
Konfigurieren und stellen Sie die Vorlage GKE-Cluster für vortrainierte KI-Inferenz bereit, um die grundlegende Infrastruktur zu erstellen, auf der Ihre KI-Arbeitslast ausgeführt wird.
Duplizieren und stellen Sie die Vorlage AI Pre-trained Inference GKE cluster als Anwendung bereit.
Im ausgewählten Bereitstellungsprojekt wird ein GKE-Cluster erstellt.
Konfigurieren Sie die Komponenten. Hier finden Sie weitere Informationen:
Klicken Sie auf Bereitstellen. Die Anwendung wird nach einigen Minuten bereitgestellt.
Klicken Sie im Bereich Anwendungsdetails auf den Tab Ausgaben.
Ermitteln Sie die cluster_id für Ihre Anwendung. Diese Informationen benötigen Sie, wenn Sie Ihr Helm-Diagramm bereitstellen.
KI-Arbeitslast bereitstellen
Verwenden Sie die Vorlage AI Pre-trained Inference GKE workload, um Ihre KI-Arbeitslast im erstellten Cluster bereitzustellen. Sie stellen ein Helm-Diagramm bereit, das die Konfiguration Ihrer KI-Arbeitslast enthält.
Klicken Sie auf der Seite Google-Vorlagen in der Vorlage AI Pre-trained Inference GKE workload auf Neue Anwendung erstellen.
Geben Sie im Feld Name einen eindeutigen Namen für Ihre Anwendung ein.
Führen Sie im Bereich GKE-Bereitstellungsziel die folgenden Schritte aus:
Wählen Sie in der Liste Projekt das Projekt aus, in dem Sie den GKE-Cluster aus Ihrer AI Pre-trained Inference GKE cluster-Anwendung bereitgestellt haben.
Wählen Sie in der Liste Region die Region aus, in der Sie den GKE-Cluster bereitgestellt haben.
Wählen Sie in der Liste Cluster den bereitgestellten GKE-Cluster aus.
Geben Sie im Feld Namespace den Namespace für Ihre Arbeitslast ein. Wenn Sie den Namen nicht geändert haben, geben Sie
defaultein.Klicken Sie auf Anwendung erstellen.
Die Anwendung wird erstellt und die Konfigurationsdateien werden angezeigt.
Führen Sie im Bereich Helm-Diagramm folgende Schritte aus:
Sehen Sie sich die Konfigurationsdetails an.
Optional: Passen Sie die Konfiguration an Ihre individuellen Anforderungen an.
Klicken Sie auf Bereitstellen, um das Helm-Diagramm in Ihrem Cluster bereitzustellen.
Eine ausführliche Anleitung finden Sie unter Anwendungen bereitstellen.
Nach einigen Minuten wird die Helm-Diagrammkonfiguration in Ihrem GKE-Cluster bereitgestellt.
Nächste Schritte
- Informationen zum Duplizieren und Anpassen von Vorlagen finden Sie unter Kurzanleitung: Google-Vorlage anpassen und bereitstellen.
- Sie können eigene Konfigurationen definieren, indem Sie Anwendungsvorlagen entwerfen.
- Allgemeine Best Practices für die Architektur mit dem Google Cloud Architecture Framework identifizieren