


Balanceo de cargas de alta disponibilidad para dispositivos de VCF
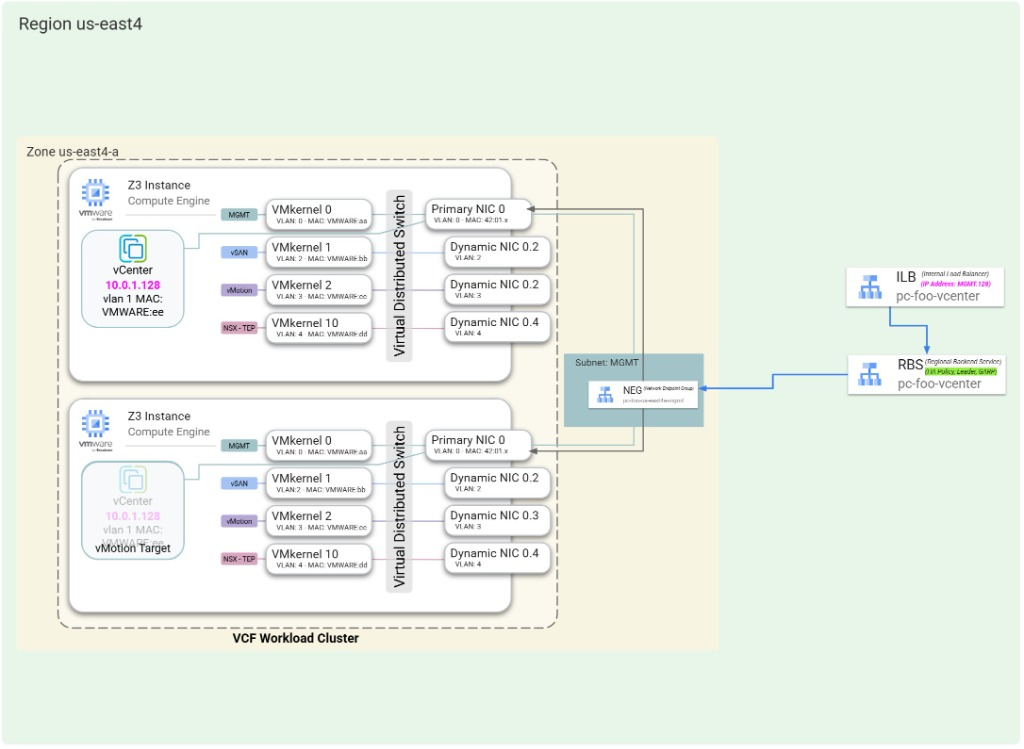
En este documento, se explica cómo los balanceadores de cargas internos regionales y los grupos de extremos de red (NEG) zonales en la solución de VMware en Google Cloud proporcionan alta disponibilidad de capa 2, movilidad de máquina virtual (vMotion) y conmutación por error automatizada para los dispositivos de administración de VMware Cloud Foundation (VCF) implementados en la infraestructura de la nube privada virtual (VPC), como se muestra en el siguiente diagrama (haz clic para ampliar):
Por qué los dispositivos de la red subyacente requieren un balanceador de cargas
En los centros de datos locales, las máquinas virtuales de administración, como vCenter Server, SDDC Manager y los nodos de NSX Manager agrupados en clústeres, dependen de los dominios de transmisión físicos de capa 2. Cuando un dispositivo conmuta por error o migra entre hosts de ESXi con vMotion, el dispositivo transmite un paquete de ARP gratuito (GARP) para actualizar las tablas de direcciones MAC de los interruptores físicos de la parte superior del bastidor (ToR) de modo que su dirección IP flote entre los servidores físicos.
Una red de VPC de Google Cloud es una red definida por software (SDN) de capa 3 enrutada con los siguientes comportamientos:
- Cada dirección IP se vincula de manera programática a una interfaz de red virtual (vNIC) específica de Compute Engine en la tabla de reenvío de SDN.
- El plano de enrutamiento de VPC no depende del aprendizaje de MAC del interruptor físico para enrutar el tráfico de capa 3 a las direcciones IP flotantes.
- Si una VM de administración de infraestructura se traslada a un host de ESXi de equipos físicos diferente, la tabla de enrutamiento de VPC requiere un mecanismo explícito para dirigir el tráfico de la dirección IP de ese dispositivo a la nueva interfaz del host.
Para admitir la movilidad de IP sin actualizaciones manuales de rutas ni reasignación de direcciones de VM,
la solución de VMware aprovisiona un balanceador de cargas de red de transferencia interno regional configurado con Fast
IP Move (GARP_RA) para cada dispositivo de administración de infraestructura flotante.
Componentes de la arquitectura de alta disponibilidad
Cada dispositivo de red en la solución de VMware usa una arquitectura de balanceo de cargas de tres niveles deGoogle Cloud para admitir la alta disponibilidad y la movilidad de vMotion:
Grupos de extremos de red por zonas (NEG)
- Tipo de construcción: NEG zonales de tipo
GCE_VM_IP_DEDICATED_BACKENDconfigurados en la subred de VPC de destino. - Función: Un NEG dedicado en cada zona agrupa las interfaces de red principales o dinámicas de todas las instancias de ESXi de equipos físicos que pertenecen al dominio de movilidad de vMotion del clúster.
- Reusabilidad: Todos los balanceadores de cargas de dispositivos subyacentes dentro del mismo clúster y subred comparten un solo conjunto de NEG zonales.
Servicio de backend regional con transferencia rápida de IP
- Tipo de construcción: Servicio de backend regional (
loadBalancingScheme: INTERNAL,protocol: UNSPECIFIED) que hace referencia a los NEG zonales del clúster. - Política de conmutación por error (
haPolicy): Se configuró confastIPMove: GARP_RA. - Función: Indica al plano de datos de Andromeda de Google Cloud que supervise la subred habilitada para transmisiones en busca de tramas de GARP y de anuncio de router (RA) emitidas por la VM del dispositivo de administración y que actualice de forma dinámica el host de backend activo.
Balanceador de cargas de red de transferencia interno regional
- Tipo de construcción: Regla de reenvío interna regional configurada con la dirección IP virtual (VIP) reservada del dispositivo.
- Función: Sirve como el extremo de IP persistente para el dispositivo de administración o la VIP del clúster. Los administradores, las cargas de trabajo y otros componentes de VCF se conectan a esta dirección VIP.
Alta disponibilidad subyacente con NEG dedicados
Cuando varias interfaces de red (como la interfaz principal nic0 y
las NIC dinámicas con etiquetado de VLAN) se conectan a la misma red de VPC, los NEG estándar de GCE_VM_IP
no pueden orientarse a subinterfaces arbitrarias. En cambio, la solución de VMware
usa NEG GCE_VM_IP_DEDICATED_BACKEND, que funcionan de la siguiente manera:
- Segmentación automática de interfaces: Adjunta automáticamente la vNIC principal o la NIC dinámica específica que coincide con la subred del NEG.
- Un solo NEG por zona: Un servicio de backend regional configurado con
NEG de
GCE_VM_IP_DEDICATED_BACKENDpuede contener solo un NEG por zona. - Requisito de la política de HA interna: Los NEG
GCE_VM_IP_DEDICATED_BACKENDsolo son compatibles con los servicios de backend regionales configurados para los balanceadores de cargas de red de transferencia internos (loadBalancingScheme: INTERNAL) que usanhaPolicy.
Restricciones de la política de HA en las subredes de transmisión
Cuando implementas servicios de backend de haPolicy en subredes con la transmisión de ARP y
el aprendizaje de MAC habilitados, se aplican las siguientes reglas:
- Esquema de balanceo de cargas: Solo se admiten los balanceadores de cargas de red de transferencia internos
(
INTERNAL). - Alineación de subredes: Todos los NEG de backend en todas las zonas para un servicio de backend determinado deben pertenecer a la misma subred de VPC.
- Asignación de reglas de reenvío: Solo una regla de reenvío puede hacer referencia a un servicio de backend configurado con NEG de transmisión.
- Tipo de subred de backend inmutable: Debes adjuntar backends en una subred de transmisión de ARP cuando crees el servicio de backend. No puedes reemplazarlos por backends en subredes que no sean de transmisión más adelante.
Evita el reclamo cruzado de políticas de HA
En una subred habilitada para la transmisión de ARP, una interfaz de host que pertenece a un servicio de backend de política de alta disponibilidad podría reclamar temporalmente el liderazgo de una política de alta disponibilidad no relacionada si transmite una trama de GARP para la VIP de la regla de reenvío de esa política.
Para evitar reclamos cruzados no deseados, incluye exactamente el mismo conjunto de backends de host de ESXi (todos los hosts en el NEG zonal del clúster) en todos los servicios de backend de la política de alta disponibilidad que operan en esa subred.
¿Qué sigue?
- Revisa el enrutamiento de superposición y la alta disponibilidad de NSX Edge en Enrutamiento de superposición y perimetral de NSX.
- Obtén información para configurar las redes del dispositivo con la consola en Implementa nodos y configura las redes del dispositivo con la consola.
- Obtén información para agregar dispositivos de administración de VCF el día 2 en Agrega dispositivos de VCF con Terraform.