


Le moteur RAG sur Gemini Enterprise Agent Platform propose différents modes de déploiement pour l'exploitation de vos instances RAG. Le choix du mode de déploiement détermine l'emplacement de stockage de vos données, la manière dont ce stockage évolue à mesure que vos données augmentent et le niveau de gestion de l'infrastructure requis. En comprenant le fonctionnement de ces modes, vous pouvez choisir le bon équilibre entre simplicité, évolutivité et coûts pour votre projet.
Le moteur RAG propose deux modes de déploiement : sans serveur et Spanner. Vous pouvez passer d'un mode à l'autre sans problème. Les données de chaque mode restent isolées les unes des autres.
Modes de déploiement disponibles
Dans cette section, nous abordons les deux modes de déploiement disponibles pour le moteur RAG :
Mode sans serveur
Le mode sans serveur est la méthode la plus abordable et la plus recommandée pour commencer à utiliser le moteur RAG. Il fournit une base de données entièrement gérée, à l'échelle mondiale et adaptée aux entreprises, qui élimine tout provisionnement et scaling de base de données.
- Idéal pour : la plupart des utilisateurs, une intégration rapide et un scaling fluide sans avoir à gérer les configurations d'infrastructure.
- Principales fonctionnalités : ne nécessite aucune gestion des niveaux. Il utilise automatiquement Vector Search géré par RAG comme base de données vectorielle par défaut pour fournir une expérience RAG simplifiée et prête à l'emploi.
En mode sans serveur, la base de données gérée par RAG sert à gérer les opérations métier RAG et à stocker les ressources RAG. Ces ressources incluent (sans s'y limiter) RagCorpus, RagFiles, RagMetadata, DataSchema, etc. Cependant, il ne peut plus être utilisé pour l'indexation des embeddings et la recherche vectorielle.
Les utilisateurs devront toujours choisir une base de données vectorielle différente séparément. En mode sans serveur, le moteur RAG provisionne par défaut une collection Vector Search 2.0 dans votre projet pour l'indexation des embeddings et la recherche vectorielle. Par rapport au mode Spanner, le provisionnement de Vector Search 2.0 dans votre projet vous offre une visibilité et un contrôle complets sur l'utilisation et les coûts de la base de données vectorielle. Pour une comparaison détaillée, consultez la section Mode Spanner et mode sans serveur.
Mode Spanner
Le mode Spanner alloue une infrastructure Spanner dédiée spécifiquement pour servir de base à votre déploiement de moteur RAG. Il est conçu pour les charges de travail qui nécessitent des fonctionnalités de conformité spécifiques (comme les CMEK) ou des instances de base de données dédiées et isolées. Le mode Spanner est attribué par défaut si aucun choix de mode n'est explicitement sélectionné.
Lorsque vous utilisez le mode Spanner, vous devez gérer votre infrastructure en sélectionnant un niveau de performances :
- Niveau de base (par défaut) : niveau fixe, économique et à faible capacité de calcul, adapté aux tests, aux petits volumes de données ou aux charges de travail non sensibles à la latence.
- Niveau Scaled : offre des performances de niveau production avec une fonctionnalité d'autoscaling. Il est adapté aux clients disposant de grandes quantités de données ou de charges de travail sensibles aux performances.
Isolation des données et changement de mode
Le moteur RAG vous permet de changer le mode de déploiement de votre projet tant qu'aucune opération n'est en cours dans votre mode de déploiement actif. Vous pouvez avoir des données dans les deux modes. Cependant, un seul mode peut être actif à la fois, et les données sont strictement isolées entre les modes de déploiement.
Pour vous aider, vous pouvez imaginer que votre projet se comporte comme s'il disposait de deux backends complètement distincts. Les ressources que vous créez (corpus, fichiers importés et embeddings analysés) sont associées de manière permanente au mode de déploiement qui était actif lors de leur création. Toutes les requêtes de récupération, qu'elles soient effectuées directement ou via Gemini, seront également limitées aux corpus et aux fichiers présents dans votre mode de déploiement actuel. Le passage d'un mode à l'autre ne déplace pas vos données et ne supprime pas les données de l'autre mode.
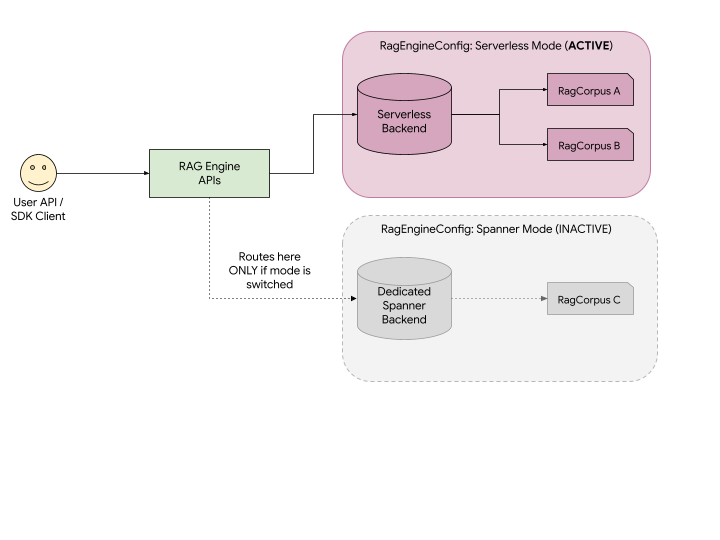
Comme illustré dans le schéma :
- API unifiée : vous utilisez exactement les mêmes API RAG d'Agent Platform pour créer et gérer des ressources. L'API achemine automatiquement vos requêtes vers le backend associé à votre mode de déploiement actif.
- Visibilité : si le mode sans serveur est actif, votre application ne peut voir que les RagCorpus A et B, et interagir avec eux. RagCorpus C, qui a été créé en mode Spanner, reste stocké de manière sécurisée, mais il est complètement masqué et inaccessible pour votre application jusqu'à ce que vous repassiez en mode Spanner pour votre projet.
- Aucune perte de données : le changement de mode ne supprime pas vos données. Elle modifie simplement le "backend" que l'API examine.
Gérer votre mode de déploiement
Le mode de déploiement est un paramètre au niveau du projet. Vous pouvez afficher ou modifier votre mode actuel à l'aide des API GetRagEngineConfig et UpdateRagEngineConfig. Consultez la page Passer d'un mode à l'autre pour savoir comment passer d'un mode de déploiement à l'autre et choisir un niveau approprié pour votre mode Spanner.
Supprimer les données et arrêter la facturation
Étant donné que les données sont isolées entre les modes, les processus de nettoyage des ressources et d'arrêt de la facturation diffèrent légèrement selon l'emplacement de vos données.
- Pour supprimer des données sans serveur : assurez-vous que le mode actif est défini sur "Sans serveur". Appelez l'API
ListRagCorporapour afficher vos ressources, puis supprimez manuellement chaque corpus à l'aide de l'APIDeleteRagCorpus. - Pour supprimer des données Spanner (déprovisionnement) : assurez-vous que votre mode actif est défini sur Spanner. Mettez à jour votre fichier
RagEngineConfiget définissez le niveau Spanner surUnprovisioned. Votre instance Spanner dédiée et toutes les données RAG qu'elle contient seront immédiatement supprimées, ce qui arrêtera toute facturation associée pour le mode Spanner. Remarque : Les données supprimées à l'aide du niveau non provisionné ne peuvent pas être récupérées.
Mode Spanner et mode sans serveur
| Fonctionnalité | Mode sans serveur | Mode Spanner |
|---|---|---|
| Coût |
|
|
| Scaling | Autoscaling entièrement géré | Le choix du niveau doit être configuré, mais un niveau d'autoscaling est proposé. |
| Isolation | Le stockage n'est pas isolé | Fournit une isolation du stockage et des performances. |
| CMEK | Aucune CMEK pour le moment | Compatible avec les clés CMEK |
| VPC Service Controls | Compatible | Compatible |
| Bases de données vectorielles compatibles |
|
|
Étapes suivantes
- Pour commencer à utiliser le moteur RAG, consultez le guide de démarrage rapide RAG.
- Pour modifier votre mode de déploiement ou mettre à jour le niveau de votre mode Spanner, consultez Passer d'un mode à l'autre.
- Pour supprimer votre instance Spanner, consultez Passer au niveau non provisionné.
- Pour en savoir plus sur le mode Spanner, consultez Gérer le mode Spanner.
- Pour en savoir plus sur le mode sans serveur, consultez Mode sans serveur.
- Pour en savoir plus sur les tarifs, consultez Facturation du moteur RAG sur Gemini Enterprise Agent Platform.