


TPU v5p
本文說明 Cloud TPU v5p 的架構和支援的設定。
系統架構
本節說明 v5p 版本的系統架構。每個 TensorCore 有 4 個矩陣乘法單元 (MXU)、1 個向量單元和 1 個純量單元。
v5p Pod 含有 8,960 顆晶片。可排程的最大工作為 96 個立方體 (6144 個晶片)。
下表列出 TPU v5p 的主要規格。
| 規格 | 值 |
|---|---|
| 每個 Pod 的晶片數量 | 8960 |
| 每顆晶片的尖峰運算效能 (BF16) (TFLOPs) | 459 |
| 每顆晶片的尖峰運算效能 (FP8) (TFLOPs) | 459 |
| 每個晶片的 HBM 容量 (GiB) | 95 |
| 每顆晶片的 HBM 頻寬 (GBps) | 2765 |
| vCPU 數量 (4 晶片 VM) | 208 |
| RAM (GB) (4 晶片 VM) | 448 |
| 每個晶片的 TensorCore 數量 | 2 |
| 每個晶片的 SparseCore 數量 | 4 |
| 每個晶片的雙向晶片間互連 (ICI) 頻寬 (GB/秒) | 1200 |
| 每個晶片的資料中心網路 (DCN) 頻寬 (Gbps) | 50 |
| 互連網路拓撲 | 3D 環面 * |
每個 TPU v5p 晶片都有 96 GiB 的實體高頻寬記憶體 (HBM)。上表列出 95 GiB,是為了考量 TPU 系統和 libtpu 執行階段為可靠性和執行階段負擔預留的 HBM。tpu-info、JAX 和 PyTorch 等工具和框架會回報使用者可分配的 HBM,而非 96 GiB 的標稱實體容量。
設定
TPU v5p Pod 由 8960 個晶片組成,這些晶片透過可重新設定的高速連結相互連結。TPU v5p 的網路功能相當靈活,可讓您以多種方式連結相同大小配量中的晶片。
下表列出 v5p 支援的最常見單一配量形狀,以及大多數 (但非全部) 大於 1 個立方體的完整立方體形狀。v5p 的最大形狀為 16x16x24 (6144 個晶片、96 個立方體)。
| 拓撲 | 核心 | 晶片 | 主機 | Cubes | 機型 | 是否支援扭曲? |
|---|---|---|---|---|---|---|
| 2x2x1 | 8 | 4 | 1 | 不適用 | ct5p-hightpu-4t |
不適用 |
| 2x2x2 | 16 | 8 | 2 | 不適用 | ct5p-hightpu-4t |
不適用 |
| 2x4x4 | 64 | 32 | 8 | 不適用 | ct5p-hightpu-4t |
不適用 |
| 4x4x4 | 128 | 64 | 16 | 1 | ct5p-hightpu-4t |
不適用 |
| 4x4x8 | 256 | 128 | 32 | 2 | ct5p-hightpu-4t |
是 |
| 4x8x8 | 512 | 256 | 64 | 4 | ct5p-hightpu-4t |
是 |
| 8x8x8 | 1024 | 512 | 128 | 8 | ct5p-hightpu-4t |
不適用 |
| 8x8x16 | 2048 | 1024 | 256 | 16 | ct5p-hightpu-4t |
是 |
| 8x16x16 | 4096 | 2048 | 512 | 32 | ct5p-hightpu-4t |
是 |
| 16x16x16 | 8192 | 4096 | 1024 | 64 | ct5p-hightpu-4t |
不適用 |
| 16x16x24 | 12288 | 6144 | 1536 | 96 | ct5p-hightpu-4t |
不適用 |
單一配量訓練作業支援最多 6,144 顆晶片。使用多配量時,最多可擴充至 18,432 顆晶片。如要進一步瞭解多配量,請參閱「Cloud TPU 多配量總覽」。
扭曲環面拓撲
對於某些 3D 配量形狀,您可以使用扭曲環面拓撲。這些拓撲可提供大幅提高的平分頻寬。舉例來說,相較於非扭曲的 4x4x8 切片,4x4x8 扭曲拓撲的理論平分頻寬可增加 70%。頻寬增加後,有助於使用全域通訊模式的工作負載。扭曲拓撲可提升大多數模型的效能,其中大型 TPU 嵌入工作負載的效益最大。TPU 軟體支援扭曲拓撲,但切片的每個維度必須等於或兩倍於最小維度。例如 4x4x8、4×8×8 或 12x12x24。TPU v4 和 TPU v5p 支援扭曲拓撲,可透過 Cloud TPU API 使用。
如果工作負載僅採用資料平行處理策略,扭曲拓撲的效能可能會稍微好一點。使用大型語言模型 (LLM) 時,扭曲拓撲的效能會因採用的平行處理類型 (例如資料平行處理或模型平行處理) 而異。如要找出模型的最佳效能,請在有和沒有扭曲拓撲的情況下訓練 LLM。在 FSDP MaxText 模型上進行的部分實驗顯示,使用扭曲拓撲時,模型 FLOPs 使用率 (MFU) 提高了 1 到 2 個百分點。
扭曲拓撲的主要優點,是能將非對稱環面拓撲 (例如 4×4×8) 變更為對稱拓撲。對稱拓撲的優點如下:
- 改善負載平衡
- 更高的對分頻寬
- 縮短封包路徑
這些優勢可提升許多全域通訊模式的效能。
舉例來說,假設有一個 4×2 環面拓撲,其中的 TPU 標有切片中的 X 和 Y 座標:
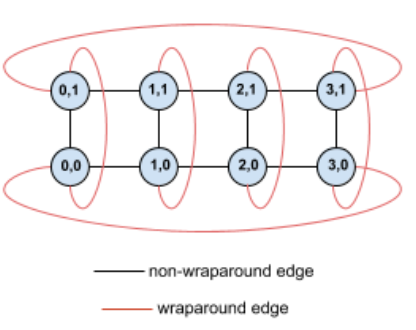
為求明確,圖表會將連線顯示為無向邊。在實際操作中,每個邊緣都是 TPU 之間的雙向連線。這個網格一側與對側之間的邊緣是環繞邊緣。
扭轉這個拓撲,會建立對稱的 4×2 扭轉環面拓撲:
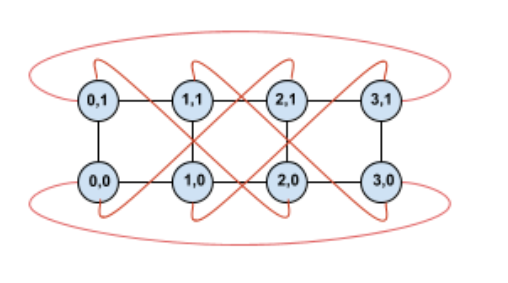
這個扭曲圖表與未扭曲圖表的差異在於 Y 軸環繞邊緣。這些環繞邊緣不會連接到 X 座標相同的其他 TPU,而是會轉移到座標 X+2 mod 4 的 TPU。
這個原則適用於不同的維度大小和維度數量。如果每個維度都等於或兩倍於最小維度的大小,則產生的網路是對稱的。
下表列出部分支援的扭曲拓撲,以及相較於未扭曲拓撲,扭曲拓撲在理論上可增加的平分頻寬。
| 拓撲 | 與非扭曲環面相比,理論上的平分頻寬增幅 |
|---|---|
| 4×4×8 | ~70% |
| 8x8x16 | |
| 12×12×24 | |
| 4×8×8 | ~40% |
| 8×16×16 |
Cloud TPU ICI 韌性
ICI 韌性可提升光學連結和光學電路交換器 (OCS) 的容錯能力,這些元件用於連接不同立方體之間的 TPU。(機櫃內的 ICI 連線使用銅線連結,不受影響)。ICI 彈性可讓 ICI 連線繞過 OCS 和光學 ICI 故障。因此,這項功能可提高 TPU 切片的排程可用性,但代價是 ICI 效能會暫時下降。
如同 Cloud TPU v4,系統已為一個立方體或更大規模的 v5p 配量 (4x4x4 拓撲) 預設開啟 ICI 韌性。
VM、主機和切片屬性
| 屬性 | TPU 的價值 |
|---|---|
| v5p 晶片數量 | 4 |
| vCPU 數量 | 208 (如果使用 NUMA 繫結來避免跨 NUMA 效能降低,則只有一半可用) |
| RAM (GB) | 448 (如果使用 NUMA 繫結來避免跨 NUMA 效能降低,則只有一半可用) |
| NUMA 節點數量 | 2 |
| NIC 處理量 (Gbps) | 200 |
Pod 中 TensorCore、晶片、主機/VM 和立方體的數量關係:
| 核心 | 晶片 | 主機/VM | Cubes | |
|---|---|---|---|---|
| 主機 | 8 | 4 | 1 | |
| Cube (機架) | 128 | 64 | 16 | 1 |
| 支援的最大切片 | 12288 | 6144 | 1536 | 96 |
| v5p 完整 Pod | 17920 | 8960 | 2240 | 140 |