


TPU7x (Ironwood)
Auf dieser Seite werden die Architektur und die verfügbaren Konfigurationen für TPU7x beschrieben, die neueste TPU, die in Google Cloudverfügbar ist. TPU7x ist die erste Version der Ironwood-Familie,der TPU der siebten Generation von Google Cloud. Die Ironwood-Generation ist für umfangreiches KI-Training und Inferenz konzipiert.
Mit 9.216 Chips pro Pod ähnelt die TPU7x-Architektur der TPU v5p-Architektur. TPU7x bietet eine hohe Leistung für umfangreiche dichte und MoE-Modelle, Vortraining, Sampling und decodierlastige Inferenz.
Wenn Sie TPU7x verwenden möchten, können Sie die Google Kubernetes Engine (GKE) oder die Compute Engine nutzen. Weitere Informationen zur Verwendung von TPUs mit der GKE finden Sie unter TPUs in der GKE.
Sie können auch TPU7x und GKE im Modus „Gesamte Kapazität“ verwenden. Der Modus „Gesamte Kapazität“ ist über eine Reservierung im Modus „Gesamte Kapazität“ verfügbar. Sie erhalten damit vollen Zugriff auf Ihre gesamte reservierte Kapazität (keine Zurückhaltung) und vollständige Transparenz über die TPU-Hardwaretopologie, den Auslastungsstatus und den Zustand. Weitere Informationen finden Sie unter Übersicht über den Modus „Gesamte Kapazität“.
Systemarchitektur
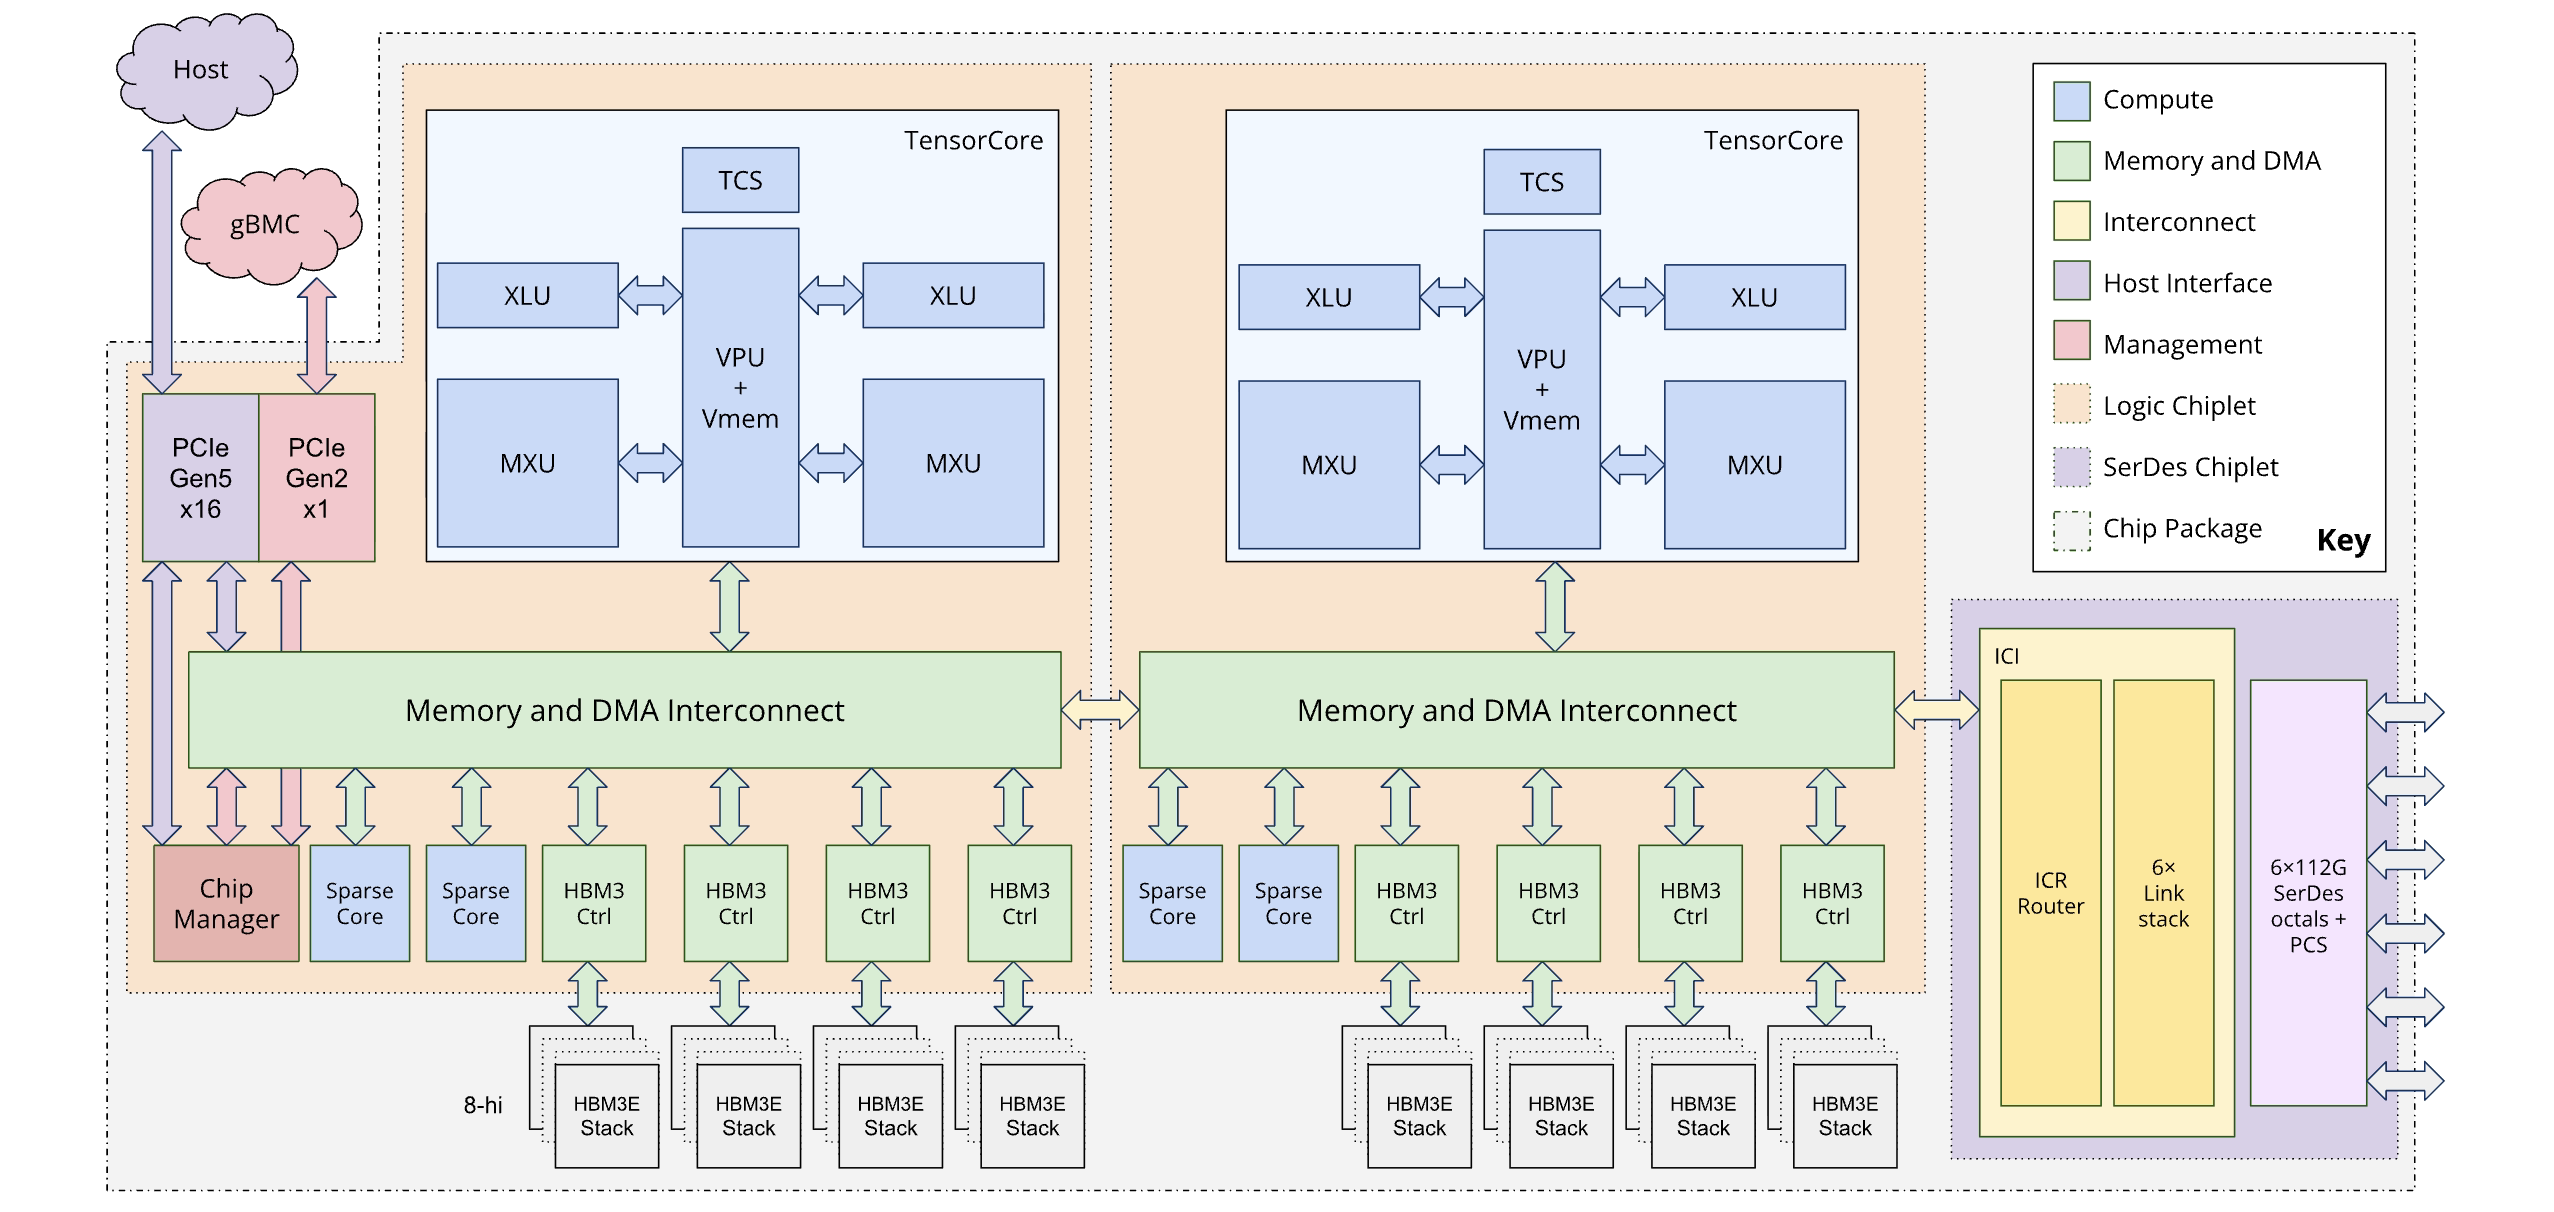
Jeder TPU7x-Chip enthält zwei TensorCores und vier SparseCores. In der folgenden Tabelle sind die wichtigsten Spezifikationen und ihre Werte für TPU7x im Vergleich zu früheren Generationen aufgeführt.
| Spezifikation | v5p | v6e (Trillium) | TPU7x (Ironwood) |
|---|---|---|---|
| Anzahl der Chips pro Pod | 8960 | 256 | 9216 |
| Maximale Rechenleistung pro Chip (BF16) (TFLOPs) | 459 | 918 | 2307 |
| Maximale Rechenleistung pro Chip (FP8) (TFLOPs) | 459 | 918 | 4614 |
| HBM-Kapazität pro Chip (GiB) | 95 | 32 | 192 |
| HBM-Bandbreite pro Chip (GB/s) | 2765 | 1638 | 7380 |
| Anzahl der vCPUs (VM mit 4 Chips) | 208 | 180 | 224 |
| RAM (GB) (VM mit 4 Chips) | 448 | 720 | 960 |
| Anzahl der TensorCores pro Chip | 2 | 1 | 2 |
| Anzahl der SparseCores pro Chip | 4 | 2 | 4 |
| Bidirektionale ICI-Bandbreite (Inter-Chip Interconnect) pro Chip (GB/s) | 1.200 | 800 | 1.200 |
| Bandbreite des Rechenzentrumsnetzwerks (DCN) pro Chip (Gbit/s) | 50 | 100 | 100 |
Das folgende Diagramm veranschaulicht die Architektur von Ironwood:
Speicherhierarchie
TPU7x verfügt über ein mehrstufiges Speichersystem. Die Verwaltung der Datenverschiebung zwischen diesen Stufen ist entscheidend für die Leistung:
- High-Bandwidth Memory (HBM): Jeder Chip ist mit 192 GB HBM ausgestattet, mit einer Bandbreite von etwa 7,37 TB/s. Die große HBM-Kapazität ermöglicht große Batchgrößen, was den Durchsatz verbessern kann. Trotz seiner Größe kann HBM jedoch immer noch ein Engpass sein, insbesondere bei speichergebundenen Vektorvorgängen oder ineffizienten Datenzugriffsmustern.
- Vektorspeicher (VMEM): VMEM ist ein kleinerer On-Chip-SRAM (statischer Arbeitsspeicher) mit einer deutlich höheren Bandbreite zur Matrix Multiply Unit (MXU) als HBM. Dieser Speicher fungiert als Hochgeschwindigkeits-Scratchpad für benutzerdefinierte Kernel. Die Größe dieses Puffers ist ein anpassbarer Parameter. Die Optimierung der Puffergröße ist für die Feinabstimmung benutzerdefinierter Pallas-Kernel von entscheidender Bedeutung, da ihre Blockgrößen häufig durch den verfügbaren VMEM begrenzt sind.
- Host-Arbeitsspeicher und PCIe: Jede Gruppe von vier TPU-Chips ist über ein PCIe-Netzwerk mit einem CPU-Host verbunden. Diese Verbindung hat zwar eine viel geringere Bandbreite als HBM, aber der Hauptspeicher des Hosts kann verwendet werden, um Aktivierungen oder Optimierungszustände auszulagern und so HBM freizugeben. Diese Technik ist besonders nützlich, um den Speicherdruck bei großen Modellen zu verwalten.
Weitere Informationen zur effizienten Verwaltung der Datenverschiebung zwischen den Ebenen der TPU7x-Speicherhierarchie finden Sie unter Ironwood-Leistungsoptimierungen.
Dual-Chiplet-Architektur
Mit dem Ironwood-Programmiermodell können Sie auf zwei TPU-Chiplets zugreifen, anstatt auf eine einzelne logische Kernarchitektur (auch als MegaCore bezeichnet), die in früheren Generationen (TPU v4 und v5p) verwendet wurde. Diese Änderung verbessert die Kosteneffizienz und die Effizienz der Chipherstellung. Dies stellt zwar eine architektonische Veränderung dar, aber das neue Design sorgt dafür, dass Sie vorhandene Softwaremodelle mit minimalen Änderungen wiederverwenden können.
Ironwood-TPUs bestehen aus zwei separaten Chiplets, die jeweils über einen eigenen dedizierten Speicherplatz verfügen. Dies ist eine Abweichung vom einheitlichen Speicherplatz der MegaCore-Architektur.
Chiplet-Zusammensetzung: Jedes Chiplet ist eine eigenständige Einheit mit einem TensorCore, zwei SparseCores und 96 GB High-Bandwidth Memory (HBM).
Hochgeschwindigkeitsverbindung: Die beiden Chiplets sind über eine Die-to-Die-Schnittstelle (D2D) verbunden, die sechsmal schneller ist als eine 1D-Inter-Chip-Interconnect-Verbindung (ICI). Die Kommunikation zwischen Chiplets wird mithilfe von kollektiven Vorgängen verwaltet.
Programmiermodell und Framework-Exposition
Das Programmiermodell für Ironwood ähnelt dem von TPU-Generationen vor v4, z. B. TPU v3. Die neue Architektur wird auf folgende Weise bereitgestellt:
Zwei Geräte pro Chip: Frameworks wie JAX stellen jeden Ironwood-Chip als zwei separate „Geräte“ dar, eines für jedes Chiplet.
Chiplet-Spezifikation: Sie können angeben, welches Chiplet für eine Berechnung verwendet werden soll. JAX fügt der Topologiespezifikation eine vierte Dimension hinzu, um zwischen Chiplets zu unterscheiden. Mit diesem Design können Sie vorhandene Softwaremodelle mit minimalen Änderungen wiederverwenden.
Weitere Informationen zum Erreichen einer optimalen Leistung mit der Dual-Chiplet-Architektur finden Sie unter Leistungsempfehlungen für die Dual-Chiplet-Architektur von Ironwood.
Unterstützte Konfigurationen
TPU7x-Chips haben eine direkte Verbindung zu den nächstgelegenen benachbarten Chips in 3 Dimensionen, was zu einem 3D-Mesh von Netzwerkverbindungen führt. Slices mit mehr als 64 Chips bestehen aus einem oder mehreren 4 × 4 × 4-Cubes von Chips.
TPU7x-Chips haben eine 3D-Torus-Interconnect-Topologie. Mit dieser Topologie können Slices auf bis zu 9.216 Chips hochskaliert werden. Sie bietet eine bidirektionale Bandbreite von 200 GB/s pro Achse für die Kommunikation zwischen Chips innerhalb eines Pods.
In der folgenden Tabelle sind gängige 3D-Slice-Formen aufgeführt, die für TPU7x unterstützt werden:
| Topologie | TPU-Chips | Hosts | VMs | Cubes | Umfang |
|---|---|---|---|---|---|
| 2x2x1 | 4 | 1 | 1 | 1/16 | Einzelner Host |
| 2x2x2 | 8 | 2 | 2 | 1/8 | Mehrere Hosts |
| 2x2x4 | 16 | 4 | 4 | 1/4 | Mehrere Hosts |
| 2x4x4 | 32 | 8 | 8 | 1/2 | Mehrere Hosts |
| 4x4x4 | 64 | 16 | 16 | 1 | Mehrere Hosts |
| 4 x 4 x 8 | 128 | 32 | 32 | 2 | Mehrere Hosts |
| 4 x 8 x 8 | 256 | 64 | 64 | 4 | Mehrere Hosts |
| 8 x 8 x 8 | 512 | 128 | 128 | 8 | Mehrere Hosts |
| 8 x 8 x 16 | 1.024 | 256 | 256 | 16 | Mehrere Hosts |
| 8 x 16 x 16 | 2.048 | 512 | 512 | 32 | Mehrere Hosts |
TPU7x-VM
Jede virtuelle TPU7x-Maschine (VM) enthält 4 Chips. Jede VM hat Zugriff auf zwei NUMA-Knoten. Weitere Informationen zu NUMA-Knoten finden Sie im Wikipedia-Artikel zu Non-Uniform Memory Access.
Alle TPU7x-Slices verwenden Full-Host-VMs mit 4 Chips. Die technischen Spezifikationen für eine TPU7x-VM sind:
- Anzahl der vCPUs pro VM: 224
- RAM pro VM: 960 GB
- Anzahl der NUMA-Knoten pro VM: 2
Unterstützte Modelle
Ein unterstütztes Modell wird für TPU7x-Hardware optimiert und validiert. Sie können unterstützte Modelle ohne Codeänderungen bereitstellen und ausführen. Unterstützte Modelle sind so konfiguriert, dass sie die TPU7x-Funktionen nutzen, einschließlich der Dual-Chiplet-Architektur, der High-Bandwidth Interconnects (ICI), des HBM und der Mixed-Precision-Berechnung (z. B. FP8 und BF16).
Google und die Open-Source-Community pflegen voreingestellte Rezepte, Konfigurationen und Support für Trainings- und Inferenzarbeitslasten auf TPU7x.
Für das Training optimierte Modelle
Für das Training optimierte Modelle enthalten vorkonfigurierte Rezepte und Hyperparameter, die für verteilte Trainings-Frameworks optimiert sind. Mit diesen Rezepten werden optimale Parallelitätsstrategien (einschließlich Daten-, Tensor-, Pipeline- und Kontextparallelität) konfiguriert, um den Durchsatz und die Skalierungseffizienz über TPU7x-Topologien mit einem einzelnen Host und mehreren Slices hinweg zu maximieren.
Trainingsrezepte, Leitfäden und Leistungsbenchmarks für unterstützte Modelle auf TPU7x finden Sie in den folgenden Ressourcen:
- TPU-Trainingsrezepte für TPU7x: Das offizielle GitHub-Repository mit voreingestellten Trainingsrezepten, Präzisionskonfigurationen (FP8 und BF16), Benchmarks für die Schrittzeit und Durchsatzmesswerten für beliebte offene Modelle auf TPU7x.
- MaxText-Repository: Ein leistungsstarkes Open-Source-LLM-Trainings-Framework, das in JAX geschrieben und für Cloud TPU optimiert wurde.
- Modell mit TPU7x trainieren: Eine Anleitung zum Bereitstellen von TPU7x-Ressourcen und zum Bereitstellen von Trainingsarbeitslasten mit MaxText.
- TorchTitan auf TPU: Ein Open-Source-Framework, das auf TorchTitan von PyTorch basiert und für das Training großer Modelle auf Cloud TPU angepasst wurde.
Inferenzoptimierte Modelle
Inferenzoptimierte Modelle werden für die Bereitstellung auf TPU7x mit vLLM und SGLang mithilfe von JAX- und PyTorch-Backends (TorchTPU) validiert. Diese Modelle werden mithilfe von Tensorparallelität und benutzerdefinierten TPU-Kernels, die in Pallas und Tokamax geschrieben wurden, auf Korrektheit, numerische Genauigkeit und Bereitstellungsdurchsatz getestet.
Bereitstellungsrezepte und Bereitstellungstools für unterstützte Modelle auf TPU7x finden Sie in den folgenden Ressourcen:
- TPU-Inferenzrezepte für TPU7x: Vorkonfigurierte Bereitstellungsrezepte, Konfigurationen und Bereitstellungsmanifeste, die für TPU7x optimiert sind.
- vLLM auf TPU: Bereitstellung mit dem
vllm-jax-Backend für JAX-Modelle und demvllm-torchtpu-Backend für PyTorch-Modelle. - SGLang auf TPU: Bereitstellung mit dem
sglang-jax-Backend für JAX-Modelle und demsglang-torchtpu-Backend für PyTorch-Modelle. - TPU v7x-vLLM-Modellunterstützungsmatrix: Nächtliche automatisierte Testergebnisse für Unittests, Korrektheit und Benchmark-Status auf TPU7x.
- Inferenz auf Cloud TPU ausführen: Eine Anleitung zum Einrichten der Modellbereitstellung auf einem einzelnen Host auf Cloud TPU.
Hyperdisk
Standardmäßig ist das VM-Bootlaufwerk für TPU7x Hyperdisk Balanced. Sie können Ihrer TPU-VM weitere Laufwerke für zusätzlichen Speicherplatz hinzufügen. Die folgenden Laufwerkstypen werden auf TPU7x unterstützt:
- Hyperdisk abgestimmt
- Hyperdisk ML
Weitere Informationen zu Hyperdisk finden Sie unter Hyperdisk – Übersicht. Weitere Informationen zu Speicheroptionen für Cloud TPU finden Sie unter Speicheroptionen für Cloud TPU-Daten.
Nächste Schritte
- TPU7x mit GKE verwenden
- TPU7x im Modus „Gesamte Kapazität“ verwenden
- Google Cloud ML Diagnostics-Plattform zum Optimieren und Diagnostizieren von Arbeitslasten verwenden
- Trainingsarbeitslast mit einem für TPU7x optimierten Rezept ausführen
- TPU7x-Mikrobenchmark ausführen
- Leistungsoptimierungen für Ironwood
- Umfangreiche Modelle für maschinelles Lernen in der GKE mit mehrstufigem Checkpointing trainieren