


PyTorch auf Cloud TPU
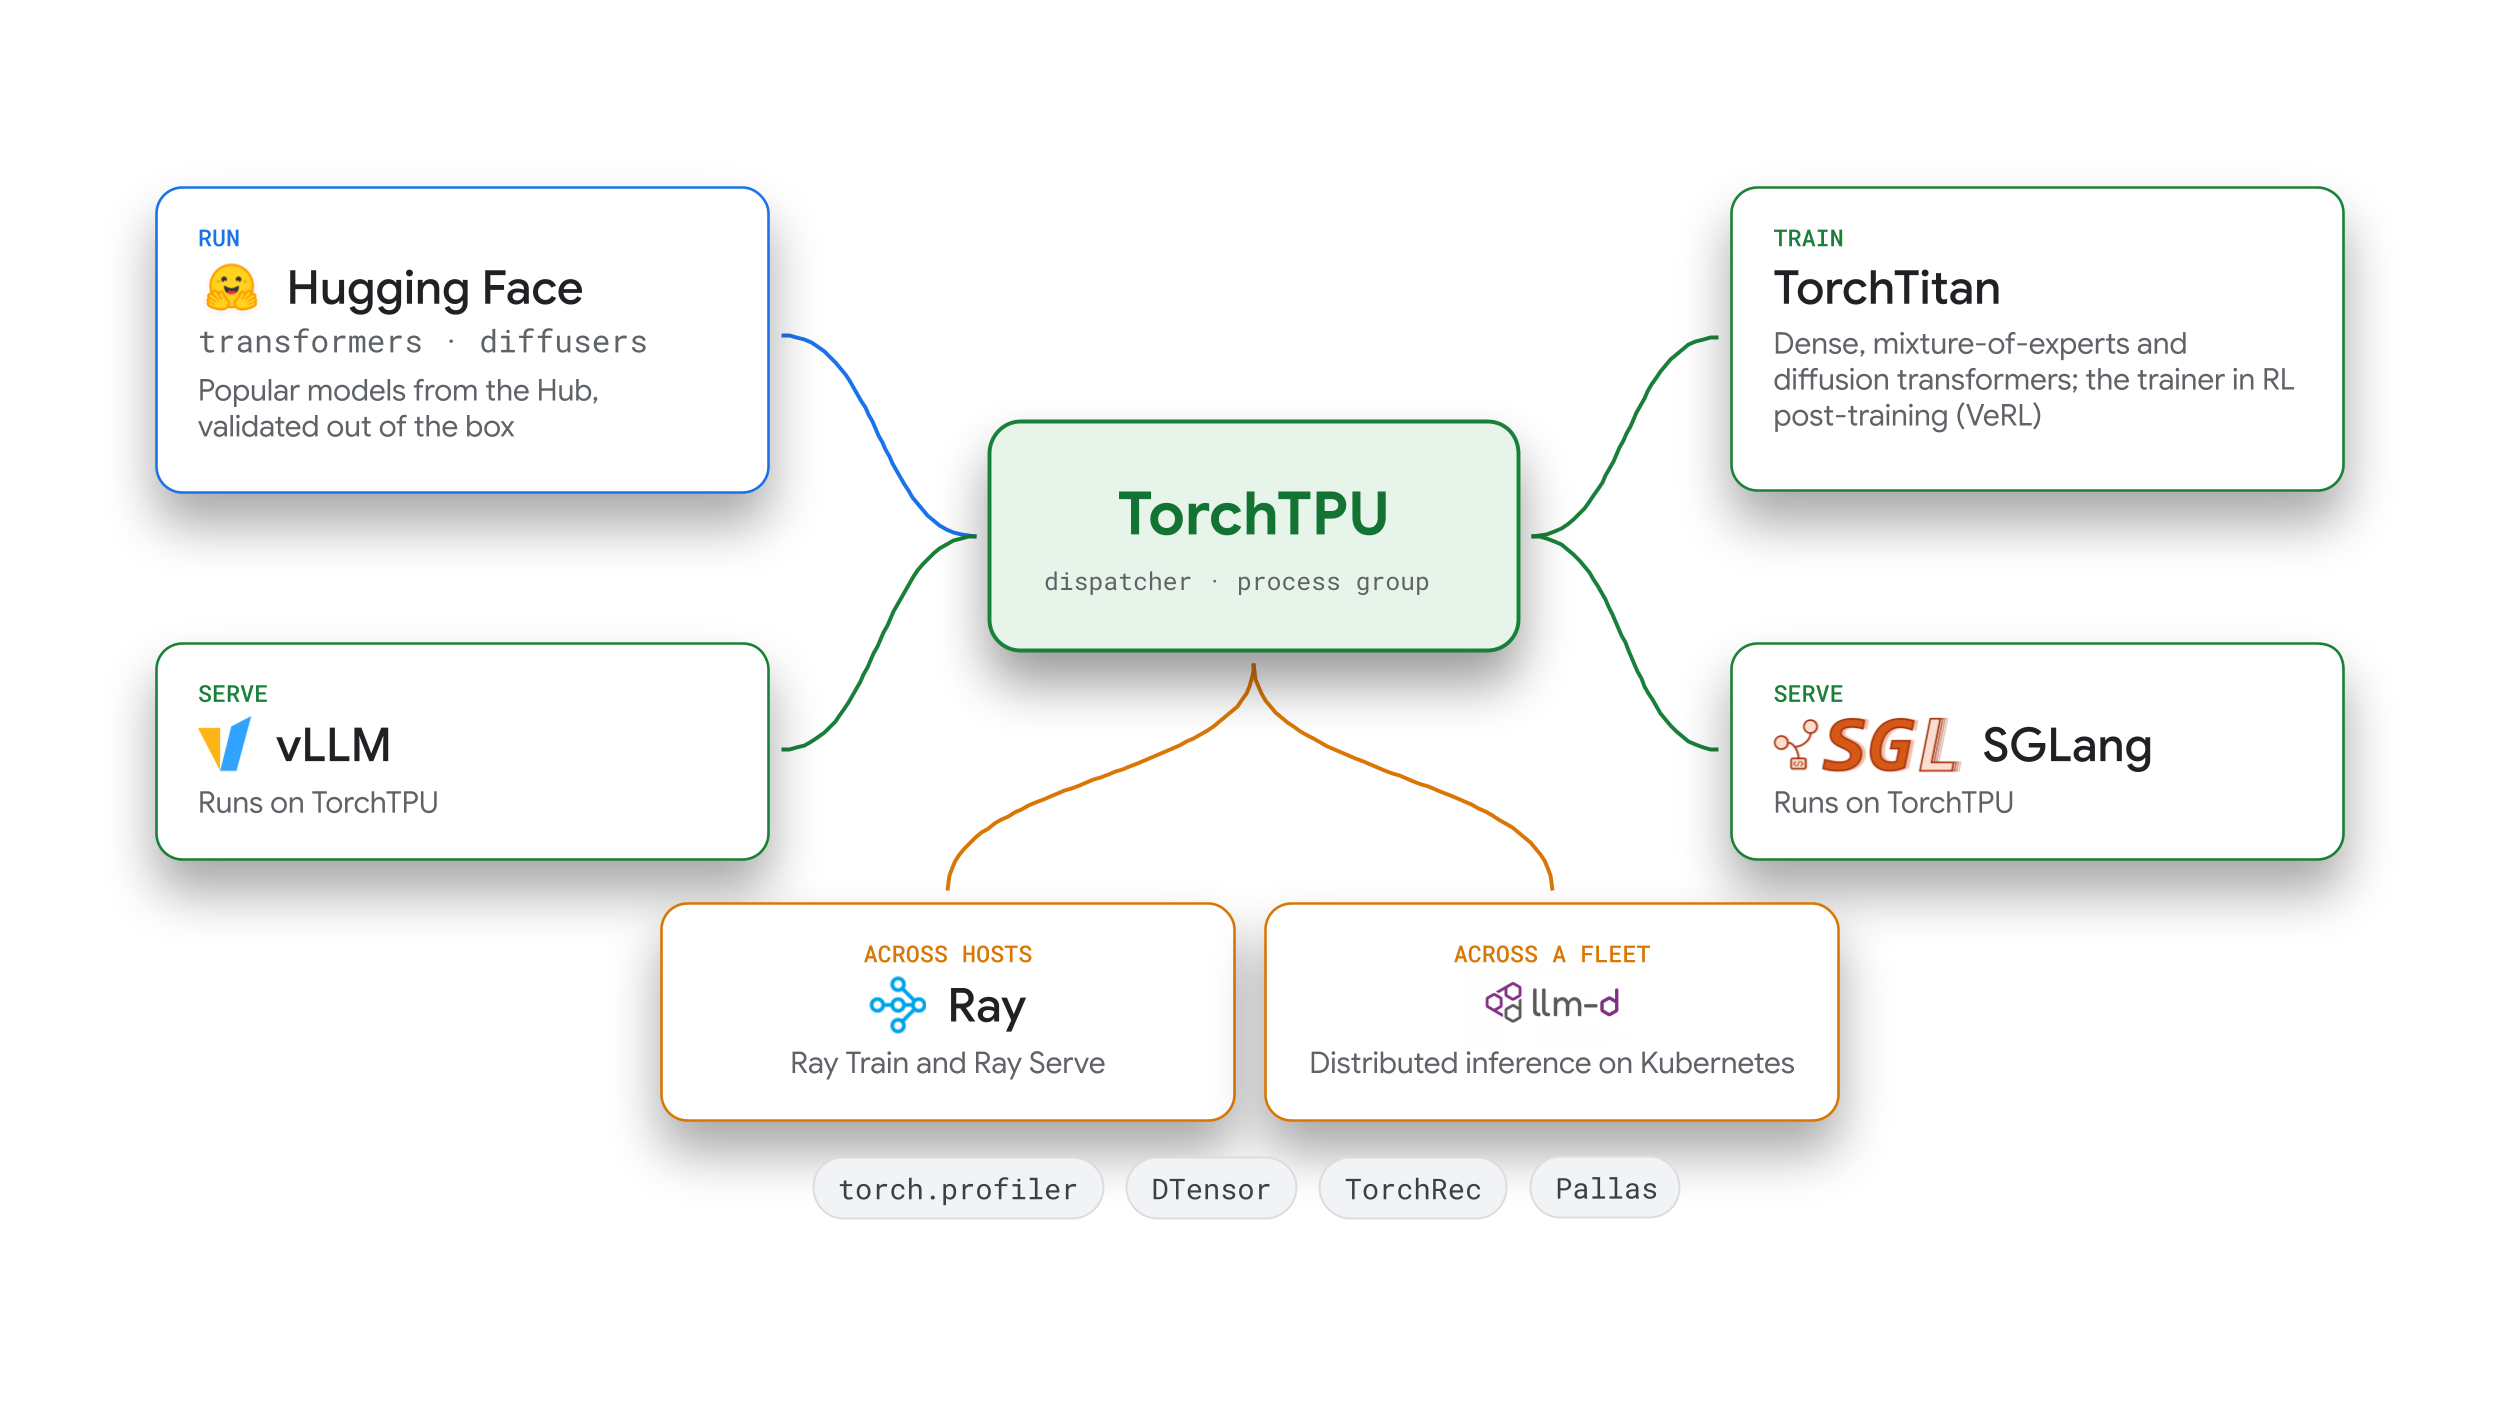
Mit PyTorch auf Cloud TPU können Sie Open-Source-Modelle auf Cloud TPU-Hardware trainieren, optimieren und bereitstellen. Dazu verwenden Sie die Standard-PyTorch-Semantik, verteilte APIs und die Ökosystemtools, die Sie bereits verwenden, darunter Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec und Ray.
Die Grundlage des Stacks ist TorchTPU, ein PyTorch-natives Open-Source-Backend, das gemeinsam mit dem PyTorch-Team bei Meta entwickelt wurde. TorchTPU bietet Bibliotheken, Frameworks und Tools für jede Phase des Lebenszyklus des maschinellen Lernens, von der Kernlaufzeitausführung und benutzerdefinierten Kernels bis hin zur Produktionsinferenz, dem Training im großen Maßstab und der Clusterorchestrierung.
Jetzt starten
- PyTorch-Modelle auf TPUs ausführen: Beginnen Sie mit TorchTPU und der TorchTPU-Dokumentation.
- LLMs und multimodale Modelle bereitstellen: Verwenden Sie vLLM-TorchTPU oder SGLang-TorchTPU.
- Anfragen über eine Kubernetes-Flotte weiterleiten: Verwenden Sie llm-d.
- Foundation Models vortrainieren oder optimieren: Verwenden Sie TorchTitan auf TPU (oder TorchRec für Empfehlungsmodelle).
- Datenverarbeitungs-, Trainings-, RL- und Bereitstellungspipelines skalieren: Verwenden Sie Ray.
- Modelle mit Ihrem Programmierassistenten einrichten, profilieren und optimieren: Verwenden Sie die TPU Agent Suite (Vorabversion).
TorchTPU: PyTorch-natives Backend für Cloud TPU
TorchTPU stellt das Geräte-Backend, die Integration des Graph-Compilers und benutzerdefinierte Kernel-APIs für PyTorch auf Cloud TPU bereit. TorchTPU wurde in Zusammenarbeit mit dem PyTorch-Team entwickelt und ermöglicht es Ihnen, Modelle interaktiv im Eager-Modus zu debuggen, Modellcode mit torch.compile zu kompilieren und mit torch.distributed (tpu_dist) über Slices hinweg zu skalieren.
So installieren Sie TorchTPU und führen einen Tensorvorgang auf einer Cloud TPU aus:
pip install torch_tpu
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
Motivation
Cloud TPUs wurden bisher mit JAX und TensorFlow kombiniert. Für die Ausführung von PyTorch auf TPUs war jedoch die Lazy-Tensor-Grafikaufzeichnung (PyTorch/XLA) erforderlich. Das bedeutete oft, dass Code hinzugefügt werden musste, um kompilierbare Bereiche zu markieren. TorchTPU führt Vorgänge standardmäßig im Eager-Modus aus. Dabei wird das Standardausführungsmodell von PyTorch mit einem Prozess pro Gerät verwendet. Vorhandene Arbeitslasten und Bibliotheken können also ohne strukturelle Änderungen ausgeführt werden.
Design
TorchTPU bietet PyTorch-native TPU-Unterstützung für PyTorch mit drei Designzielen:
- Standard-PyTorch-Semantik: Führt einen Prozess pro Gerät aus und behält PyTorch-Tensoransichten und In-Place-Mutationen ohne JAX-Laufzeitabhängigkeit bei.
- Sofortige Ausführung standardmäßig: Standard-PyTorch-Modelle werden sofort im Eager-Modus ausgeführt, um interaktives Debugging und schrittweise Prüfungen zu ermöglichen.
- Compiler- und Kernel-Optimierungen: Neben der sofortigen Ausführung von Operatoren bietet TorchTPU auch die Operator-Fusion im Eager-Modus, die Einbindung von
torch.compilemit dynamischen Formgrenzen zur Reduzierung von Neukompilierungen und benutzerdefinierte Kernel-APIs.
Für die Graphkompilierung erfasst torch.compile den PyTorch-Berechnungsgraphen mit TorchDynamo und kompiliert ihn über OpenXLA und StableHLO in TPU-Maschinencode. Kollektive Vorgänge werden auf der Ebene der Prozessgruppe torch.distributed (tpu_dist) ausgeführt.
Wichtigste Stärken
- Unterstützung für Operatoren, Modelle und Hugging Face: TorchTPU unterstützt Standard-PyTorch-Operatoren (ATen) in Vorwärts- und Rückwärtsdurchläufen und wird kontinuierlich mit gängigen Hugging Face-Modellen getestet. Sie können Modelle in Transformers v5 bereitstellen, indem Sie
device_map="tpu"übergeben, Diffusers-Pipelines mit Eager-Modus,torch.compileund Tensor-Parallelität ausführen und Arbeitslasten mittorch.profilerin TensorBoard und XProf profilieren. - Skalierung von einem einzelnen Chip auf mehrere Slices: Das
tpu_dist-Backend unterstütztDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2) undDTensor. Außerdem ordnettorch.tpu.distributed.topology_aware_meshParallelitätsdimensionen den physischen TPU-Interconnect-Verbindungen zu. - Konfigurierbare Modi für die sofortige Ausführung: Es gibt drei Modi für die sofortige Ausführung:
Strict(Standard): Sendet Operatoren einzeln und asynchron mit der standardmäßigen imperativen PyTorch-Semantik.Debug: Wird synchron mit der Tensor-Grenzprüfung ausgeführt.DeferAndFuse: Führt Sequenzen von Eager-Operatoren zusammen, um den HBM-Traffic (High Bandwidth Memory) zu reduzieren.
- Kompilierung und Caching des vollständigen Graphen:
torch.compile(backend="tpu")kompiliert Graphen in TPU-Ausführbare Dateien und speichert sie über Prozesse, Hosts und Jobneustarts hinweg im Cache. - Benutzerdefinierte TPU-Kernel: Sie können benutzerdefinierte Pallas-Kernel, einschließlich Kernel, die direkt zwischen Chips kommunizieren, als Standard-PyTorch-Funktionen aufrufen, vordefinierte Kernel aus der Tokamax-Bibliothek verwenden oder portable kachelbasierte Kernel mit Helion erstellen.
Weitere Informationen finden Sie in der TorchTPU-Dokumentation. Sie können auch Fragen im Diskussionsforum zu PyTorch auf TPU stellen oder Probleme auf GitHub melden.
Produktionsinferenz und -bereitstellung
Für die Produktionsbereitstellung lässt sich PyTorch auf Cloud TPU in Open-Source-Inferenz-Engines und Kubernetes-native verteilte Bereitstellungsinfrastruktur einbinden.
vLLM-TorchTPU und SGLang-TorchTPU: Inferenz-Engines
vLLM-TorchTPU und SGLang-TorchTPU sind TorchTPU-Backends für die vLLM- und SGLang-Inferenz-Engines. Beide Backends führen offene Modelle wie Qwen, DeepSeek, GLM, Kimi, GPT-OSS und Gemma 4 aus. Weitere Informationen finden Sie im Blogpost Neue vLLM- und SGLang-Inferenz-Engines auf TPU.
Motivation
Für die Bereitstellung von Reasoning-, multimodalen und Tool-basierten Arbeitslasten sind häufig benutzerdefinierte Modelldefinitionen, spekulative Decodierungsmethoden und Quantisierungsschemas erforderlich. Wenn Sie die vLLM- und SGLang-Backends auf TorchTPU erstellen, können Sie Ihren Bereitstellungsstack direkt in PyTorch anpassen und debuggen.
Design
Beide Backends behalten die standardmäßigen vLLM- und SGLang-Planer, KV-Cache-Manager und API-Server bei, verwenden aber im Hintergrund die TorchTPU-Ausführung und benutzerdefinierte Pallas-Operatoren. Die meisten Modelle führen ihre Standard-PyTorch-Modelldefinitionen aus, während rechenintensive Blöcke Pallas-Kernel innerhalb des kompilierten Graphen aufrufen, sodass hardwarespezifische Kernel unabhängig aktualisiert werden können.
Wichtigste Stärken
- Parallelität, Quantisierung und spekulatives Decodieren: Unterstützt Tensor-, Daten-, Experten-, Pipeline- und Kontextparallelität über Hosts hinweg sowie multimodale (Bild und Video) und Einbettungseingaben. Zu den unterstützten Methoden für die spekulative Decodierung gehören die Multi-Token-Vorhersage (MTP), EAGLE-3, DFlash, DSpark und der n-Gramm-Abgleich. Zu den unterstützten Quantisierungsformaten gehören 8-Bit-KV-Caches (
FP8) sowie 8-Bit- (FP8) und 4-Bit-Gleitkomma-Modellprüfpunkte (MXFP4undNVFP4). - Zweistufiges Präfix-Caching, Toolaufrufe und strukturierte Ausgabe: Beim automatischen Präfix-Caching (auch für Hybrid-Attention- und rekursive Modelle) werden aktive Präfixe im HBM beibehalten und ältere Präfixe in den Hostspeicher ausgelagert, um eine Neuberechnung bei mehrstufigen Anfragen zu vermeiden. Toolaufrufe und strukturierte Ausgaben sind integriert.
- Überlappende KV-Cache-Übertragungen mit TPU Sync: Unterstützt disaggregiertes Prefill- und Decode-Serving (Trennung von Prompt-Verarbeitung und Token-Generierung auf separate Worker-Pools) über Hosts hinweg und Host-KV-Offloading mit TPU Sync. TPU Sync ist eine Open-Source-C++-Bibliothek, die PyTorch-Gerätepuffer direkt in Hintergrundthreads liest, ohne Daten über den Host-CPU-Arbeitsspeicher zu kopieren.
Weitere Informationen zu vLLM-TorchTPU finden Sie im vLLM-TorchTPU-Repository. Sie können auch Fragen im vLLM-Slack-Kanal stellen oder vLLM-TorchTPU-Probleme auf GitHub melden.
Weitere Informationen zu SGLang-TorchTPU finden Sie im SGLang-TorchTPU-Repository. SGLang-TorchTPU-Probleme können Sie auf GitHub melden.
llm-d: Kubernetes-native verteilte Inferenz
llm-d ist ein Open-Source-Sandbox-Framework der Cloud Native Computing Foundation (CNCF) für die verteilte LLM-Inferenz auf Kubernetes, das mit Red Hat, IBM, Google Cloudund einer Community von mehr als 500 Mitwirkenden und 35 Organisationen entwickelt wurde.
Motivation
Während Inferenz-Engines mit einer einzelnen Instanz die Ausführung pro Replikat verwalten, müssen Produktionsflotten Traffic-Spitzen, Prioritäten für mehrere Mandanten, die gemeinsame Nutzung von Kontexten über die gesamte Flotte hinweg und Rollouts ohne Ausfallzeiten bewältigen. llm-d bietet die Routing- und Betriebsebene auf Clusterebene, um eine Flotte von Inferenzservern zu koordinieren.
Design
llm-d wird vor Modellservern wie vLLM und SGLang in Kubernetes ausgeführt. llm-d bietet Folgendes:
- Leitet Anfragen basierend auf dem Präfix-Cache-Status und der Replikatlast weiter.
- Koordiniert disaggregierte Prefill- und Decodierungs-Worker-Pools.
- Unterstützt MoE-Sharding und asynchrone Batch-Inferenz.
- Verwaltet die gestaffelte KV-Cache-Auslagerung über den Gerätespeicher, den Hostspeicher und den Speicher.
Wichtigste Stärken
- Routing von Multi-Turn-Sitzungen: Leitet Multi-Turn-Unterhaltungen an Replikate weiter, die den im Cache gespeicherten Kontext enthalten. Die Unterstützung für die Turn-Priority-Planung und die Stateful Responses API ermöglicht es Agenten, den Kontext über mehrere Turns hinweg wiederzuverwenden, um Neuberechnungen zu reduzieren.
- Dienstqualität für mehrere Mandanten: Mit der Flusssteuerung für Priorität und Fairness können latenzempfindliche Anfragen und Agentenarbeitslasten mit Lastspitzen eine Flotte gemeinsam nutzen, ohne dass es zu Ressourcenmangel kommt.
- Flottenvorgänge und Rolling Updates: Bietet eine v1-Konfigurations-API, Hochverfügbarkeit des Routers und koordinierte Rolling Updates, die Vorabfüll- und Decodierungsreplikate als eine einzige logische Einheit verwalten.
- Native TorchTPU-Bereitstellung in der GKE: Sie können Cloud TPUs zusammen mit anderen Beschleunigern hinter einem einzelnen llm-d-Endpunkt bereitstellen und vLLM-TorchTPU- und SGLang-TorchTPU-Replikate mit Standard-Kubernetes-Tools verwalten.
Weitere Informationen erhalten Sie, wenn Sie Fragen im llm-d-Slack-Kanal stellen oder Probleme auf GitHub melden.
Trainings-, Feinabstimmungs- und Domainbibliotheken
TorchTPU bietet Referenztrainingsrezepte und domainspezifische Bibliotheken, die für TPU-Hardware optimiert sind, um große Modelle vorzutrainieren, abzustimmen und anzupassen.
TorchTitan auf TPU: Referenz für umfangreiches Training
TorchTitan auf TPU erweitert TorchTitan, die modulare PyTorch-Referenzplattform für das Training generativer KI, um TPU-Sharding-Durchgänge, benutzerdefinierte Kernel und Trainingsrezepte. Weitere Informationen finden Sie im Blogpost Integrating TorchTPU into TorchTitan and Optimizing Models for TPU.
Motivation
Für die Skalierung des Trainings über TPU-Slices mit mehreren Hosts müssen Parameter über die Chip-Interconnect-Verbindung hinweg fragmentiert und die Kommunikation mit der Berechnung überlappt werden. Google und Meta haben TPU-Sharding und -Kompilierungsdurchläufe in TorchTitan gemeinsam entwickelt, sodass Sie keine benutzerdefinierten TPU-Sharding-Strategien entwerfen oder die Kommunikation manuell planen müssen.
Design
Modelle werden in PyTorch für ein einzelnes Gerät ohne beschleunigerspezifischen Code geschrieben. TorchTitan konfiguriert Modellebenen aus Konfigurationsdateien. So können Sie einzelne Ebenen durch benutzerdefinierte Pallas-Kernel (z. B. Splash Attention) ersetzen, ohne die Modelldefinition oder die Trainingsschleife bearbeiten zu müssen.
Die SimpleFSDP-Implementierung von TorchTitan platziert Parameter-Sharding-Vorgänge direkt im kompilierten Graphen, sodass der XLA-Compiler die Gerätekommunikation mit der Berechnung überlappen kann. Die Graphkompilierung für den gesamten Schritt erfasst den gesamten Trainingsschritt als einzelnes XLA-Programm. Bei Multislice-Ausführungen werden die Shards beim Hybrid-Sharding (HSDP) innerhalb jedes Slice über die Inter-Chip-Verbindung (ICI) aufgeteilt und über das Rechenzentrumsnetzwerk (Data Center Network, DCN) über die Slices hinweg repliziert. Dieses Layout beschränkt den Slice-übergreifenden Traffic auf eine einzelne Gradientenreduzierung pro Schritt.
Wichtigste Stärken
- Rezepte für Vortraining und RL-Nachtraining: Enthält Referenzrezepte für dichte LLMs (Llama 3, Qwen 3 und MuseGlimmer 30B), Mixture of Experts-Modelle (MoE) (Qwen 3 235B, validiert auf bis zu 8.192 TPU7x-Chips) und Diffusionstransformatoren (FLUX.1). Für das RL-Post-Training (z. B. Group Relative Policy Optimization oder GRPO) delegiert VeRL (Vorabversion) Parameteraktualisierungen an TorchTitan und überträgt aktualisierte Gewichtungen an Bereitstellungs-Engines, um Trainingsverläufe (Rollouts) zu generieren.
- Vorkonfigurierte Compiler- und Parallelitätseinstellungen: Rezeptkonfigurationen enthalten vorkonfigurierte Compiler- und Parallelitätseinstellungen, sodass Sie die Model FLOPs Utilization (MFU) über Konfigurationsdateien statt über Codeänderungen optimieren können.
- Onboarding für neue Architekturen: Das Hugging Face Transformers-Modellierungs-Backend führt Hugging Face Hub-Modellprüfpunkte (einschließlich MoE-Modelle ohne Expertenparallelität) über den TorchTitan-Trainer aus. Für vollständige Modellports enthält TorchTitan eine schrittweise Onboarding-Anleitung für Entwickler und KI-Agenten.
- Wiederverwendung eigenständiger Komponenten: Sie können TorchTitan vollständig übernehmen oder einzelne Module, benutzerdefinierte Operatoren und Compiler-Flags in eine vorhandene Trainingscodebasis importieren.
Weitere Informationen finden Sie im Startleitfaden für TorchTitan auf TPU. Sie können auch Fragen im PyTorch-Diskussionsforum stellen oder Probleme auf GitHub melden.
TorchRec: Empfehlungssysteme
TorchRec ist eine PyTorch-Domainbibliothek, die verteilte Einbettungstabellen und Sharding-Primitive für Empfehlungsmodelle bereitstellt. In Cloud TPU lagert TorchRec dünnbesetzte Einbettungstabellen-Lookups auf dedizierte TPU-SparseCore-Prozessoren aus, während dichte Matrixvorgänge auf den TPU-TensorCores ausgeführt werden.
Weitere Informationen zu TorchRec finden Sie in der TorchRec-Dokumentation. Sie können auch Fragen im Diskussionsforum zu PyTorch auf TPU stellen oder Probleme auf GitHub melden.
Clusterorchestrierung und Entwicklertools
Zur Skalierung von Multi-Node-Pipelines und zur Automatisierung des Modell-Onboardings lässt sich das TorchTPU-Ökosystem in Ray einbinden und bietet Erweiterungen für KI-Agenten mit Zugriff auf die TPU-Dokumentation.
Ray: Verteiltes Training, Bereitstellung und RL
Ray skaliert Python- und KI-Arbeitslasten über Cluster hinweg mit Ray Train, Ray Serve, Ray Data, Ray Core und RL-Frameworks wie verl.
Motivation
Multislicing-Training und mehrstufige Pipelines (z. B. RL-Workflows, die Datenvorverarbeitung, Training und Roll-out-Generierung kombinieren) erfordern eine automatisierte Slice-Bereitstellung, Topologieerkennung und fehlertolerante Worker-Koordination. Eigenständige Startdienstprogramme wie torchrun stellen keine TPU-Slices bereit und koordinieren keine mehrstufigen Akteur-Pipelines. Daher verwaltet Ray die clusterweite Planung und Platzierung für TorchTPU-Arbeitslasten.
Design
Wenn Sie einen Job einreichen und dabei die TPU-Generation, die Topologie und die Anzahl der Worker angeben, reserviert Ray vollständige TPU-Slices, sodass alle Worker in einem Slice zusammen geplant werden. Außerdem werden die Adressen der Chip-Interconnects ermittelt und ein PyTorch-Worker pro TPU-Gerät gestartet. Das PyTorch-Backend von Ray Train initialisiert das tpu-Gerät und die tpu_dist-Prozessgruppe automatisch, bevor der Job gestartet wird.
Wichtigste Stärken
- Topologie-abgestimmte Platzierung: Passt die Platzierung von Workern auf Hosts an die physische TPU-Generation und das Slice-Layout an.
- Automatisierte Fehlerbehebung: Führt verteilte Trainingsjobs auf mehreren TPU-Slices in der GKE mit automatisierter Wiederherstellung aus, wenn ein Worker oder Slice ausfällt.
- Direktes Daten-Prefetching auf TPU: Mit der Methode
iter_torch_batchesvon Ray Data werden Batches als PyTorch-Tensoren direkt in den TPU-Gerätespeicher vorab abgerufen. - Inferenzorchestrierung mit mehreren Hosts: Verwaltet Bereitstellungen mit mehreren Hosts für vLLM-TorchTPU und SGLang-TorchTPU.
TPU Agent Suite: (Vorabversion) Coding-Agents für TPU
Die TPU Agent Suite ist eine Open-Source-Erweiterung für Programmierassistenten, darunter Claude Code und Google Antigravity (weitere Programmier-Agents folgen). Sie ist auf die Transformer-Inferenz (dichte LLMs und MoE-Modelle) auf TPU v6e und TPU7x ausgerichtet.
Motivation
Allgemeinen Programmierassistenten fehlt oft der aktuelle Kontext zu TPU-Hardwaretopologien, XLA-Compiler-Flags, XProf-Telemetrie und Pallas-Kernel-Einschränkungen. Über die TPU Agent Suite erhält Ihr Assistent Zugriff auf die offizielle TPU-Dokumentation und strukturierte Workflows. So werden ungültige Vorschläge für Flags vermieden und iteratives Profiling und Benchmarking automatisiert.
Design
Die Suite fügt Ihrer vorhandenen Unterstützung beim Programmieren eine TPU-Wissensdatenbank und sechs aufgabenspezifische Sub-Agents hinzu. Ein Router-Agent delegiert jeden Prompt an den entsprechenden Sub-Agenten, ohne selbst Befehle auszuführen. Jede Befehlsausführung auf Ihrer TPU-VM oder Ihrem GKE-Cluster erfordert Ihre Genehmigung. Abstimmungsschleifen führen eine begrenzte Anzahl von aufgezeichneten Versuchen aus, bevor Ergebnisse zurückgegeben werden.
Wichtigste Stärken
- Modell-Onboarding und Genauigkeitsprüfung: Der TPU-Modell-Onboarding-Agent löst nicht unterstützte Operatoren auf, wählt einen Bereitstellungspfad (vLLM-TorchTPU oder Standard-PyTorch) aus und vergleicht die Ausgaben der einzelnen Schichten mit dem CPU-Referenzmodell, um die numerische Genauigkeit zu prüfen.
- Absturz- und Engpassdiagnose: Der TPU-Diagnose-Agent analysiert Absturzprotokolle, prüft XProf-Profile und XLA-Compiler-Traces und isoliert Laufzeitengpässe.
- Kernel-, Compiler- und Sharding-Optimierung: Der TPU-Kernel-Entwicklungs-Agent unterstützt bei benutzerdefinierten Pallas-Kernels, der TPU-Leistungsoptimierungs-Agent führt Benchmarks für XLA-Compiler-Flag-Kombinationen durch und der TPU-Sharding-Agent plant Multislice-Parallelitätslayouts.
- Dokumentationssuche mit Zitaten: Der TPU Knowledge Base-Agent beantwortet technische Fragen mit expliziten Zitaten aus der offiziellen TPU-Dokumentation und den TPU-Anleitungen und gibt an, wenn ein Thema nicht behandelt wird.
Weitere Informationen finden Sie in der Dokumentation zur TPU Agent Suite. Sie können Feedback geben und Fragen in den GitHub-Diskussionen stellen oder Probleme auf GitHub melden.
Nächste Schritte
- Erste Schritte mit der TorchTPU-Dokumentation.
- Probieren Sie die TorchTitan auf TPU-Rezepte aus.
- Inferenzarbeitslasten mit vLLM-TorchTPU und SGLang-TorchTPU bereitstellen.
- Fragen im Diskussionsforum zu PyTorch auf TPU stellen
- Wenn Sie einen bestimmten Anwendungsfall mit dem Produkt- und Entwicklungsteam von Google besprechen möchten, senden Sie eine E-Mail an torchtpu-feedback@google.com.