


Produktions-KI auf Cloud TPUs mit JAX erstellen
Der JAX AI Stack erweitert den numerischen JAX-Kern um eine Sammlung von von Google unterstützten zusammensetzbaren Bibliotheken und entwickelt ihn zu einer robusten, End-to-End-Open-Source-Plattform für Machine Learning in extremem Umfang. Der JAX AI Stack besteht aus einer umfassenden und robusten Umgebung, die den gesamten ML-Lebenszyklus abdeckt:
Grundlage für industrielle Skalierung: Der JAX AI Stack ist für massive Skalierung ausgelegt. Er nutzt ML Pathways, um das Training über Zehntausende von Chips hinweg zu orchestrieren, und Orbax für asynchrones Checkpointing mit hohem Durchsatz und hoher Ausfallsicherheit. So wird ein produktionsreifes Training von hochmodernen Modellen ermöglicht.
Vollständiges, produktionsreifes Toolkit: Der JAX AI Stack bietet eine umfassende Sammlung von Bibliotheken für den gesamten Entwicklungsprozess: Flax für die flexible Modellerstellung, Optax für kombinierbare Optimierungsstrategien und Grain für die deterministischen Datenpipelines, die für reproduzierbare, umfangreiche Ausführungen unerlässlich sind.
Spezialisierte Spitzenleistung: Um die Hardware maximal auszulasten, bietet der JAX AI Stack spezialisierte Bibliotheken, darunter Tokamax für hochmoderne benutzerdefinierte Kernel, Qwix für nicht-intrusive Quantisierung, die die Trainings- und Inferenzgeschwindigkeit erhöht, und XProf für tiefgreifendes, hardwareintegriertes Leistungsprofiling.
Vollständiger Pfad zur Produktion: Der JAX AI Stack ermöglicht einen nahtlosen Übergang von der Forschung zur Bereitstellung. Dazu gehören MaxText als skalierbare Referenz für das Training von Foundation Models, Tunix für hochmodernes Reinforcement Learning (RL) und Alignment sowie eine einheitliche Inferenzlösung mit vLLM-JAX und der JAX-Bereitstellungslaufzeit.
Die Philosophie des JAX AI Stack basiert auf lose gekoppelten Komponenten, von denen jede eine bestimmte Aufgabe gut erfüllt. JAX ist kein monolithisches ML-Framework, sondern hat einen engen Fokus und konzentriert sich auf effiziente Array-Vorgänge und Programmtransformationen. Das Ökosystem basiert auf diesem Kern-Framework, um eine Vielzahl von Funktionen bereitzustellen, die sowohl mit dem Training von ML-Modellen als auch mit anderen Arten von Arbeitslasten wie wissenschaftlichem Computing zusammenhängen.
Dieses System aus lose gekoppelten Komponenten ermöglicht es Ihnen, Bibliotheken so auszuwählen und zu kombinieren, dass sie Ihren Anforderungen am besten entsprechen. Aus Sicht der Softwareentwicklung können Sie mit dieser Architektur auch Funktionen iterativ aktualisieren, die herkömmlicherweise als Kernkomponenten des Frameworks gelten (z. B. Datenpipelines und Prüfpunkte), ohne dass die Gefahr besteht, dass das Kernframework destabilisiert wird oder Sie in Releasezyklen hängen bleiben. Da die meisten Funktionen in Bibliotheken implementiert sind und nicht durch Änderungen an einem monolithischen Framework, ist die numerische Kernbibliothek langlebiger und lässt sich besser an zukünftige Veränderungen in der Technologielandschaft anpassen.
In den folgenden Abschnitten finden Sie eine technische Übersicht über den JAX AI Stack, seine wichtigsten Funktionen, die Designentscheidungen dahinter und wie sie zusammen eine langlebige Plattform für moderne ML-Arbeitslasten bilden.
Der JAX AI Stack und andere Komponenten des Ökosystems
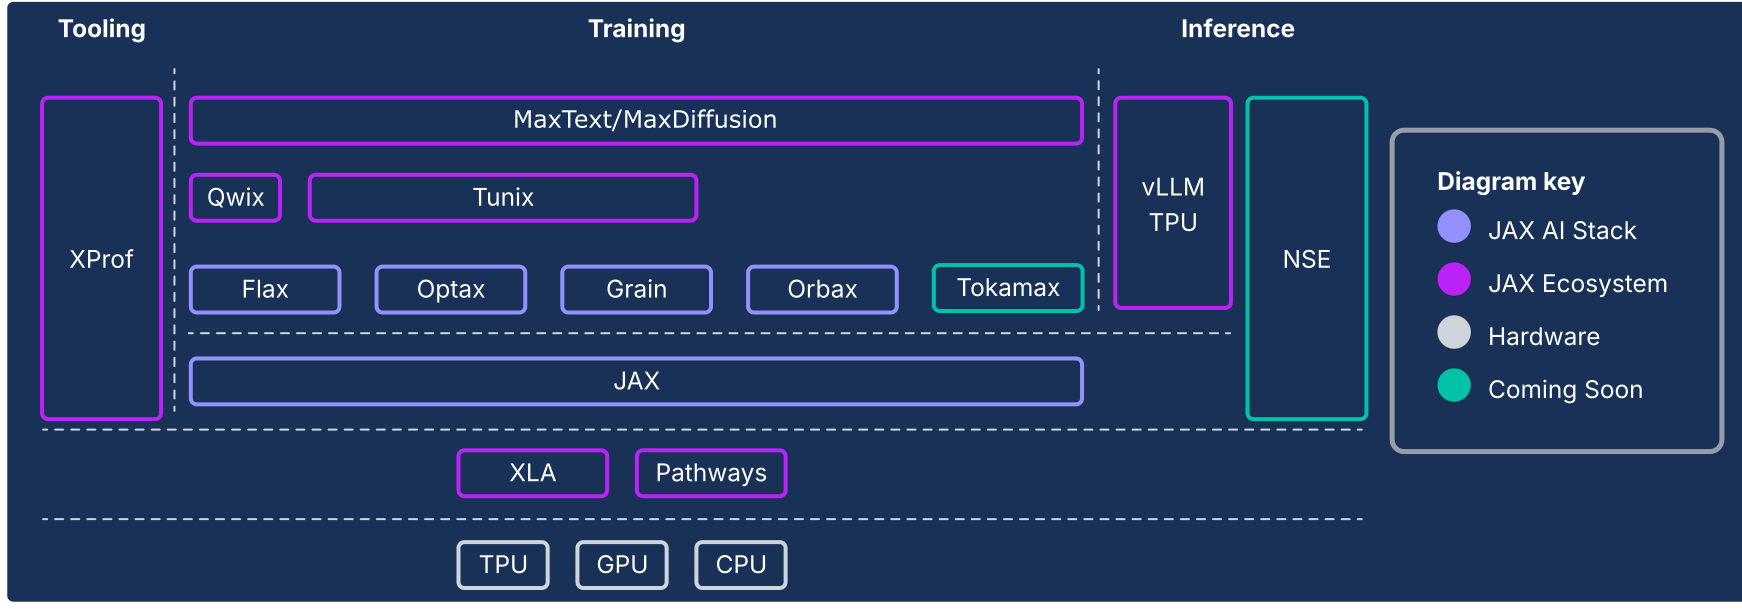
| Komponente | Funktion / Beschreibung |
|---|---|
| Kern und Komponenten des JAX AI Stack1 | |
| JAX | Beschleunigerorientierte Array-Berechnung und Programmtransformation (JIT, grad, vmap, pmap). |
| Flax | Flexible Bibliothek zur Erstellung neuronaler Netzwerke für die intuitive Erstellung und Änderung von Modellen. |
| Optax | Eine Bibliothek mit zusammensetzbaren Transformationen für die Gradientenverarbeitung und -optimierung. |
| Orbax | Bibliothek für verteilte Prüfpunkte in beliebigem Umfang für die Ausfallsicherheit von Trainings im Hero-Maßstab. |
| Körnung | Eine skalierbare, deterministische und prüfpunktfähige Bibliothek für Eingabedatenpipelines. |
| JAX AI Stack – Infrastruktur | |
| XLA | Open-Source-Compiler für maschinelles Lernen für TPUs, CPUs und GPUs. |
| Pathways | Verteilte Laufzeit zur Orchestrierung von Berechnungen auf Zehntausenden von Chips. |
| JAX AI Stack – Fortgeschritten Entwicklung | |
| Pallas | Eine JAX-Erweiterung zum Schreiben von benutzerdefinierten Low-Level- und Hochleistungs-Kernels, die in Python implementiert sind. |
| Tokamax | Eine kuratierte Bibliothek mit hochmodernen, leistungsstarken benutzerdefinierten Kernels (z. B. Attention). |
| Qwix | Eine umfassende, nicht-intrusive Bibliothek für die Quantisierung (PTQ, QAT, QLoRA). |
| JAX AI Stack – Anwendung | |
| MaxText / MaxDiffusion | Skalierbare Referenz-Frameworks für das Training von Foundation Models (z. B. LLM und Diffusion). |
| Tunix | Ein Framework für hochmodernes Post-Training und Alignment (RLHF, DPO). |
| vLLM-JAX | Eine leistungsstarke LLM-Inferenzlösung mit integrierter Einbindung des vLLM-Frameworks. |
| XProf | Ein tiefgreifender, hardwareintegrierter Profiler für die systemweite Leistungsanalyse. |
1 Im Python-Paket jax-ai-stack enthalten.
Abbildung 1: JAX AI Stack und Ökosystemkomponenten
Die architektonische Notwendigkeit: Leistung über Frameworks hinaus
Da Modellarchitekturen konvergieren, z. B. bei multimodalen Mixture-of-Experts-Transformern (MoE), führt das Streben nach Spitzenleistung zur Entstehung von Megakernen. Ein Megakernel ist im Grunde der gesamte Vorwärtsdurchlauf (oder ein großer Teil davon) eines bestimmten Modells, der mit einer Low-Level-API wie dem CUDA SDK auf NVIDIA-GPUs manuell codiert wurde. Dieser Ansatz ermöglicht eine maximale Hardwareauslastung, indem Computing, Speicher und Kommunikation aggressiv überlappt werden. Neuere Arbeiten aus der Forschungsgemeinschaft haben gezeigt, dass dieser Ansatz bei der Inferenz auf GPUs zu erheblichen Durchsatzsteigerungen führen kann, in einigen Fällen um mehr als 22 %. Dieser Trend beschränkt sich nicht nur auf die Inferenz. Es gibt Hinweise darauf, dass bei einigen groß angelegten Trainingsbemühungen eine Hardwaresteuerung auf niedriger Ebene eingesetzt wurde, um erhebliche Effizienzsteigerungen zu erzielen.
Wenn sich dieser Trend beschleunigt, könnten alle heute existierenden High-Level-Frameworks an Bedeutung verlieren, da für die Leistung auf ausgereiften, stabilen Architekturen letztendlich der Low-Level-Zugriff auf die Hardware entscheidend ist. Dies stellt eine Herausforderung für alle modernen ML-Stacks dar: Wie kann eine Hardwaresteuerung auf Expertenebene bereitgestellt werden, ohne die Produktivität und Flexibilität eines High-Level-Frameworks zu beeinträchtigen?
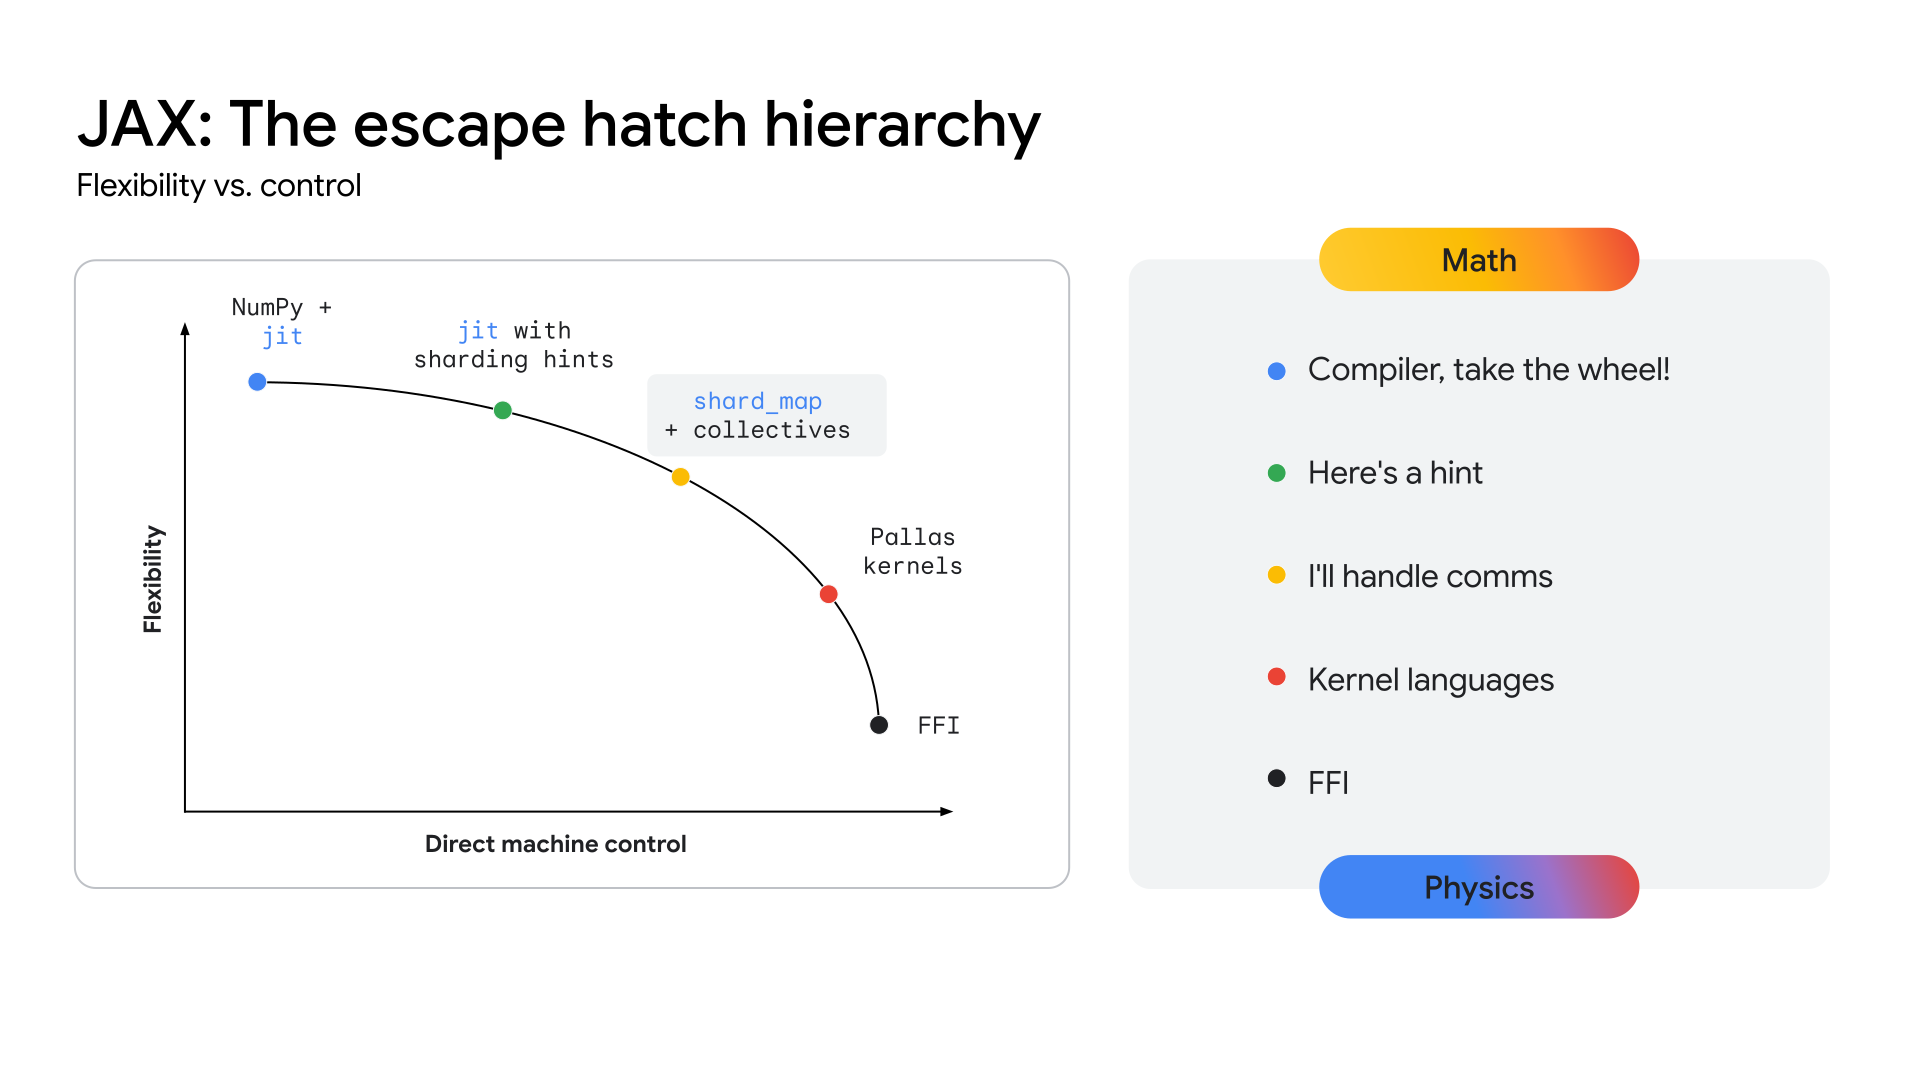
Damit TPUs einen klaren Weg zu diesem Leistungsniveau bieten können, muss das Ökosystem eine API-Ebene bereitstellen, die näher an der Hardware liegt, um die Entwicklung dieser hochspezialisierten Kernel zu ermöglichen. Der JAX-Stack wurde entwickelt, um dieses Problem zu lösen, indem er ein Kontinuum an Abstraktion bietet (siehe Abbildung 2) – von den automatisierten, allgemeinen Optimierungen des XLA-Compilers bis hin zur detaillierten, manuellen Steuerung der Pallas-Kernel-Authoring-Bibliothek.
Abbildung 2: Das JAX-Abstraktionskontinuum
Der zentrale JAX AI Stack
Der JAX AI Stack besteht aus fünf wichtigen Bibliotheken, die die Grundlage für die Modellentwicklung bilden:
JAX: Eine Grundlage für die zusammensetzbare, leistungsstarke Programmtransformation
JAX ist eine Python-Bibliothek für beschleunigerorientierte Array-Berechnungen und Programmtransformationen, die für leistungsstarkes numerisches Computing und umfangreiches maschinelles Lernen entwickelt wurde. Mit seinem funktionalen Programmiermodell und der NumPy-ähnlichen API bietet JAX eine solide Grundlage für übergeordnete Bibliotheken.
Mit seinem Compiler-First-Design fördert JAX die Skalierbarkeit, indem es XLA (siehe Abschnitt zu XLA) für eine aggressive, programmweite Analyse, Optimierung und Hardware-Ausrichtung nutzt. Der Schwerpunkt von JAX auf funktionaler Programmierung (z. B. reine Funktionen) macht die Kernprogrammtransformationen besser handhabbar und vor allem kombinierbar.
Diese Kerntransformationen können kombiniert werden, um eine hohe Leistung und Skalierung von Arbeitslasten über Modellgröße, Clustergröße und Hardwaretypen hinweg zu erreichen:
- jit: Just-in-Time-Kompilierung von Python-Funktionen in optimierte, fusionierte XLA-Ausführbare.
- grad: Automatische Differenzierung, die den Vorwärts- und Rückwärtsmodus sowie Ableitungen höherer Ordnung unterstützt.
- vmap: Automatische Vektorisierung, die nahtloses Batching und Datenparallelität ermöglicht, ohne die Funktionslogik zu ändern.
- pmap / shard_map: Automatische Parallelisierung über mehrere Geräte (z. B. TPU-Kerne), die die Grundlage für verteiltes Training bildet.
Durch die nahtlose Integration in das GSPMD-Modell (General-purpose SPMD) von XLA kann JAX Berechnungen automatisch über große TPU-Pods hinweg parallelisieren, wobei nur minimale Codeänderungen erforderlich sind. In den meisten Fällen sind für die Skalierung nur Sharding-Annotationen auf hoher Ebene erforderlich.
Flax: Flexible Erstellung neuronaler Netzwerke
Flax vereinfacht das Erstellen, Debuggen und Analysieren neuronaler Netzwerke in JAX, indem es einen intuitiven, objektorientierten Ansatz für die Modellentwicklung bietet. Die funktionale API von JAX ist zwar leistungsstark, bietet aber eine vertrautere ebenenbasierte Abstraktion für Entwickler, die an Frameworks wie PyTorch gewöhnt sind, ohne dass die Leistung beeinträchtigt wird.
Dieses Design vereinfacht das Ändern oder Kombinieren trainierter Modellkomponenten.
Techniken wie LoRA und Quantisierung erfordern manipulierbare Modelldefinitionen, die die NNX API von Flax über eine Python-Schnittstelle bereitstellt. NNX kapselt den Modellstatus, reduziert die kognitive Belastung der Nutzer und ermöglicht das programmatische Durchlaufen und Ändern der Modellhierarchie.
Wichtigste Stärken:
- Intuitive objektorientierte API: Vereinfacht die Modellerstellung und ermöglicht erweiterte Anwendungsfälle wie das Ersetzen von Submodulen und die teilweise Initialisierung.
- Konsistent mit Core JAX: Flax bietet Lifted Transformations, die vollständig mit dem funktionalen Paradigma von JAX kompatibel sind. So wird die volle Leistung von JAX mit verbesserter Entwicklerfreundlichkeit kombiniert.
Optax: Kombinierbare Strategien zur Gradientenverarbeitung und -optimierung
Optax ist eine Bibliothek zur Gradientenverarbeitung und -optimierung für JAX. Es soll Modellentwicklern Bausteine bieten, die sich auf benutzerdefinierte Weise neu kombinieren lassen, um unter anderem Deep-Learning-Modelle zu trainieren. Sie baut auf den Funktionen der JAX-Kernbibliothek auf und bietet eine gut getestete, leistungsstarke Bibliothek mit Verlust- und Optimierungsfunktionen sowie zugehörigen Techniken, die zum Trainieren von ML-Modellen verwendet werden können.
Motivation
Die Berechnung und Minimierung von Verlusten ist der Kern des Trainings von ML-Modellen. Die JAX-Kernbibliothek unterstützt die automatische Differenzierung und bietet die numerischen Funktionen zum Trainieren von Modellen. Sie bietet jedoch keine Standardimplementierungen gängiger Optimierer (z. B. RMSProp oder Adam) oder Verluste (z. B. CrossEntropy oder MSE). Sie könnten diese Funktionen zwar implementieren (und einige fortgeschrittene Entwickler werden dies auch tun), aber ein Fehler in einer Optimiererimplementierung würde zu schwer zu diagnostizierenden Problemen mit der Modellqualität führen. Anstatt dass der Nutzer solche kritischen Teile implementieren muss, bietet Optax Implementierungen dieser Algorithmen, die auf Korrektheit und Leistung getestet wurden.
Das Feld der Optimierungstheorie liegt im Bereich der Forschung. Seine zentrale Rolle beim Training macht es jedoch auch zu einem unverzichtbaren Bestandteil des Trainings von ML-Modellen für die Produktion. Eine Bibliothek, die diese Rolle erfüllt, muss sowohl flexibel genug sein, um schnelle Forschungsiterationen zu ermöglichen, als auch robust und leistungsfähig genug, um für das Training von Produktionsmodellen zuverlässig zu sein. Außerdem sollten gut getestete Implementierungen von hochmodernen Algorithmen bereitgestellt werden, die den Standardgleichungen entsprechen. Die Optax-Bibliothek ist mit ihrer modularen, zusammensetzbaren Architektur und dem Fokus auf korrektem, lesbarem Code darauf ausgelegt, dies zu erreichen.
Design
Optax wurde entwickelt, um sowohl die Forschungsgeschwindigkeit als auch den Übergang von der Forschung zur Produktion zu verbessern. Dazu werden lesbare, gut getestete und effiziente Implementierungen von Kernalgorithmen bereitgestellt. Optax kann auch außerhalb des Kontexts von Deep Learning verwendet werden. In diesem Kontext kann es jedoch als eine Sammlung bekannter Verlustfunktionen, Optimierungsalgorithmen und Gradiententransformationen betrachtet werden, die in einer rein funktionalen Weise im Einklang mit der JAX-Philosophie implementiert sind. Die Sammlung bekannter Verluste und Optimierer ermöglicht Nutzern einen einfachen und sicheren Einstieg.
Der modulare Ansatz von Optax ermöglicht es Ihnen, mehrere Optimierer miteinander zu verketten, gefolgt von anderen gängigen Transformationen (z. B. Gradienten-Clipping) und sie mit gängigen Techniken wie MultiStep oder Lookahead zu verpacken, um mit wenigen Codezeilen leistungsstarke Optimierungsstrategien zu erzielen. Über die flexible Oberfläche können Sie neue Optimierungsalgorithmen erforschen und leistungsstarke Optimierungstechniken zweiter Ordnung wie Shampoo oder Muon verwenden.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
Im vorherigen Code-Snippet wird gezeigt, wie Sie einen Optimierer mit einer benutzerdefinierten Lernrate, Gradienten-Clipping und Gradientenakkumulation einrichten.
Wichtigste Stärken
- Umfangreiche Bibliothek: Bietet eine umfassende Bibliothek mit Verlusten, Optimierern und Algorithmen, wobei der Schwerpunkt auf Korrektheit und Lesbarkeit liegt.
- Modulare, verkettbare Transformationen: Mit dieser flexiblen API können Sie leistungsstarke, komplexe Optimierungsstrategien deklarativ erstellen, ohne die Trainingsschleife zu ändern.
- Funktional und skalierbar: Die rein funktionalen Implementierungen lassen sich nahtlos in die Parallelisierungsmechanismen von JAX (z. B. pmap) einbinden. So können Sie mit demselben Code von einem einzelnen Host auf große Cluster skalieren.
Orbax / TensorStore – Groß angelegte verteilte Prüfpunkte
Orbax ist eine Prüfpunktbibliothek für JAX, die für jede Größenordnung geeignet ist, von einzelnen Geräten bis hin zu groß angelegtem verteiltem Training. Ziel ist es, fragmentierte Checkpointing-Implementierungen zu vereinheitlichen und wichtige Leistungsfunktionen wie asynchrones und mehrstufiges Checkpointing einem breiteren Publikum zugänglich zu machen. Orbax bietet die für umfangreiche Trainingsjobs erforderliche Ausfallsicherheit und ein flexibles Format für die Veröffentlichung von Prüfpunkten.
Im Gegensatz zu allgemeinen Prüfpunkt- und Wiederherstellungssystemen, die den gesamten Systemstatus erfassen, werden beim ML-Prüfpunkt mit Orbax nur die Informationen selektiv beibehalten, die für die Fortsetzung des Trainings erforderlich sind: Modellgewichtungen, Optimierungsstatus und Datenladerstatus. Durch diesen gezielten Ansatz werden Ausfallzeiten von Beschleunigern minimiert. Orbax erreicht dies, indem E/A-Vorgänge mit Berechnungen überlappt werden. Dies ist eine wichtige Funktion für große Arbeitslasten. Die Zeit, in der die Beschleuniger inaktiv sind, wird auf die Dauer der Datenübertragung vom Gerät zum Host reduziert. Diese kann sich mit dem nächsten Trainingsschritt überschneiden, sodass das Checkpointing aus Leistungssicht fast kostenlos ist.
Im Kern verwendet Orbax TensorStore für das effiziente, parallele Lesen und Schreiben von Array-Daten. Die Orbax API abstrahiert diese Komplexität und bietet eine nutzerfreundliche Oberfläche für die Verarbeitung von PyTrees, der Standarddarstellung von Modellen in JAX.
Wichtigste Stärken:
- Weit verbreitet: Mit Millionen von monatlichen Downloads dient Orbax als gängiges Medium für die Freigabe von ML-Artefakten.
- Vereinfacht die Komplexität: Orbax abstrahiert die Komplexität des verteilten Checkpointings, einschließlich asynchronem Speichern, Atomizität und Dateisystemdetails.
- Flexibel: Orbax bietet APIs für gängige Anwendungsfälle, ermöglicht es Ihnen aber auch, Ihren Workflow an spezielle Anforderungen anzupassen.
- Leistungsstark und skalierbar: Funktionen wie asynchrones Checkpointing, ein effizientes Speicherformat (OCDBT) und intelligente Strategien zum Laden von Daten sorgen dafür, dass Orbax auf Trainingsläufe mit Zehntausenden von Knoten skaliert werden kann.
Grain: Deterministische und skalierbare Eingabedatenpipelines
Grain ist eine Python-Bibliothek zum Lesen und Verarbeiten von Daten für das Training und die Bewertung von JAX-Modellen. Sie ist flexibel, schnell und deterministisch und unterstützt erweiterte Funktionen wie Prüfpunkte, die für das erfolgreiche Training großer Arbeitslasten unerlässlich sind. Es unterstützt gängige Datenformate und Speicher-Back-Ends und bietet außerdem eine flexible API, um die Unterstützung auf nutzerspezifische Formate und Back-Ends zu erweitern, die nicht nativ unterstützt werden. Grain ist zwar hauptsächlich für die Verwendung mit JAX konzipiert, aber frameworkunabhängig. Es ist nicht erforderlich, dass JAX ausgeführt wird, und kann auch mit anderen Frameworks verwendet werden.
Motivation
Datenpipelines sind ein wichtiger Bestandteil der Trainingsinfrastruktur. Sie müssen flexibel sein, damit gängige Transformationen effizient ausgedrückt werden können, und leistungsfähig genug, um die Beschleuniger jederzeit auszulasten. Außerdem müssen sie mehrere Speicherformate und Back-Ends unterstützen. Aufgrund der höheren Schrittzeiten stellt das Training großer Modelle im großen Maßstab zusätzliche Anforderungen an die Datenpipeline, die über die Anforderungen regulärer Trainingsarbeitslasten hinausgehen. Diese Anforderungen konzentrieren sich hauptsächlich auf Determinismus und Reproduzierbarkeit2. Die Grain-Bibliothek ist mit einer flexiblen Architektur konzipiert, die diese Anforderungen erfüllt.
2 In Abschnitt 5.1 des PaLM-Papers weisen die Autoren darauf hin, dass sie trotz aktiviertem Gradient Clipping sehr große Verlustspitzen beobachtet haben. Die Lösung bestand darin, die fehlerhaften Datenbatches zu entfernen und das Training von einem Prüfpunkt vor dem Verlustanstieg neu zu starten. Dies ist nur mit einer vollständig deterministischen und reproduzierbaren Trainingseinrichtung möglich.
Design
Auf der höchsten Ebene gibt es zwei Möglichkeiten, eine Eingabepipeline zu strukturieren: als separaten Cluster von Daten-Workern oder durch die gemeinsame Bereitstellung der Daten-Worker auf den Hosts, die die Beschleuniger steuern. Grain entscheidet sich aus verschiedenen Gründen für Letzteres.
Beschleuniger werden mit leistungsstarken Hosts kombiniert, die während der Trainingsschritte in der Regel inaktiv sind. Daher ist es sinnvoll, die Eingabedatenpipeline auf ihnen auszuführen. Diese Implementierung bietet zusätzliche Vorteile: Sie vereinfacht die Ansicht der Datenfragmentierung, da eine einheitliche Ansicht der Fragmentierung für Eingabe und Berechnung bereitgestellt wird. Man könnte argumentieren, dass die Platzierung des Daten-Workers auf dem Beschleuniger-Host die Host-CPU überlasten könnte. Dies schließt jedoch nicht aus, dass rechenintensive Transformationen mithilfe von RPCs auf einen anderen Cluster ausgelagert werden3.
Auf der API-Seite können Sie mit Grain dank einer reinen Python-Implementierung, die mehrere Prozesse und eine flexible API unterstützt, beliebig komplexe Datentransformationen implementieren. Dazu werden Pipelinephasen basierend auf bekannten Transformationsparadigmen zusammengestellt.
Grain unterstützt standardmäßig effiziente Datenformate mit zufälligem Zugriff wie ArrayRecord und Bagz sowie andere gängige Datenformate wie Parquet und TFDS. Grain unterstützt standardmäßig das Lesen aus lokalen Dateisystemen sowie das Lesen aus Cloud Storage. Neben der Unterstützung gängiger Speicherformate und Back-Ends ermöglicht eine saubere Abstraktion der Speicherebene, dass Sie Unterstützung für Ihre vorhandenen Datenquellen hinzufügen oder diese so verpacken können, dass sie mit der Grain-Bibliothek kompatibel sind.
3So müssen multimodale Datenpipelines funktionieren: Bild- und Audio-Tokenizer sind beispielsweise selbst Modelle, die in ihren eigenen Clustern auf ihren eigenen Beschleunigern ausgeführt werden. Die Eingabepipelines würden RPC-Aufrufe ausführen, um Datenbeispiele in Tokenstreams umzuwandeln.
Wichtigste Stärken
- Deterministische Datenbereitstellung: Durch die gemeinsame Bereitstellung des Daten-Workers mit dem Beschleuniger und die Kopplung mit einem stabilen globalen Shuffle und Prüfpunkt-Iteratoren können der Modellstatus und der Datenpipelinestatus zusammen in einem konsistenten Snapshot mit Orbax gespeichert werden. Das verbessert den Determinismus des Trainingsprozesses.
- Flexible APIs für leistungsstarke Datentransformationen: Mit einer flexiblen, reinen Python-Transformations-API können Sie umfangreiche Datentransformationen innerhalb der Eingabeverarbeitungspipeline durchführen.
- Erweiterbare Unterstützung für mehrere Formate und Back-Ends: Eine erweiterbare Datenquellen-API unterstützt gängige Speicherformate und Back-Ends und ermöglicht es Ihnen, Unterstützung für neue Formate und Back-Ends hinzuzufügen.
- Leistungsstarke Debugging-Oberfläche: Mit Visualisierungstools für Datenpipelines und einem Debug-Modus können Sie die Leistung Ihrer Datenpipelines prüfen, debuggen und optimieren.
Der erweiterte JAX AI Stack
Über den Kern-Stack hinaus bietet ein umfangreiches Ökosystem spezialisierter Bibliotheken die Infrastruktur, die erweiterten Tools und die Lösungen auf Anwendungsebene, die für die End-to-End-ML-Entwicklung erforderlich sind.
Grundlegende Infrastruktur: Compiler und Laufzeiten
XLA: Die hardwareunabhängige, compilerzentrierte Engine
Motivation
XLA oder Accelerated Linear Algebra ist der domänenspezifische Compiler von Google, der gut in JAX integriert ist und TPU-, CPU- und GPU-Hardwaregeräte unterstützt. XLA wurde als hardwareunabhängiger Codegenerator für TPUs, GPUs und CPUs entwickelt.
Das Compiler-First-Design des XLA-Compilers ist eine grundlegende Architekturentscheidung, die in einer sich schnell entwickelnden Forschungslandschaft einen dauerhaften Vorteil bietet. Im Gegensatz dazu beruht der vorherrschende Kernel-zentrierte Ansatz in anderen Ökosystemen auf handoptimierten Bibliotheken für die Leistung. Dies ist zwar für stabile, etablierte Modellarchitekturen sehr effektiv, stellt aber einen Engpass für Innovationen dar. Wenn neue Forschungsergebnisse neue Architekturen hervorbringen, muss das Ökosystem warten, bis neue Kernel geschrieben und optimiert wurden. Unser compilerzentriertes Design kann jedoch oft auf neue Muster verallgemeinert werden und bietet vom ersten Tag an einen leistungsstarken Pfad für innovative Forschung.
Design
XLA kompiliert die Berechnungsgraphen, die JAX während des Tracing-Prozesses generiert (z. B. wenn eine Funktion mit @jax.jit dekoriert ist), Just-In-Time (JIT).
Diese Kompilierung folgt einer mehrstufigen Pipeline:
- JAX-Berechnungsdiagramm
- High-Level Optimizer (HLO)
- Low-Level Optimizer (LLO)
- Hardwarecode
- Vom JAX-Graphen zu HLO: Der JAX-Berechnungsgraph wird in die HLO-Darstellung von XLA konvertiert. Auf dieser hohen Ebene werden leistungsstarke, hardwareunabhängige Optimierungen wie Operatorfusion und effiziente Speicherverwaltung angewendet. Der StableHLO-Dialekt dient als langlebige, versionierte Schnittstelle für diese Phase.
- Von HLO zu LLO: Nach den allgemeinen Optimierungen übernehmen hardwarespezifische Backends und wandeln die HLO-Darstellung in eine maschinenorientierte LLO um.
- Vom LLO zum Hardwarecode: Das LLO wird schließlich in hocheffizienten Maschinencode kompiliert. Für TPUs wird dieser Code als VLIW-Pakete (Very Long Instruction Word) gebündelt, die direkt an die Hardware gesendet werden.
Das Design von XLA ist auf Parallelität ausgelegt, um die Skalierung zu ermöglichen. Es werden Algorithmen verwendet, um die Matrixmultiplikationseinheiten (MXUs) auf einem Chip maximal zu nutzen. Zwischen Chips verwendet XLA SPMD (Single Program Multiple Data), eine compilerbasierte Parallelisierungstechnik, die ein einzelnes Programm auf allen Geräten verwendet. Dieses leistungsstarke Modell wird über JAX APIs bereitgestellt, sodass Sie Daten-, Modell- oder Pipeline-Parallelität mit Sharding-Anmerkungen auf hoher Ebene verwalten können.
Für komplexere Parallelitätsmuster ist auch Multiple Program Multiple Data (MPMD) möglich. Bibliotheken wie PartIR:MPMD ermöglichen es JAX-Nutzern, auch MPMD-Annotationen bereitzustellen.
Wichtigste Stärken
- Kompilierung: Die Just-in-Time-Kompilierung des Berechnungsgraphen ermöglicht Optimierungen des Speicherlayouts, der Pufferzuweisung und der Speicherverwaltung. Bei Alternativen wie kernelbasierten Methoden liegt diese Last beim Entwickler. In den meisten Fällen kann XLA eine hervorragende Leistung erzielen, ohne die Entwicklungsgeschwindigkeit zu beeinträchtigen.
- Parallelität: XLA implementiert mehrere Formen der Parallelität mit SPMD, die auf JAX-Ebene verfügbar sind. So können Sie Sharding-Strategien ausdrücken und Modelle auf Tausenden von Chips skalieren und testen.
Pathways: Eine einheitliche Laufzeit für verteilte Berechnungen in großem Maßstab
Pathways bietet Abstraktionen für verteiltes Training und Inferenz mit integrierter Fehlertoleranz und Wiederherstellung. So können ML-Forscher Code schreiben, als würden sie eine einzelne, leistungsstarke Maschine verwenden.
Motivation
Für das Training und die Bereitstellung großer Modelle sind Hunderte bis Tausende von Chips erforderlich. Diese Chips sind auf zahlreiche Racks und Hostmaschinen verteilt. Ein Trainingsjob ist ein umfangreiches synchrones Programm, bei dem alle diese Chips und ihre jeweiligen Hosts gemeinsam an XLA-Berechnungen arbeiten müssen, die parallelisiert (fragmentiert) wurden. Bei Large Language Models, die möglicherweise mehr als Zehntausende von Chips benötigen, muss dieser Dienst in der Lage sein, mehrere Pods über eine Rechenzentrums-Fabric hinweg zu verbinden und zusätzlich Interchip Interconnect (ICI)- und On-Chip Interconnect (OCI)-Fabrics innerhalb eines Pods zu verwenden.
Design
ML Pathways ist das System, mit dem wir verteilte Berechnungen über Hosts und TPU-Chips hinweg koordinieren. Sie ist auf Skalierbarkeit und Effizienz für Hunderttausende von Beschleunigern ausgelegt. Für umfangreiches Training bietet es einen einzelnen Python-Client für mehrere Pod-Jobs, Megascale XLA-Integration, einen Kompilierungsdienst und Remote-Python. Außerdem werden Slice-übergreifende Parallelität und Toleranz gegenüber Preemption unterstützt, was eine automatische Wiederherstellung nach Ressourcen-Preemptions ermöglicht.
Pathways enthält optimierte hostübergreifende Kollektive, mit denen XLA-Berechnungsgrafiken über einen einzelnen TPU-Pod hinaus erweitert werden können. Die Unterstützung von XLA für Daten-, Modell- und Pipeline-Parallelität wird erweitert, sodass sie über TPU-Slice-Grenzen hinweg über das Rechenzentrumsnetzwerk (Data Center Network, DCN) funktioniert. Dazu wird eine verteilte Laufzeit integriert, die die DCN-Kommunikation mit XLA-Kommunikationsprimitiven verwaltet.
Wichtigste Stärken
Die in JAX integrierte Single-Controller-Architektur ist eine wichtige Abstraktion. Damit können Forscher verschiedene Sharding- und Parallelisierungsstrategien für das Training und die Bereitstellung untersuchen und gleichzeitig problemlos auf Zehntausende von Chips skalieren.
Erweiterte Entwicklung: Leistung, Daten und Effizienz
Pallas: Leistungsstarke benutzerdefinierte Kernel in JAX schreiben
Obwohl JAX in erster Linie ein Compiler ist, gibt es Situationen, in denen Sie die Hardware genau steuern möchten, um die maximale Leistung zu erzielen. Pallas ist eine Erweiterung für JAX, mit der benutzerdefinierte Kernel für GPUs und TPUs geschrieben werden können. Ziel ist es, eine präzise Kontrolle über den generierten Code zu ermöglichen, kombiniert mit der Ergonomie von JAX-Tracing und der jax.numpy API.
Pallas bietet ein rasterbasiertes Parallelitätsmodell, bei dem eine benutzerdefinierte Kernelfunktion über ein mehrdimensionales Raster paralleler Arbeitsgruppen gestartet wird. Sie ermöglicht die explizite Verwaltung der Speicherhierarchie, indem Sie definieren können, wie Tensoren zwischen langsamerem, größerem Speicher (z. B. HBM) und schnellerem, kleinerem On-Chip-Speicher (z. B. VMEM auf TPU, Shared Memory auf GPU) aufgeteilt und übertragen werden. Dabei werden Indexzuordnungen verwendet, um Rasterpositionen mit bestimmten Datenblöcken zu verknüpfen. Pallas kann dieselbe Kerneldefinition so reduzieren, dass sie sowohl auf den TPUs von Google als auch auf verschiedenen GPUs effizient ausgeführt wird. Dazu werden Kernel in eine Zwischendarstellung kompiliert, die für die Zielarchitektur geeignet ist – Mosaic für TPUs oder Technologien wie Triton für GPUs. Mit Pallas können Sie leistungsstarke Kernel schreiben, die Blöcke wie Attention spezialisieren, um die beste Modellleistung auf der Zielhardware zu erzielen, ohne auf herstellerspezifische Toolkits angewiesen zu sein.
Tokamax: Eine ausgewählte Bibliothek mit hochmodernen Kernels
Wenn Pallas ein Tool zum Erstellen von Kernels ist, ist Tokamax eine Bibliothek mit hochmodernen benutzerdefinierten Beschleuniger-Kernels, die sowohl TPUs als auch GPUs unterstützen. Tokamax basiert auf JAX und Pallas und ermöglicht es Ihnen, die volle Leistung Ihrer Hardware zu nutzen. Außerdem bietet es Tools zum Erstellen und automatischen Optimieren benutzerdefinierter Kernel.
Motivation
JAX, das seine Wurzeln in XLA hat, ist ein Compiler-First-Framework. Es gibt jedoch einige wenige Fälle, in denen Sie die Hardware direkt steuern müssen, um die maximale Leistung zu erzielen4. Benutzerdefinierte Kernel sind entscheidend, um die beste Leistung aus teuren ML-Beschleunigerressourcen wie TPUs und GPUs herauszuholen. Sie werden zwar häufig verwendet, um die leistungsstarke Ausführung wichtiger Operatoren wie Attention zu ermöglichen, ihre Implementierung erfordert jedoch ein tiefes Verständnis sowohl des Modells als auch der Zielhardwarearchitektur. Tokamax bietet eine maßgebliche Quelle für ausgewählte, gut getestete, leistungsstarke Kernel sowie eine robuste gemeinsame Infrastruktur für deren Entwicklung, Wartung und Lebenszyklusverwaltung. Eine solche Bibliothek kann auch als Referenzimplementierung dienen, auf der Sie aufbauen und die Sie nach Bedarf anpassen können. So können Sie sich auf Ihre Modellierungsaufgaben konzentrieren, ohne sich um die Infrastruktur kümmern zu müssen.
4 Dies ist ein bewährtes Paradigma, das auch in der CPU-Welt verwendet wird. Dort macht kompilierter Code den Großteil des Programms aus und Entwickler greifen auf intrinsische Funktionen oder Inline-Assembly zurück, um leistungskritische Abschnitte zu optimieren.
Design
Für jeden Kernel bietet Tokamax eine gemeinsame API, die von mehreren Implementierungen unterstützt werden kann. TPU-Kernel können beispielsweise entweder durch standardmäßiges XLA-Lowering oder explizit mit Pallas/Mosaic-TPU implementiert werden. GPU-Kernel können durch standardmäßige XLA-Lowering, mit Mosaic-GPU oder Triton implementiert werden. Standardmäßig wählt die Tokamax API die bekannteste Implementierung für eine bestimmte Konfiguration aus. Diese wird anhand von im Cache gespeicherten Ergebnissen aus regelmäßigen Autotuning- und Benchmarking-Ausführungen ermittelt. Sie können jedoch bei Bedarf auch bestimmte Implementierungen auswählen. Im Laufe der Zeit können neue Implementierungen hinzugefügt werden, um bestimmte Funktionen in neuen Hardwaregenerationen besser zu nutzen und so die Leistung noch weiter zu steigern.
Eine Schlüsselkomponente der Tokamax-Bibliothek ist neben den Kerneln selbst die unterstützende Infrastruktur, mit der Sie benutzerdefinierte Kernel schreiben können. Mit der Autotuning-Infrastruktur können Sie beispielsweise eine Reihe konfigurierbarer Parameter (z. B. Tile-Größen) definieren, für die Tokamax einen umfassenden Sweep durchführen kann, um die bestmöglichen optimierten Einstellungen zu ermitteln und im Cache zu speichern. Nächtliche Regressionen schützen Sie vor unerwarteten Leistungs- und numerischen Problemen, die durch Änderungen an der zugrunde liegenden Compiler-Infrastruktur oder anderen Abhängigkeiten verursacht werden.
Wichtigste Stärken
- Nahtlose Entwicklererfahrung: Eine einheitliche, kuratierte Bibliothek bietet bekannte, leistungsstarke Implementierungen wichtiger Kernel mit klaren Angaben zu unterstützten Hardwaregenerationen und erwarteter Leistung, sowohl programmatisch als auch in der Dokumentation. Dadurch werden Fragmentierung und Abwanderung minimiert.
- Flexibilität und Lebenszyklusverwaltung: Sie können verschiedene Implementierungen auswählen und diese bei Bedarf im Laufe der Zeit ändern. Wenn der XLA-Compiler beispielsweise die Unterstützung für bestimmte Vorgänge verbessert, sind keine benutzerdefinierten Kernel mehr erforderlich. Es gibt einen Pfad für die Einstellung und Migration.
- Erweiterbarkeit: Sie können Ihre eigenen Kernel implementieren und gleichzeitig eine gut unterstützte gemeinsame Infrastruktur nutzen. So können Sie sich auf Funktionen und Optimierungen mit Mehrwert konzentrieren. Klar verfasste Standardimplementierungen dienen als Ausgangspunkt, von dem Nutzer lernen und den sie erweitern können.
Qwix: Nicht-intrusive, umfassende Quantisierung
Qwix ist eine umfassende Quantisierungsbibliothek für den JAX AI Stack, die sowohl LLMs als auch andere Modelltypen in allen Phasen unterstützt, einschließlich Training (Quantization Aware Training (QAT), Quantization Technique (QT), Quantized Low-Rank Adaptation (QLoRA)) und Inferenz-Post-Training-Quantisierung (PTQ), die sowohl auf XLA- als auch auf On-Device-Laufzeiten abzielt.
Motivation
Vorhandene Quantisierungsbibliotheken, insbesondere im PyTorch-Ökosystem, dienen oft nur begrenzten Zwecken (z. B. nur PTQ oder nur QLoRA). Diese fragmentierte Landschaft zwingt Sie dazu, zwischen Tools zu wechseln, was eine konsistente Codeverwendung und einen präzisen numerischen Abgleich zwischen Training und Inferenz erschwert. Außerdem erfordern viele Lösungen erhebliche Modelländerungen, wodurch die Modelllogik eng mit der Quantisierungslogik verknüpft wird.
Design
Die Designphilosophie von Qwix legt Wert auf eine umfassende Lösung und vor allem auf eine nicht-intrusive Modellintegration. Sie ist hierarchisch und erweiterbar aufgebaut und basiert auf wiederverwendbaren funktionalen APIs.
Diese unaufdringliche Integration wird durch einen sorgfältig entwickelten Abfangmechanismus erreicht, der JAX-Funktionen an ihre quantisierten Gegenstücke weiterleitet. So können Sie Ihre Modelle ohne Änderungen einbinden und den Quantisierungscode vollständig von den Modelldefinitionen entkoppeln.
Im folgenden Beispiel wird die w4a4-Quantisierung (4-Bit-Gewichtung, 4-Bit-Aktivierung) auf die MLP-Ebenen eines LLM und die w8-Quantisierung (8-Bit-Gewichtung) auf den Embedder angewendet. Wenn Sie das Quantisierungsrezept ändern möchten, müssen Sie nur die Regelliste aktualisieren.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
Wichtigste Stärken
- Umfassende Lösung: Qwix ist in zahlreichen Quantisierungsszenarien einsetzbar und sorgt für eine konsistente Codenutzung zwischen Training und Inferenz.
- Nicht-intrusive Modellintegration: Wie das Beispiel zeigt, können Sie Modelle mit einer einzigen Codezeile einbinden. So können Sie Hyperparameter für viele Quantisierungsschemas verwenden, um den besten Kompromiss zwischen Qualität und Leistung zu finden.
- Föderiert mit anderen Bibliotheken: Qwix lässt sich nahtlos in den JAX AI Stack einbinden. Tokamax passt sich beispielsweise automatisch an, um quantisierte Versionen von Kernels zu verwenden, ohne dass zusätzlicher Nutzercode erforderlich ist, wenn das Modell mit Qwix quantisiert wird.
- Forschungsfreundlich: Die grundlegenden APIs und die erweiterbare Architektur von Qwix ermöglichen es Forschern, neue Algorithmen zu untersuchen und unkomplizierte Vergleiche mit integrierten Benchmark- und Bewertungstools durchzuführen.
Die Anwendungsebene: Training und Alignment
Foundation Model-Training: MaxText und MaxDiffusion
MaxText und MaxDiffusion sind die wichtigsten LLM- und Diffusionsmodell-Trainingsframeworks von Google. Diese Repositories enthalten eine Auswahl hochoptimierter Implementierungen beliebter Open-Weights-Modelle. Sie dienen einem doppelten Zweck: Sie fungieren sowohl als sofort einsatzbereite Codebasis für das Modelltraining als auch als Referenz, auf der Entwickler von Foundation Models aufbauen können.
Motivation
Das Interesse am Training von GenAI-Modellen wächst in der gesamten Branche rasant. Die Beliebtheit offener Modelle hat diesen Trend beschleunigt und bewährte Architekturen bereitgestellt. Das Trainieren und Anpassen dieser Modelle erfordert hohe Leistung, Effizienz, Skalierbarkeit auf eine große Anzahl von Chips und klaren, verständlichen Code. MaxText und MaxDiffusion sind umfassende Lösungen, die auf TPUs oder GPUs verwendet werden können und diese Anforderungen erfüllen.
Design
MaxText und MaxDiffusion sind Codebasen für Foundation Models, die auf Lesbarkeit und Leistung ausgelegt sind. Sie sind mit gut getesteten, wiederverwendbaren Komponenten strukturiert: Modelldefinitionen, die benutzerdefinierte Kernel (wie Tokamax) für maximale Leistung verwenden, ein Trainings-Harness für Orchestrierung und Monitoring sowie ein leistungsstarkes Konfigurationssystem, mit dem Sie Details wie Sharding und Quantisierung (mit Qwix) über eine intuitive Oberfläche steuern können. Erweiterte Zuverlässigkeitsfunktionen wie mehrstufige Prüfpunkte sorgen für einen dauerhaft guten Durchsatz.
MaxText und MaxDiffusion nutzen die erstklassigen JAX-Bibliotheken Qwix, Tunix, Orbax und Optax, um Kernfunktionen bereitzustellen. Diese Bibliotheken bieten eine robuste, skalierbare Infrastruktur, reduzieren den Entwicklungsaufwand und ermöglichen es Ihnen, sich auf die Modellierungsaufgabe zu konzentrieren. Für die Inferenz wird der Modellcode freigegeben, um eine effiziente und skalierbare Bereitstellung zu ermöglichen.
Wichtigste Stärken
- Performant by Design: Mit einer Trainingsinfrastruktur, die für einen hohen „Goodput“ (nützlichen Durchsatz) eingerichtet ist, und Modellimplementierungen, die für eine hohe MFU (Model Flops Utilization) optimiert sind, bieten MaxText und MaxDiffusion sofort eine hohe Leistung bei horizontaler Skalierung.
- Für Skalierung entwickelt: Mit der Leistung des JAX AI Stack (insbesondere Pathways) können Sie mit diesen Frameworks nahtlos von Dutzenden auf Zehntausende von Chips skalieren.
- Solide Grundlage für Foundation Model-Entwickler: Die hochwertigen, lesbaren Implementierungen dienen Entwicklern als solide Grundlage, die sie entweder als End-to-End-Lösung oder als Referenzimplementierung für ihre eigenen Anpassungen verwenden können.
Nach dem Training und der Abstimmung: das Tunix-Framework
Tunix bietet hochmoderne Open-Source-Algorithmen für bestärkendes Lernen (Reinforcement Learning, RL) sowie ein robustes Framework und eine robuste Infrastruktur. Entwickler können so auf einfache Weise mit LLM-Post-Training-Techniken experimentieren, einschließlich überwachter Feinabstimmung (Supervised Fine Tuning, SFT) und Alignment mit JAX und TPUs.
Motivation
Das Post-Training ist ein wichtiger Schritt, um das volle Potenzial von LLMs auszuschöpfen. Die Phase des bestärkenden Lernens (Reinforcement Learning, RL) ist besonders wichtig für die Entwicklung von Alignment- und Reasoning-Fähigkeiten. Die Open-Source-Entwicklung in diesem Bereich basiert fast ausschließlich auf PyTorch und GPUs, was eine grundlegende Lücke für JAX- und TPU-Lösungen hinterlässt. Tunix (Tune-in-JAX) ist eine leistungsstarke, JAX-native Bibliothek, die diese Lücke schließen soll.
Design
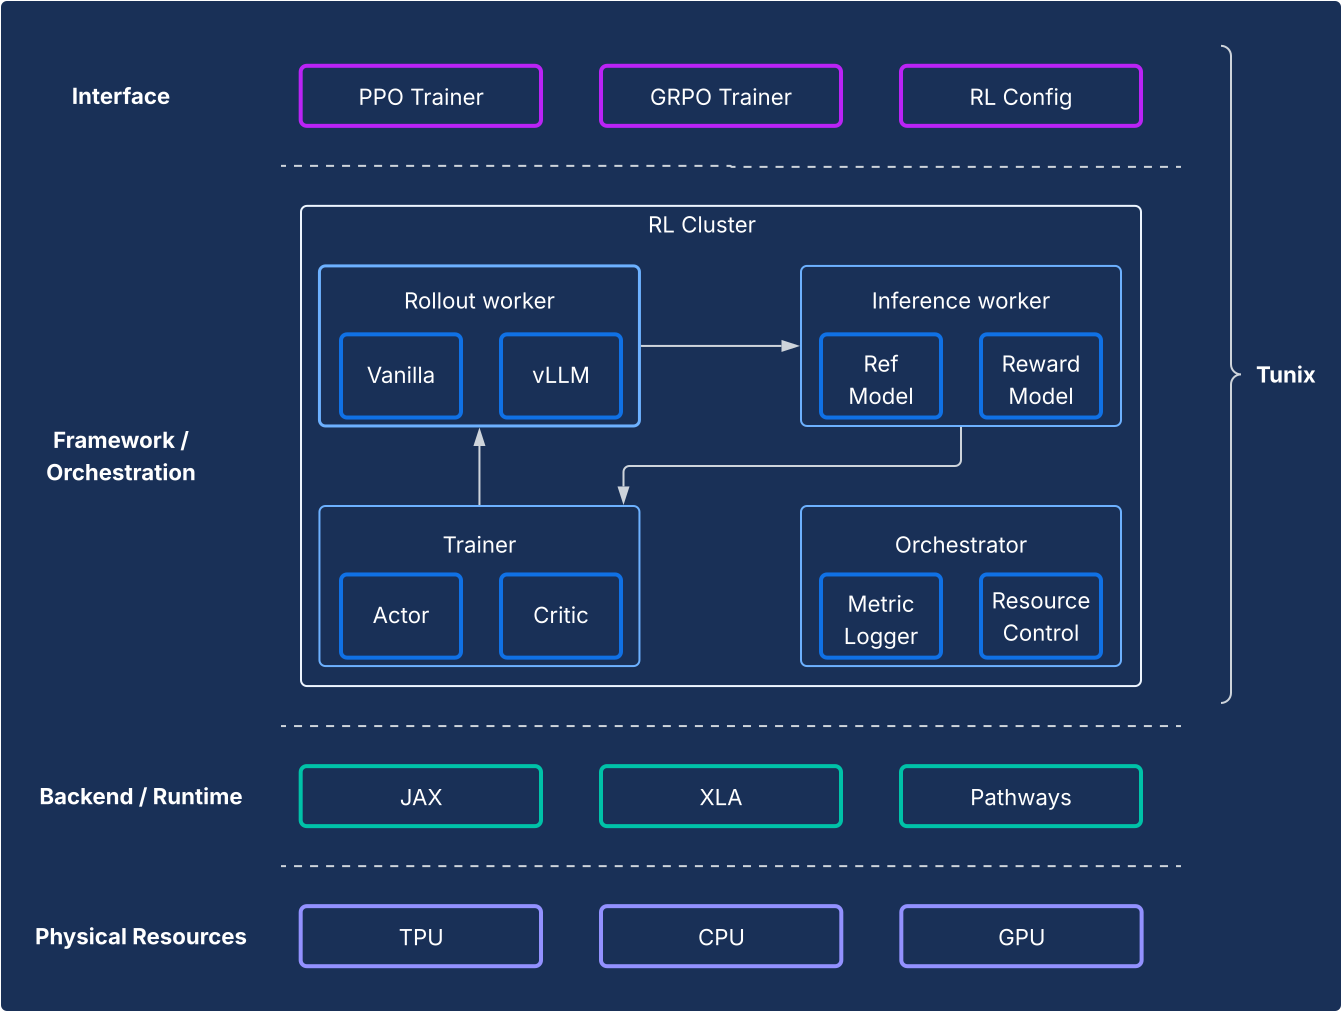
Aus Framework-Sicht ermöglicht Tunix eine hochmoderne Einrichtung, die RL-Algorithmen klar von der Infrastruktur trennt. Es bietet eine einfache, clientähnliche API, die die Komplexität der RL-Infrastruktur verbirgt, sodass Sie neue Algorithmen entwickeln können. Tunix bietet Standardlösungen für gängige Algorithmen, darunter Proximal Policy Optimization (PPO) und Direct Preference Optimization (DPO).
Auf der Infrastrukturseite ist Tunix in Pathways eingebunden, was eine Single-Controller-Architektur ermöglicht, die RL-Training mit mehreren Knoten zugänglich macht. Auf der Trainingsseite unterstützt Tunix nativ parametereffizientes Training (z. B. LoRA) und nutzt JAX-Sharding und XLA (General and Scalable Parallelization for ML Computation Graph, GSPMD), um einen leistungsstarken Berechnungsgraphen zu generieren. Es unterstützt gängige Open-Source-Modelle wie Gemma und Llama standardmäßig.
Wichtigste Stärken
- Einfachheit: Es bietet eine allgemeine, clientähnliche API, die die Komplexität der zugrunde liegenden verteilten Infrastruktur abstrahiert.
- Entwicklereffizienz: Tunix beschleunigt den Forschungs- und Entwicklungszyklus mit integrierten Algorithmen und „Rezepten“. So erhalten Sie ein funktionierendes Modell und können schnell iterieren.
- Leistung und Skalierbarkeit: Tunix ermöglicht eine hocheffiziente und horizontal skalierbare Trainingsinfrastruktur, indem Pathways als einzelner Controller im Backend genutzt wird.
Die Anwendungsebene: Produktion und Inferenz
Eine historische Herausforderung für die Einführung von JAX war der Weg von der Forschung zur Produktion. Der JAX AI Stack bietet jetzt eine ausgereifte, zweigleisige Produktionsgeschichte, die sowohl Kompatibilität mit dem Ökosystem als auch JAX-Leistung bietet.
Leistungsstarke LLM-Inferenz: Die vLLM-JAX-Lösung
vLLM-JAX ist das leistungsstarke Inferenz-Backend von Google, das für die effiziente Ausführung von JAX-Large Language Models (LLMs) auf Cloud TPUs entwickelt wurde. Es bindet das Open-Source-vLLM-Framework in das JAX- und TPU-Ökosystem von Google ein. Informationen zum Bereitstellen von PyTorch-Modellen mit vLLM auf TPUs finden Sie unter PyTorch auf Cloud TPU.
Motivation
Die Branche entwickelt sich rasant weiter und die Nachfrage nach nahtlosen, leistungsstarken und nutzerfreundlichen Inferenzlösungen steigt. Entwickler stehen oft vor großen Herausforderungen, die durch komplexe und inkonsistente Tools, unzureichende Leistung und eingeschränkte Modellkompatibilität verursacht werden. Der vLLM-Stack löst diese Probleme, indem er eine einheitliche, leistungsstarke und intuitive Plattform bietet.
Design
Diese Lösung erweitert das vLLM-Framework, anstatt es neu zu erfinden. vLLM-JAX ist eine hochoptimierte Open-Source-LLM-Bereitstellungs-Engine, die für ihren hohen Durchsatz bekannt ist. Dieser wird durch wichtige Funktionen wie PagedAttention (das KV-Caches wie virtuellen Speicher verwaltet, um die Fragmentierung zu minimieren) und Continuous Batching (das dem Batch dynamisch Anfragen hinzufügt, um die Auslastung zu verbessern) erreicht.
vLLM-JAX baut auf dieser Grundlage auf und entwickelt Kernkomponenten für die Anfrageverarbeitung, Planung und Speicherverwaltung. Es wird ein JAX-basiertes Backend eingeführt, das als Brücke fungiert und den Berechnungsgraphen und die Speichervorgänge von vLLM in TPU-ausführbaren Code übersetzt. Dieses Backend übernimmt die Geräteinteraktionen, die Ausführung des JAX-Modells und die Besonderheiten der Verwaltung des KV-Cache auf TPU-Hardware. Es enthält TPU-spezifische Optimierungen wie effiziente Aufmerksamkeitsmechanismen (z. B. die Nutzung von JAX Pallas-Kernels für Ragged Paged Attention) und Quantisierung, die alle auf die TPU-Architektur zugeschnitten sind.
Wichtigste Stärken
- Keine Onboarding-/Offboarding-Kosten für Nutzer: Nutzer können diese Lösung ohne nennenswerte Probleme übernehmen. Aus Sicht der Nutzer sollte die Verarbeitung von Inferenzanfragen auf TPUs mit der auf GPUs identisch sein. Die Befehlszeile zum Starten des Servers, zum Akzeptieren von Prompts und zum Zurückgeben von Ausgaben wird freigegeben.
- Das Ökosystem vollständig nutzen: Bei diesem Ansatz werden die vLLM-Schnittstelle und die Nutzererfahrung genutzt und verbessert, um Kompatibilität und Nutzerfreundlichkeit zu gewährleisten.
- Austauschbarkeit zwischen TPUs und GPUs: Die Lösung funktioniert sowohl auf TPUs als auch auf GPUs effizient und bietet Ihnen Flexibilität.
- Kosteneffizient (beste Leistung/$): Optimiert die Leistung, um das beste Preis-Leistungs-Verhältnis für gängige Modelle zu bieten.
JAX-Bereitstellung: Orbax-Serialisierung und Neptune-Bereitstellungs-Engine
Für andere Modelle als LLMs oder für Nutzer, die eine vollständig JAX-native Pipeline wünschen, bieten die Orbax-Serialisierungsbibliothek und das Neptune Serving Engine (NSE)-System eine leistungsstarke End-to-End-Bereitstellungslösung.
Motivation
In der Vergangenheit wurden JAX-Modelle oft über einen umständlichen Weg in die Produktion gebracht, z. B. durch Einbinden in TensorFlow-Grafiken und Bereitstellen mit TensorFlow Serving. Dieser Ansatz brachte erhebliche Einschränkungen und Ineffizienzen mit sich, da Entwickler mit einem separaten Ökosystem arbeiten mussten und die Iteration verlangsamt wurde. Ein dediziertes JAX-natives Bereitstellungssystem ist entscheidend für Nachhaltigkeit, reduzierte Komplexität und optimierte Leistung.
Design
Diese Lösung besteht aus zwei Hauptkomponenten, wie im folgenden Diagramm dargestellt.
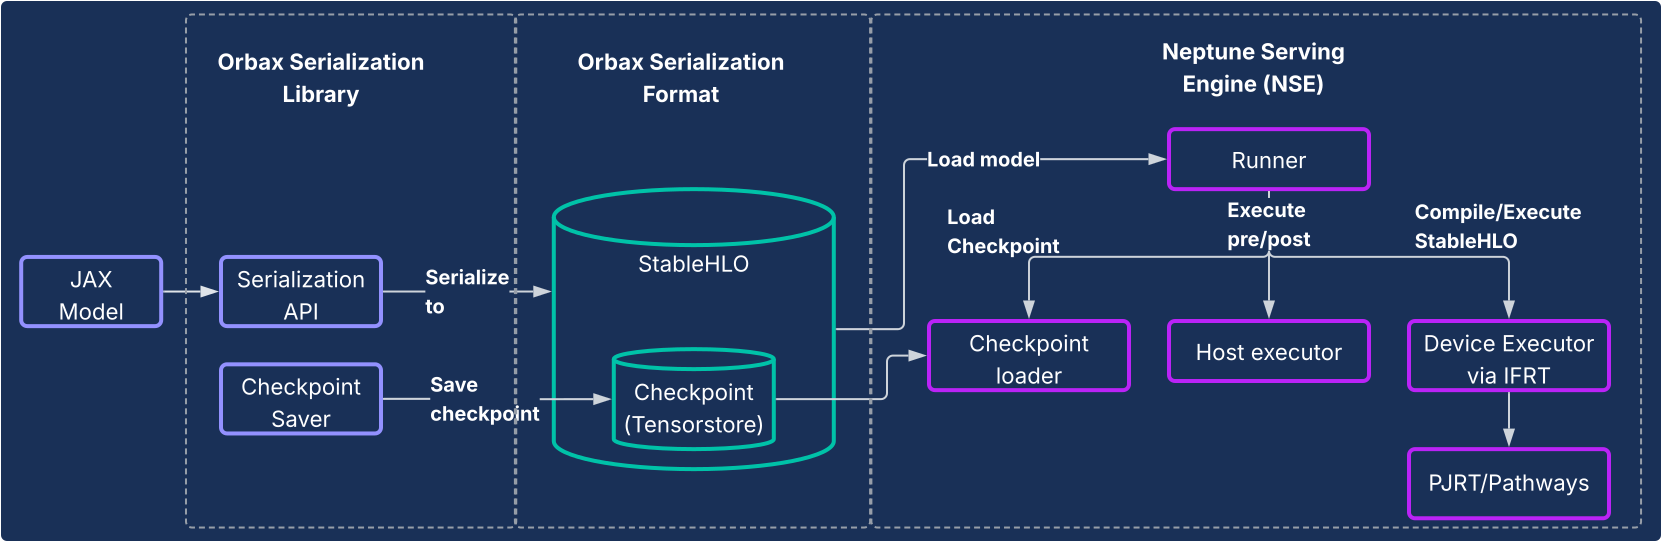
- Orbax-Serialisierungsbibliothek: Bietet nutzerfreundliche APIs zum Serialisieren von JAX-Modellen in ein neues, robustes Orbax-Serialisierungsformat. Dieses Format ist für die Produktionsbereitstellung optimiert. Es stellt JAX-Modellberechnungen direkt mit StableHLO dar, sodass der Berechnungsgraf nativ dargestellt werden kann. Außerdem wird TensorStore zum Speichern von Gewichtungen verwendet, was ein schnelles Laden von Prüfpunkten für die Bereitstellung ermöglicht.
- Neptune Serving Engine (NSE): Dies ist die zugehörige leistungsstarke, flexible Bereitstellungs-Engine (normalerweise als C++-Binärdatei bereitgestellt), die für die native Ausführung von JAX-Modellen im Orbax-Format entwickelt wurde. NSE bietet produktionsrelevante Funktionen wie schnelles Laden von Modellen, gleichzeitige Bereitstellung mit hohem Durchsatz und integriertem Batching, Unterstützung für mehrere Modellversionen sowie Bereitstellung auf einzelnen und mehreren Hosts (mit PJRT und Pathways). Verwenden Sie die Neptune Serving Engine für:
- Nicht-LLM-Modelle: Es ist eine Lösung für allgemeine Zwecke, die sich ideal für Arbeitslasten wie Empfehlungssysteme, Diffusionsmodelle und andere KI-Modelle eignet.
- Kleine LLMs und „One-Shot“-Bereitstellung: Es ist für nicht autoregressive Modelle oder kleinere Modelle konzipiert, die „unär“ bereitgestellt werden. Dabei wird die gesamte Ausgabe in einem einzigen Durchgang generiert, ohne dass eine komplexe Zustandsverwaltung wie ein KV-Cache erforderlich ist.
Kurz gesagt: Die Neptune Serving Engine schließt die Lücke für die Bereitstellung der vielen Modelle, die keine großen, autoregressiven Language Models sind, und bietet eine leistungsstarke TPU-native Lösung für das breitere ML-Ökosystem.
Wichtigste Stärken
- Native JAX-Bereitstellung: Die Lösung wurde nativ für JAX entwickelt, sodass kein Framework-übergreifender Overhead bei der Modellserialisierung und -bereitstellung entsteht. Dies sorgt für ein schnelles Laden des Modells und eine optimierte Ausführung auf CPUs, GPUs und TPUs.
- Mühelose Bereitstellung in der Produktion: Serialisierte Modelle bieten einen hermetischen Bereitstellungspfad, der nicht von Abweichungen bei Python-Abhängigkeiten betroffen ist und Integritätsprüfungen des Modells zur Laufzeit ermöglicht. Dies bietet einen nahtlosen, intuitiven Pfad für die Produktionsreife von JAX-Modellen.
- Verbesserte Entwicklererfahrung: Da kein umständliches Framework-Wrapping mehr erforderlich ist, werden Abhängigkeiten und Systemkomplexität erheblich reduziert, was die Iteration für JAX-Entwickler beschleunigt.
Systemweite Analyse und Profilerstellung
XProf: Detaillierte, hardwareintegrierte Leistungsprofilerstellung
XProf ist ein Profilerstellungs- und Leistungsanalysetool, das detaillierte Einblicke in verschiedene Aspekte der Ausführung von ML-Arbeitslasten bietet, sodass Sie die Leistung debuggen und optimieren können. Es ist eng in die JAX- und TPU-Ökosysteme eingebunden.
Motivation
Einerseits werden ML-Arbeitslasten immer komplexer. Andererseits gibt es eine explosionsartige Zunahme spezialisierter Hardwarefunktionen, die auf diese Arbeitslasten abzielen. Angesichts der enormen Kosten für die ML-Infrastruktur ist es wichtig, beide effektiv aufeinander abzustimmen, um Spitzenleistung und Effizienz zu erzielen. Dazu sind detaillierte Einblicke in die Arbeitslast und die Hardware erforderlich, die schnell verständlich dargestellt werden. XProf ist dafür hervorragend geeignet.
Design
XProf besteht aus zwei Hauptkomponenten: Erfassung und Analyse.
- Erfassung: XProf erfasst Informationen aus verschiedenen Quellen: Annotationen in Ihrem JAX-Code, Kostenmodelle für Vorgänge im XLA-Compiler und speziell entwickelte Hardware-Profilerstellungsfunktionen in der TPU. Diese Erfassung kann programmatisch oder on demand ausgelöst werden und generiert ein umfassendes Ereignisartefakt.
- Analyse: XProf verarbeitet die erfassten Daten nach und erstellt eine Reihe leistungsstarker Visualisierungen, auf die über einen Browser zugegriffen werden kann.
Wichtigste Stärken
Die wahre Stärke von XProf liegt in der tiefen Integration in den gesamten Stack. Dadurch wird eine Breite und Tiefe der Analyse ermöglicht, die ein konkreter Vorteil des gemeinsam entwickelten JAX/TPU-Ökosystems ist.
- Gemeinsam mit der TPU entwickelt: XProf nutzt Hardwarefunktionen, die speziell für die nahtlose Profilerfassung entwickelt wurden, sodass der Erfassungsaufwand weniger als 1% beträgt. So kann die Profilerstellung ein einfacher, iterativer Teil der Entwicklung sein.
- Breite und Tiefe der Analyse: XProf liefert detaillierte Analysen über mehrere Achsen hinweg. Zu den Tools gehören:
- Trace Viewer: Eine Zeitachsenansicht der Ausführung auf verschiedenen Hardwareeinheiten (z. B. TensorCores).
- HLO-Op-Profil: Schlägt die Gesamtzeit in verschiedene Kategorien von Vorgängen auf.
- Memory Viewer: Hier werden die Arbeitsspeicherzuweisungen durch verschiedene Vorgänge während des Profilerstellungsfensters aufgeführt.
- Roofline-Analyse: Hilft Ihnen, festzustellen, ob bestimmte Vorgänge rechen- oder speichergebunden sind und wie weit sie von den Spitzenkapazitäten der Hardware entfernt sind.
- Graph Viewer: Bietet eine Ansicht des vollständigen HLO-Graphen, der von der Hardware ausgeführt wird.
Vergleichsperspektive: Der JAX/TPU-Stack als überzeugende Wahl
Die moderne Machine-Learning-Landschaft bietet viele hervorragende, ausgereifte Toolchains. Der JAX AI Stack bietet Entwicklern, die sich auf umfangreiches, leistungsstarkes ML konzentrieren, eine Reihe einzigartiger und überzeugender Vorteile, die sich direkt aus dem modularen Design und dem tiefgreifenden Hardware-Co-Design ergeben.
Viele Frameworks bieten eine Vielzahl von Funktionen, aber der JAX AI Stack bietet spezifische, leistungsstarke Unterscheidungsmerkmale in wichtigen Bereichen des Entwicklungslebenszyklus:
- Einfachere, leistungsstärkere Entwicklerumgebung: Das verkettbare Gradiententransformationsparadigma von Optax ermöglicht leistungsstärkere und flexiblere Optimierungsstrategien, die einmal deklariert werden, anstatt imperativ in der Trainingsschleife verwaltet zu werden. Auf Systemebene abstrahiert die einfachere Single-Controller-Schnittstelle von Pathways die Komplexität des Multislice-Trainings, was für Forscher eine erhebliche Vereinfachung darstellt.
- Auf extreme Ausfallsicherheit ausgelegt: Der JAX-Stack ist für extrem umfangreiches Training konzipiert. Orbax bietet Funktionen für die „Hero-Scale-Trainingsresilienz“ wie Notfall- und mehrstufige Prüfpunkte. Ergänzt wird dies durch Grain, das die Reproduzierbarkeit mit deterministischen globalen Shuffles und prüfpunktfähigen Datenladern vollständig unterstützt. Die Möglichkeit, den Zustand der Datenpipeline (Grain) und den Modellzustand (Orbax) atomar zu prüfen, ist eine wichtige Funktion, um die Reproduzierbarkeit bei Jobs mit langer Ausführungszeit zu gewährleisten.
- Ein vollständiges End-to-End-Ökosystem: Der Stack bietet eine kohärente End-to-End-Lösung. Entwickler können MaxText als SOTA-Referenz für das Training und Tunix für die Abstimmung verwenden. Außerdem können sie mit vLLM-JAX (für vLLM-Kompatibilität) und NSE (für JAX-Leistung) einen klaren, zweigleisigen Weg zur Produktion einschlagen.
Viele Stacks sind aus Sicht der Software auf hoher Ebene ähnlich, aber der entscheidende Faktor ist oft die Leistung/TCO. Hier bietet das gemeinsame Design von JAX und TPUs einen klaren Vorteil. Dieser Leistungs-/TCO-Vorteil ist ein direktes Ergebnis der vertikalen Integration von Software und TPU-Hardware. Die Fähigkeit des XLA-Compilers, Vorgänge speziell für die TPU-Architektur zusammenzuführen, oder für den XProf-Profiler, Hardware-Hooks für <1% Overhead-Profiling zu verwenden, sind konkrete Vorteile dieser tiefen Integration.
Für Organisationen, die diesen Stack einführen, minimiert der umfassende Funktionsumfang des JAX AI Stack die Migrationskosten. Für Kunden, die gängige offene Modellarchitekturen verwenden, ist der Wechsel von anderen Frameworks zu MaxText oft nur eine Frage der Einrichtung von Konfigurationsdateien. Darüber hinaus können gängige Prüfpunktformate wie Safetensors in den Stack aufgenommen werden, sodass vorhandene Prüfpunkte ohne kostspieliges erneutes Training migriert werden können.
In der folgenden Tabelle sind die vom JAX AI Stack bereitgestellten Komponenten und ihre Entsprechungen in anderen Frameworks oder Bibliotheken aufgeführt.
| Funktion | JAX | Alternativen/Äquivalente in anderen Frameworks5 |
| Compiler / Laufzeit | XLA | Induktor, Eager |
| MultiPod-Training | Pathways | Torch Lightning-Strategien, Ray Train, Monarch (neu). |
| Kern-Framework | JAX | PyTorch |
| Modellerstellung | Flax, Max*-Modelle | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| Optimierer und Verluste | Optax | torch.optim.*, torch.nn.*Loss |
| Data Loader | Körnung | Ray Data, HuggingFace-Datenlader |
| Prüfpunkte | Orbax | Verteilte Prüfpunktausführung von PyTorch, NeMo-Prüfpunktausführung |
| Quantisierung | Qwix | TorchAO, bitsandbytes |
| Kernel-Erstellung und bekannte Implementierungen | Pallas / Tokamax | Triton/Helion, Liger-Kernel, TransformerEngine |
| Nach dem Training / der Abstimmung | Tunix | VERL, NeMoRL |
| Profilerstellung | XProf | PyTorch-Profiler, NSight Systems, NSight Compute |
| Foundation Model-Training | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| LLM-Inferenz | vLLM | SGLang |
| Nicht-LLM-Inferenz | NSE | Triton Inference Server, RayServe |
5 Einige der hier aufgeführten Entsprechungen sind nicht immer echte Vergleiche, da andere Frameworks API-Grenzen anders ziehen als JAX. Die Liste der Äquivalente ist nicht vollständig und es erscheinen häufig neue Bibliotheken.
Fazit: Eine langlebige, produktionsreife Plattform für die Zukunft der KI
Die Daten in der vorherigen Tabelle veranschaulichen eine offensichtliche Schlussfolgerung: Diese Stacks haben ihre eigenen Stärken und Schwächen in einer kleinen Anzahl von Bereichen, sind aber insgesamt aus Software-Sicht sehr ähnlich. Beide Stacks bieten schlüsselfertige Lösungen für das Vortraining, die Anpassung nach dem Training und die Bereitstellung von Foundation Models.
Der JAX AI Stack bietet eine überzeugende und robuste Lösung für das Trainieren und Bereitstellen von ML-Modellen in jeder Größenordnung. Es nutzt eine tiefe vertikale Integration von Software und TPU-Hardware, um eine erstklassige Leistung und Gesamtbetriebskosten zu bieten.
Der Stack basiert auf bewährten internen Systemen und wurde so weiterentwickelt, dass er inhärente Zuverlässigkeit und Skalierbarkeit bietet. So können Nutzer auch die größten Modelle zuverlässig entwickeln und bereitstellen. Das modulare und zusammensetzbare Design, das auf der Philosophie des JAX AI Stack basiert, bietet Nutzern beispiellose Freiheit und Kontrolle. Sie können den Stack an ihre spezifischen Anforderungen anpassen, ohne die Einschränkungen eines monolithischen Frameworks.
XLA und Pathways bieten eine skalierbare und fehlertolerante Basis, JAX eine leistungsstarke und ausdrucksstarke Numerikbibliothek, leistungsstarke Kernentwicklungsbibliotheken wie Flax, Optax, Grain und Orbax, erweiterte Leistungstools wie Pallas, Tokamax und Qwix sowie eine robuste Anwendungs- und Produktionsebene in MaxText, vLLM und NSE. Der JAX AI Stack bietet Nutzern eine solide Grundlage, auf der sie aufbauen und modernste Forschung schnell in die Produktion bringen können.