


在 Cloud TPU 上執行 PyTorch
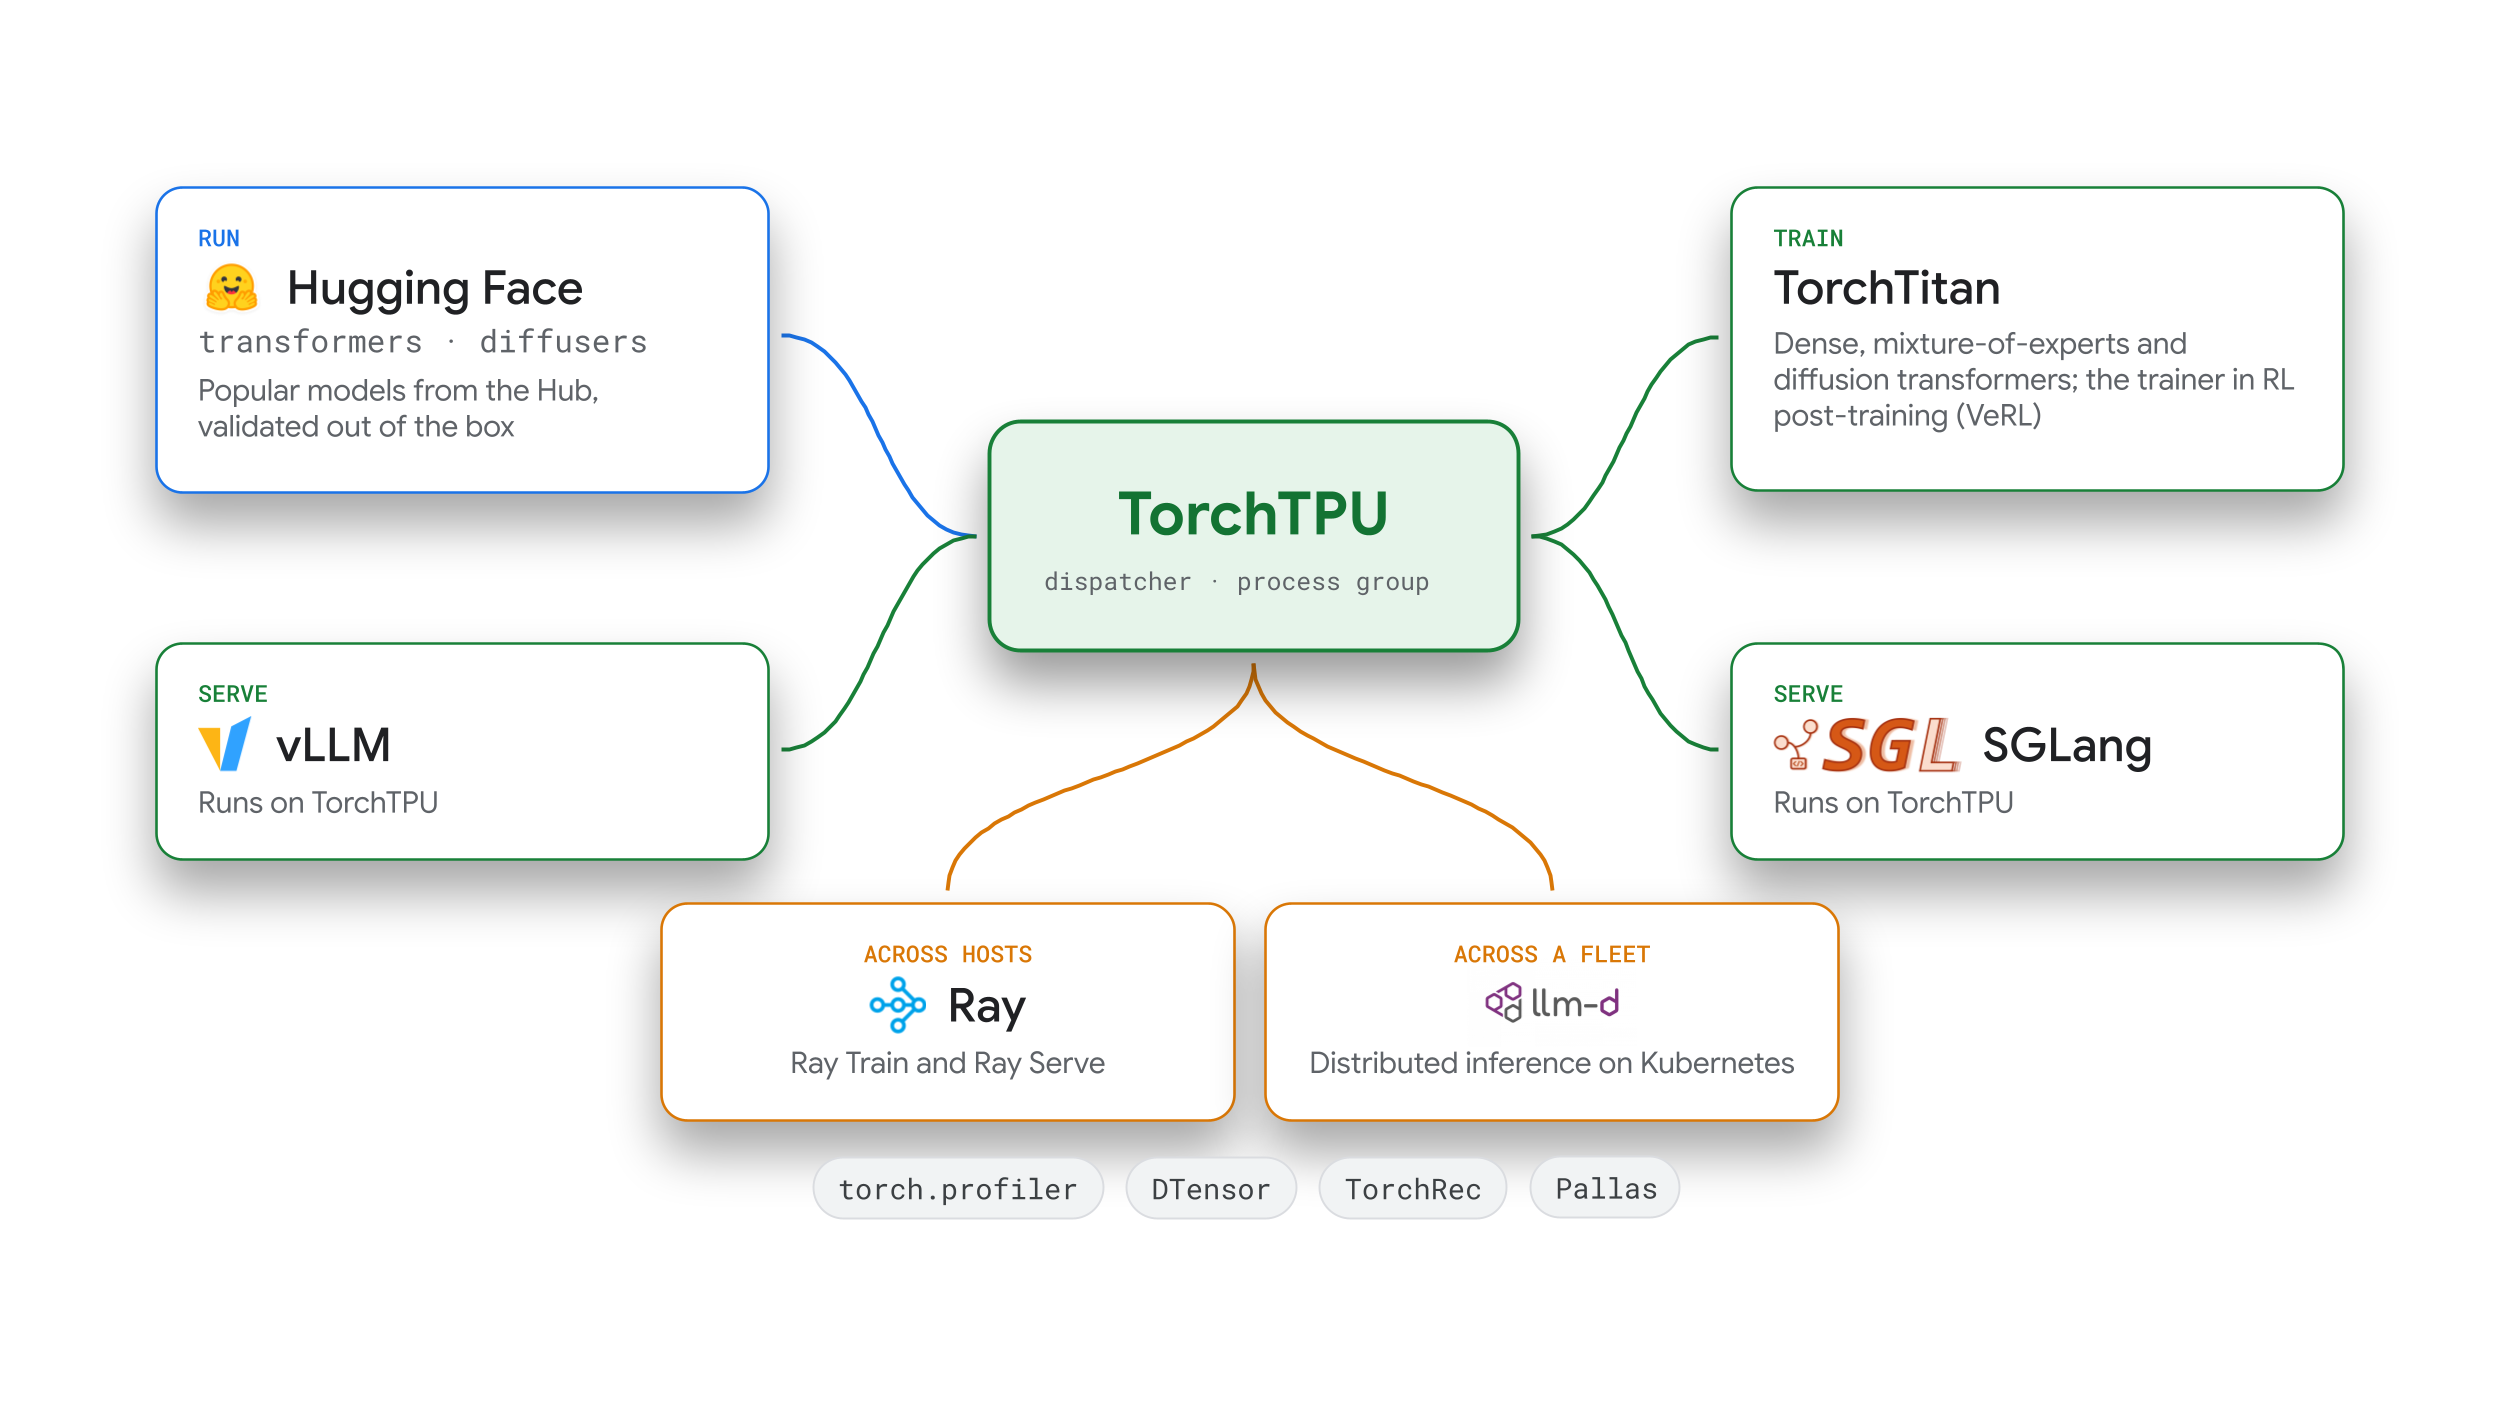
在 Cloud TPU 上使用 PyTorch,即可透過標準 PyTorch 語意和分散式 API,在 Cloud TPU 硬體上訓練、微調及提供開放原始碼模型。可與您目前使用的生態系統工具整合,包括 Hugging Face、vLLM、SGLang、llm-d、TorchTitan、TorchRec 和 Ray。
這個堆疊的基礎是 TorchTPU,這是與 Meta 的 PyTorch 團隊共同開發的開放原始碼 PyTorch 原生後端。TorchTPU 提供程式庫、架構和工具,涵蓋機器學習生命週期的每個階段,包括核心執行階段執行、自訂核心、正式環境推論、大規模訓練和叢集自動化調度管理。
開始使用
- 在 TPU 上執行 PyTorch 模型:從 TorchTPU 和 TorchTPU 說明文件開始。
- 提供大型語言模型 (LLM) 和多模態模型:使用 vLLM-TorchTPU 或 SGLang-TorchTPU。
- 在 Kubernetes 機群中轉送要求:使用 llm-d。
- 預先訓練或微調基礎模型:使用 TPU 上的 TorchTitan (或 TorchRec 推薦模型)。
- 擴充資料處理、訓練、強化學習 (RL) 和服務管道:使用 Ray。
- 使用程式開發輔助,執行模型、分析模型設定檔及調整模型:使用 TPU agent suite (預先發布版)。
TorchTPU:Cloud TPU 的 PyTorch 原生後端
TorchTPU 提供裝置後端、圖形編譯器整合,以及 Cloud TPU 上 PyTorch 的自訂核心 API。TorchTPU 是與 PyTorch 團隊合作開發,可讓您在 eager 模式下以互動方式偵錯模型、使用 torch.compile 編譯模型程式碼,以及使用 torch.distributed (tpu_dist) 跨切片擴充。
執行下列指令,安裝 TorchTPU:
pip install torch_tpu
如要在 Cloud TPU 上執行張量運算,請執行下列 Python 程式碼:
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
以下影片簡要介紹 TorchTPU:
如要深入瞭解,請參閱「TorchTPU 的運作方式」。
動機
雖然 Cloud TPU 過去一直與 JAX 和 TensorFlow 搭配使用,但先前在 TPU 上執行 PyTorch 時,需要延遲張量圖記錄 (PyTorch/XLA),這通常代表需要新增程式碼來標記可編譯區域。TorchTPU 預設會使用 PyTorch 的標準單一程序/裝置執行模型,積極執行作業,因此現有的工作負載和程式庫不需重寫結構即可執行。
設計
TorchTPU 為 PyTorch 帶來 PyTorch 原生 TPU 支援,並著重於三個設計目標:
- 標準 PyTorch 語意:每個裝置執行一項程序,並保留 PyTorch 張量檢視和就地變異,不依賴 JAX 執行階段。
- 預設為 Eager Execution:在 Eager 模式下立即執行標準 PyTorch 模型,以便進行互動式偵錯和逐步檢查。
- 編譯器和核心最佳化:在 Eager 模式中提供運算子融合 (除了逐一運算子 Eager Execution),
torch.compile整合動態形狀邊界以減少重新編譯,以及自訂核心 API。
在圖形編譯方面,torch.compile 會使用 TorchDynamo 擷取 PyTorch 運算圖,並透過 OpenXLA 和 StableHLO 將其編譯為 TPU 機器碼。集體運算會在 torch.distributed 程序群組層級 (tpu_dist) 執行。
主要優點
- 運算子、模型和 Hugging Face 支援:TorchTPU 支援正向和反向傳遞中的標準 PyTorch (ATen) 運算子,並持續針對熱門 Hugging Face 模型進行測試。您可以傳遞
device_map="tpu",在 Transformers v5 中部署模型;使用 eager 模式、torch.compile和張量平行處理執行 Diffusers 管道;以及在 TensorBoard 和 XProf 中使用torch.profiler分析工作負載。 - 從單晶片到多配量擴充:
tpu_dist後端支援DistributedDataParallel(DDP)、FullyShardedDataParallel(FSDP2) 和DTensor。此外,torch.tpu.distributed.topology_aware_mesh會將平行處理維度對應至實體 TPU 互連。 - 可設定的 Eager Execution 模式:提供三種 Eager Execution 模式:
Strict(預設):使用標準命令式 PyTorch 語意,個別且非同步調度運算子。Debug:同步執行,並檢查張量邊界。DeferAndFuse:融合 eager 運算子序列,減少高頻寬記憶體 (HBM) 流量。
- 完整圖表編譯和快取:
torch.compile(backend="tpu")會將圖表編譯成 TPU 執行檔,並在程序、主機和工作重新啟動時快取這些檔案。 - 自訂 TPU 核心:您可以呼叫自訂 Pallas 核心 (包括直接在晶片之間通訊的核心),做為標準 PyTorch 函式。您也可以使用 Tokamax 程式庫中預先建構的核心,或使用 Helion 編寫可攜式圖塊核心。
如要瞭解詳情,請參閱 TorchTPU 說明文件、在 PyTorch on TPU 討論論壇中提問,或在 TorchTPU Issue Tracker 回報問題。
正式環境推論與提供
如要部署至正式環境,Cloud TPU 上的 PyTorch 可與開放原始碼推論引擎和 Kubernetes 原生分散式服務基礎架構整合。
vLLM-TorchTPU 和 SGLang-TorchTPU:推論引擎
vLLM-TorchTPU 和 SGLang-TorchTPU 是 vLLM 和 SGLang 推論引擎的 TorchTPU 後端。這兩個後端都執行開放式模型,例如 Qwen、DeepSeek、GLM、Kimi、GPT-OSS 和 Gemma 4。
詳情請參閱 vLLM-TorchTPU 說明文件,以及宣布推出 TPU 專用新版 vLLM 和 SGLang 推論引擎。
動機
如要提供推論、多模態和工具使用工作負載,通常需要自訂模型定義、推測解碼方法和量化配置。在 TorchTPU 建構 vLLM 和 SGLang 後端,即可直接在 PyTorch 自訂及偵錯服務堆疊。
設計
這兩個後端都保留標準 vLLM 和 SGLang 排程器、鍵/值 (KV) 快取管理工具和 API 伺服器,同時在底層使用 TorchTPU 執行和自訂 Pallas 運算子。大多數模型會執行標準 PyTorch 模型定義,而運算密集區塊則會在編譯圖中叫用 Pallas 核心,因此可獨立更新硬體專屬核心。
主要優點
- 平行處理、量化和推測解碼:支援跨主機的張量、資料、專家、管道和情境平行處理,以及多模態 (圖片和影片) 和嵌入輸入。支援的推測解碼方法包括多詞元預測 (MTP)、EAGLE-3、DFlash、DSpark 和 N-gram 比對。支援的量化格式包括 8 位元 (FP8) KV 快取,以及 8 位元 (FP8) 和 4 位元 (MXFP4 和 NVFP4) 浮點模型檢查點。
- 雙層前置字元快取、工具呼叫和結構化輸出:自動前置字元快取會將有效前置字元保留在 HBM 中,並將舊前置字元卸載至主機記憶體,避免在多輪要求中重新計算。這項快取功能支援混合注意力機制和遞迴模型,並內建工具呼叫和結構化輸出功能。
- 使用 TPU Sync 重疊 KV 快取傳輸:支援分散式預先填充和解碼服務 (將提示詞處理和詞元生成作業,分散到不同的 worker 集區),並使用 TPU Sync 卸載主機和主機 KV。TPU Sync 是開放原始碼 C++ 程式庫,可直接在背景執行緒讀取 PyTorch 裝置緩衝區,不需透過主機 CPU 記憶體複製資料。
如要進一步瞭解 vLLM-TorchTPU,請參閱 vLLM-TorchTPU 存放區和 TPU7x 的 vLLM-TorchTPU 方案、在 vLLM Slack 頻道中提問,或在 vLLM-TorchTPU Issue Tracker 中回報問題。
如要進一步瞭解 SGLang-TorchTPU,請參閱 SGLang-TorchTPU 存放區,或在 SGLang-TorchTPU Issue Tracker 回報問題。
llm-d:Kubernetes 原生分散式推論
llm-d 是開放原始碼的雲端原生運算基金會 (CNCF) 沙箱框架,可在 Kubernetes 上執行分散式 LLM 推論。這項專案由 Red Hat、IBM、 Google Cloud,以及超過 500 名貢獻者和 35 個組織組成的社群共同開發。
動機
雖然單一執行個體推論引擎會管理每個副本的執行作業,但正式環境機群必須處理流量高峰、多租戶優先順序、機群範圍的脈絡共用,以及零停機時間推出作業。llm-d 提供叢集層級的轉送和作業層,可協調推論伺服器機群。
設計
llm-d 會在 Kubernetes 上的模型伺服器 (例如 vLLM 和 SGLang) 前端執行,並提供下列功能:
- 根據前置字元快取狀態和副本負載轉送要求。
- 協調預先填入和解碼工作站集區。
- 支援混合專家 (MoE) 分區和非同步批次推論。
- 管理裝置記憶體、主機記憶體和儲存空間之間的分層 KV 快取卸載。
主要優點
- 多輪工作階段轉送:將多輪對話轉送至保留快取脈絡的副本。輪流優先排程和有狀態的 Responses API 支援,可讓代理重複使用各輪對話的背景資訊,減少重新運算。
- 多租戶服務品質:優先順序和公平流量控制功能,可讓對延遲敏感的要求和突發代理工作負載共用機群,不會發生資源匱乏的情況。
- 機群作業和滾動式更新:提供 v1 設定 API、路由器高可用性,以及協調式滾動式更新,將預先填入和解碼副本視為單一邏輯單元管理。
- 在 Google Kubernetes Engine (GKE) 上原生提供 TorchTPU:您可以在一個 llm-d 端點後方,與其他加速器一起提供 Cloud TPU,並使用標準 Kubernetes 工具管理 vLLM-TorchTPU 和 SGLang-TorchTPU 副本。
詳情請參閱「關於 GKE Inference Gateway」中的 llm-d 路由器,以及 llm-d GKE Gateway 指南。您也可以在 llm-d Slack 頻道提問,或透過 llm-d Issue Tracker 回報問題。
訓練、微調和領域程式庫
TorchTPU 提供參考訓練方法和特定領域程式庫,並針對 TPU 硬體進行調整,可預先訓練、微調及調整大型模型。
在 TPU 上使用 TorchTitan:大規模訓練參考資料
TPU 上的 TorchTitan 擴充了 TorchTitan,這是 PyTorch 模組化參考平台,用於生成式 AI 訓練,具備 TPU 分區傳遞、自訂核心和訓練配方。
詳情請參閱網誌文章「Integrating TorchTPU into TorchTitan and Optimizing Models for TPU」(將 TorchTPU 整合至 TorchTitan 並針對 TPU 最佳化模型)。
動機
如要跨多主機 TPU 切片擴充訓練,必須在晶片互連網路中分割參數,並重疊通訊與運算。Google 和 Meta 共同開發了 TorchTitan 內部的 TPU 分區和編譯階段,因此您不必設計自訂 TPU 分區策略,也不必手動排定通訊。
設計
您可以使用單一裝置 PyTorch 編寫模型,不需使用加速器專屬程式碼。TorchTitan 會根據設定檔設定模型層,因此您可以使用自訂 Pallas 核心 (例如 Splash Attention) 取代個別層,而不必編輯模型定義或訓練迴圈。
TorchTitan 的 SimpleFSDP 實作會將參數 sharding 作業直接放在編譯圖中,讓 XLA 編譯器能將裝置通訊與運算重疊。此外,全步驟圖表編譯會將整個訓練步驟擷取為單一 XLA 程式。如果是 Multislice 執行作業,混合式資料分割 (HSDP) 會透過晶片間互連 (ICI) 在每個配量內分割資料,並透過資料中心網路 (DCN) 跨配量複製資料。這種配置會將跨切片流量限制為每個步驟減少一次梯度。
主要優點
- 預先訓練和強化學習後訓練配方:包含稠密 LLM (Llama 3、Qwen 3 和 MuseGlimmer 30B)、MoE 模型 (Qwen 3 235B,已在多達 8,192 個 TPU7x 晶片上驗證) 和擴散轉換器 (FLUX.1) 的參考配方。對於強化學習後訓練 (例如群組相對政策最佳化,或 GRPO),VeRL (預先發布版) 會將參數更新委派給 TorchTitan。接著將更新後的權重推送至服務引擎,生成訓練軌跡 (推出)。
- 預先設定的編譯器和平行處理設定:配方設定包含預先設定的編譯器和平行處理設定,因此您可以透過設定檔調整模型 FLOP 使用率 (MFU),不必變更程式碼。
- 新架構的新手上路:Hugging Face Transformers 模型後端會透過 TorchTitan 訓練器,執行 Hugging Face Hub 模型檢查點 (包括不含專家平行處理的 MoE 模型)。針對完整模型移植,TorchTitan 提供逐步入門技能,協助工程師和程式設計代理。
- 獨立元件重複使用:您可以端對端採用 TorchTitan,或將個別模組、自訂運算子和編譯器旗標匯入現有的訓練程式碼集。
如要瞭解詳情,請參閱 TorchTitan on TPU 入門指南和 TorchTitan Qwen3-8B training recipe for TPU7x。您也可以在 TorchTitan 討論論壇中提問,或在 TorchTitan Issue Tracker 回報問題。
TorchRec:推薦系統
TorchRec 是 PyTorch 領域程式庫,提供分散式嵌入表格和建議模型的分區原始物件。在 Cloud TPU 上,TorchRec 會將稀疏嵌入表格查詢作業卸載至專屬的 TPU SparseCore 處理器,同時在 TPU TensorCore 上執行密集矩陣運算。
如要進一步瞭解 TorchRec,請參閱 TorchRec 說明文件、在 PyTorch on TPU 討論論壇中提問,或在 TorchRec Issue Tracker 中回報問題。
叢集自動化調度管理和開發人員工具
為擴充多節點管道並自動化模型上線流程,TorchTPU 生態系統與 Ray 整合,並提供可存取 TPU 說明文件的程式碼代理擴充功能。
Ray:分散式訓練、提供和強化學習
Ray 使用 Ray Train、Ray Serve、Ray Data、Ray Core 和 VeRL (預先發布版) 等強化學習框架,在叢集間擴充 Python 和 AI 工作負載。詳情請參閱網誌文章「Announcing Ray support for PyTorch on Google TPUs」(宣布 Google TPU 上的 PyTorch 支援 Ray)。
動機
多配量訓練和多級式管道 (例如結合資料預先處理、訓練和推出生成的 RL 工作流程) 需要自動化切片佈建、拓撲探索和容錯 worker 協調。torchrun 等獨立啟動公用程式不會佈建 TPU 切片,也不會協調多階段 actor 管道,因此 Ray 會管理 TorchTPU 工作負載的叢集範圍排程和配置。
設計
提交工作時,如果指定 TPU 世代、拓撲和 worker 數量,Ray 的 SlicePlacementGroup API 會保留完整的 TPU slice,因此 slice 中的所有 worker 會透過晶片間互連網路 (ICI) 共同排程。Ray 會為每個 worker (TPU_VISIBLE_CHIPS) 隔離一個邏輯 TPU 裝置,並設定 TorchTPU 的 slice-builder 位址和網狀拓撲。在 Ray Train 中,使用 TorchTrainer 在 ScalingConfig 中設定 use_tpu=True,會自動在 worker 之間初始化 tpu 裝置和 tpu_dist 程序群組。
主要優點
- 拓撲比對群組排程:
SlicePlacementGroup和TorchTrainer會比對各主機的 worker 放置位置與實體 TPU 世代和切片版面配置,防止資源分散。 - 自動復原故障:在 GKE 的 TPU slice 執行分散式 DDP、FSDP2 和 DTensor 訓練工作,並在 worker 或 slice 故障時自動復原。
- 直接預先擷取資料至 TPU:Ray Data 的
iter_torch_batches方法會將批次資料預先擷取為 PyTorch 張量,直接載入 TPU 裝置記憶體。 - 多主機推論自動化調度管理:Ray Serve LLM (
LLMConfig) 會為每個副本保留SlicePlacementGroup,並在單主機和多主機 TPU 配量中,部署與 OpenAI 相容的 vLLM-TorchTPU 端點。
如要開始使用 GKE,請參閱「關於 Ray on GKE」,以及「使用 Ray 和 TorchTPU 在多主機 TPU 上微調模型」和「使用 Ray 和 TorchTPU 在多主機 TPU 上提供 LLM」教學課程。
TPU agent suite:TPU 程式設計代理 (預先發布版)
TPU agent suite 是程式開發輔助 (包括 Claude Code 和 Google Antigravity) 的開放原始碼擴充功能,專門用於 TPU v6e 和 TPU7x 上的 Transformer 推論 (密集 LLM 和 MoE 模型)。
如要瞭解詳情,請觀看開放原始碼 TPU agent suite 總覽:
動機
一般用途的程式開發輔助通常缺乏 TPU 硬體拓撲、XLA 編譯器旗標、XProf 遙測和 Pallas 核心限制的最新背景資訊。TPU agent suite 可讓 AI 助理存取官方 TPU 說明文件和結構化工作流程。這有助於避免無效的標記建議,並自動執行疊代剖析和基準測試。
設計
這套工具會在現有的程式開發輔助中,加入 TPU 知識庫和四個特定任務子代理。路由器代理 (tpu-agent) 會將每個提示委派給適當的子代理,不會自行執行指令。在 TPU VM 或 GKE 叢集上執行任何指令,都必須經過您的核准,且調整迴圈會執行有限次數的記錄嘗試,然後傳回結果。
主要優點
- 模型導入和準確度驗證:
tpu-model-onboarding代理會解決不支援的運算子,並選取提供路徑 (vLLM-TorchTPU 或標準 PyTorch)。此外,也會逐層比較輸出內容與 CPU 參考模型,驗證數值準確度。 - 當機和瓶頸診斷:
tpu-diagnostics代理會分析當機記錄、檢查 XProf 設定檔和 XLA 編譯器追蹤記錄,並找出執行階段瓶頸。 - 自訂 Pallas 核心開發:
tpu-kernel-development代理可在有限的疊代預算內,協助編寫及自動調整自訂 Pallas TPU 核心。 - 查詢文件並附上引用來源:
tpu-knowledge-base代理會回答技術問題,並明確引用官方 TPU 文件和教學課程,也會說明未涵蓋的主題。
如要瞭解詳情,請參閱 TPU agent suite 說明文件、在 TPU agent suite GitHub 討論區分享意見回饋和提問,或在 TPU agent suite Issue Tracker 回報問題。
後續步驟
- 開始使用 TorchTPU 說明文件。
- 試用 TorchTitan on TPU 方案。
- 使用 vLLM-TorchTPU 和 SGLang-TorchTPU 部署推論工作負載。
- 在 PyTorch on TPU 討論論壇中提問。
- 如要與 Google 產品和工程團隊討論特定用途,請傳送電子郵件至 torchtpu-feedback@google.com。