


PyTorch ב-Cloud TPU
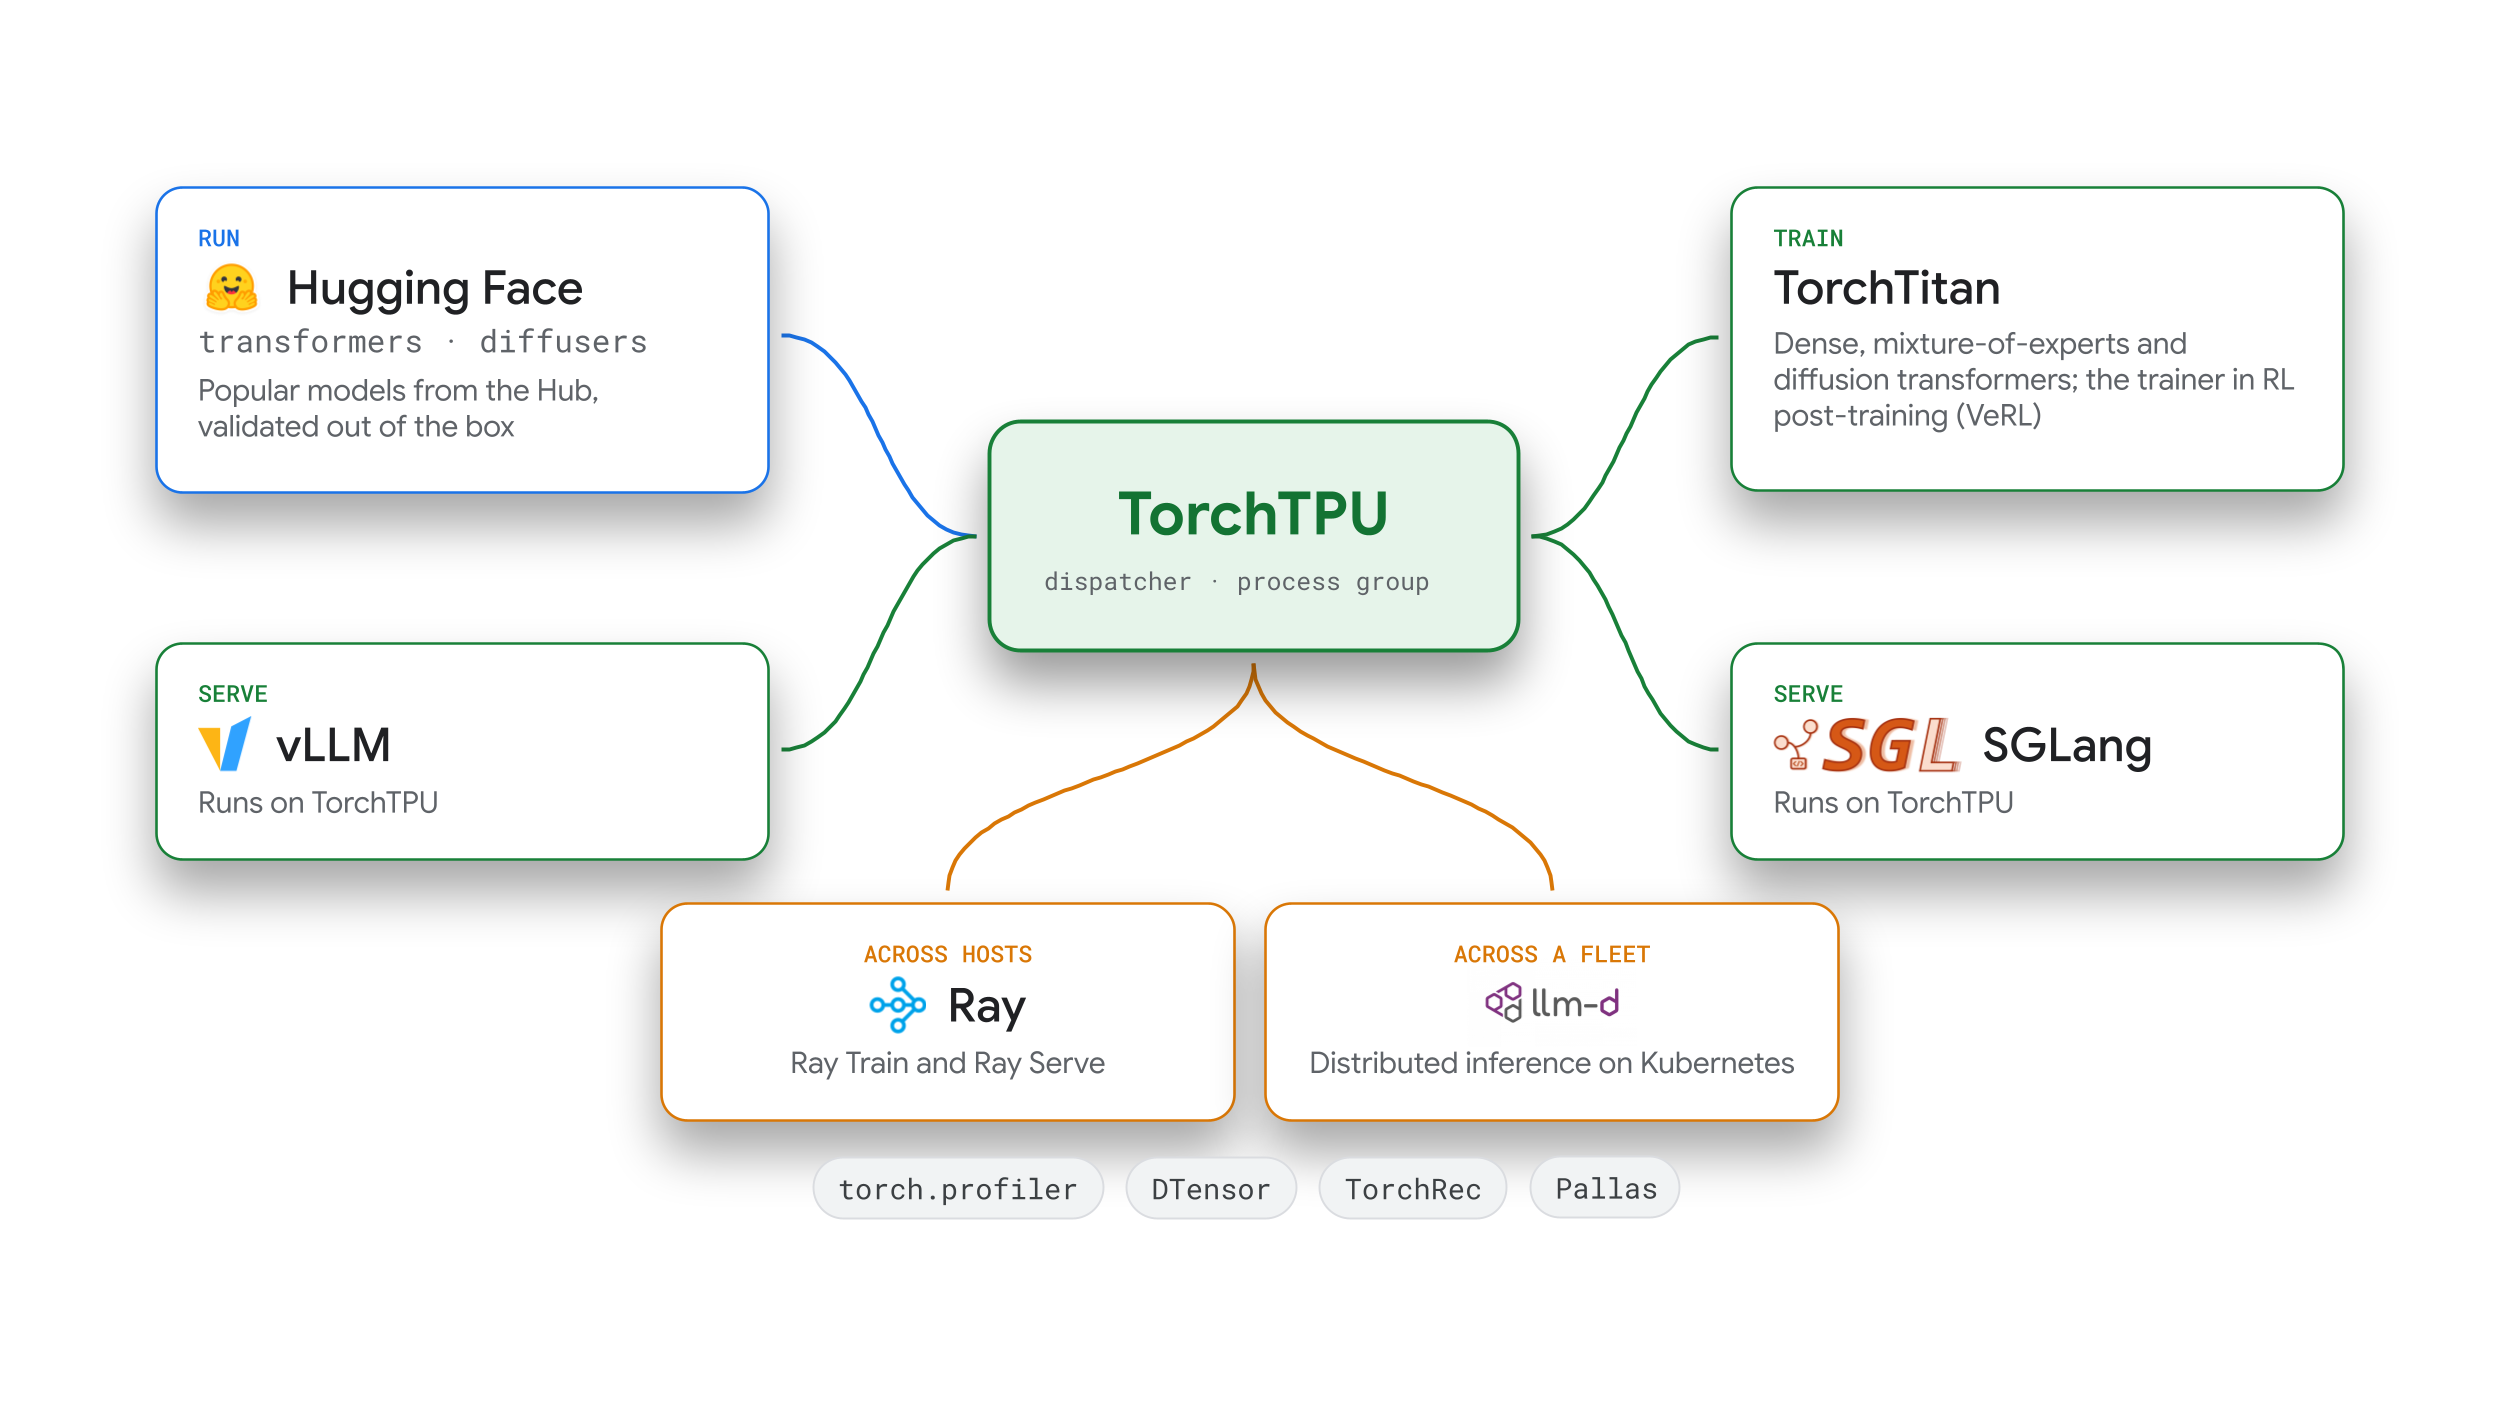
באמצעות PyTorch ב-Cloud TPU, אתם יכולים לאמן, לכוונן ולהגיש מודלים פתוחים בחומרה של Cloud TPU באמצעות סמנטיקה סטנדרטית של PyTorch וממשקי API מבוזרים. הוא משתלב עם הכלים בסביבה שכבר משתמשים בהם, כולל Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec ו-Ray.
בבסיס של ה-stack נמצא TorchTPU, קצה עורפי בקוד פתוח שמותאם ל-PyTorch, שפותח בשיתוף עם צוות PyTorch ב-Meta. ב-TorchTPU יש ספריות, מסגרות וכלים לכל שלב במחזור החיים של למידת המכונה, החל מהרצה של זמן ריצה וקרנלים בהתאמה אישית ועד להסקת מסקנות בסביבת הייצור, אימון בקנה מידה גדול ותזמור אשכולות.
קדימה, מתחילים
- הרצת מודלים של PyTorch ב-TPU: מתחילים עם TorchTPU והמסמכים של TorchTPU.
- הצגת מודלים גדולים של שפה (LLM) ומודלים מולטי-מודאליים: משתמשים ב-vLLM-TorchTPU או ב-SGLang-TorchTPU.
- ניתוב בקשות בצי של Kubernetes: משתמשים ב-llm-d.
- אימון מראש או כוונון של מודלים בסיסיים: משתמשים ב-TorchTitan ב-TPU (או ב-TorchRec למודלים של המלצות).
- הרחבת עיבוד הנתונים, האימון, למידת חיזוק (RL) וצינורות עיבוד הנתונים להצגת מודעות: באמצעות Ray.
- הכשרת עובדים חדשים, יצירת פרופילים וכוונון מודלים בעזרת עוזר התכנות: משתמשים ב-TPU agent suite (גרסת טרום-השקה).
TorchTPU: קצה עורפי מקורי של PyTorch ל-Cloud TPU
TorchTPU מספק את הקצה העורפי של המכשיר, שילוב של מהדר גרפים וממשקי API של ליבה בהתאמה אישית ל-PyTorch ב-Cloud TPU. TorchTPU, שפותח בשיתוף עם צוות PyTorch, מאפשר לנפות באגים במודלים באופן אינטראקטיבי במצב eager, לקמפל קוד של מודלים באמצעות torch.compile ולשנות את קנה המידה בפרוסות באמצעות torch.distributed (tpu_dist).
כדי להתקין את TorchTPU, מריצים את הפקודה הבאה:
pip install torch_tpu
כדי להריץ פעולת טנזור ב-Cloud TPU, מריצים את קוד ה-Python הבא:
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
בסרטון הבא יש סקירה כללית קצרה על TorchTPU:
מידע נוסף זמין במאמר TorchTPU is now open source: Run native PyTorch on TPUs ובמאמר How TorchTPU works.
למה בחרנו לעשות זאת?
בעבר, יחידות Cloud TPU הותאמו ל-JAX ול-TensorFlow, אבל כדי להריץ את PyTorch ב-TPU נדרש רישום גרפים של lazy-tensor (PyTorch/XLA), מה שלרוב הצריך הוספת קוד לסימון אזורים שניתנים להידור. כברירת מחדל, TorchTPU מריץ פעולות באופן מיידי באמצעות מודל ההרצה הרגיל של PyTorch, שבו כל מכשיר מריץ תהליך אחד. לכן, עומסי עבודה וספריות קיימים פועלים בלי שצריך לשכתב את המבנה שלהם.
עיצוב
TorchTPU מספק תמיכה מובנית ב-TPU ל-PyTorch, עם שלוש מטרות עיצוב:
- סמנטיקה רגילה של PyTorch: מריצה תהליך אחד לכל מכשיר ושומרת על תצוגות טנזור של PyTorch ומוטציות במקום, בלי תלות בזמן ריצה של JAX.
- הרצה מיידית כברירת מחדל: מריצה מודלים רגילים של PyTorch באופן מיידי במצב הרצה מיידית, כדי לאפשר ניפוי באגים אינטראקטיבי ובדיקה שלב אחר שלב.
- אופטימיזציות של קומפיילר וליבה: מספק מיזוג אופרטורים במצב eager (בנוסף להרצה של eager אופרטור אחר אופרטור), שילוב של
torch.compileעם גבולות צורה דינמיים כדי לצמצם את הקימפולים מחדש, וממשקי API של ליבה בהתאמה אישית.
כדי לקמפל את התרשים, torch.compile מתעד את תרשים החישוב של PyTorch באמצעות TorchDynamo ומקמפל אותו לשפת מכונה של TPU באמצעות OpenXLA ו-StableHLO. פעולות קולקטיביות פועלות ברמת קבוצת התהליכים של torch.distributed (tpu_dist).
נקודות החוזק העיקריות
- תמיכה באופרטורים, במודלים וב-Hugging Face: TorchTPU תומך באופרטורים סטנדרטיים של PyTorch (ATen) במעברים קדימה ואחורה, ונבדק באופן קבוע מול מודלים פופולריים של Hugging Face. אתם יכולים לפרוס מודלים ב-Transformers v5 על ידי העברת
device_map="tpu", להריץ צינורות עיבוד נתונים של Diffusers במצב eager, torch.compile, ו-tensor parallelism, ולנתח עומסי עבודה באמצעותtorch.profilerב-TensorBoard וב-XProf. - שינוי קנה מידה משבב יחיד לריבוי-פרוסות (Multislice): הקצה העורפי של
tpu_distתומך ב-DistributedDataParallel(DDP), ב-FullyShardedDataParallel(FSDP2) וב-DTensor. בנוסף,torch.tpu.distributed.topology_aware_meshממפה את ממדי ההקבלה לחיבורים הפיזיים של ה-TPU. - מצבי ביצוע מיידיים שניתנים להגדרה: מספק שלושה מצבי ביצוע מיידיים:
-
Strict(ברירת המחדל): שולח אופרטורים בנפרד ובאופן אסינכרוני, עם סמנטיקה אימפרטיבית רגילה של PyTorch. -
Debug: פועל באופן סינכרוני עם בדיקת גבולות של טנזור. -
DeferAndFuse: ממזג רצפים של אופרטורים מיידיים כדי להפחית את התנועה בזיכרון ברוחב פס גבוה (HBM).
-
- קומפילציה ושמירה במטמון של גרפים מלאים:
torch.compile(backend="tpu")מקמפל גרפים לקובצי הפעלה של TPU ושומר אותם במטמון בתהליכים, במארחים ובהפעלות מחדש של משימות. - קרנלים מותאמים אישית של TPU: אתם יכולים להפעיל קרנלים מותאמים אישית של Pallas, כולל קרנלים שמתקשרים ישירות בין שבבים, כפונקציות PyTorch רגילות. אתם יכולים גם להשתמש בקרנלים מוכנים מראש מהספרייה Tokamax, או לכתוב קרנלים ניידים מבוססי-משבצות באמצעות Helion.
למידע נוסף, אפשר לעיין במסמכי התיעוד של TorchTPU, לשאול שאלות בפורום הדיון של PyTorch ב-TPU או לדווח על בעיות בIssue Tracker של TorchTPU.
הסקה והצגה בסביבת ייצור
לפריסה בסביבת ייצור, PyTorch ב-Cloud TPU משתלב עם מנועי הסקה בקוד פתוח ועם תשתית להצגת מודלים מבוזרים ב-Kubernetes.
vLLM-TorchTPU ו-SGLang-TorchTPU: מנועי הסקה
vLLM-TorchTPU ו-SGLang-TorchTPU הם קצוות עורפיים של TorchTPU למנועי ההסקה vLLM ו-SGLang. שני ה-backends מריצים מודלים פתוחים כמו Qwen, DeepSeek, GLM, Kimi, GPT-OSS ו-Gemma 4.
מידע נוסף זמין במאמרי העזרה של vLLM-TorchTPU ובמאמר הכרזה על מנועי הסקה חדשים של vLLM ו-SGLang ב-TPU.
למה בחרנו לעשות זאת?
כדי להפעיל עומסי עבודה של הסקת מסקנות, מולטי-מודאליות ושימוש בכלים, בדרך כלל צריך הגדרות מודל מותאמות אישית, שיטות פענוח ספקולטיביות וסכימות קוונטיזציה. כשמפתחים את הקצה העורפי של vLLM ו-SGLang ב-TorchTPU, אפשר להתאים אישית את סטאק ההצגה ולנפות בו באגים ישירות ב-PyTorch.
עיצוב
שני ה-backends שומרים על מתזמנים סטנדרטיים של vLLM ו-SGLang, מנהלי מטמון של מפתח/ערך (KV) ושרתי API, תוך שימוש בהפעלה של TorchTPU ובאופרטורים מותאמים אישית של Pallas. רוב המודלים מריצים את הגדרות המודל הרגילות של PyTorch, ואילו בלוקים שדורשים הרבה משאבי מחשוב מפעילים קרנלים של Pallas בתוך התרשים המקומפל, כדי שיהיה אפשר לעדכן קרנלים ספציפיים לחומרה באופן עצמאי.
נקודות החוזק העיקריות
- מקביליות, קוונטיזציה ופענוח ספקולטיבי: תמיכה במקביליות של טנזורים, נתונים, מומחים, צינורות עיבוד נתונים והקשרים בין מארחים, וגם בקלט מולטי-מודאלי (תמונות וסרטונים) והטמעות. שיטות הפענוח הספקולטיבי הנתמכות כוללות חיזוי של כמה אסימונים (MTP), EAGLE-3, DFlash, DSpark והתאמת n-gram. פורמטים נתמכים של קוונטיזציה כוללים מטמונים של KV ב-8 ביט (FP8) ונקודות ביקורת של מודלים עם נקודה צפה (floating-point) ב-8 ביט (FP8) וב-4 ביט (MXFP4 ו-NVFP4).
- שמירה במטמון של קידומות בשתי רמות, קריאה לפונקציות ופלט מובנה: שמירה אוטומטית במטמון של קידומות שומרת קידומות פעילות ב-HBM ומעבירה קידומות ישנות יותר לזיכרון המארח כדי למנוע חישוב מחדש בבקשות עם כמה שלבים. השמירה במטמון תומכת במודלים של קשב היברידי וברשתות נוירונים חוזרות (RNN), והיא כוללת קריאה לפונקציות ופלט מובנה.
- העברות חופפות של מטמון KV באמצעות TPU Sync: תמיכה בהפרדה של מילוי מראש ופענוח (הפרדת עיבוד ההנחיות ויצירת הטוקנים למאגרי עובדים נפרדים) בין מארחים, והעברת KV למארח באמצעות TPU Sync. TPU Sync היא ספריית C++ בקוד פתוח שקוראת מאגרי נתונים זמניים של מכשירי PyTorch ישירות בשרשורים ברקע, בלי להעתיק נתונים דרך זיכרון המארח של המעבד (CPU).
מידע נוסף על vLLM-TorchTPU זמין במאגר vLLM-TorchTPU ובמתכונים של vLLM-TorchTPU ל-TPU7x. אתם יכולים גם לשאול שאלות בערוץ Slack של vLLM או לדווח על בעיות בIssue Tracker של vLLM-TorchTPU.
מידע נוסף על SGLang-TorchTPU זמין במאגר SGLang-TorchTPU. אפשר גם לדווח על בעיות בIssue Tracker של SGLang-TorchTPU.
llm-d: הסקת מסקנות מבוזרת ב-Kubernetes
llm-d הוא מסגרת ארגז חול (sandbox) בקוד פתוח של Cloud Native Computing Foundation (CNCF) להסקת מסקנות מבוזרת של LLM ב-Kubernetes. הוא פותח בשיתוף עם Red Hat, IBM, Google Cloudוקהילה של יותר מ-500 תורמים ו-35 ארגונים.
למה בחרנו לעשות זאת?
למרות שמנועי הסקה של מכונה אחת מנהלים את הביצוע לכל רפליקה, פליטים של ייצור צריכים לטפל בעליות חדות בתנועה, בעדיפויות של ריבוי דיירים, בשיתוף הקשר ברמת הפליט ובהשקות ללא זמן השבתה. llm-d מספק את שכבת הניתוב והפעולות ברמת האשכול כדי לתאם פליט של שרתי הסקה.
עיצוב
llm-d פועל לפני שרתי מודלים כמו vLLM ו-SGLang ב-Kubernetes, ומספק את הדברים הבאים:
- מנתב בקשות על סמך מצב המטמון של הקידומת והעומס על הרפליקה.
- מתאם בין מאגרי עובדים מפורקים למילוי מראש ולפענוח.
- תומך בפיצול נתונים (sharding) של שילוב מומחים (MoE) ובהסקת אצווה אסינכרונית.
- מנהל את ההעברה של מטמון KV בשכבות בין זיכרון המכשיר, זיכרון המארח והאחסון.
נקודות החוזק העיקריות
- ניתוב סשנים בכמה שלבים: ניתוב שיחות בכמה שלבים לרפליקות שמכילות את ההקשר שלהן במטמון. תזמון לפי סדר עדיפויות של תורות ותמיכה ב-Stateful Responses API מאפשרים לסוכנים להשתמש בהקשר בתורות שונות כדי לצמצם את החישוב מחדש.
- איכות השירות בסביבה מרובת דיירים: בקרת זרימה לפי עדיפות והוגנות מאפשרת לבקשות שרגישות לזמן אחזור ולעומסי עבודה מתפרצים של סוכנים לחלוק צי בלי להרעיב את המשאבים.
- פעולות בצי ועדכונים בהדרגה (rolling): מספק ממשק API להגדרות בגרסה 1, זמינות גבוהה של הנתב ועדכונים מתואמים בהדרגה שמנהלים את הרפליקות של המילוי מראש והפענוח כיחידה לוגית אחת.
- הצגה מקורית של TorchTPU ב-Google Kubernetes Engine (GKE): אתם יכולים להציג Cloud TPUs לצד מאיצים אחרים מאחורי נקודת קצה אחת של llm-d, ולנהל רפליקות של vLLM-TorchTPU ו-SGLang-TorchTPU באמצעות כלי Kubernetes רגילים.
מידע נוסף זמין במאמר נתב llm-d במאמר "מידע על GKE Inference Gateway" ובמדריך GKE Gateway של llm-d. אפשר גם לשאול שאלות בערוץ Slack של llm-d או לדווח על בעיות בIssue Tracker של llm-d.
ספריות לאימון, לכוונון עדין ולדומיינים
כדי לאמן מראש, לכוונן ולהתאים מודלים גדולים, TorchTPU מספק מתכוני אימון לדוגמה וספריות ספציפיות לדומיין שמותאמות לחומרת TPU.
TorchTitan ב-TPU: חומר עזר לאימון בקנה מידה גדול
TorchTitan ב-TPU מרחיב את TorchTitan, פלטפורמת העזר המודולרית של PyTorch לאימון AI גנרטיבי, עם מעברי פיצול נתונים (sharding) ב-TPU, ליבות בהתאמה אישית ומתכוני אימון.
מידע נוסף זמין במאמר שילוב של TorchTPU ב-TorchTitan ואופטימיזציה של מודלים ל-TPU.
למה בחרנו לעשות זאת?
כדי להרחיב את האימון על פני פרוסות TPU עם כמה מארחים, צריך לפצל את הפרמטרים על פני החיבורים בין השבבים ולחפוף בין התקשורת לבין החישוב. Google ומטא פיתחו במשותף את שלבי הפיצול וההידור של TPU ב-TorchTitan, כך שאתם לא צריכים לתכנן אסטרטגיות פיצול TPU בהתאמה אישית או לתזמן תקשורת באופן ידני.
עיצוב
אתם כותבים מודלים ב-PyTorch במכשיר יחיד בלי קוד ספציפי למאיץ. TorchTitan מגדיר שכבות של מודלים מקובצי תצורה, ומאפשר להחליף שכבות ספציפיות בקרנלים מותאמים אישית של Pallas (כמו Splash Attention) בלי לערוך את הגדרת המודל או את לולאת האימון.
בהטמעה של SimpleFSDP ב-TorchTitan, פעולות חלוקת הפרמטרים לחלקים מתבצעות ישירות בתוך התרשים שעבר הידור, כדי שהמהדר של XLA יוכל לחפוף בין התקשורת של המכשיר לבין החישוב. בנוסף, הידור גרף של שלב שלם מתעד את כל שלב האימון כתוכנית XLA אחת. בהרצות של ריבוי-פרוסות, חלוקה היברידית ל-shards (HSDP) מחלקת ל-shards בתוך כל פרוסה דרך החיבור בין השבבים (ICI), ומשכפלת בין הפרוסות דרך הרשת של מרכז הנתונים (DCN). הפריסה הזו מגבילה את התנועה בין הפרוסות להפחתת גרדיאנט אחת לכל שלב.
נקודות החוזק העיקריות
- מתכונים לאימון מוקדם ולפוסט-אימון של RL: כולל מתכוני עזר למודלים צפופים של LLM (Llama 3, Qwen 3 ו-MuseGlimmer 30B), מודלים של MoE (Qwen 3 235B, מאומתים על עד 8,192 שבבי TPU7x) וטרנספורמרים של דיפוזיה (FLUX.1). ל-RL אחרי אימון (כמו אופטימיזציה של מדיניות יחסית לקבוצה, או GRPO), VeRL (גרסת טרום-השקה (Preview)) מעביר עדכוני פרמטרים ל-TorchTitan. לאחר מכן, הוא מעביר את המשקלים המעודכנים למנועי ההצגה כדי ליצור מסלולי אימון (השקות).
- הגדרות קומפיילר ומקביליות מוגדרות מראש: הגדרות המתכון כוללות הגדרות קומפיילר ומקביליות מוגדרות מראש, כדי שתוכלו לשנות את ניצול ה-FLOP של המודל (MFU) באמצעות קובצי תצורה במקום שינויים בקוד.
- הכשרת עובדים חדשים לארכיטקטורות חדשות: הקצה העורפי של המודלים של Hugging Face Transformers מריץ נקודות ביקורת של מודלים של Hugging Face Hub (כולל מודלים של MoE ללא מקביליות מומחים) דרך מאמן TorchTitan. לפורטים מלאים של מודלים, TorchTitan כולל מיומנות הדרכה שלב אחר שלב למהנדסים ולסוכני תכנות.
- שימוש חוזר ברכיבים עצמאיים: אתם יכולים להשתמש ב-TorchTitan מקצה לקצה או לייבא מודולים נפרדים, אופרטורים בהתאמה אישית ודגלי קומפיילר לבסיס קוד קיים של אימון.
מידע נוסף זמין במדריך לתחילת העבודה עם TorchTitan ב-TPU ובמתכון לאימון TorchTitan Qwen3-8B ל-TPU7x. אתם יכולים גם לשאול שאלות בפורום הדיון של TorchTitan או לדווח על בעיות בכלי למעקב אחר בעיות ב-TorchTitan.
TorchRec: מערכות המלצות
TorchRec היא ספריית דומיינים של PyTorch שמספקת טבלאות הטמעה מבוזרות ופרימיטיבים של פיצול למודלים של המלצות. ב-Cloud TPU, TorchRec מעביר את החיפושים בטבלאות הטמעות דלילות למעבדי TPU SparseCore ייעודיים, בזמן שהוא מריץ פעולות של מטריצות צפופות ב-TPU TensorCores.
למידע נוסף על TorchRec, קראו את המסמכים של TorchRec, שאלו שאלות בפורום הדיונים של PyTorch ב-TPU או דווחו על בעיות בIssue Tracker של TorchRec.
כלים למפתחים ולתזמור אשכולות
כדי להרחיב את צינורות עיבוד הנתונים עם כמה צמתים ולהפוך את תהליך ההצטרפות של המודל לאוטומטי, המערכת האקולוגית של TorchTPU משתלבת עם Ray ומספקת תוספים של סוכני תכנות עם גישה למסמכי התיעוד של TPU.
Ray: אימון מבוזר, הצגה ו-RL
Ray משמש להרחבת עומסי עבודה של Python ו-AI באשכולות באמצעות Ray Train, Ray Serve, Ray Data, Ray Core ומסגרות RL כמו VeRL (גרסת טרום-השקה). מידע נוסף זמין במאמר הכרזה על תמיכה של Ray ב-PyTorch ב-TPU של Google.
למה בחרנו לעשות זאת?
אימון של ריבוי-פרוסות ופייפליינים עם כמה שלבים (כמו תהליכי עבודה של RL שמשלבים עיבוד מראש של נתונים, אימון ויצירת פריסה) דורשים הקצאת פרוסות אוטומטית, גילוי טופולוגיה ותיאום בין workers עם עמידות בכשלים. כלי הפעלה עצמאיים כמו torchrun לא מקצים פרוסות TPU או מתאמים צינורות עיבוד נתונים של שחקנים בכמה שלבים, ולכן Ray מנהל את התזמון והמיקום של עומסי העבודה של TorchTPU בכל האשכול.
עיצוב
כששולחים משימה ומציינים את דור ה-TPU, הטופולוגיה ומספר ה-workers, ה-API של Ray, SlicePlacementGroup, שומר פרוסות TPU שלמות כדי שכל ה-workers בפרוסה יתוזמנו יחד כקבוצה דרך ה-inter-chip interconnect (ICI). Ray מבודד מכשיר TPU לוגי אחד לכל וורקר (TPU_VISIBLE_CHIPS) ומגדיר את הכתובות של ה-slice-builder ואת טופולוגיית ה-mesh של TorchTPU. ב-Ray Train, הגדרת use_tpu=True ב-ScalingConfig עם TorchTrainer מאתחלת את המכשיר tpu ואת קבוצת התהליכים tpu_dist באופן אוטומטי בכל ה-workers.
נקודות החוזק העיקריות
- תזמון קבוצתי שתואם לטופולוגיה:
SlicePlacementGroupו-TorchTrainerמתאימים את מיקום ה-worker במארחים לפריסת הפרוסות והדור הפיזי של ה-TPU, כדי למנוע פרגמנטציה של המשאבים. - שחזור אוטומטי אחרי כשל: הפעלה של משימות אימון מבוזרות של DDP, FSDP2 ו-DTensor בפרוסות TPU ב-GKE, עם שחזור אוטומטי במקרה של כשל ב-worker או בפרוסה.
- אחזור מראש של נתונים ישירות ל-TPU: השיטה
iter_torch_batchesשל Ray Data מאחזרת מראש אצוות כטנזורים של PyTorch ישירות לזיכרון של מכשיר ה-TPU. - תזמור של הסקת מסקנות בכמה מארחים: Ray Serve LLM (
LLMConfig) שומרSlicePlacementGroupלכל רפליקה ופורס נקודות קצה של vLLM-TorchTPU שתואמות ל-OpenAI בפרוסות TPU של מארח יחיד וכמה מארחים.
כדי להתחיל להשתמש ב-GKE, קראו את המאמר מידע על Ray ב-GKE ואת המדריכים כוונון עדין של מודלים במארחים מרובים של TPU באמצעות Ray ו-TorchTPU והצגת LLM במארחים מרובים של TPU באמצעות Ray ו-TorchTPU.
TPU agent suite: סוכני תכנות ל-TPU (גרסת טרום-השקה)
TPU agent suite הוא תוסף בקוד פתוח לעוזרי תכנות, כולל Claude Code ו-Google Antigravity, שמתמקד בהסקת טרנספורמרים (מודלים של LLM צפופים ו-MoE) ב-TPU v6e וב-TPU7x.
למידע נוסף, צפו בסקירה הכללית של חבילת הסוכנים בקוד פתוח של TPU:
למה בחרנו לעשות זאת?
לעוזרים לשימוש כללי לעזרה בתכנות בדרך כלל אין הקשר עדכני לגבי טופולוגיות של חומרת TPU, דגלים של מהדר XLA, טלמטריה של XProf ומגבלות של ליבת Pallas. חבילת הסוכנים של TPU נותנת לעוזר האישי גישה למסמכי התיעוד הרשמיים של TPU ולתהליכי עבודה מובְנים. כך אפשר למנוע הצעות לא תקינות לדגלים, ולהפוך את תהליכי הפרופיילינג וההשוואה לאוטומטיים.
עיצוב
החבילה מוסיפה מאגר ידע של TPU וארבעה סוכני משנה ספציפיים למשימות לעוזר הקיים לעזרה בתכנות. סוכן ניתוב (tpu-agent) מעביר כל הנחיה לסוכן המשנה המתאים בלי להריץ פקודות בעצמו. כל פקודה שמופעלת ב-TPU VM או באשכול GKE דורשת אישור שלכם, ולולאות הכוונון מפעילות מספר מוגבל של ניסיונות מתועדים לפני שהן מחזירות תוצאות.
נקודות החוזק העיקריות
- הכשרת מודלים ואימות הדיוק: הסוכן
tpu-model-onboardingפותר בעיות של אופרטורים לא נתמכים ובוחר נתיב להצגת מודעות (vLLM-TorchTPU או PyTorch רגיל). הוא גם משווה בין הפלטים של כל שכבה לבין מודל העזר של המעבד (CPU) כדי לאמת את הדיוק המספרי. - אבחון של קריסות וצווארי בקבוק: הסוכן של
tpu-diagnosticsמנתח יומני קריסה, בודק פרופילים של XProf ועקבות של מהדר XLA, ומבודד צווארי בקבוק בזמן הריצה. - פיתוח קרנל מותאם אישית של Pallas: הסוכן של
tpu-kernel-developmentעוזר לכתוב ולכוונן באופן אוטומטי קרנלים מותאמים אישית של Pallas TPU במסגרת תקציב איטרציה מוגבל. - חיפוש במסמכי תיעוד עם ציטוטים: הנציג של
tpu-knowledge-baseעונה על שאלות טכניות עם ציטוטים מפורשים ממדריכים וממסמכי תיעוד רשמיים של TPU, ומציין אם נושא מסוים לא נכלל.
מידע נוסף זמין במסמכי התיעוד של TPU agent suite. אתם יכולים גם לשתף משוב ולשאול שאלות בדיונים על TPU agent suite ב-GitHub, או לדווח על בעיות בIssue Tracker של TPU agent suite.
המאמרים הבאים
- למסמכי התיעוד של TorchTPU
- נסו את המתכונים של TorchTitan ב-TPU.
- פריסת עומסי עבודה של הסקת מסקנות באמצעות vLLM-TorchTPU ו-SGLang-TorchTPU.
- לשאול שאלות בפורום הדיונים של PyTorch ב-TPU.
- כדי לדון בתרחיש שימוש ספציפי עם צוות המוצר וההנדסה של Google, שלחו אימייל לכתובת torchtpu-feedback@google.com.