


Conforme descrito em Planos de execução de consulta, o compilador SQL transforma uma instrução SQL em um plano de execução de consulta, que é usado para receber os resultados da consulta. Nesta página, descrevemos as práticas recomendadas para criar instruções SQL que ajudam o Spanner a encontrar planos de execução eficientes. Consulte o guia [Ajuste de consulta][query_tuning] para receber ajuda para melhorar o desempenho da consulta.
As instruções SQL de exemplo mostradas nesta página usam o seguinte esquema de amostra:
GoogleSQL
CREATE TABLE Singers (
 SingerId   INT64 NOT NULL,
 FirstName  STRING(1024),
 LastName   STRING(1024),
 SingerInfo BYTES(MAX),
 BirthDate  DATE
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
 SingerId     INT64 NOT NULL,
 AlbumId      INT64 NOT NULL,
 AlbumTitle   STRING(MAX),
 ReleaseDate  DATE
) PRIMARY KEY (SingerId, AlbumId),
INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Para a referência completa do SQL, consulte Sintaxe de instrução, Funções e operadores e Estrutura léxica e sintaxe.
PostgreSQL
CREATE TABLE Singers (
 SingerId   BIGINT PRIMARY KEY,
 FirstName  VARCHAR(1024),
 LastName   VARCHAR(1024),
 SingerInfo BYTEA,
 BirthDate  TIMESTAMPTZ
);

CREATE TABLE Albums (
 SingerId        BIGINT NOT NULL,
 AlbumId         BIGINT NOT NULL,
 AlbumTitle      VARCHAR(1024),
 ReleaseDate     DATE,
 PRIMARY KEY(SingerId, AlbumId),
 FOREIGN KEY (SingerId) REFERENCES Singers(SingerId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Para mais informações, consulte A linguagem PostgreSQL no Spanner.
Usar parâmetros de consulta
O Spanner aceita parâmetros de consulta para aumentar o desempenho e ajudar a evitar a injeção de SQL quando as consultas são criadas usando a entrada do usuário. É possível usar os parâmetros de consulta como substitutos de expressões arbitrárias, mas não como substitutos de identificadores, nomes de colunas, nomes de tabelas ou outras partes da consulta.
Os parâmetros podem ser exibidos em qualquer lugar onde se espera um valor literal. O mesmo nome de parâmetro pode ser usado mais de uma vez em uma única instrução SQL.
Em resumo, os parâmetros de consulta oferecem suporte à execução de consultas das seguintes maneiras:
- Planos pré-otimizados: as consultas que usam parâmetros podem ser executadas mais rapidamente em cada invocação, porque a parametrização facilita o armazenamento em cache do plano de execução pelo Spanner.
- Composição de consulta simplificada: não é necessário usar escape em valores de string ao fornecê-los em parâmetros de consulta. Os parâmetros de consulta também reduzem o risco de erros de sintaxe.
- Segurança: os parâmetros de consulta tornam suas consultas mais seguras, protegendo você de vários ataques de injeção de SQL. Essa proteção é especialmente importante para consultas que você constrói com base na entrada do usuário.
Para melhorar o desempenho, o Spanner converte valores literais codificados em SQL em parâmetros se o plano de execução de consulta ideal não depender dos valores literais específicos. Isso permite que o Spanner reduza a latência e os custos de CPU armazenando em cache e reutilizando o plano de consulta. No entanto, isso não oferece as mesmas proteções contra injeção de SQL e benefícios de composição de consulta mais simples. Usar parâmetros de consulta no código do aplicativo é a prática recomendada.
Noções básicas sobre como o Spanner executa consultas
O Spanner permite consultar bancos de dados usando instruções SQL declarativas que especificam quais dados você quer recuperar. Para entender como o Spanner recebe os resultados, examine o plano de execução da consulta. Um plano de execução de consulta mostra o custo computacional associado a cada etapa da consulta. Com esses custos, é possível depurar problemas de desempenho de consulta e otimizar sua consulta. Para saber mais, consulte Planos de execução de consultas.
É possível recuperar planos de execução de consulta pelo console do Google Cloud ou pelas bibliotecas de cliente.
Para receber um plano de execução de consulta para uma consulta específica usando o console doGoogle Cloud , siga estas etapas:
Abra a página "Instâncias do Spanner".
Selecione os nomes da instância do Spanner e do banco de dados que você quer consultar.
Clique em Spanner Studio no painel de navegação à esquerda.
Digite a consulta no campo de texto e clique em Executar consulta.
Clique em Explicação
. O console do Google Cloud exibe um plano de execução visual para sua consulta.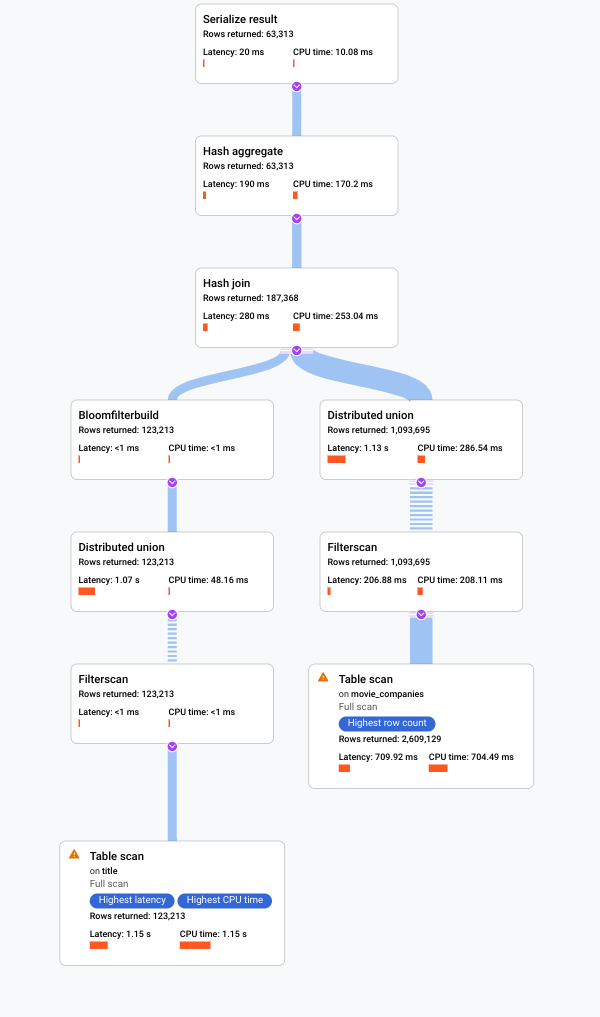
Para mais informações sobre como entender os planos visuais e usá-los para depurar suas consultas, consulte Ajustar uma consulta usando o visualizador de planos de consulta.
Também é possível ver amostras de planos de consulta históricos e comparar o desempenho de uma consulta ao longo do tempo para determinadas consultas. Para saber mais, consulte Planos de consulta amostrados.
Usar índices secundários
Como outros bancos de dados relacionais, o Spanner oferece índices secundários, que podem ser usados para recuperar dados usando uma instrução SQL ou a interface de leitura do Spanner. O uso de um índice secundário em uma consulta SQL permite especificar como você quer que o Spanner receba os resultados. A especificação de um índice secundário pode acelerar a execução da consulta.
Por exemplo, imagine que você queira buscar os IDs de todos os cantores com um sobrenome específico. Uma maneira de escrever uma consulta SQL é:
SELECT s.SingerId
FROM Singers AS s
WHERE s.LastName = 'Smith';
Essa consulta retornaria os resultados esperados, mas pode levar muito tempo para retornar os resultados. O tempo depende do número de linhas na tabela Singers e de quantas satisfazem o predicado WHERE s.LastName = 'Smith'.
Se não houver um índice secundário que contenha a coluna LastName para leitura,
o plano de consulta lerá toda a tabela Singers para encontrar linhas que correspondam ao
predicado. A leitura de toda a tabela é chamada de verificação completa da tabela. Uma verificação de tabela completa é uma maneira cara de conseguir os resultados quando a tabela contém apenas uma pequena porcentagem de Singers com esse sobrenome.
É possível melhorar o desempenho dessa consulta definindo um índice secundário na coluna de sobrenome:
CREATE INDEX SingersByLastName ON Singers (LastName);
Como o índice secundário SingersByLastName contém a coluna da tabela indexada
LastName e a coluna da chave primária SingerId, o Spanner
pode buscar todos os dados da tabela de índice, que é muito menor, em vez de verificar a
tabela Singers completa.
Nesse cenário, o Spanner usa automaticamente o índice secundário
SingersByLastName ao executar a consulta, desde que tenham se passado três dias
desde a criação do banco de dados. Consulte Uma observação sobre novos bancos de dados.
No entanto, é melhor informar explicitamente ao Spanner para usar esse índice
especificando uma diretiva de índice na cláusula FROM:
GoogleSQL
SELECT s.SingerId
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Se você estiver usando esquemas nomeados,
use a seguinte sintaxe para a cláusula FROM:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Agora, suponha que você também queria buscar o nome do cantor além do ID. Mesmo que a coluna FirstName não esteja contida no índice, especifique a diretiva de índice como antes:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId, s.FirstName
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Você ainda tem um benefício de desempenho ao usar o índice porque o Spanner não precisa fazer uma verificação completa da tabela ao executar o plano de consulta. Em vez disso, ele seleciona o subconjunto de linhas que satisfazem o predicado
do índice SingersByLastName e, em seguida, faz uma pesquisa na tabela base
Singers para buscar o nome apenas desse subconjunto de linhas.
Se você não quiser que o Spanner busque linhas da tabela base, armazene uma cópia da coluna FirstName no próprio índice:
GoogleSQL
CREATE INDEX SingersByLastName ON Singers (LastName) STORING (FirstName);
PostgreSQL
CREATE INDEX SingersByLastName ON Singers (LastName) INCLUDE (FirstName);
O uso de uma cláusula STORING (para o dialeto GoogleSQL) ou INCLUDE (para o dialeto PostgreSQL) como essa custa armazenamento extra, mas
oferece as seguintes vantagens:
- As consultas SQL que usam o índice e selecionam colunas armazenadas na cláusula
STORINGouINCLUDEnão exigem uma mesclagem extra com a tabela base. - As chamadas de leitura que usam o índice podem ler colunas armazenadas na cláusula
STORINGouINCLUDE.
Os exemplos anteriores ilustram como os índices secundários podem acelerar as consultas
quando as linhas escolhidas pela cláusula WHERE de uma consulta podem ser identificadas rapidamente
usando o índice secundário.
Outro cenário em que os índices secundários podem oferecer benefícios de desempenho é para determinadas consultas que retornam resultados ordenados. Por exemplo, suponha que você queira buscar todos os títulos de álbuns e as datas de lançamento em ordem crescente de data de lançamento e ordem decrescente de título do álbum. Você pode escrever uma consulta SQL da seguinte maneira:
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Sem um índice secundário, esta consulta requer uma etapa de classificação potencialmente cara no plano de execução. É possível agilizar a execução da consulta definindo esse índice secundário:
CREATE INDEX AlbumsByReleaseDateTitleDesc on Albums (ReleaseDate, AlbumTitle DESC);
Em seguida, reescreva a consulta para usar o índice secundário:
GoogleSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums@{FORCE_INDEX=AlbumsByReleaseDateTitleDesc} AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
PostgreSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums /*@ FORCE_INDEX=AlbumsByReleaseDateTitleDesc */ AS s
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Essa consulta e a definição de índice atendem aos dois critérios a seguir:
- Para remover a etapa de classificação, verifique se a lista de colunas na cláusula
ORDER BYé um prefixo da lista de chaves de índice. - Para evitar a junção da tabela base para buscar colunas ausentes, verifique se o índice abrange todas as colunas da tabela que a consulta usa.
Embora os índices secundários possam acelerar as consultas comuns, adicioná-los pode aumentar a latência das operações de commit, porque cada índice secundário normalmente requer o envolvimento de um nó extra em cada commit. Para a maioria das cargas de trabalho, ter alguns índices secundários é suficiente. No entanto, considere se você se preocupa mais com a latência de leitura ou de gravação e quais operações são mais críticas para sua carga de trabalho. Faça um comparativo de mercado da carga de trabalho para garantir que ela esteja funcionando conforme o esperado.
Para a referência completa de índices secundários, consulte Índices secundários.
Otimizar pesquisas de chave de intervalo
Um uso comum de uma consulta SQL é ler várias linhas do Spanner com base em uma lista de chaves conhecidas.
As práticas recomendadas a seguir ajudam a escrever consultas eficientes ao buscar dados por um intervalo de chaves:
Se a lista de chaves for esparsa e não adjacente, use parâmetros de consulta e
UNNESTpara construir a consulta.Por exemplo, se a lista de chaves for
{1, 5, 1000}, escreva a consulta assim:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST (@KeyList)
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST ($1)
Observações:
O operador UNNEST nivela uma matriz de entrada em linhas de elementos.
O parâmetro de consulta, que é
@KeyListpara o GoogleSQL e$1para o PostgreSQL, pode acelerar a consulta, conforme discutido na prática recomendada anterior.É melhor usar um UNNEST com um único parâmetro do que OR com vários parâmetros.
Se a lista de chaves for adjacente e estiver dentro de um intervalo, especifique os limites inferior e superior do intervalo de chaves na cláusula
WHERE.Por exemplo, se a lista de chaves for
{1,2,3,4,5}, construa a consulta da seguinte maneira:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN @min AND @max
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN $1 AND $2
Essa consulta só é mais eficiente se as chaves no intervalo forem adjacentes. Em outras palavras, se a lista de chaves for
{1, 5, 1000}, não especifique os limites inferior e superior como na consulta anterior, porque a consulta resultante verificaria todos os valores entre 1 e 1.000.
Otimizar mesclagens
As operações de mesclagem podem ser caras porque podem aumentar significativamente o número de linhas que a consulta precisa verificar, o que resulta em consultas mais lentas. Além das técnicas que você costuma usar em outros bancos de dados relacionais para otimizar consultas de mesclagem, veja algumas práticas recomendadas para uma JOIN mais eficiente ao usar o SQL do Spanner:
- Se possível, vincule dados em tabelas intercaladas por chave principal. Exemplo:
SELECT s.FirstName, a.ReleaseDate
FROM Singers AS s JOIN Albums AS a ON s.SingerId = a.SingerId;
The rows in the interleaved table `Albums` are physically
stored in the same splits as the parent row in `Singers`, as discussed in
[Schema and Data Model](/spanner/docs/schema-and-data-model). Therefore, joins can be
completed locally without sending lots of data across the network.
Use a diretiva de mesclagem se quiser forçar a ordem da mesclagem. Exemplo:
GoogleSQL
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
PostgreSQL
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
A diretiva de mesclagem
FORCE_JOIN_ORDERinstrui o Spanner a usar a ordem de mesclagem especificada na consulta (ou seja,Singers JOIN Albums, nãoAlbums JOIN Singers). Os resultados retornados são os mesmos, independentemente da ordem escolhida pelo Spanner. No entanto, talvez você queira usar essa diretiva de mesclagem se notar no plano de consulta que o Spanner alterou a ordem de mesclagem e causou consequências indesejáveis, como resultados intermediários maiores, ou perdeu oportunidades de buscar linhas.Use uma diretiva de vinculação para escolher uma implementação de junção. Quando você usa o SQL para consultar várias tabelas, o Spanner usa automaticamente um método de mesclagem que provavelmente tornará a consulta mais eficiente. No entanto, o Google recomenda que você teste diferentes algoritmos de mesclagem. Escolher o algoritmo de mesclagem certo pode melhorar a latência, o consumo de memória ou ambos. Esta consulta demonstra a sintaxe para usar uma diretiva JOIN com a dica
JOIN_METHODpara escolher umHASH JOIN:GoogleSQL
SELECT *
FROM Singers s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON a.SingerId = a.SingerId
PostgreSQL
SELECT *
FROM Singers s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON a.SingerId = a.SingerId
Se você estiver usando um
HASH JOINouAPPLY JOINe tiver uma cláusulaWHEREaltamente seletiva em um lado doJOIN, coloque a tabela que produz o menor número de linhas como a primeira tabela na cláusulaFROMda mesclagem. Essa estrutura ajuda porque, emHASH JOIN, o Spanner sempre escolhe a tabela do lado esquerdo como build e a tabela do lado direito como probe. Da mesma forma, paraAPPLY JOIN, o Spanner escolhe a tabela do lado esquerdo como externa e a tabela do lado direito como interna. Saiba mais sobre esses tipos de mesclagem: [mesclagem de hash][hash_join] e [mesclagem de aplicação][apply_join].Para consultas essenciais à carga de trabalho, especifique o método e a ordem de mesclagem com melhor desempenho nas instruções SQL para ter um desempenho mais consistente.
Otimizar consultas com pushdown de predicado de carimbo de data/hora
A aplicação de predicados de carimbo de data/hora é uma técnica de otimização de consultas usada no Spanner para melhorar a eficiência de consultas que usam carimbos de data/hora e dados com uma política de armazenamento em níveis baseada em idade. Quando você ativa essa otimização, as operações de filtragem nas colunas de carimbo de data/hora são realizadas o mais cedo possível no plano de execução da consulta. Isso pode reduzir significativamente a quantidade de dados processados e melhorar o desempenho geral da consulta.
Com o pushdown de predicado de carimbo de data/hora, o mecanismo de banco de dados analisa a consulta e identifica o filtro de carimbo de data/hora. Em seguida, ele "envia" esse filtro para a camada de armazenamento, de modo que apenas os dados relevantes com base nos critérios de carimbo de data/hora sejam lidos do SSD. Isso minimiza a quantidade de dados processados e transferidos, resultando em uma execução de consulta mais rápida.
Para otimizar as consultas de modo que elas acessem apenas os dados armazenados no SSD, é necessário que:
- A consulta precisa ter a aplicação de predicado de carimbo de data/hora ativada. Para mais informações, consulte Dicas de instrução do GoogleSQL e Dicas de instrução do PostgreSQL.
A consulta precisa usar uma restrição baseada em idade igual ou menor que a idade especificada na política de transbordamento dos dados (definida com a opção
ssd_to_hdd_spill_timespanna instrução DDLCREATE LOCALITY GROUPouALTER LOCALITY GROUP). Para mais informações, consulte as instruçõesLOCALITY GROUPdo GoogleSQL e as instruçõesLOCALITY GROUPdo PostgreSQL.A coluna que está sendo filtrada na consulta precisa ser uma coluna de carimbo de data/hora que contém o carimbo de data/hora de confirmação. Para detalhes sobre como criar uma coluna de carimbo de data/hora de confirmação, consulte Carimbos de data/hora de confirmação no GoogleSQL e Carimbos de data/hora de confirmação no PostgreSQL. Essas colunas precisam ser atualizadas junto com a coluna de carimbo de data/hora e residir no mesmo grupo de localidade, que tem uma política de armazenamento em camadas baseada em idade.
Se, para uma determinada linha, algumas das colunas consultadas estiverem no SSD e outras no HDD (devido à atualização de colunas em momentos diferentes e ao envelhecimento do HDD em momentos diferentes), o desempenho da consulta poderá ser pior ao usar a dica. Isso ocorre porque a consulta precisa preencher dados das diferentes camadas de armazenamento. Como resultado do uso da dica, o Spanner envelhece os dados no nível da célula individual (nível de granularidade de linha e coluna) com base no carimbo de data/hora de commit de cada célula, o que desacelera a consulta. Para evitar esse problema, atualize rotineiramente todas as colunas que estão sendo consultadas usando essa técnica de otimização na mesma transação para que todas as colunas compartilhem o mesmo carimbo de data/hora de confirmação e se beneficiem da otimização.
Para ativar o pushdown de predicado de carimbo de data/hora no nível da instrução, use uma dica de instrução na consulta. Exemplo:
GoogleSQL
@{allow_timestamp_predicate_pushdown=TRUE}
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 12 HOUR);
PostgreSQL
/*@allow_timestamp_predicate_pushdown=TRUE*/
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > CURRENT_TIMESTAMP - INTERVAL '12 hours';
Evitar grandes leituras em transações de leitura e gravação
Transações de leitura/gravação permitem uma sequência de zero ou mais leituras ou consultas SQL e podem incluir um conjunto de mutações, antes de uma chamada para confirmação. Para manter a consistência dos dados, o Spanner adquire bloqueios ao ler e gravar linhas nas tabelas e nos índices. Para mais informações sobre bloqueio, consulte Vida útil de leituras e gravações.
Devido à forma como o bloqueio funciona no Spanner, realizar uma leitura ou consulta SQL que lê um grande número de linhas (por exemplo, SELECT * FROM
Singers) significa que nenhuma outra transação pode gravar nas linhas que você leu até que sua transação seja confirmada ou cancelada.
Além disso, como a transação está processando um grande número de linhas, é
provável que ela leve mais tempo do que uma transação que lê um intervalo muito menor de linhas
(por exemplo, SELECT LastName FROM Singers WHERE SingerId = 7), o que agrava
ainda mais o problema e reduz a capacidade do sistema.
Portanto, tente evitar leituras grandes (por exemplo, verificações completas de tabelas ou operações de mesclagem massivas) nas transações, a menos que você esteja disposto a aceitar uma capacidade de gravação menor.
Em alguns casos, o padrão a seguir pode gerar resultados melhores:
- Faça as leituras grandes em uma transação somente leitura. As transações somente leitura permitem uma maior capacidade de processamento agregada porque não usam bloqueios.
- Opcional: faça o processamento necessário nos dados que você acabou de ler.
- Inicie uma transação de leitura/gravação.
- Verifique se as linhas críticas não mudaram de valor desde que você realizou
a transação somente leitura na etapa 1.
- Se houve mudança, reverta sua transação e comece novamente na etapa 1.
- Se tudo estiver certo, confirme as mutações.
Uma maneira de evitar leituras grandes em transações de leitura e gravação é analisar os planos de execução gerados pelas consultas.
Usar ORDER BY para garantir a ordem dos resultados SQL
Se você espera uma determinada ordem para os resultados de uma consulta SELECT,
inclua explicitamente a cláusula ORDER BY. Por exemplo, se você quiser listar todos os
cantores em ordem de chave primária, use esta consulta:
SELECT * FROM
Singers
ORDER BY SingerId;
O Spanner garante a ordenação de resultados somente se a cláusula ORDER BY
estiver presente na consulta. Em outras palavras, considere esta consulta sem o ORDER
BY:
SELECT * FROM Singers;
O Spanner não garante que os resultados dessa consulta estejam na ordem da chave primária. Além disso, a ordem dos resultados pode mudar a qualquer momento e não há garantia de que seja consistente entre as invocações. Se uma
consulta tiver uma cláusula ORDER BY e o Spanner usar um índice que
forneça a ordem necessária, o Spanner não vai classificar explicitamente
os dados. Portanto, não se preocupe com o impacto no desempenho ao incluir essa cláusula. Para verificar se uma operação de classificação explícita está incluída na
execução, consulte o plano de consulta.
Usar STARTS_WITH em vez de LIKE
Como o Spanner não avalia padrões LIKE parametrizados
até o momento da execução, ele precisa ler todas as linhas e avaliá-las
em relação à expressão LIKE para filtrar as linhas que não correspondem.
Quando um padrão LIKE tem o formato foo% (por exemplo, começa com uma string fixa e termina com um único caractere curinga de porcentagem) e a coluna é indexada, use STARTS_WITH em vez de LIKE. Essa opção permite que o Spanner
otimize o plano de execução da consulta de maneira mais eficaz.
Não recomendado:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE @like_clause;
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE $1;
Recomendação:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, @prefix);
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, $2);
Usar carimbos de data/hora de commit
Se o aplicativo precisar consultar dados gravados após um determinado horário, adicione
colunas de carimbo de data/hora de confirmação às tabelas relevantes. Os carimbos de data/hora de confirmação permitem uma
otimização do Spanner que pode reduzir a E/S de consultas com cláusulas
WHERE que restringem os resultados a linhas gravadas mais recentemente do que um horário
específico.
Saiba mais sobre essa otimização com bancos de dados de dialeto do GoogleSQL ou com bancos de dados de dialeto do PostgreSQL.