


Em um banco de dados do Spanner, o Spanner cria automaticamente um
índice para a chave primária de cada tabela. Por exemplo, não é necessário fazer nada
para indexar a chave primária de Singers, porque ela é indexada automaticamente
para você.
Também é possível criar índices secundários para outras colunas. Adicionar um índice secundário a uma coluna torna mais eficiente para procurar dados nessa coluna. Por
exemplo, se você precisar procurar rapidamente um álbum por título, crie
um índice secundário em AlbumTitle,
para que o Spanner não precise verificar a tabela inteira.
Se a pesquisa no exemplo anterior for feita em uma transação de leitura e gravação,
a pesquisa mais eficiente também evitará o bloqueio de toda a tabela,
o que permite inserções e atualizações simultâneas na tabela para linhas fora do
intervalo de pesquisa AlbumTitle.
Além dos benefícios que trazem para as pesquisas, os índices secundários também podem ajudar o Spanner a executar verificações com mais eficiência, permitindo verificações de índice em vez de verificações de tabela completa.
O Spanner armazena os seguintes dados em cada índice secundário:
- Todas as colunas de chave da tabela base.
- Todas as colunas incluídas no índice.
- Todas as colunas especificadas na cláusula opcional
STORING(bancos de dados de dialeto GoogleSQL) ouINCLUDE(bancos de dados de dialeto PostgreSQL) da definição do índice.
Com o tempo, o Spanner analisa suas tabelas para garantir que os índices secundários sejam usados para as consultas apropriadas.
Adicionar um índice secundário
O momento mais eficiente para adicionar um índice secundário é quando você cria a tabela. Para criar uma tabela e os índices dela ao mesmo tempo, envie as instruções DDL da nova tabela e dos novos índices em uma única solicitação ao Spanner.
No Spanner, também é possível adicionar um novo índice secundário a uma tabela enquanto o banco de dados continua a disponibilizar o tráfego. Como qualquer outra alteração de esquema no Spanner, adicionar um índice a um banco de dados não exige que ele seja desconectado e não bloqueia colunas ou tabelas inteiras.
Sempre que um novo índice é adicionado a uma tabela, o Spanner preenche automaticamente o índice para refletir uma visualização atualizada dos dados que estão sendo indexados. O Spanner gerencia esse processo de preenchimento para você, e o processo é executado em segundo plano usando recursos de nó com baixa prioridade. A velocidade de preenchimento do índice se adapta às mudanças nos recursos do nó durante a criação do índice, e o preenchimento não afeta significativamente o desempenho do banco de dados.
O tempo de criação do índice pode variar de minutos a muitas horas. Como a criação do índice é uma atualização de esquema, ele está sujeito às mesmas restrições de desempenho que qualquer outra atualização de esquema. O tempo necessário para criar um índice secundário depende de vários fatores:
- O tamanho do conjunto de dados
- A capacidade de computação da instância
- da carga na instância.
Para ver o progresso de um processo de preenchimento de índice, consulte a seção de progresso.
Esteja ciente de que usar a coluna confirmar carimbo de data/hora como a primeira parte do índice secundário pode criar pontos de acesso e reduzir o desempenho de gravação.
Use a instrução CREATE INDEX para definir um índice secundário
no esquema. Veja alguns exemplos:
Para indexar todos os Singers no banco de dados pelo nome e sobrenome:
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Para criar um índice de todos Songs no banco de dados pelo valor de SongName:
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
Para indexar somente as músicas de um determinado cantor, use a cláusula INTERLEAVE IN para intercalar o índice na tabela Singers:
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
Para indexar apenas as canções de um álbum específico:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
Para indexar por ordem decrescente de SongName:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
A anotação DESC anterior se aplica apenas a SongName. Para indexar por ordem decrescente de outras chaves de índice, anote-as com DESC também: SingerId DESC, AlbumId DESC.
Observe também que PRIMARY_KEY é uma palavra reservada e não pode ser usada como o nome de um índice. É o nome dado ao pseudo-índice
criado quando uma tabela com especificação de chave primária é criada.
Para mais detalhes e práticas recomendadas sobre como escolher índices não intercalados e intercalados, consulte Escolher entre índices intercalados e globais, Opções de índice e Usar um índice intercalado em uma coluna com valor que aumenta ou diminui monotonicamente.
Índices e intercalação
Os índices do Spanner podem ser intercalados com outras tabelas para colocar as linhas de índice com as de outra tabela. Semelhante à intercalação de tabelas do Spanner, as colunas de chave primária do pai do índice precisam ser um prefixo das colunas indexadas, correspondendo ao tipo e à ordem de classificação. Ao contrário das tabelas intercaladas, não é necessário que os nomes das colunas sejam iguais. Cada linha de um índice intercalado é armazenada fisicamente com a linha pai associada.
Por exemplo, considere o seguinte esquema:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
Para indexar todos os Singers no banco de dados pelo nome e sobrenome, é necessário
criar um índice. Veja como definir o índice SingersByFirstLastName:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Se você quiser criar um índice de Songs em (SingerId, AlbumId, SongName),
faça o seguinte:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
Ou você pode criar um índice intercalado com um ancestral de Songs,
como o seguinte:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
Além disso, também é possível criar um índice de Songs em
(PublisherId, SingerId, AlbumId, SongName) que é intercalado com uma tabela
que não é um ancestral de Songs, como Publishers. A chave primária da tabela Publishers (id) não é um prefixo das colunas indexadas no exemplo a seguir. Isso ainda é permitido porque Publishers.Id e
Songs.PublisherId compartilham o mesmo tipo, ordem de classificação e nulabilidade.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
Escolher entre índices intercalados e globais
Ao criar um índice secundário no Spanner, você o define como um índice global (o índice padrão não intercalado) ou um índice intercalado. Escolher o tipo de índice ideal é fundamental para o desempenho de leitura e gravação.
Comparação de índices
| Recurso | Índice intercalado | Índice global |
|---|---|---|
| Local de armazenamento | Colocalizada com a linha mãe na mesma divisão (árvore de linhas). | Armazenado em uma tabela raiz separada, que pode ser dividida de forma independente da tabela base. |
| Principais requisitos | A chave primária da tabela pai precisa ser um prefixo das chaves de índice. | Não há restrições nas chaves de índice. |
| Sobrecarga de gravação | Baixo. Quando intercaladas em um ancestral da tabela base, as atualizações geralmente são locais para a divisão, evitando confirmações em duas fases entre as divisões. Se intercalada em uma tabela que não é um ancestral, a sobrecarga de gravação é maior porque as atualizações podem exigir transações distribuídas. | Alto. As atualizações geralmente abrangem diferentes divisões, exigindo transações distribuídas. |
| Ideal para | Consultas com escopo para uma única entidade pai, por exemplo, "encontrar fotos do usuário USER_NAME". | Consultas que pesquisam em todo o banco de dados, por exemplo, "encontrar usuário por e-mail". |
Por que os índices intercalados geralmente são preferidos
Em um banco de dados distribuído como o Spanner, a localidade dos dados é fundamental para o desempenho. Os índices intercalados geralmente são preferidos porque preservam a localidade dos dados:
- Leituras eficientes:se as consultas sempre filtrarem pelo ID de uma entidade pai, um índice intercalado permitirá que o Spanner satisfaça a consulta verificando apenas a divisão que contém essa entidade pai, em vez de consultar várias divisões.
- Gravações eficientes:quando você atualiza uma linha em uma tabela, o Spanner também precisa atualizar os índices secundários. Se você usar um índice global, é provável que a entrada do índice esteja em uma divisão diferente da linha de base. Isso força o Spanner a realizar uma transação distribuída (confirmação em duas fases) entre as divisões, o que aumenta a latência e o uso da CPU. Se um índice intercalado estiver intercalado em um ancestral da tabela base, a entrada do índice será armazenada na mesma divisão que a linha base, tornando a gravação uma operação local.
Guia de decisões
Use as diretrizes a seguir para escolher o tipo de índice ideal para seu caso de uso:
Quando usar um índice intercalado
Use um índice intercalado quando uma ou mais das seguintes condições forem verdadeiras:
- Suas consultas sempre incluem um filtro na chave primária da tabela pai, por exemplo,
WHERE UserId = @userId AND .... - As colunas de chave primária da tabela pai podem ser usadas naturalmente como um prefixo para as chaves de índice.
- Você quer minimizar a latência de gravação e a sobrecarga de CPU da manutenção de índices.
Exemplo:
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
Quando usar um índice global
Use um índice global quando uma ou mais das seguintes condições forem verdadeiras:
- Você precisa consultar dados em todo o banco de dados sem filtrar por uma entidade pai, por exemplo, uma pesquisa global.
- As colunas que você quer indexar não compartilham um prefixo com nenhuma tabela pai.
Exemplo:
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
Verificar o progresso do preenchimento do índice
Console
No menu de navegação do Spanner, clique na guia Operações. A página Operações mostra uma lista de operações em execução.
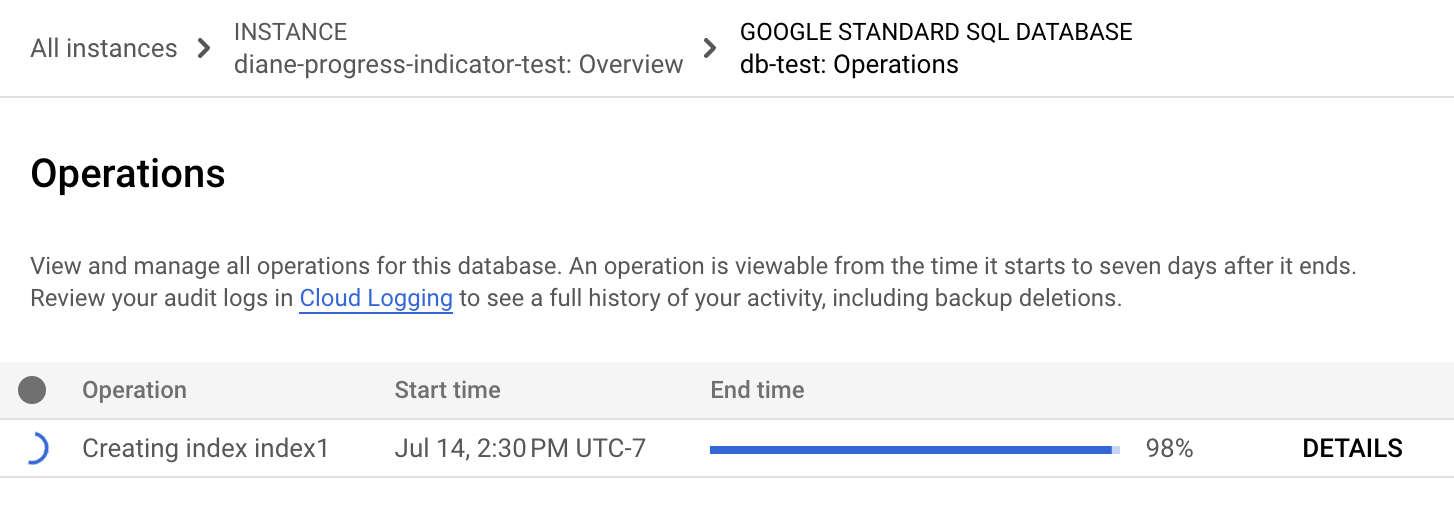
Encontre a operação de preenchimento na lista. Se ela ainda estiver em execução, o indicador de progresso na coluna Horário de término vai mostrar a porcentagem da operação que foi concluída, como mostrado na imagem a seguir:
gcloud
Use gcloud spanner operations describe
para verificar o progresso de uma operação.
Consiga o ID da operação:
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Substitua:
- INSTANCE-NAME pelo nome da instância do Spanner.
- DATABASE-NAME pelo nome do banco de dados.
Observações sobre o uso:
Para limitar a lista, especifique a sinalização
--filter. Exemplo:--filter="metadata.name:example-db"lista apenas as operações em um banco de dados específico.--filter="error:*"lista apenas as operações de backup que falharam.
Para informações sobre a sintaxe do filtro, consulte gcloud topic filtros. Para informações sobre como filtrar operações de backup, consulte o campo
filterem ListBackupOperationsRequest.A sinalização
--typenão diferencia maiúsculas de minúsculas.
A saída será assim:
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
Execute
gcloud spanner operations describe:gcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
Substitua:
- INSTANCE-NAME: o nome da instância do Spanner.
- DATABASE-NAME: o nome do banco de dados do Spanner.
- PROJECT-NAME: o nome do projeto.
- OPERATION-ID: o ID da operação que você quer verificar.
A seção
progressna saída mostra a porcentagem da operação que foi concluída. A resposta será semelhante a:done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST v1
Consiga o ID da operação:
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Substitua:
- INSTANCE-NAME pelo nome da instância do Spanner.
- DATABASE-NAME pelo nome do banco de dados.
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT-ID: o ID do projeto.
- INSTANCE-ID: o ID da instância
- DATABASE-ID: o ID do banco de dados.
- OPERATION-ID: o ID da operação.
Método HTTP e URL:
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
Para enviar a solicitação, expanda uma destas opções:
Você receberá uma resposta JSON semelhante a esta:
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
Para gcloud e REST, é possível encontrar o progresso de cada instrução de preenchimento de índice na seção progress. Para cada instrução na matriz de instruções,
há um campo correspondente na matriz de progresso. Essa ordem de matriz de progresso
corresponde à ordem da matriz de instruções. Quando disponíveis, os campos startTime, progressPercent e endTime são preenchidos de acordo.
A saída não mostra um tempo estimado para a conclusão do preenchimento.
Se a operação demorar muito, você poderá cancelá-la. Para mais informações, consulte Cancelar a criação de índices.
Cenários ao visualizar o progresso do preenchimento do índice
Há diferentes cenários que você pode encontrar ao tentar verificar o progresso de um preenchimento de índice. As instruções de criação de índice que exigem um preenchimento de índice fazem parte de operações de atualização de esquema, e pode haver várias instruções que fazem parte de uma operação de atualização de esquema.
O primeiro cenário é o mais simples, que é quando a instrução de criação do índice é a primeira na operação de atualização do esquema. Como a instrução de criação de índice
é a primeira, ela é a primeira processada e executada devido
à ordem de execução.
Imediatamente, o campo startTime da instrução de criação de índice será preenchido com o horário de início da operação de atualização do esquema. Em seguida, o campo progressPercent da instrução de criação de índice é preenchido quando o progresso do preenchimento do índice é maior que 0%. Por fim, o campo endTime é preenchido quando
a instrução é confirmada.
O segundo cenário é quando a instrução de criação do índice não é a primeira
instrução na operação de atualização do esquema. Nenhum campo relacionado à instrução de criação de índice será preenchido até que as instruções anteriores tenham sido confirmadas devido à ordem de execução.
Assim como no cenário anterior, depois que as instruções anteriores são confirmadas, o campo startTime da instrução de criação de índice é preenchido primeiro, seguido pelo campo progressPercent. Por fim, o campo endTime é preenchido quando a
instrução termina de ser confirmada.
Cancelar criação de índice
Use a Google Cloud CLI para cancelar a criação de um índice. Para recuperar uma lista de
operações de atualização de esquema para um banco de dados do Spanner, use o
comando gcloud spanner operations list e inclua
a opção --filter:
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
Encontre o OPERATION_ID para a operação que você quer cancelar, use o comando gcloud spanner operations cancel para cancelá-lo:
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
Ver índices atuais
Para ver informações sobre os índices atuais em um banco de dados, use o console doGoogle Cloud ou a Google Cloud CLI:
Console
Acesse a página Instâncias do Spanner no console do Google Cloud .
Clique no nome da instância que quer exibir.
No painel esquerdo, clique no banco de dados que você quer visualizar e clique na tabela que você quer visualizar.
Clique na guia Índices. O console do Google Cloud mostra uma lista de índices.
Opcional: para detalhes sobre um índice, como as colunas incluídas, clique no nome do índice.
gcloud
Use o comando gcloud spanner databases ddl describe:
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
A CLI gcloud mostra as instruções da linguagem de definição de dados (DDL) para criar as tabelas e os índices do banco de dados. As instruções CREATE
INDEX descrevem os índices atuais. Exemplo:
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
Consultar com um índice específico
As seções a seguir explicam como especificar um índice em uma instrução SQL e
com a interface de leitura do Spanner. Os exemplos nessas seções presumem que você adicionou uma coluna MarketingBudget à tabela Albums e criou um índice chamado AlbumsByAlbumTitle:
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Especificar um índice em uma instrução SQL
Quando você usa o SQL para consultar uma tabela do Spanner, o Spanner utiliza automaticamente os índices que provavelmente tornarão a consulta mais eficiente. Como resultado, você não precisa especificar um índice para consultas SQL. No entanto,
para consultas essenciais à sua carga de trabalho, o Google aconselha a utilização de
diretivas FORCE_INDEX nas instruções SQL para um desempenho mais consistente.
Em alguns casos, o Spanner pode escolher um índice que aumenta a latência da consulta. Se você seguir as [etapas de solução de problemas para regressões de desempenho][troubleshooting-query-performance-regressions] e decidir testar um índice diferente para a consulta, especifique o índice como parte da consulta.
Para especificar um índice em uma instrução SQL, use a dica FORCE_INDEX
para fornecer uma diretiva de índice. As diretivas de índice usam a seguinte sintaxe:
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
Também é possível usar uma diretiva de índice para instruir o Spanner a verificar a tabela base em vez de usar um índice:
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
É possível usar uma diretiva de índice para instruir o Spanner a verificar um índice em uma tabela com esquemas nomeados:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
O exemplo a seguir mostra uma consulta SQL que especifica um índice:
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
Uma diretiva de índice pode forçar o processador de consultas do Spanner a ler
colunas adicionais que são exigidas pela consulta, mas não estão armazenadas no índice.
O processador de consultas recupera essas colunas unindo o índice e a tabela base. Para evitar essa mesclagem extra, use uma
cláusula STORING (bancos de dados de dialeto GoogleSQL) ou INCLUDE (bancos de dados de dialeto PostgreSQL) para
armazenar as colunas adicionais no índice.
No exemplo anterior, a coluna MarketingBudget não é
armazenada no índice, mas a consulta SQL seleciona essa coluna. Como resultado, o Spanner precisa procurar a coluna MarketingBudget na tabela base e, em seguida, mesclá-la com os dados do índice para retornar os resultados da consulta.
O Spanner vai gerar um erro se a diretiva de índice tiver algum dos seguintes problemas:
- O índice não existe.
- O índice está em uma tabela base diferente.
- Falta um a expressão de filtragem obrigatória
NULLpara um índiceNULL_FILTERED.
Os exemplos a seguir mostram como gravar e executar consultas que buscam os valores de AlbumId, AlbumTitle e MarketingBudget usando o índice AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Especificar um índice na interface de leitura
Ao usar a interface de leitura do Spanner e quiser que ele use um índice, você precisa especificar o índice. A interface de leitura não seleciona o índice automaticamente.
Além disso, seu índice deve conter todos os dados que aparecem nos resultados da consulta, excluindo as colunas que fazem parte da chave primária. Essa restrição existe porque a interface de leitura não é compatível com junções entre o índice e a tabela base. Se você precisar incluir outras colunas nos resultados da consulta, terá algumas opções:
- Use uma cláusula
STORINGouINCLUDEpara armazenar as colunas adicionais no índice. - Consulte sem incluir as colunas adicionais e use as chaves primárias para enviar outra consulta que lê as colunas adicionais.
O Spanner retorna valores do índice em ordem de classificação crescente por chave de índice. Para recuperar os valores em ordem decrescente, siga estas etapas:
Anote a chave de índice com
DESC: Por exemplo:CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);A anotação
DESCse aplica a uma única chave de índice. Se o índice incluir mais de uma chave e você desejar que os resultados apareçam em ordem descendente com base em todas as chaves, inclua uma anotaçãoDESCpara cada chave.Se a leitura especificar um intervalo de chaves, certifique-se de que o intervalo de chaves também esteja em ordem decrescente. Em outras palavras, o valor da chave inicial precisa ser maior que o valor da chave final.
O exemplo a seguir mostra como recuperar os valores de AlbumId e AlbumTitle usando o índice AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Criar um índice para verificações somente de índice
Se quiser, use a cláusula STORING (para bancos de dados de dialeto do GoogleSQL) ou INCLUDE (para bancos de dados de dialeto do PostgreSQL) para armazenar uma cópia de uma coluna no
índice. Esse tipo de índice oferece vantagens para consultas e chamadas de leitura usando o índice, ao custo de usar armazenamento extra:
- As consultas SQL que usam o índice e selecionam colunas armazenadas na cláusula
STORINGouINCLUDEnão exigem uma mesclagem extra com a tabela base. - As chamadas
read()que usam o índice podem ler colunas armazenadas pela cláusulaSTORING/INCLUDE.
Por exemplo, suponha que você tenha criado uma versão alternativa de AlbumsByAlbumTitle
que armazena uma cópia da coluna MarketingBudget no índice (observe a
cláusula STORING ou INCLUDE em negrito):
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
Com o índice AlbumsByAlbumTitle antigo, o Spanner precisa mesclar o índice
com a tabela base e, em seguida, recuperar a coluna da tabela base. Com o novo índice AlbumsByAlbumTitle2, o Spanner lê a coluna diretamente do índice, o que é mais eficiente.
Se você usar a interface de leitura em vez de SQL, o novo índice AlbumsByAlbumTitle2 também permitirá que você leia a coluna MarketingBudget diretamente:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Alterar um índice
É possível usar a instrução ALTER INDEX para adicionar outras colunas
a um índice atual ou remover colunas. Isso
pode atualizar a lista de colunas definida pela cláusula STORING
(bancos de dados de dialeto GoogleSQL) ou INCLUDE (bancos de dados de dialeto PostgreSQL) ao criar o
índice. Não é possível usar essa instrução para adicionar ou remover colunas da chave de índice. Por exemplo, em vez de criar um novo
índice AlbumsByAlbumTitle2, use ALTER INDEX para adicionar uma
coluna a AlbumsByAlbumTitle, como mostrado no exemplo a seguir:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
Quando você adiciona uma nova coluna a um índice, o Spanner
usa um processo de preenchimento em segundo plano. Enquanto o preenchimento estiver em andamento,
a coluna no índice não será legível, então talvez você não tenha o aumento de desempenho
esperado. Use o comando gcloud spanner operations
para listar a operação de longa duração e conferir o status dela.
Para mais informações, consulte operação de descrição.
Também é possível usar a operação de cancelamento para cancelar uma operação em andamento.
Depois que o preenchimento é concluído, o Spanner adiciona a coluna ao índice. À medida que o índice aumenta, isso pode deixar as consultas que usam o índice mais lentas.
O exemplo a seguir mostra como remover uma coluna de um índice:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
Índice de valores NULL
Por padrão, o Spanner indexa valores NULL. Por exemplo, lembre-se da definição do índice SingersByFirstLastName na tabela Singers:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Todas as linhas de Singers são indexadas mesmo se FirstName ou LastName, ou ambas, forem NULL.

Quando valores NULL são indexados, é possível realizar consultas SQL eficientes e leituras sobre dados que incluem valores NULL. Por exemplo, use esta instrução de consulta SQL para encontrar todos Singers com NULL FirstName:
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
Ordem de classificação para valores NULL
O Spanner classifica NULL como o menor valor para qualquer tipo. Para uma coluna em ordem crescente (ASC), os valores NULL são classificados primeiro. Para uma coluna em ordem decrescente (DESC), os NULL valores classificam por último.
Desativar a indexação de valores NULL
GoogleSQL
Para desativar a indexação de nulos, adicione a palavra-chave NULL_FILTERED à definição do índice. Índices NULL_FILTERED são particularmente úteis para indexar colunas esparsas, onde a maioria das linhas contém um valor NULL. Nesses casos, o índice NULL_FILTERED pode ser consideravelmente menor e mais eficiente de manter do que um índice normal que inclua valores NULL.
Aqui está uma definição alternativa de SingersByFirstLastName que não indexa os valores NULL:
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
A palavra-chave NULL_FILTERED se aplica a todas as colunas de chave de índice. Não é possível especificar a filtragem de NULL por coluna.
PostgreSQL
Para filtrar linhas com valores nulos em uma ou mais colunas indexadas, use o
predicado WHERE COLUMN IS NOT NULL.
Os índices filtrados por nulo são particularmente úteis para indexar colunas esparsas, em que a maioria das linhas contém um valor NULL. Nesses casos, o índice filtrado por nulo pode ser consideravelmente menor e mais eficiente de manter do que um índice normal que inclui valores NULL.
Aqui está uma definição alternativa de SingersByFirstLastName que não indexa os valores NULL:
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
A filtragem de valores NULL impede que o Spanner os use em algumas
consultas. Por exemplo, o Spanner não usa o índice para esta consulta,
porque o índice omite as linhas Singers em que LastName é NULL. Como
resultado, o uso do índice impediria que a consulta retornasse as linhas corretas:
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
Para permitir que o Spanner use o índice, reescreva a consulta para que ela exclua as linhas que também são excluídas do índice:
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
Campos de proto de índice
Use colunas geradas para indexar
campos em buffers de protocolo armazenados em colunas PROTO, desde que os campos
indexados usem os tipos de dados primitivos ou ENUM.
Se você definir um índice em um campo de mensagem de protocolo, não será possível modificar ou remover esse campo do esquema proto. Para mais informações, consulte Atualizações em esquemas que contêm um índice em campos proto.
Veja a seguir um exemplo da tabela Singers com uma coluna de mensagem proto
SingerInfo. Para definir um índice no campo nationality de PROTO,
é preciso criar uma coluna gerada armazenada:
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
Ele tem a seguinte definição do tipo de proto googlesql.example.SingerInfo:
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
Em seguida, defina um índice no campo nationality do proto:
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
A consulta SQL a seguir lê dados usando o índice anterior:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
Observações:
- Use uma diretiva de índice para acessar índices nos campos de colunas de buffer de protocolo.
- Não é possível criar um índice em campos de buffer de protocolo repetidos.
Atualizações em esquemas que contêm um índice em campos proto
Se você definir um índice em um campo de mensagem de protocolo, não será possível modificar ou remover esse campo do esquema proto. Isso ocorre porque, depois que você define o índice, a verificação de tipo é realizada sempre que o esquema é atualizado. O Spanner captura as informações de tipo de todos os campos no caminho usados na definição do índice.
Índices exclusivos
Os índices podem ser declarados como UNIQUE. Os índices UNIQUE adicionam uma restrição aos dados indexados que proíbem entradas duplicadas para uma determinada chave de índice.
Essa restrição é aplicada pelo Spanner no momento da confirmação da transação.
Especificamente, qualquer transação que gere várias entradas de índice para a mesma chave falhará na confirmação.
Se uma tabela contiver dados não UNIQUE para começar, a tentativa de criar um índice UNIQUE nela falhará.
Uma observação sobre índices UNIQUE NULL_FILTERED
Um índice UNIQUE NULL_FILTERED não impõe a exclusividade da chave de índice quando pelo menos uma das partes de chave do índice é NULL.
Por exemplo, suponha que você tenha criado a tabela e o índice a seguir:
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
As duas linhas a seguir em ExampleTable têm os mesmos valores para as chaves de índice secundário Key1, Key2 e Col1:
1, NULL, 1, 1
1, NULL, 2, 1
Como Key2 é NULL e o índice é filtrado por nulo, as linhas não estarão
presentes no índice ExampleIndex. Como eles não são inseridos no
índice, o índice não os rejeitará por violar a exclusividade em (Key1, Key2,
Col1).
Se você quiser que o índice aplique a exclusividade dos valores da tupla (Key1,
Key2, Col1), anote Key2 com NOT NULL na definição da tabela
ou crie o índice sem filtrar nulos.
Criar um índice com base em uma expressão escalar
Com um índice de expressão, é possível criar um índice com base em uma expressão escalar que se aplica a uma ou mais colunas de tabela. Isso é útil porque elimina a necessidade de criar e manter uma coluna gerada dedicada na tabela apenas para fins de indexação.
Os índices em colunas geradas e os índices de expressão podem ser úteis para indexar campos específicos em uma coluna JSON. É possível criar um índice em um valor extraído de um objeto JSON, o que permite que o otimizador de consultas realize pesquisas com eficiência com base nesse valor.
Neste exemplo, uma coluna gerada chamada VenueCity, que é baseada no campo city dentro do JSON, é criada apenas para ser colocada em um índice:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
Para fazer isso de maneira mais eficiente, defina o índice diretamente, e o Spanner vai processar o mecanismo subjacente de maneira implícita:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
Em ambos os casos, sua consulta pode usar o índice VenuesByCity para uma execução mais rápida:
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
Os índices de expressão podem ter colunas que são uma combinação de expressões e referências de coluna diretas. Isso permite que mais consultas usem o índice para uma execução mais rápida.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
Remover um índice
Use a instrução DROP INDEX para remover um índice secundário do
esquema.
Para descartar o índice chamado SingersByFirstLastName:
DROP INDEX SingersByFirstLastName;
Indexar para uma verificação mais rápida
Quando o Spanner precisa realizar uma verificação de tabela (em vez de uma pesquisa indexada) para buscar valores de uma ou mais colunas, é possível receber resultados mais rápidos se houver um índice para essas colunas e na ordem especificada pela consulta. Se você realiza consultas que exigem verificações com frequência, considere criar índices secundários para que essas verificações sejam mais eficientes.
Em particular, se você precisar que o Spanner verifique com frequência a chave primária de uma tabela ou outro índice em ordem inversa, aumente a eficiência dele por meio de um índice secundário que torne explícita a ordem escolhida.
Por exemplo, a consulta a seguir sempre retorna um resultado rápido, mesmo que o Spanner precise verificar Songs para encontrar o menor valor de SongId:
SELECT SongId FROM Songs LIMIT 1;
SongId é a chave primária da tabela, armazenada (como todas as chaves primárias)
em ordem crescente. O Spanner pode verificar o índice dessa chave e encontrar
o primeiro resultado rapidamente.
No entanto, sem a ajuda de um índice secundário, a consulta a seguir não retornaria tão rapidamente, especialmente se Songs tiver muitos dados:
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
Embora SongId seja a chave primária da tabela, o Spanner não tem como buscar o valor mais alto da coluna sem recorrer a uma verificação completa da tabela.
Adicionar o índice a seguir permitiria que essa consulta retornasse mais rapidamente:
CREATE INDEX SongIdDesc On Songs(SongId DESC);
Com esse índice, o Spanner o usaria para retornar um resultado para a segunda consulta com muito mais rapidez.
A seguir
- Saiba mais sobre as práticas recomendadas de SQL para o Spanner.
- Entenda os planos de execução de consultas do Spanner.
- Saiba como resolver problemas de regressões de desempenho em consultas SQL.