


Dalam database Spanner, Spanner otomatis membuat indeks untuk kunci utama setiap tabel. Misalnya, Anda tidak perlu melakukan apa pun untuk mengindeks kunci utama Singers, karena kunci tersebut otomatis diindeks untuk Anda.
Anda juga dapat membuat indeks sekunder untuk kolom lain. Menambahkan indeks sekunder pada kolom akan membuat pencarian data di kolom tersebut menjadi lebih efisien. Misalnya, jika Anda perlu mencari album berdasarkan judul dengan cepat, Anda harus membuat indeks sekunder di AlbumTitle, sehingga Spanner tidak perlu memindai seluruh tabel.
Jika pencarian dalam contoh sebelumnya dilakukan dalam transaksi baca-tulis,
pencarian yang lebih efisien juga menghindari penahanan kunci pada seluruh tabel,
yang memungkinkan penyisipan dan pembaruan serentak ke tabel untuk baris di luar
rentang pencarian AlbumTitle.
Selain manfaat yang diberikan pada pencarian, indeks sekunder juga dapat membantu Spanner menjalankan pemindaian dengan lebih efisien, sehingga memungkinkan pemindaian indeks, bukan pemindaian tabel penuh.
Spanner menyimpan data berikut di setiap indeks sekunder:
- Semua kolom kunci dari tabel dasar
- Semua kolom yang disertakan dalam indeks
- Semua kolom yang ditentukan dalam klausa
STORINGopsional (database dialek GoogleSQL) atau klausaINCLUDE(database dialek PostgreSQL) dari definisi indeks.
Seiring waktu, Spanner akan menganalisis tabel Anda untuk memastikan bahwa indeks sekunder digunakan untuk kueri yang sesuai.
Menambahkan indeks sekunder
Waktu paling efisien untuk menambahkan indeks sekunder adalah saat Anda membuat tabel. Untuk membuat tabel dan indeksnya secara bersamaan, kirim pernyataan DDL untuk tabel baru dan indeks baru dalam satu permintaan ke Spanner.
Di Spanner, Anda juga dapat menambahkan indeks sekunder baru ke tabel yang ada saat database terus melayani traffic. Seperti perubahan skema lainnya di Spanner, menambahkan indeks ke database yang ada tidak memerlukan penghentian database dan tidak mengunci seluruh kolom atau tabel.
Setiap kali indeks baru ditambahkan ke tabel yang ada, Spanner akan otomatis mengisi ulang, atau mengisi, indeks untuk mencerminkan tampilan terbaru dari data yang diindeks. Spanner mengelola proses pengisian ulang ini untuk Anda, dan prosesnya berjalan di latar belakang menggunakan resource node dengan prioritas rendah. Kecepatan pengisian ulang indeks beradaptasi dengan perubahan resource node selama pembuatan indeks, dan pengisian ulang tidak memengaruhi performa database secara signifikan.
Pembuatan indeks dapat memerlukan waktu beberapa menit hingga beberapa jam. Karena pembuatan indeks adalah update skema, indeks terikat oleh batasan performa yang sama dengan update skema lainnya. Waktu yang diperlukan untuk membuat indeks sekunder bergantung pada beberapa faktor:
- Ukuran set data
- Kapasitas komputasi instance
- Beban pada instance
Untuk melihat progres yang dicapai untuk proses pengisian ulang indeks, lihat bagian progres.
Perlu diketahui bahwa menggunakan kolom stempel waktu commit sebagai bagian pertama dari indeks sekunder dapat membuat hotspot dan mengurangi performa tulis.
Gunakan pernyataan CREATE INDEX untuk menentukan indeks sekunder dalam skema Anda. Berikut beberapa contohnya:
Untuk mengindeks semua Singers dalam database berdasarkan nama depan dan nama belakangnya:
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Untuk membuat indeks semua Songs dalam database berdasarkan nilai SongName:
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
Untuk mengindeks hanya lagu untuk penyanyi tertentu, gunakan klausa INTERLEAVE IN untuk menyisipkan indeks dalam tabel Singers:
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
Untuk mengindeks hanya lagu di album tertentu:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
Untuk mengindeks berdasarkan urutan menurun SongName:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
Perhatikan bahwa anotasi DESC sebelumnya hanya berlaku untuk SongName. Untuk mengindeks berdasarkan
urutan menurun kunci indeks lainnya, anotasikan juga dengan DESC:
SingerId DESC, AlbumId DESC.
Perhatikan juga bahwa PRIMARY_KEY adalah kata yang dicadangkan dan tidak dapat digunakan sebagai nama indeks. Ini adalah nama yang diberikan ke pseudo-index
yang dibuat saat tabel dengan spesifikasi PRIMARY KEY dibuat
Untuk mengetahui detail selengkapnya dan praktik terbaik dalam memilih indeks non-interleaved dan indeks interleaved, lihat Memilih antara indeks interleaved dan global, Opsi indeks, dan Menggunakan indeks interleaved pada kolom yang nilainya meningkat atau menurun secara monoton.
Indeks dan Interleaving
Indeks Spanner dapat disisipkan dengan tabel lain untuk menempatkan baris indeks bersama dengan baris tabel lain. Serupa dengan penyisipan tabel Spanner, kolom kunci utama dari induk indeks harus berupa awalan kolom yang diindeks, yang cocok dalam jenis dan tata urutan. Tidak seperti tabel yang disisipkan, pencocokan nama kolom tidak diperlukan. Setiap baris indeks yang disisipkan disimpan secara fisik bersama dengan baris induk terkait.
Misalnya, perhatikan skema berikut:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
Untuk mengindeks semua Singers dalam database berdasarkan nama depan dan nama belakangnya, Anda harus membuat indeks. Berikut cara menentukan indeks SingersByFirstLastName:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Jika ingin membuat indeks Songs di (SingerId, AlbumId, SongName),
Anda dapat melakukan hal berikut:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
Atau, Anda dapat membuat indeks yang disisipkan dengan ancestor Songs,
seperti berikut:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
Selain itu, Anda juga dapat membuat indeks Songs di (PublisherId, SingerId, AlbumId, SongName) yang disisipkan dengan tabel yang bukan ancestor dari Songs, seperti Publishers. Perhatikan bahwa kunci utama untuk tabel Publishers (id), bukan awalan kolom yang diindeks dalam contoh berikut. Hal ini masih diizinkan karena Publishers.Id dan
Songs.PublisherId memiliki jenis, tata urutan, dan nullability yang sama.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
Memilih antara indeks interleaved dan global
Saat membuat indeks sekunder di Spanner, Anda menentukannya sebagai indeks global (indeks default yang tidak disisipkan) atau indeks yang disisipkan. Memilih jenis indeks yang optimal sangat penting untuk performa baca dan tulis.
Perbandingan indeks
| Fitur | Indeks berselang-seling | Indeks global |
|---|---|---|
| Lokasi penyimpanan | Ditempatkan bersama baris induk di pemisahan yang sama (hierarki baris). | Disimpan dalam tabel root terpisah, yang dapat dibagi secara independen dari tabel dasar. |
| Persyaratan utama | Kunci utama tabel induk harus berupa awalan kunci indeks. | Tidak ada batasan pada kunci indeks. |
| Overhead penulisan | Rendah. Saat disisipkan di ancestor tabel dasar, update biasanya bersifat lokal untuk pemisahan, sehingga menghindari commit dua fase di seluruh pemisahan. Jika disisipkan dalam tabel yang bukan ancestor, overhead penulisan akan lebih tinggi karena update mungkin memerlukan transaksi terdistribusi. | Lebih tinggi. Update sering kali mencakup pemisahan yang berbeda, sehingga memerlukan transaksi terdistribusi. |
| Paling cocok untuk | Kueri yang dicakup ke satu parent entity—misalnya, "temukan foto untuk pengguna USER_NAME". | Kueri yang menelusuri seluruh database—misalnya, "temukan pengguna berdasarkan email". |
Alasan indeks yang disisipkan biasanya lebih disukai
Dalam database terdistribusi seperti Spanner, lokalitas data adalah kunci performa. Indeks yang disisipkan biasanya lebih disukai karena mempertahankan lokalitas data:
- Pembacaan yang efisien: Jika kueri Anda selalu memfilter berdasarkan ID entity induk, indeks yang disisipkan memungkinkan Spanner memenuhi kueri dengan memindai hanya pemisahan yang berisi entity induk tersebut, bukan memeriksa beberapa pemisahan.
- Penulisan yang efisien: Saat Anda memperbarui baris dalam tabel, Spanner juga harus memperbarui indeks sekundernya. Jika Anda menggunakan indeks global, entri indeks kemungkinan berada di pemisahan yang berbeda dengan baris dasar. Hal ini memaksa Spanner untuk melakukan transaksi terdistribusi (commit dua fase) di seluruh pemisahan, yang meningkatkan latensi dan penggunaan CPU. Jika indeks yang disisipkan disisipkan dalam ancestor tabel dasar, entri indeks akan disimpan dalam pemisahan yang sama dengan baris dasar, sehingga penulisan menjadi operasi lokal.
Panduan pengambilan keputusan
Gunakan panduan berikut untuk memilih jenis indeks yang optimal untuk kasus penggunaan Anda:
Kapan harus menggunakan indeks yang disisipkan
Gunakan indeks yang disisipkan jika satu atau beberapa hal berikut benar:
- Kueri Anda selalu menyertakan filter pada kunci utama tabel induk—misalnya,
WHERE UserId = @userId AND .... - Kolom kunci utama tabel induk secara alami dapat digunakan sebagai awalan untuk kunci indeks Anda.
- Anda ingin meminimalkan latensi tulis dan overhead CPU pemeliharaan indeks.
Contoh:
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
Kapan harus menggunakan indeks global
Gunakan indeks global jika satu atau beberapa hal berikut benar:
- Anda perlu mengkueri data di seluruh database tanpa memfilter berdasarkan parent entity—misalnya, penelusuran global.
- Kolom yang ingin Anda indeks tidak memiliki awalan yang sama dengan tabel induk mana pun.
Contoh:
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
Memeriksa progres pengisian ulang indeks
Konsol
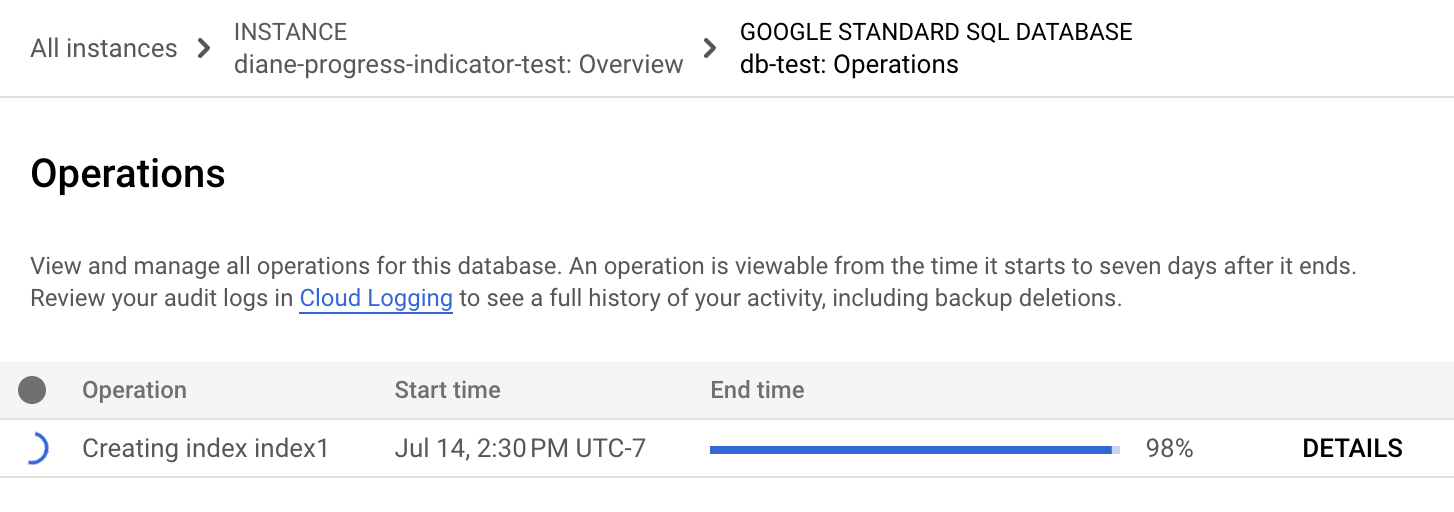
Di menu navigasi Spanner, klik tab Operations. Halaman Operations menampilkan daftar operasi yang sedang berjalan.
Temukan operasi pengisian ulang dalam daftar. Jika masih berjalan, indikator progres di kolom End time akan menampilkan persentase operasi yang telah selesai, seperti yang ditunjukkan pada gambar berikut:
gcloud
Gunakan gcloud spanner operations describe
untuk memeriksa progres operasi.
Dapatkan ID operasi:
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Ganti kode berikut:
- INSTANCE-NAME dengan nama instance Spanner.
- DATABASE-NAME dengan nama database.
Catatan penggunaan:
Untuk membatasi daftar, tentukan flag
--filter. Contoh:--filter="metadata.name:example-db"hanya mencantumkan operasi pada database tertentu.--filter="error:*"hanya mencantumkan operasi pencadangan yang gagal.
Untuk mengetahui informasi tentang sintaksis filter, lihat filter topik gcloud. Untuk mengetahui informasi tentang cara memfilter operasi pencadangan, lihat kolom
filterdi ListBackupOperationsRequest.Flag
--typetidak peka huruf besar/kecil.
Outputnya akan terlihat mirip seperti berikut:
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
Jalankan
gcloud spanner operations describe:gcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
Ganti kode berikut:
- INSTANCE-NAME: Nama instance Spanner.
- DATABASE-NAME: Nama database Spanner.
- PROJECT-NAME: Nama project.
- OPERATION-ID: ID operasi dari operasi yang ingin Anda periksa.
Bagian
progressdalam output menunjukkan persentase operasi yang telah selesai. Outputnya terlihat mirip dengan yang berikut ini:done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST v1
Dapatkan ID operasi:
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Ganti kode berikut:
- INSTANCE-NAME dengan nama instance Spanner.
- DATABASE-NAME dengan nama database.
Sebelum menggunakan salah satu data permintaan, lakukan penggantian berikut:
- PROJECT-ID: project ID.
- INSTANCE-ID: ID instance.
- DATABASE-ID: ID database.
- OPERATION-ID: ID operasi.
Metode HTTP dan URL:
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
Untuk mengirim permintaan Anda, perluas salah satu opsi berikut:
Anda akan melihat respons JSON seperti berikut:
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
Untuk gcloud dan REST, Anda dapat menemukan progres setiap pernyataan pengisian ulang indeks di bagian progress. Untuk setiap pernyataan dalam array pernyataan,
ada kolom yang sesuai dalam array progres. Urutan array progres ini
sesuai dengan urutan array pernyataan. Setelah tersedia, kolom startTime, progressPercent, dan endTime akan diisi sebagaimana mestinya.
Perhatikan bahwa output tidak menampilkan perkiraan waktu kapan progres pengisian ulang akan selesai.
Jika operasi memerlukan waktu terlalu lama, Anda dapat membatalkannya. Untuk mengetahui informasi selengkapnya, lihat Membatalkan pembuatan indeks.
Skenario saat melihat progres pengisian ulang indeks
Ada berbagai skenario yang dapat Anda temui saat mencoba memeriksa progres pengisian ulang indeks. Pernyataan pembuatan indeks yang memerlukan pengisian ulang indeks adalah bagian dari operasi update skema, dan mungkin ada beberapa pernyataan yang merupakan bagian dari operasi update skema.
Skenario pertama adalah yang paling sederhana, yaitu saat pernyataan pembuatan indeks
adalah pernyataan pertama dalam operasi update skema. Karena pernyataan pembuatan indeks adalah pernyataan pertama, pernyataan ini adalah yang pertama diproses dan dieksekusi karena urutan eksekusi.
Kolom startTime dari pernyataan pembuatan indeks akan langsung diisi dengan waktu mulai operasi update skema. Selanjutnya, kolom progressPercent pernyataan pembuatan indeks akan diisi saat progres pengisian ulang indeks lebih dari 0%. Terakhir, kolom endTime diisi setelah pernyataan di-commit.
Skenario kedua adalah saat pernyataan pembuatan indeks bukan pernyataan pertama dalam operasi update skema. Tidak ada kolom yang terkait dengan pernyataan pembuatan indeks yang akan diisi hingga pernyataan sebelumnya telah di-commit karena urutan eksekusi.
Serupa dengan skenario sebelumnya, setelah pernyataan sebelumnya di-commit, kolom startTime dari pernyataan pembuatan indeks akan diisi terlebih dahulu, diikuti dengan kolom progressPercent. Terakhir, kolom endTime akan diisi setelah
pernyataan selesai di-commit.
Membatalkan pembuatan indeks
Anda dapat menggunakan Google Cloud CLI untuk membatalkan pembuatan indeks. Untuk mengambil daftar operasi pembaruan skema untuk database Spanner, gunakan perintah gcloud spanner operations list, dan sertakan opsi --filter:
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
Temukan OPERATION_ID untuk operasi yang ingin Anda batalkan, lalu gunakan perintah gcloud spanner operations cancel untuk membatalkannya:
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
Melihat indeks yang ada
Untuk melihat informasi tentang indeks yang ada dalam database, Anda dapat menggunakan konsolGoogle Cloud atau Google Cloud CLI:
Konsol
Buka halaman Instances Spanner di konsol Google Cloud .
Klik nama instance yang ingin Anda lihat.
Di panel kiri, klik database yang ingin Anda lihat, lalu klik tabel yang ingin Anda lihat.
Klik tab Indeks. Konsol Google Cloud menampilkan daftar indeks.
Opsional: Untuk mendapatkan detail tentang indeks, seperti kolom yang disertakan, klik nama indeks.
gcloud
Gunakan perintah gcloud spanner databases ddl describe:
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
gcloud CLI mencetak pernyataan Bahasa Definisi Data (DDL) untuk membuat tabel dan indeks database. Pernyataan CREATE
INDEX menjelaskan indeks yang ada. Misalnya:
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
Membuat kueri dengan indeks tertentu
Bagian berikut menjelaskan cara menentukan indeks dalam pernyataan SQL dan
dengan antarmuka baca untuk Spanner. Contoh di bagian ini
mengasumsikan bahwa Anda menambahkan kolom MarketingBudget ke tabel Albums dan
membuat indeks bernama AlbumsByAlbumTitle:
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Menentukan indeks dalam pernyataan SQL
Saat Anda menggunakan SQL untuk mengkueri tabel Spanner, Spanner akan otomatis menggunakan indeks apa pun yang mungkin membuat kueri lebih efisien. Oleh karena itu, Anda tidak perlu menentukan indeks untuk kueri SQL. Namun,
untuk kueri yang penting bagi workload Anda, Google menyarankan Anda menggunakan
arahan FORCE_INDEX dalam pernyataan SQL untuk performa yang lebih konsisten.
Dalam beberapa kasus, Spanner mungkin memilih indeks yang menyebabkan latensi kueri meningkat. Jika Anda mengikuti [langkah-langkah pemecahan masalah untuk regresi performa][troubleshooting-query-performance-regressions] dan memutuskan untuk mencoba indeks yang berbeda untuk kueri, Anda dapat menentukan indeks sebagai bagian dari kueri.
Untuk menentukan indeks dalam pernyataan SQL, gunakan petunjuk FORCE_INDEX
untuk memberikan arahan indeks. Perintah indeks menggunakan sintaksis berikut:
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
Anda juga dapat menggunakan perintah indeks untuk memberi tahu Spanner agar memindai tabel dasar, bukan menggunakan indeks:
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
Anda dapat menggunakan perintah indeks untuk memberi tahu Spanner agar memindai indeks dalam tabel dengan skema bernama:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Contoh berikut menunjukkan kueri SQL yang menentukan indeks:
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
Perintah indeks dapat memaksa pemroses kueri Spanner untuk membaca kolom tambahan yang diperlukan oleh kueri, tetapi tidak disimpan dalam indeks.
Pemroses kueri mengambil kolom ini dengan menggabungkan indeks dan tabel dasar. Untuk menghindari penggabungan tambahan ini, gunakan
klausa STORING (database dialek GoogleSQL) atau klausa INCLUDE (database dialek PostgreSQL) untuk
menyimpan kolom tambahan dalam indeks.
Pada contoh sebelumnya, kolom MarketingBudget tidak disimpan dalam indeks, tetapi kueri SQL memilih kolom ini. Akibatnya,
Spanner harus mencari kolom MarketingBudget di tabel dasar,
lalu menggabungkannya dengan data dari indeks, untuk menampilkan hasil kueri.
Spanner akan memunculkan error jika perintah indeks memiliki salah satu masalah berikut:
- Indeks tidak ada.
- Indeks berada di tabel dasar yang berbeda.
- Kueri tidak memiliki ekspresi pemfilteran
NULLyang diperlukan untuk indeksNULL_FILTERED.
Contoh berikut menunjukkan cara menulis dan menjalankan kueri yang mengambil nilai AlbumId, AlbumTitle, dan MarketingBudget menggunakan indeks AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Menentukan indeks di antarmuka baca
Saat menggunakan antarmuka baca ke Spanner, dan Anda ingin Spanner menggunakan indeks, Anda harus menentukan indeks. Antarmuka baca tidak memilih indeks secara otomatis.
Selain itu, indeks Anda harus berisi semua data yang muncul dalam hasil kueri, tidak termasuk kolom yang merupakan bagian dari kunci utama. Batasan ini ada karena antarmuka baca tidak mendukung penggabungan antara indeks dan tabel dasar. Jika perlu menyertakan kolom lain dalam hasil kueri, Anda memiliki beberapa opsi:
- Gunakan klausa
STORINGatauINCLUDEuntuk menyimpan kolom tambahan dalam indeks. - Buat kueri tanpa menyertakan kolom tambahan, lalu gunakan kunci utama untuk mengirim kueri lain yang membaca kolom tambahan.
Spanner menampilkan nilai dari indeks dalam tata urutan menaik berdasarkan kunci indeks. Untuk mengambil nilai dalam urutan menurun, selesaikan langkah-langkah berikut:
Beri anotasi pada kunci indeks dengan
DESC. Contoh:CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);Anotasi
DESCberlaku untuk satu kunci indeks. Jika indeks menyertakan lebih dari satu kunci, dan Anda ingin hasil kueri muncul dalam urutan menurun berdasarkan semua kunci, sertakan anotasiDESCuntuk setiap kunci.Jika pembacaan menentukan rentang kunci, pastikan rentang kunci juga dalam urutan menurun. Dengan kata lain, nilai kunci awal harus lebih besar daripada nilai kunci akhir.
Contoh berikut menunjukkan cara mengambil nilai AlbumId dan
AlbumTitle menggunakan indeks AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Membuat indeks untuk pemindaian khusus indeks
Secara opsional, Anda dapat menggunakan klausa STORING (untuk database dialek GoogleSQL) atau klausa INCLUDE (untuk database dialek PostgreSQL) untuk menyimpan salinan kolom dalam indeks. Jenis indeks ini memberikan keuntungan untuk kueri dan panggilan baca yang menggunakan indeks, dengan konsekuensi penggunaan penyimpanan tambahan:
- Kueri SQL yang menggunakan indeks dan memilih kolom yang disimpan dalam klausa
STORINGatauINCLUDEtidak memerlukan join tambahan ke tabel dasar. - Panggilan
read()yang menggunakan indeks dapat membaca kolom yang disimpan oleh klausaSTORING/INCLUDE.
Misalnya, Anda membuat versi alternatif AlbumsByAlbumTitle
yang menyimpan salinan kolom MarketingBudget dalam indeks (perhatikan
klausa STORING atau INCLUDE yang dicetak tebal):
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
Dengan indeks AlbumsByAlbumTitle lama, Spanner harus menggabungkan indeks dengan tabel dasar, lalu mengambil kolom dari tabel dasar. Dengan indeks AlbumsByAlbumTitle2 baru, Spanner membaca kolom langsung dari indeks, yang lebih efisien.
Jika Anda menggunakan antarmuka baca, bukan SQL, indeks AlbumsByAlbumTitle2 yang baru juga memungkinkan Anda membaca kolom MarketingBudget secara langsung:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Mengubah indeks
Anda dapat menggunakan pernyataan ALTER INDEX untuk menambahkan kolom tambahan ke indeks yang ada atau menghapus kolom. Tindakan ini dapat memperbarui daftar kolom yang ditentukan oleh klausa STORING (database dialek GoogleSQL) atau klausa INCLUDE (database dialek PostgreSQL) saat Anda membuat indeks. Anda tidak dapat menggunakan pernyataan ini untuk menambahkan kolom ke atau menghapus kolom dari kunci indeks. Misalnya, daripada membuat indeks baru AlbumsByAlbumTitle2, Anda dapat menggunakan ALTER INDEX untuk menambahkan kolom ke AlbumsByAlbumTitle, seperti yang ditunjukkan dalam contoh berikut:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
Saat Anda menambahkan kolom baru ke indeks yang ada, Spanner
menggunakan proses pengisian ulang di latar belakang. Saat pengisian ulang sedang berlangsung, kolom dalam indeks tidak dapat dibaca, sehingga Anda mungkin tidak mendapatkan peningkatan performa yang diharapkan. Anda dapat menggunakan perintah gcloud spanner operations
untuk mencantumkan operasi yang berjalan lama dan melihat statusnya.
Untuk mengetahui informasi selengkapnya, lihat operasi describe.
Anda juga dapat menggunakan operasi pembatalan untuk membatalkan operasi yang sedang berjalan.
Setelah pengisian ulang selesai, Spanner akan menambahkan kolom ke dalam indeks. Seiring bertambahnya ukuran Indeks, hal ini dapat memperlambat kueri yang menggunakan indeks.
Contoh berikut menunjukkan cara menghapus kolom dari indeks:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
Indeks nilai NULL
Secara default, Spanner mengindeks nilai NULL. Misalnya, ingat kembali
definisi indeks SingersByFirstLastName pada tabel Singers:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Semua baris Singers diindeks meskipun FirstName atau LastName, atau keduanya, adalah NULL.
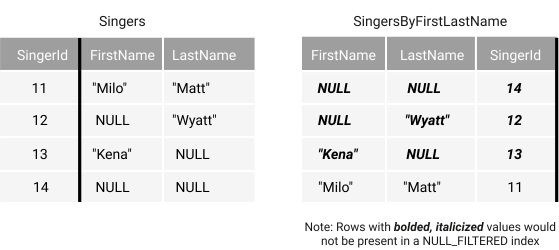
Saat nilai NULL diindeks, Anda dapat melakukan kueri SQL dan pembacaan yang efisien pada data yang menyertakan nilai NULL. Misalnya, gunakan pernyataan kueri SQL ini
untuk menemukan semua Singers dengan NULL FirstName:
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
Tata urutan untuk nilai NULL
Spanner mengurutkan NULL sebagai nilai terkecil untuk jenis tertentu. Untuk
kolom dalam urutan menaik (ASC), nilai NULL diurutkan terlebih dahulu. Untuk kolom dalam urutan menurun (DESC), nilai NULL diurutkan terakhir.
Menonaktifkan pengindeksan nilai NULL
GoogleSQL
Untuk menonaktifkan pengindeksan null, tambahkan kata kunci NULL_FILTERED ke definisi indeks. Indeks NULL_FILTERED sangat berguna untuk mengindeks kolom sparse, yang sebagian besar barisnya berisi nilai NULL. Dalam kasus ini, indeks NULL_FILTERED bisa jauh lebih kecil dan lebih efisien untuk dikelola daripada indeks normal yang menyertakan nilai NULL.
Berikut adalah definisi alternatif SingersByFirstLastName yang tidak mengindeks nilai NULL:
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
Kata kunci NULL_FILTERED berlaku untuk semua kolom kunci indeks. Anda tidak dapat menentukan pemfilteran NULL per kolom.
PostgreSQL
Untuk memfilter baris dengan nilai null di satu atau beberapa kolom yang diindeks, gunakan predikat WHERE COLUMN IS NOT NULL.
Indeks yang difilter null sangat berguna untuk mengindeks kolom sparse, di mana sebagian besar baris berisi nilai NULL. Dalam kasus ini, indeks yang difilter null bisa jauh lebih kecil dan lebih efisien untuk dikelola daripada indeks normal yang menyertakan nilai NULL.
Berikut adalah definisi alternatif SingersByFirstLastName yang tidak mengindeks nilai NULL:
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
Memfilter nilai NULL akan mencegah Spanner menggunakannya untuk beberapa kueri. Misalnya, Spanner tidak menggunakan indeks untuk kueri ini,
karena indeks menghilangkan baris Singers yang memiliki LastName bernilai NULL; akibatnya, penggunaan indeks akan mencegah kueri menampilkan baris yang benar:
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
Agar Spanner dapat menggunakan indeks, Anda harus menulis ulang kueri sehingga mengecualikan baris yang juga dikecualikan dari indeks:
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
Kolom proto indeks
Gunakan kolom yang dihasilkan untuk mengindeks kolom dalam buffering protokol yang disimpan di kolom PROTO, selama kolom yang diindeks menggunakan jenis data primitif atau ENUM.
Jika Anda menentukan indeks pada kolom pesan protokol, Anda tidak dapat mengubah atau menghapus kolom tersebut dari skema proto. Untuk mengetahui informasi selengkapnya, lihat Pembaruan pada skema yang berisi indeks pada kolom proto.
Berikut adalah contoh tabel Singers dengan kolom pesan proto SingerInfo. Untuk menentukan indeks pada kolom nationality dari PROTO, Anda perlu membuat kolom yang dihasilkan yang disimpan:
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
File ini memiliki definisi jenis proto googlesql.example.SingerInfo berikut:
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
Kemudian, tentukan indeks pada kolom nationality proto:
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
Kueri SQL berikut membaca data menggunakan indeks sebelumnya:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
Catatan:
- Gunakan perintah indeks untuk mengakses indeks pada kolom buffering protokol.
- Anda tidak dapat membuat indeks pada kolom buffering protokol berulang.
Pembaruan pada skema yang berisi indeks pada kolom proto
Jika Anda menentukan indeks pada kolom pesan protokol, Anda tidak dapat mengubah atau menghapus kolom tersebut dari skema proto. Hal ini karena setelah Anda menentukan indeks, pemeriksaan jenis dilakukan setiap kali skema diperbarui. Spanner menangkap informasi jenis untuk semua kolom di jalur yang digunakan dalam definisi indeks.
Indeks unik
Indeks dapat dideklarasikan UNIQUE. Indeks UNIQUE menambahkan batasan pada data yang diindeks yang melarang entri duplikat untuk kunci indeks tertentu.
Batasan ini diterapkan oleh Spanner pada waktu commit transaksi.
Secara khusus, setiap transaksi yang akan menyebabkan beberapa entri indeks untuk kunci yang sama akan gagal di-commit.
Jika tabel berisi data non-UNIQUE sejak awal, upaya untuk membuat indeks UNIQUE di dalamnya akan gagal.
Catatan tentang indeks UNIQUE NULL_FILTERED
Indeks UNIQUE NULL_FILTERED tidak menerapkan keunikan kunci indeks jika setidaknya salah satu bagian kunci indeks adalah NULL.
Misalnya, Anda membuat tabel dan indeks berikut:
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
Dua baris berikut di ExampleTable memiliki nilai yang sama untuk kunci indeks sekunder Key1, Key2, dan Col1:
1, NULL, 1, 1
1, NULL, 2, 1
Karena Key2 adalah NULL dan indeks difilter null, baris tidak akan ada dalam indeks ExampleIndex. Karena tidak dimasukkan ke dalam indeks, indeks tidak akan menolaknya karena melanggar keunikan pada (Key1, Key2,
Col1).
Jika Anda ingin indeks menerapkan keunikan nilai tuple (Key1,
Key2, Col1), Anda harus menganotasi Key2 dengan NOT NULL dalam definisi
tabel atau membuat indeks tanpa memfilter null.
Membuat indeks berdasarkan ekspresi skalar
Indeks ekspresi memungkinkan Anda membuat indeks berdasarkan ekspresi skalar yang berlaku untuk satu atau beberapa kolom tabel. Hal ini bermanfaat karena menghilangkan kebutuhan untuk membuat dan mengelola kolom yang dihasilkan khusus dalam tabel Anda hanya untuk tujuan pengindeksan.
Indeks pada kolom yang dihasilkan dan indeks ekspresi dapat berguna untuk mengindeks kolom tertentu dalam kolom JSON. Anda dapat membuat indeks pada nilai yang diekstrak dari objek JSON, sehingga pengoptimal kueri dapat melakukan pencarian secara efisien berdasarkan nilai tersebut.
Dalam contoh ini, kolom yang dihasilkan bernama VenueCity, yang didasarkan pada kolom city dalam JSON, dibuat semata-mata untuk tujuan menempatkannya dalam indeks:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
Untuk mencapai hal ini secara lebih efisien, Anda dapat menentukan indeks secara langsung, dan Spanner akan menangani mekanisme yang mendasarinya secara implisit:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
Dalam kedua kasus tersebut, kueri Anda dapat menggunakan indeks VenuesByCity untuk eksekusi yang lebih cepat:
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
Indeks Ekspresi dapat memiliki kolom yang merupakan campuran ekspresi dan referensi kolom langsung. Hal ini memungkinkan lebih banyak kueri menggunakan indeks untuk eksekusi yang lebih cepat.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
Menghapus indeks
Gunakan pernyataan DROP INDEX untuk menghapus indeks sekunder dari skema Anda.
Untuk menghapus indeks bernama SingersByFirstLastName:
DROP INDEX SingersByFirstLastName;
Indeks untuk pemindaian yang lebih cepat
Saat Spanner perlu melakukan pemindaian tabel (bukan pencarian terindeks) untuk mengambil nilai dari satu atau beberapa kolom, Anda dapat menerima hasil yang lebih cepat jika ada indeks untuk kolom tersebut, dan dalam urutan yang ditentukan oleh kueri. Jika Anda sering melakukan kueri yang memerlukan pemindaian, pertimbangkan untuk membuat indeks sekunder guna membantu pemindaian ini terjadi secara lebih efisien.
Secara khusus, jika Anda memerlukan Spanner untuk sering memindai kunci utama tabel atau indeks lainnya dalam urutan terbalik, Anda dapat meningkatkan efisiensinya melalui indeks sekunder yang membuat urutan yang dipilih menjadi eksplisit.
Misalnya, kueri berikut selalu menampilkan hasil yang cepat, meskipun
Spanner perlu memindai Songs untuk menemukan nilai terendah
SongId:
SELECT SongId FROM Songs LIMIT 1;
SongId adalah kunci utama tabel, yang disimpan (seperti semua kunci utama) dalam urutan menaik. Spanner dapat memindai indeks kunci tersebut dan menemukan hasil pertama dengan cepat.
Namun, tanpa bantuan indeks sekunder, kueri berikut tidak akan ditampilkan secepat itu, terutama jika Songs menyimpan banyak data:
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
Meskipun SongId adalah kunci utama tabel, Spanner tidak dapat mengambil nilai tertinggi kolom tanpa melakukan pemindaian tabel lengkap.
Menambahkan indeks berikut akan memungkinkan kueri ini ditampilkan lebih cepat:
CREATE INDEX SongIdDesc On Songs(SongId DESC);
Dengan adanya indeks ini, Spanner akan menggunakannya untuk menampilkan hasil kueri kedua dengan jauh lebih cepat.
Langkah berikutnya
- Pelajari praktik terbaik SQL untuk Spanner.
- Pahami rencana eksekusi kueri untuk Spanner.
- Cari tahu cara memecahkan masalah regresi performa dalam kueri SQL.