


Ringkasan
Halaman ini menjelaskan konsep di balik rencana eksekusi kueri dan cara Spanner menggunakannya untuk menjalankan kueri di lingkungan terdistribusi. Untuk mempelajari cara mengambil rencana eksekusi untuk kueri tertentu menggunakan konsolGoogle Cloud , lihat Memahami cara Spanner menjalankan kueri. Anda juga dapat melihat sampel rencana kueri historis untuk membandingkan performa kueri dari waktu ke waktu. Untuk mempelajari lebih lanjut, lihat Rencana kueri yang diambil sampelnya.
Spanner menggunakan pernyataan SQL deklaratif untuk mengkueri databasenya. Pernyataan SQL menentukan apa yang diinginkan pengguna tanpa menentukan cara mendapatkan hasilnya. Rencana eksekusi kueri adalah serangkaian langkah untuk mendapatkan hasil. Untuk pernyataan SQL tertentu, mungkin ada beberapa cara untuk mendapatkan hasilnya. Pengoptimal kueri Spanner mengevaluasi berbagai rencana eksekusi dan memilih yang paling efisien. Spanner kemudian menggunakan rencana eksekusi untuk mengambil hasilnya. Rencana eksekusi mendukung database dialek GoogleSQL dan database dialek PostgreSQL.
Untuk mengetahui informasi selengkapnya tentang pengoptimal kueri, lihat Ringkasan pengoptimal kueri.
Secara konseptual, rencana eksekusi adalah hierarki operator relasional. Setiap operator membaca baris dari inputnya dan menghasilkan baris output. Hasil operator di root eksekusi ditampilkan sebagai hasil kueri SQL.
Sebagai contoh, perhatikan kueri berikut:
SELECT s.SongName FROM Songs AS s;
Kueri ini menghasilkan rencana eksekusi kueri yang dapat divisualisasikan sebagai:
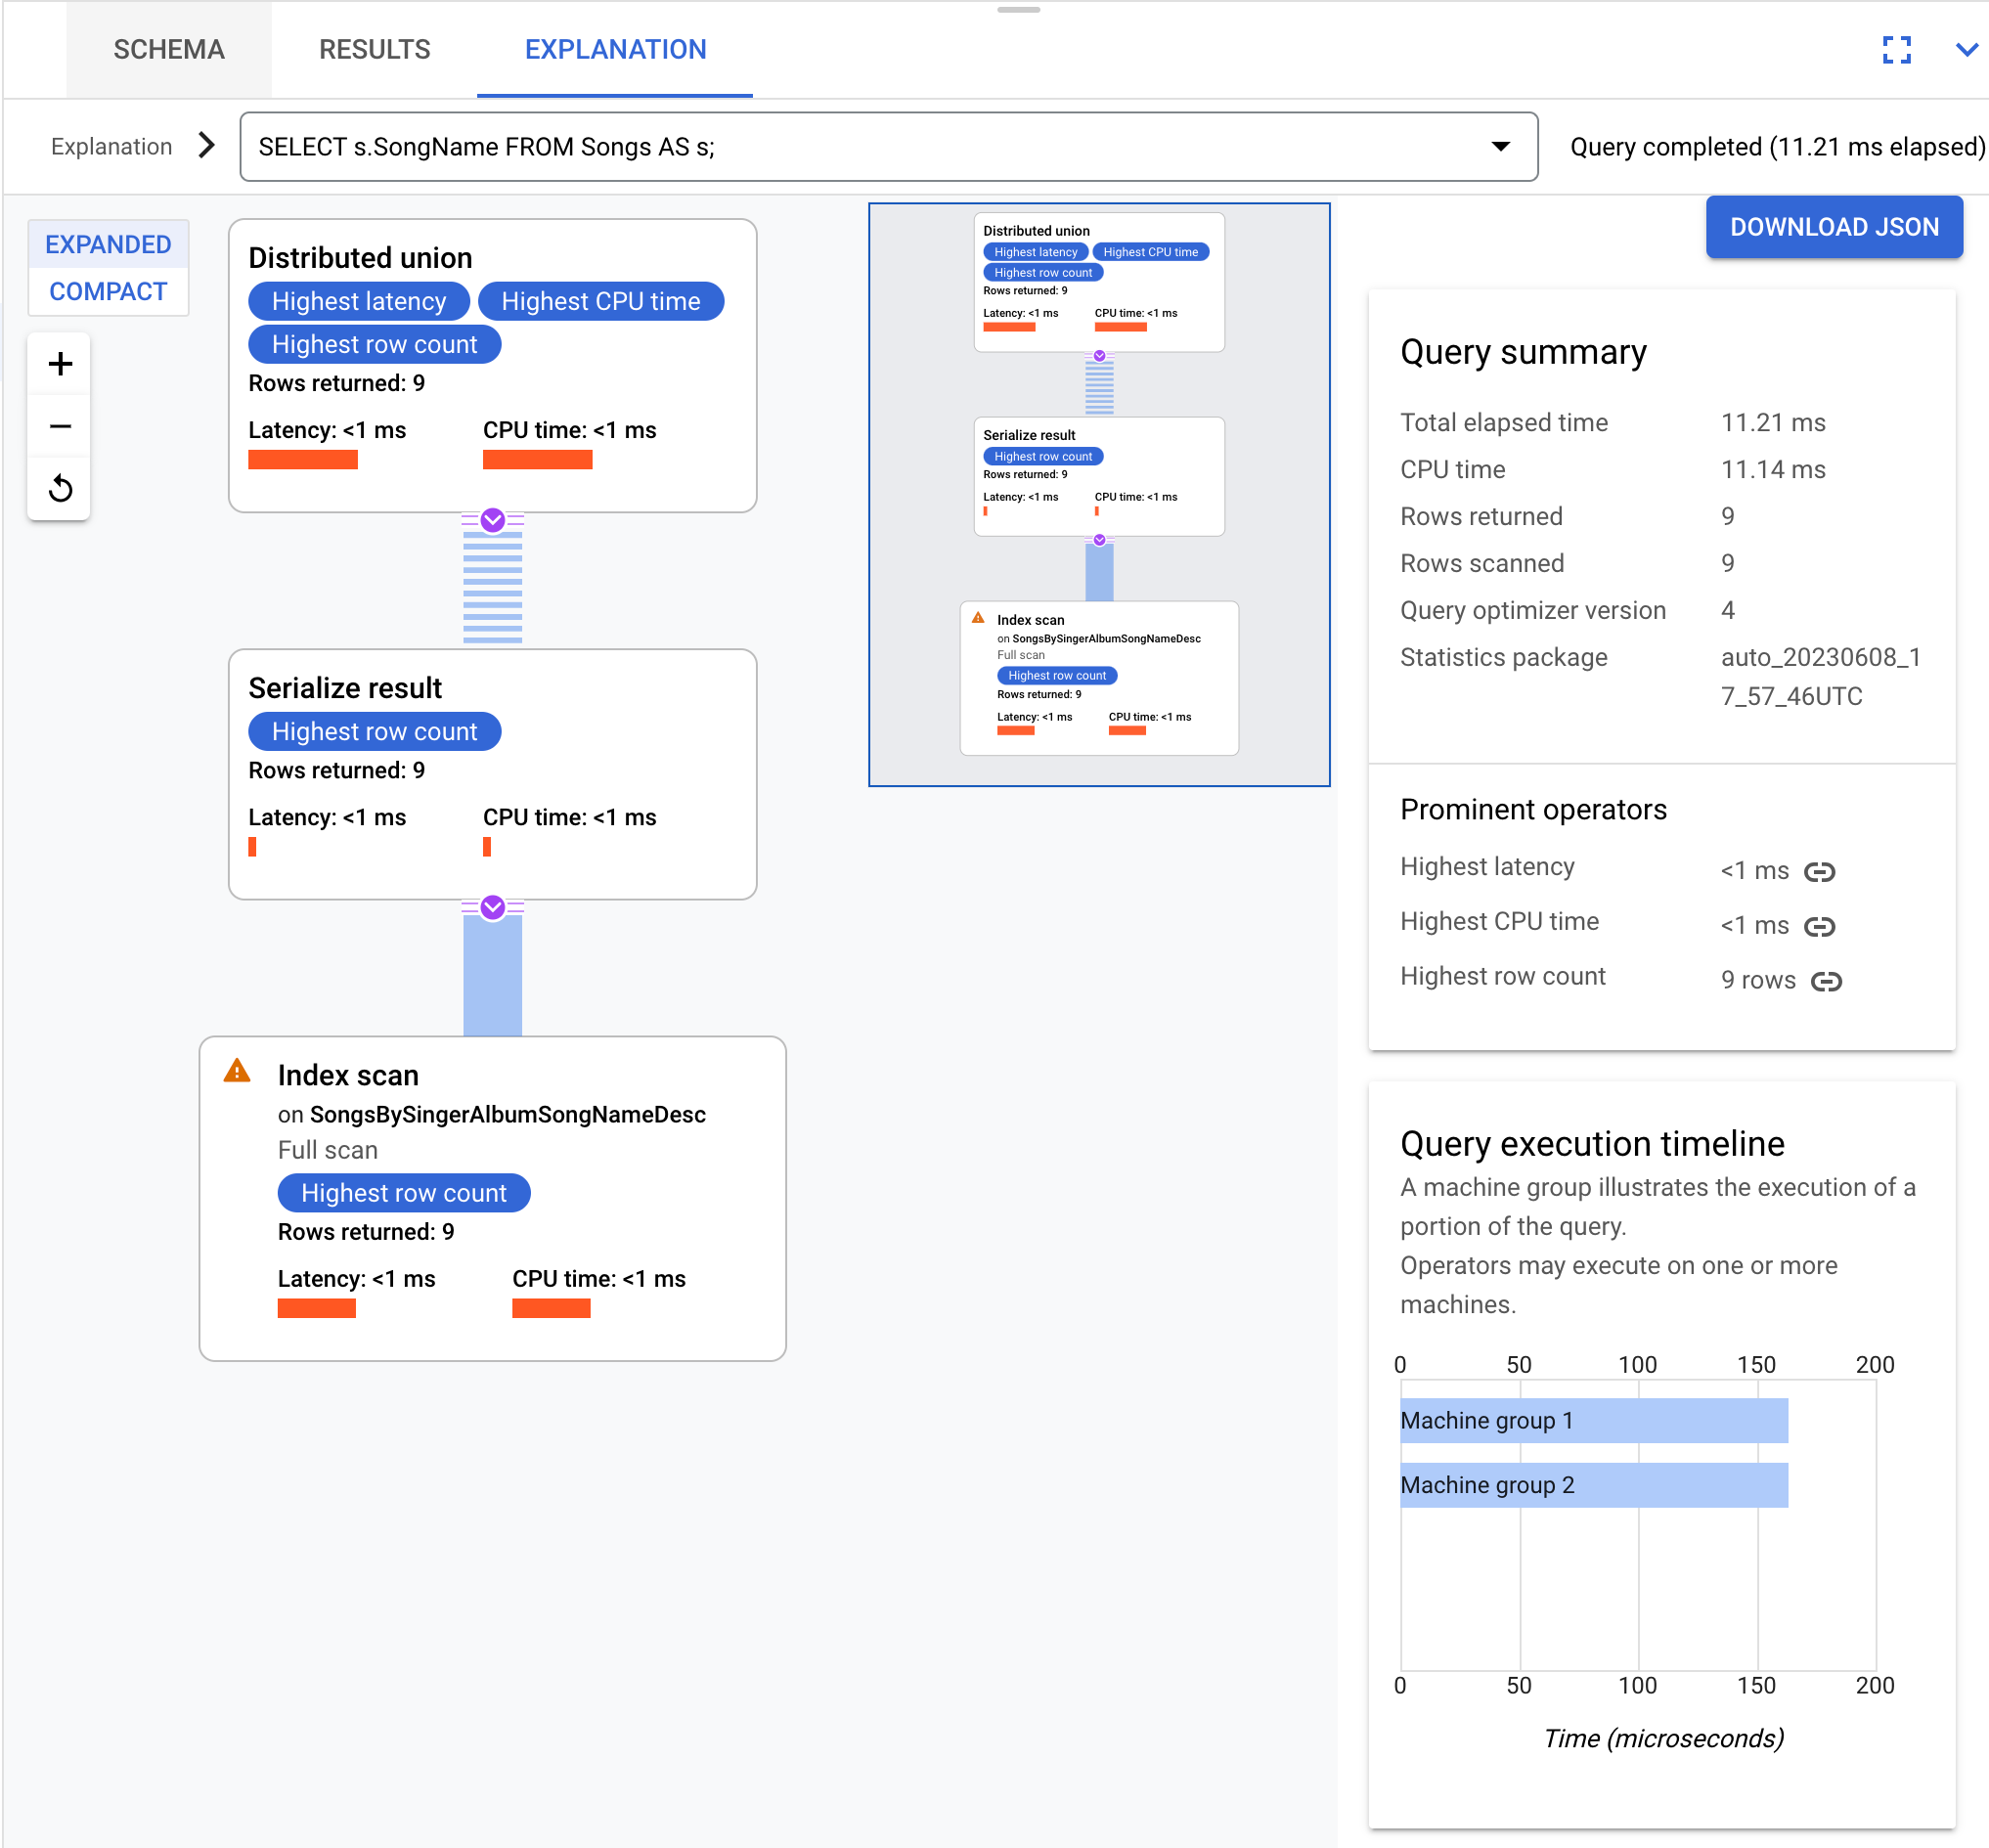
Dalam contoh ini, Spanner menjalankan rencana kueri dari atas ke bawah, dan data mengalir dari bawah ke atas. Operator
distributed union
dijalankan terlebih dahulu. Garis biru putus-putus menunjukkan bahwa operator ini dapat
melakukan panggilan jarak jauh. Baik secara lokal maupun jarak jauh, tindakan ini akan memanggil operator
serialize result
dan melanjutkan ke bawah hierarki. Saat operator table scan menghasilkan baris, operator tersebut akan segera mengembalikan kontrol ke operator serialize result. Proses ini
berlanjut hingga kueri memindai semua baris.
Kueri dan rencana eksekusi di halaman ini didasarkan pada skema database berikut:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Anda dapat menggunakan pernyataan Bahasa Pengolahan Data (DML) berikut untuk menambahkan data ke tabel ini:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Mendapatkan rencana eksekusi yang efisien merupakan tantangan karena Spanner membagi data menjadi pemisahan. Pemisahan dapat berpindah secara independen satu sama lain, dan Spanner dapat menetapkannya ke server yang berbeda, yang mungkin berada di lokasi fisik yang berbeda. Untuk mengevaluasi rencana eksekusi atas data terdistribusi, Spanner melakukan tugas-tugas berikut:
- Menjalankan subrencana secara lokal di server yang menyimpan data.
- Mengorkestrasi dan menggabungkan beberapa eksekusi jarak jauh dengan pemangkasan distribusi yang agresif.
Untuk mengaktifkan model ini, Spanner menggunakan operator
distributed union, bersama dengan varian
distributed cross apply
dan
distributed outer apply.
Cara Spanner menjalankan kueri
Secara konseptual, alur eksekusi kueri berjalan dari atas ke bawah, dan hasil kueri berjalan dari bawah ke atas. Diagram berikut menunjukkan pola ini:
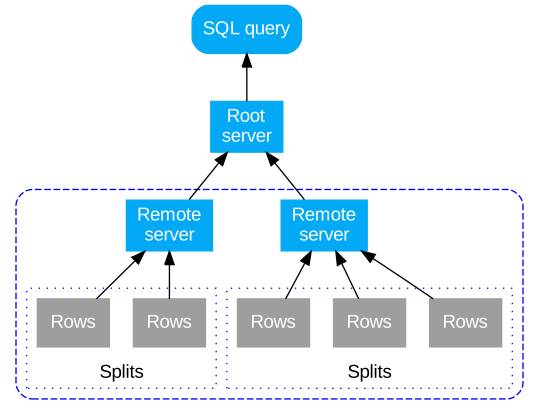
Spanner mengompilasi kueri SQL menjadi rencana eksekusi. Untuk meminimalkan jumlah hop ke data yang dikueri, Spanner memilih server root awal dan mengirimkan rencana ke server ini. Server root melakukan tindakan berikut:
- Memulai eksekusi sub-rencana jarak jauh, jika diperlukan.
- Menunggu hasil dari eksekusi jarak jauh.
- Menangani langkah eksekusi lokal yang tersisa, seperti mengagregasi hasil.
- Menampilkan hasil kueri.
Server jarak jauh yang menerima sub-rencana bertindak sebagai server root untuk sub-rencananya, mengikuti model yang sama dengan server root teratas. Model eksekusi ini menghasilkan hierarki eksekusi jarak jauh.
Metrik performa utama
Visualizer rencana kueri Spanner Studio menampilkan metrik ringkasan untuk eksekusi kueri. Metrik ringkasan mewakili gabungan metrik dari semua operator individual yang dieksekusi selama kueri. Tabel berikut menjelaskan metrik performa utama:
| Metrik | Deskripsi |
|---|---|
| Total waktu berlalu | Total waktu aktual yang diperlukan untuk menjalankan kueri. |
| Waktu CPU | Jumlah total waktu CPU yang dihabiskan di semua server yang terlibat dalam menjalankan kueri. Karena beberapa bagian eksekusi kueri dapat berjalan secara paralel, waktu CPU dapat lebih besar daripada total waktu yang berlalu. |
Rencana kueri yang dijadikan sampel
Rencana kueri sampel Spanner memungkinkan Anda melihat sampel rencana kueri historis dan membandingkan performa kueri dari waktu ke waktu. Rencana kueri yang diambil sampelnya tidak tersedia untuk semua kueri. Spanner mungkin hanya mengambil sampel kueri yang menggunakan CPU secara signifikan. Spanner menyimpan sampel rencana kueri selama 30 hari. Untuk menemukan sampel rencana kueri di halaman Query Insights di konsolGoogle Cloud , lihat Melihat sampel rencana kueri.
Anatomi contoh paket kueri sama dengan rencana eksekusi kueri reguler. Untuk mengetahui informasi selengkapnya tentang cara memahami rencana visual dan menggunakannya untuk men-debug kueri, lihat Tur visualizer rencana kueri.
Kasus penggunaan umum untuk rencana kueri yang diambil sampelnya
Kasus penggunaan umum untuk rencana kueri sampel mencakup hal berikut:
- Mengamati perubahan rencana kueri karena perubahan skema (misalnya, menambahkan atau menghapus indeks).
- Mengamati perubahan rencana kueri karena update versi pengoptimal.
- Mengamati perubahan rencana kueri karena statistik pengoptimal baru.
Spanner mengumpulkan statistik ini secara otomatis setiap tiga hari, atau Anda dapat memperbaruinya secara manual menggunakan perintah
ANALYZE.
Jika performa kueri bervariasi secara signifikan dari waktu ke waktu, atau jika Anda ingin meningkatkan performa, lihat praktik terbaik SQL untuk membuat pernyataan kueri yang dioptimalkan yang membantu Spanner menemukan rencana eksekusi yang efisien.
Pola umum
Contoh berikut mengilustrasikan pola umum dalam rencana eksekusi Spanner.
Kueri gabungan
Kueri agregat menerapkan logika GROUP BY.
Misalnya, kueri berikut menghitung jumlah lagu berdasarkan penyanyi:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
Berikut hasilnya:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
Secara konseptual, ini adalah rencana eksekusi:
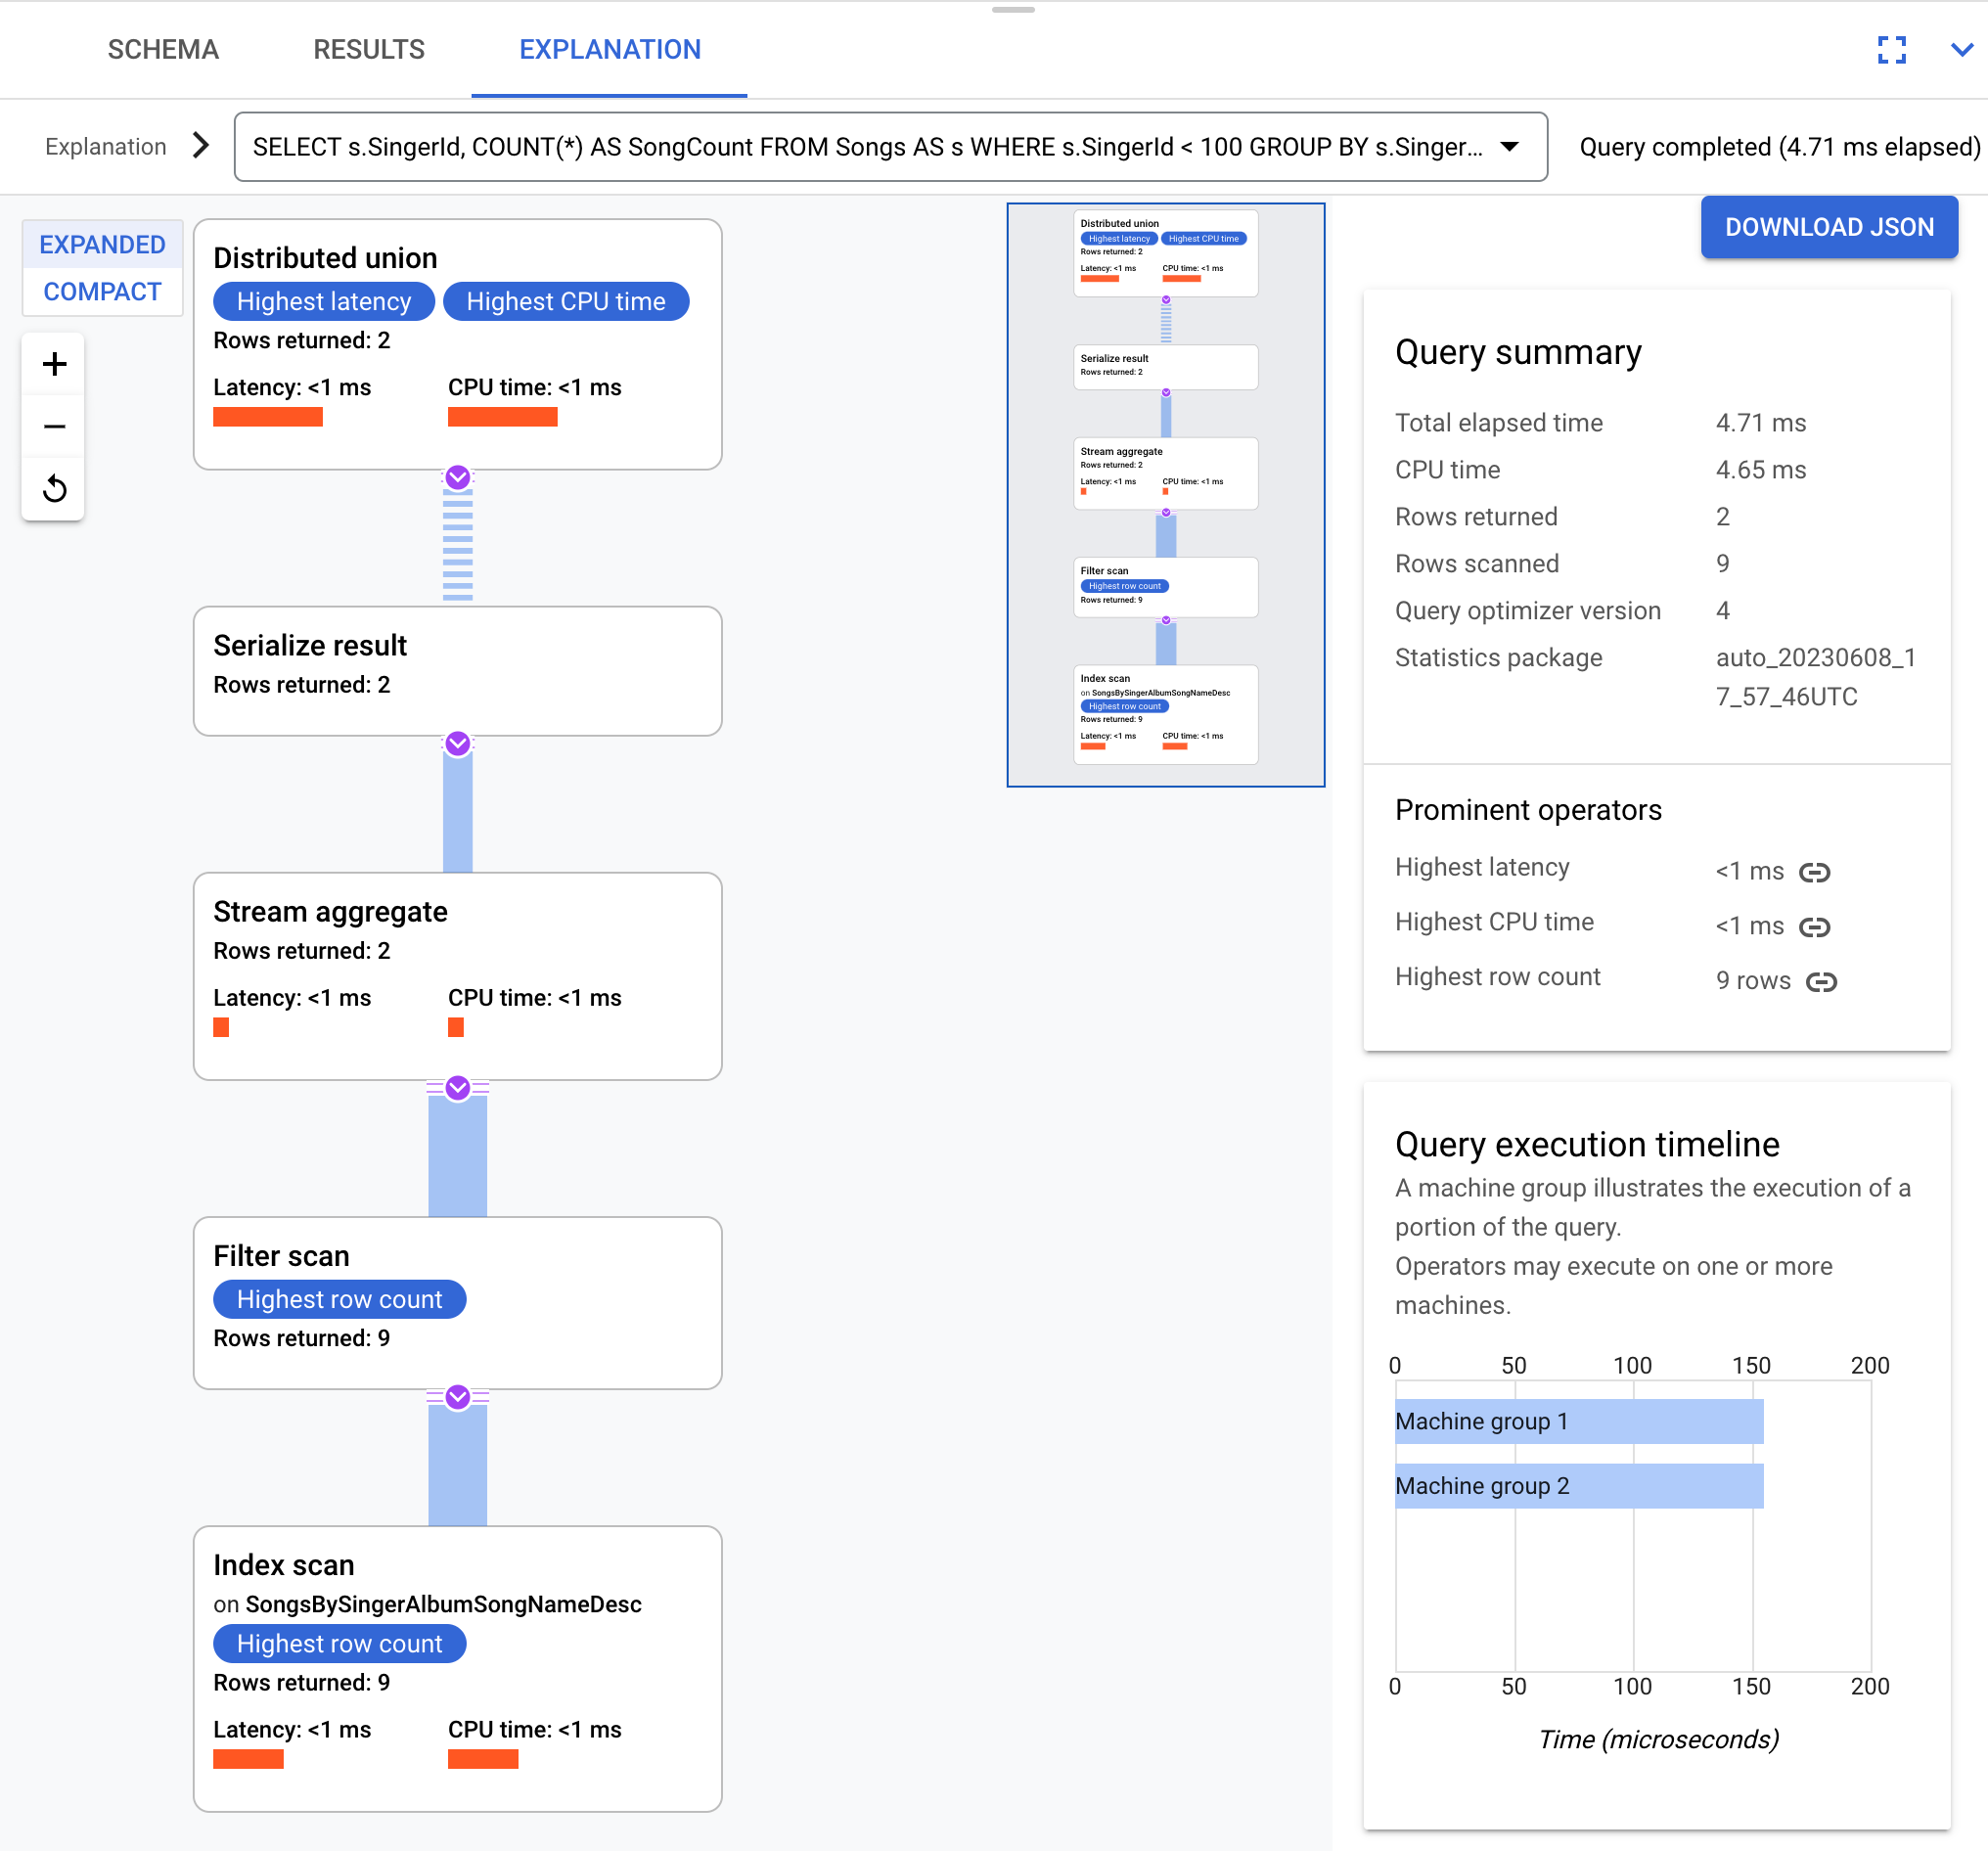
Spanner mengirimkan rencana eksekusi ke server root yang mengoordinasikan eksekusi kueri dan mendistribusikan sub-rencana dari jarak jauh.
Rencana eksekusi ini dimulai dengan operator distributed union yang mendistribusikan sub-rencana ke server jarak jauh yang pemisahannya memenuhi SingerId < 100. Setelah pemindaian pada setiap pemisahan selesai, operator stream aggregate menggabungkan baris untuk mendapatkan jumlah untuk setiap SingerId. Operator serialize result kemudian
melakukan serialisasi pada hasilnya. Terakhir, distributed union menggabungkan semua hasil dan
menampilkan hasil kueri.
Untuk mengetahui informasi selengkapnya tentang agregat, lihat Operator agregat.
Kueri gabungan yang ditempatkan bersama
Dalam tabel yang disisipkan, Spanner menyimpan baris terkait secara fisik bersama-sama. Penggabungan yang ditempatkan bersama adalah penggabungan antara tabel yang disisipkan. Penggabungan yang ditempatkan bersama dapat meningkatkan performa dibandingkan dengan penggabungan yang memerlukan indeks atau penggabungan kembali.
Misalnya, pertimbangkan kueri berikut:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
Kueri ini mengasumsikan bahwa Songs disisipkan di Albums.
Berikut hasilnya:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
Berikut adalah rencana eksekusi:
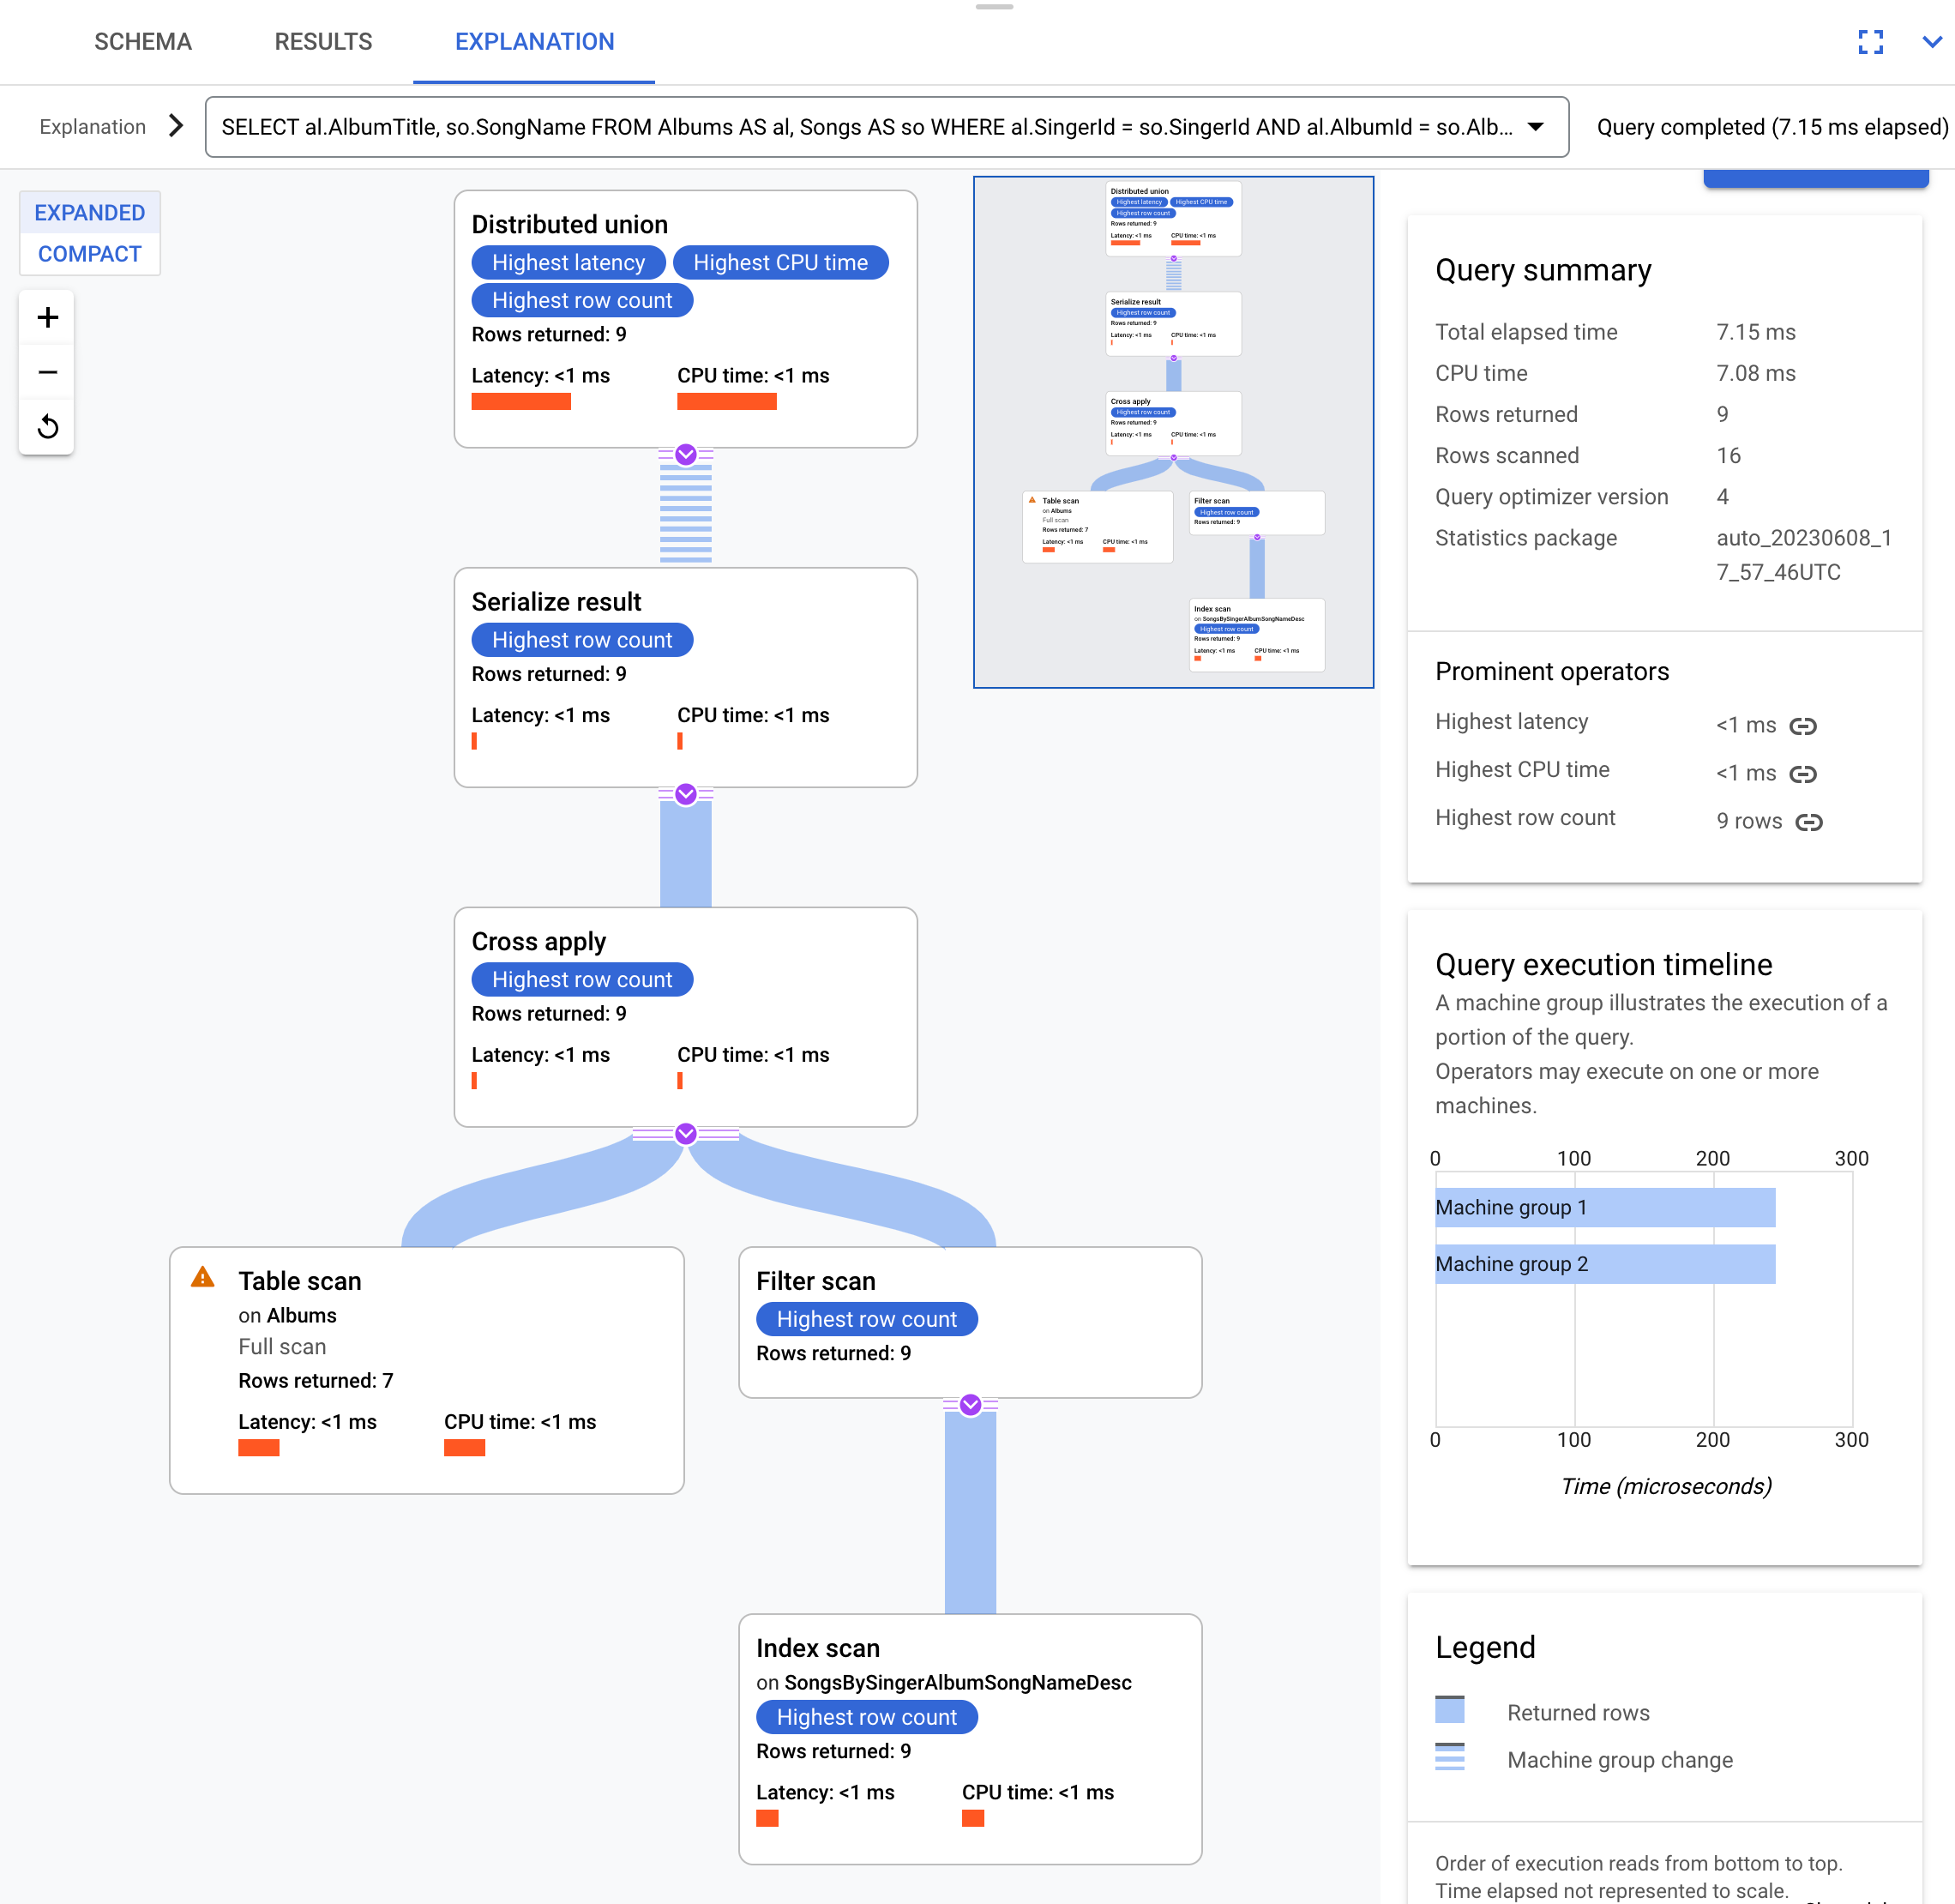
Rencana eksekusi ini dimulai dengan operator distributed union yang mendistribusikan sub-rencana ke server jarak jauh, yang berisi pemisahan tabel Albums. Karena
Songs disisipkan di Albums, setiap server jarak jauh menjalankan seluruh
sub-rencana secara lokal tanpa melakukan penggabungan di berbagai server.
Sub-rencana berisi operator cross apply. Setiap operator cross apply
melakukan
table scan pada tabel Albums untuk mengambil SingerId, AlbumId, dan
AlbumTitle. Operator cross apply kemudian memetakan output dari pemindaian tabel
ke output dari pemindaian indeks pada indeks SongsBySingerAlbumSongNameDesc.
Indeks ini tunduk pada filter, yang mengharuskan SingerId dalam indeks cocok dengan SingerId dari output pemindaian tabel. Setiap operator cross apply mengirimkan
hasilnya ke operator serialize result, yang melakukan serialisasi pada
data AlbumTitle dan SongName serta menampilkan hasilnya ke union
terdistribusi lokal. Union terdistribusi mengagregasi hasil dari union terdistribusi lokal dan menampilkannya sebagai hasil kueri.
Kueri indeks dan gabungan balik
Contoh sebelumnya menggunakan join pada dua tabel, dengan satu tabel disisipkan di tabel lainnya. Jika dua tabel, atau tabel dan indeks, tidak saling terkait, rencana eksekusi akan lebih kompleks dan kurang efisien.
Pertimbangkan indeks yang dibuat dengan perintah berikut:
CREATE INDEX SongsBySongName ON Songs(SongName);
Untuk menggunakan indeks ini dalam kueri, pilih salah satu opsi dialek database berikut:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Berikut hasilnya:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
Berikut adalah rencana eksekusi:
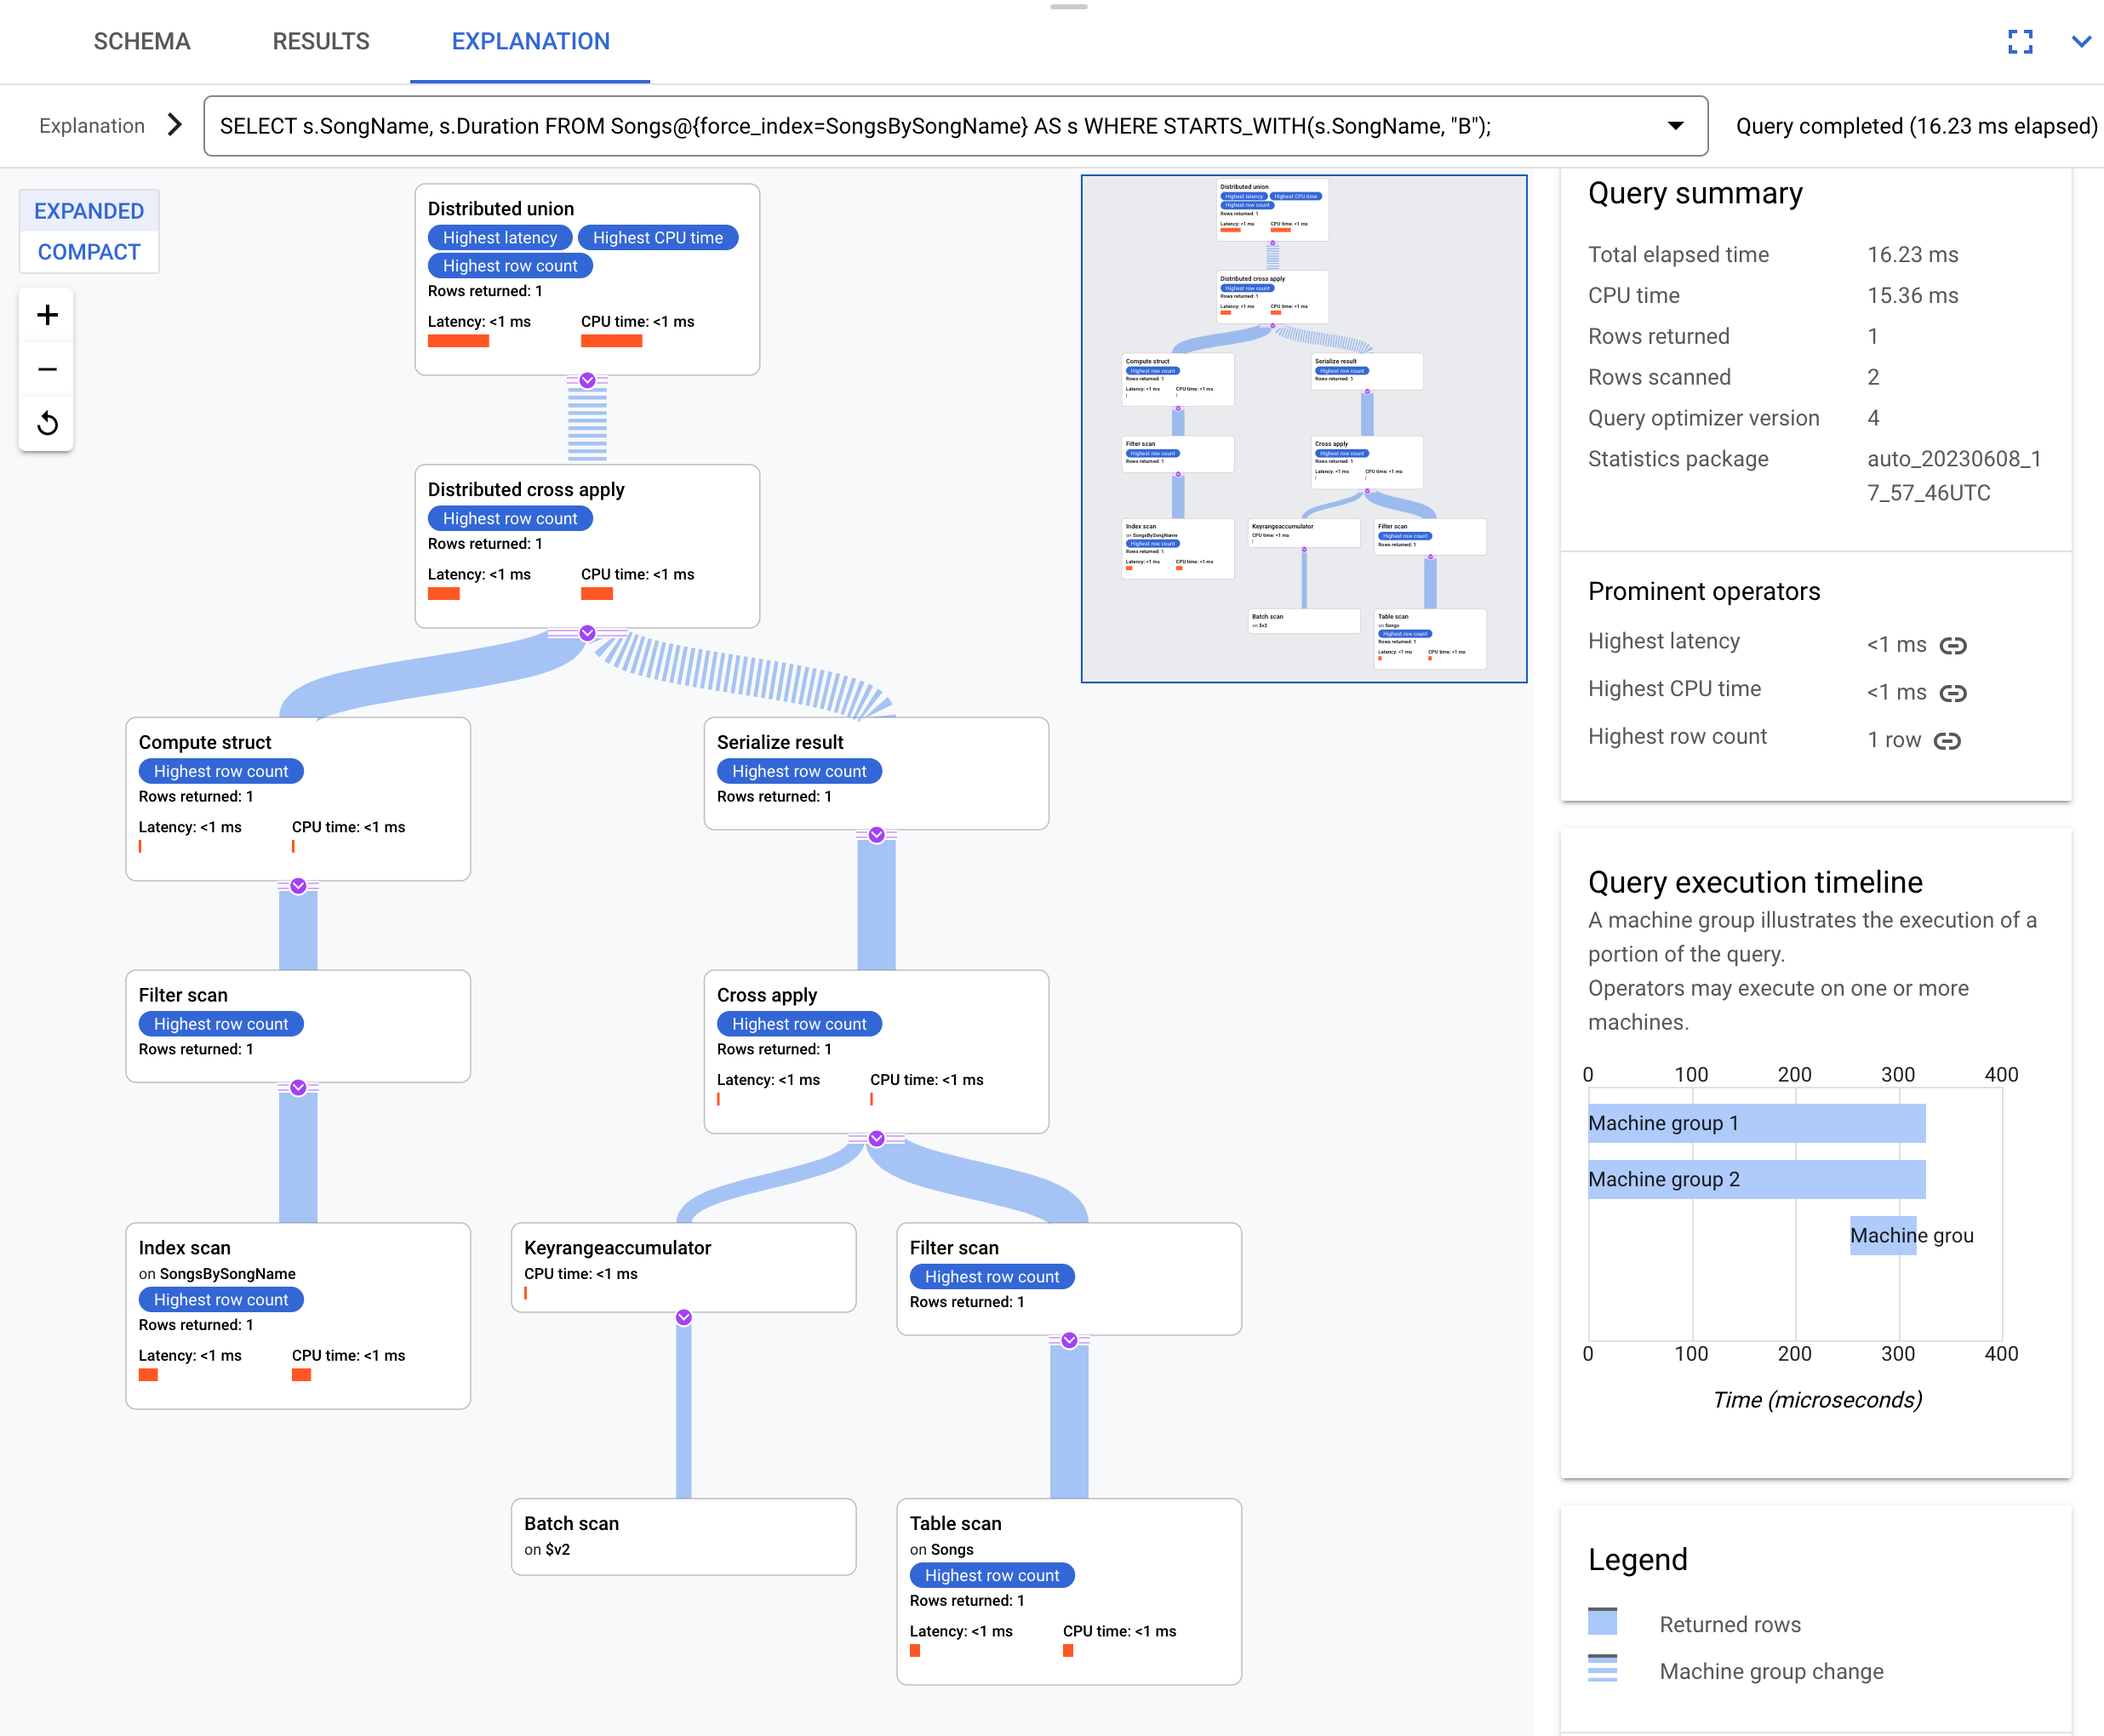
Rencana eksekusi yang dihasilkan rumit karena indeks SongsBySongName tidak berisi kolom Duration. Untuk mendapatkan nilai Duration,
Spanner menggabungkan kembali hasil yang diindeks ke tabel
Songs. Ini adalah join, tetapi tidak ditempatkan bersama karena tabel Songs dan
indeks global SongsBySongName tidak disisipkan. Jika data tidak ditempatkan bersama, Spanner akan melakukan pengoptimalan untuk mempercepat eksekusi. Pengoptimalan ini membuat rencana eksekusi menjadi lebih kompleks daripada contoh join yang ditempatkan bersama sebelumnya.
Operator teratas adalah distributed cross apply. Sisi input operator ini menerima batch baris dari indeks SongsBySongName yang memenuhi predikat STARTS_WITH(s.SongName, "B"). Operator distributed cross apply
kemudian memetakan batch ini ke server jarak jauh yang berisi pemisahan dengan
data Duration. Untuk mengambil kolom Duration, server jarak jauh melakukan pemindaian tabel. Pemindaian ini menggunakan kondisi filter Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId), yang menggabungkan TrackId dari tabel Songs ke kolom TrackId dari baris yang dikelompokkan dari indeks SongsBySongName.
Spanner menggabungkan hasil menjadi jawaban kueri akhir.
Pada gilirannya, sisi input operator distributed cross apply berisi pasangan distributed union atau local distributed union untuk mengevaluasi baris dari indeks yang memenuhi predikat STARTS_WITH.
Pertimbangkan kueri yang sedikit berbeda yang tidak memilih kolom s.Duration:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Rencana eksekusi berikut menunjukkan bahwa kueri ini sepenuhnya menggunakan indeks:
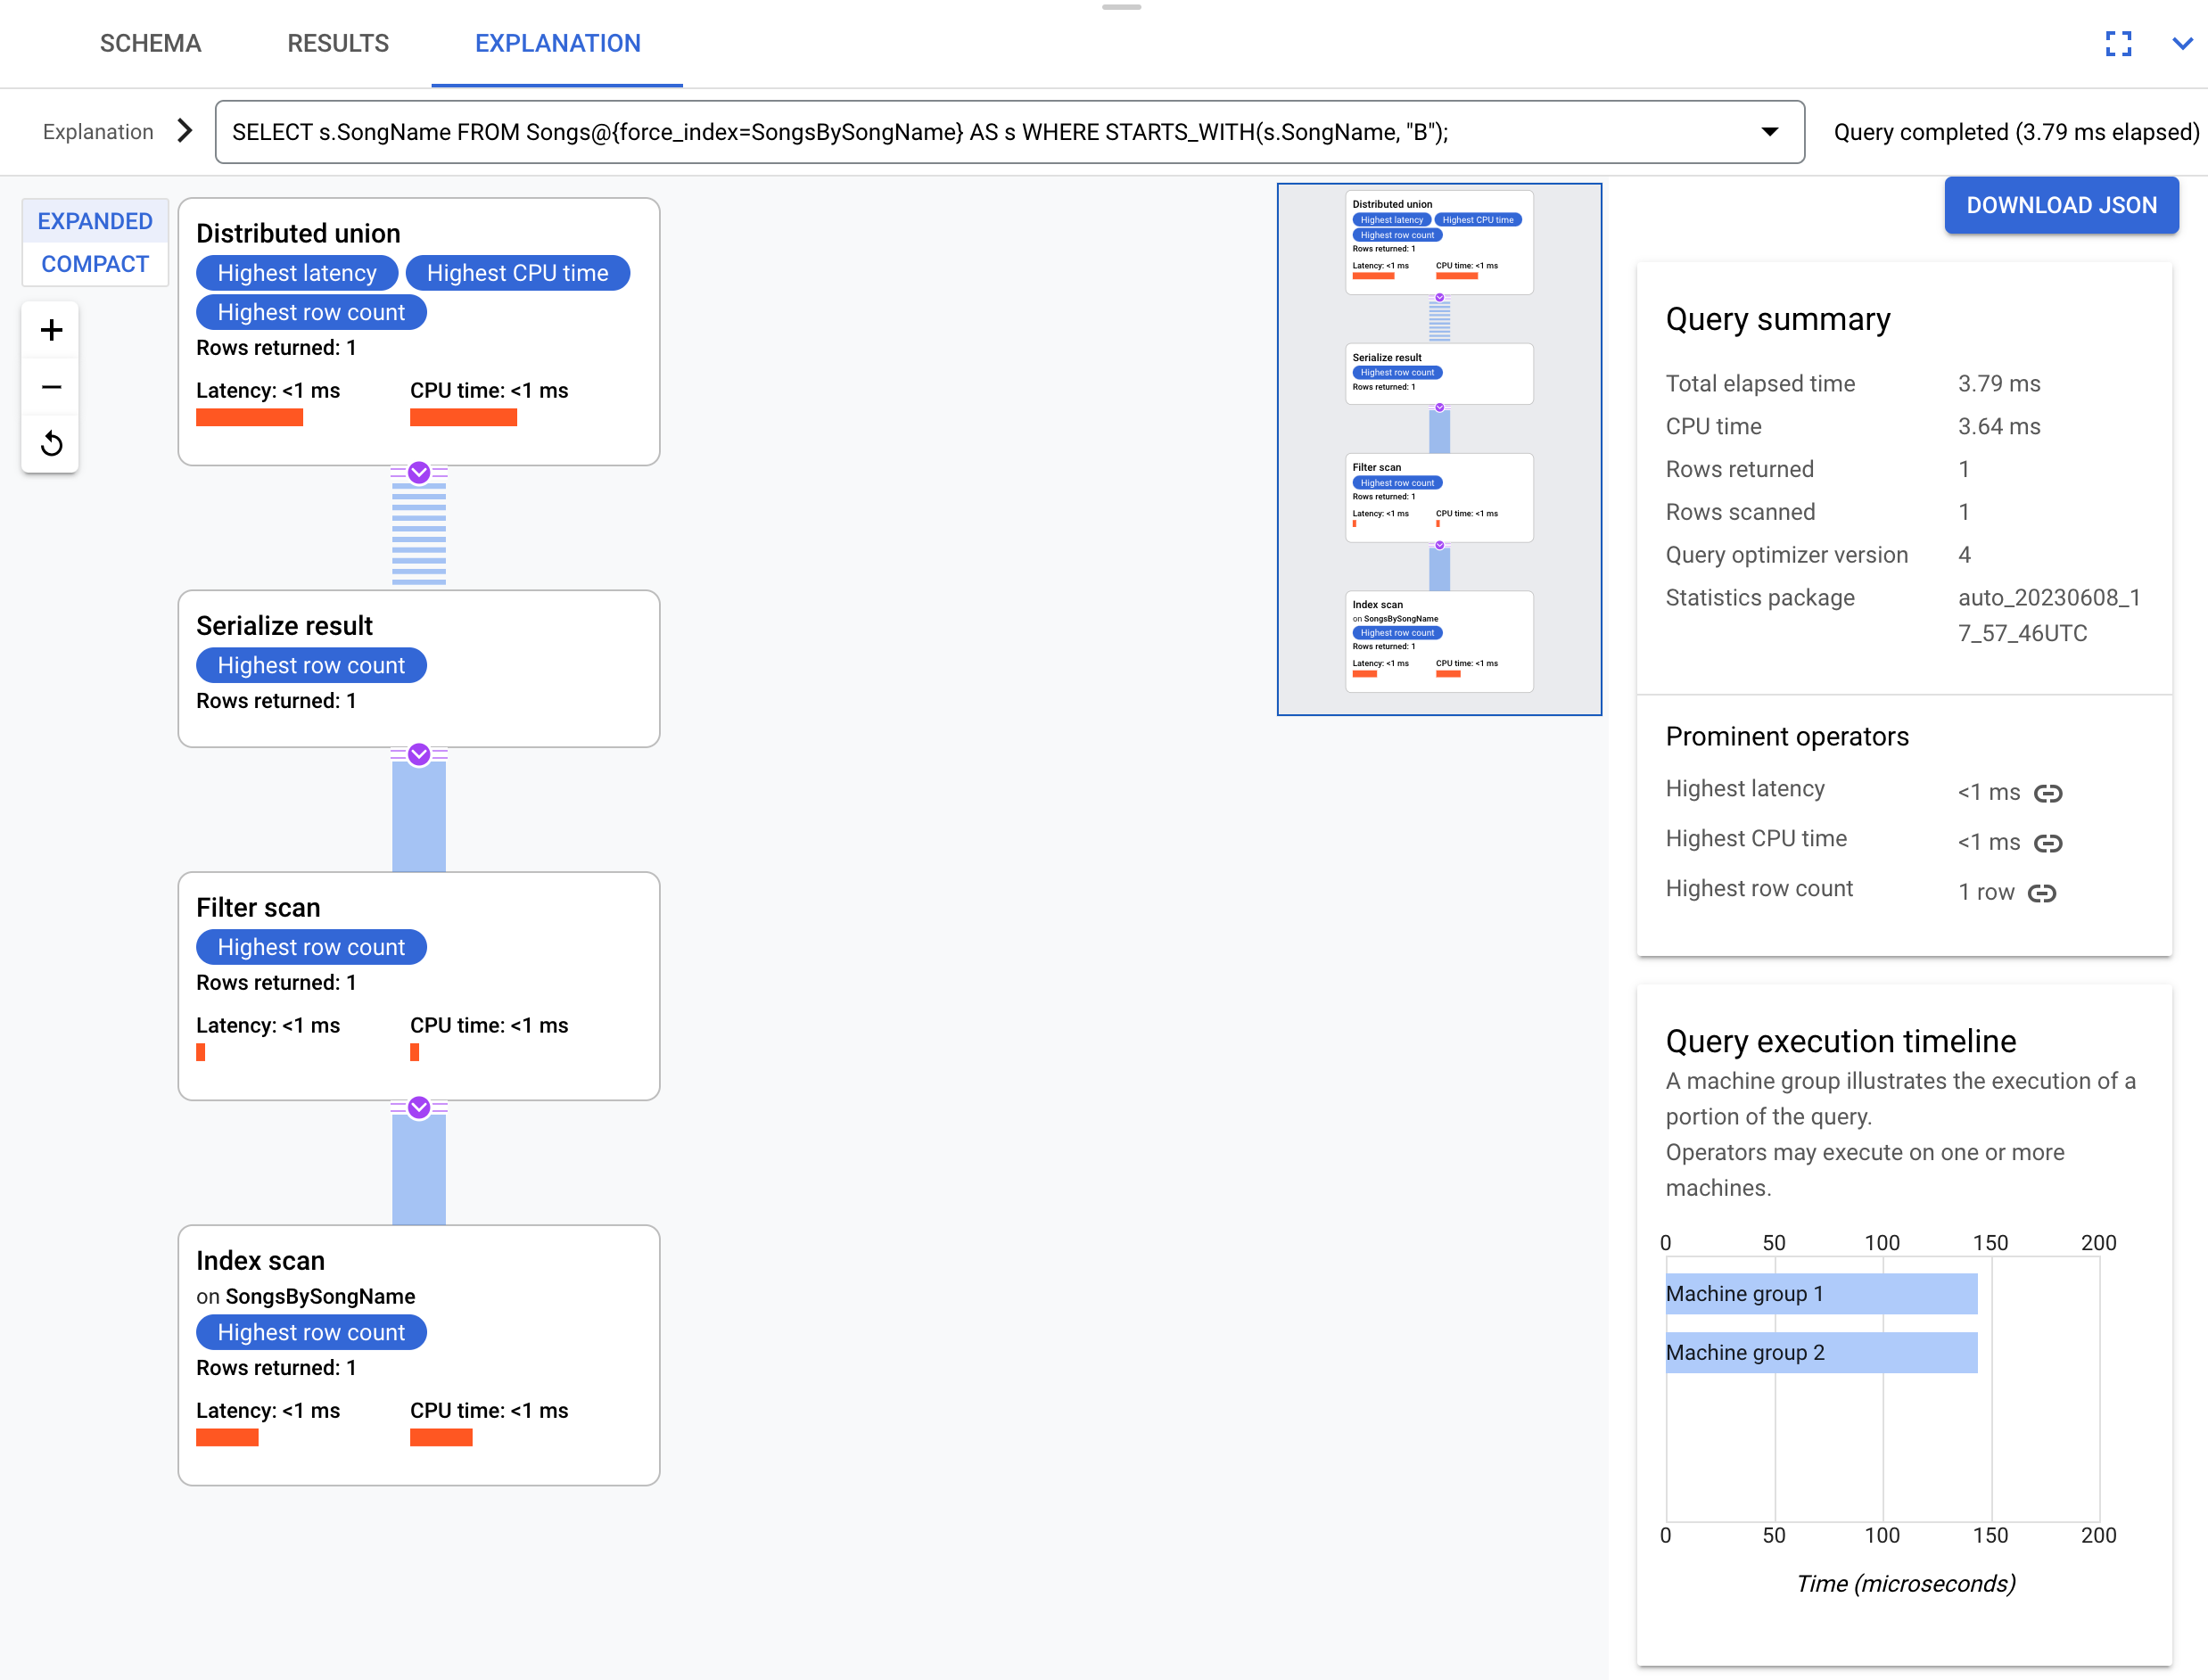
Rencana eksekusi tidak memerlukan back join karena indeks berisi semua kolom yang diminta kueri.
Pemindaian berurutan versus pencarian tersebar
Membaca rentang baris yang berdekatan jauh lebih cepat daripada membaca jumlah baris yang tersebar yang sama.
Misalnya, kueri berikut menjumlahkan durasi lagu dari sekumpulan penyanyi tertentu. Kueri ini melakukan pencarian untuk setiap ID penyanyi yang ditentukan. Untuk melihat jumlah pencarian yang dilakukan kueri, lihat statistik Seek count.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
Namun, jika Anda menyusun kueri untuk membaca urutan ID penyanyi yang berurutan, Anda dapat meningkatkan performa dengan melakukan pembacaan berurutan pada tabel Songs. Tabel Songs berisi SingerId sebagai bagian dari kunci utamanya.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
Perbedaan ini relevan saat Anda memilih metode penggabungan dan saat Anda membuat keputusan desain skema, seperti memilih kunci utama. Untuk mengetahui informasi selengkapnya tentang cara memilih metode join, lihat Cara join berinteraksi dengan pemindaian.
Membagikan gabungan terdistribusi
Setiap tabel atau indeks dalam kueri harus memiliki operator terdistribusi yang sesuai.
Operator ini berupa distributed union atau distributed apply. Jika dua
tabel atau indeks disisipkan di induk yang sama, pengoptimal kueri
mungkin menggunakan satu operator distributed union untuk kedua tabel atau indeks.
Langkah berikutnya
- Pelajari operator eksekusi kueri.
- Pelajari pengoptimal kueri Spanner.
- Pelajari cara mengelola pengoptimal kueri.