


Descripción general
En esta página, se explican los conceptos detrás de los planes de ejecución de consultas y cómo Spanner los usa para realizar consultas en un entorno distribuido. Si quieres obtener información para recuperar un plan de ejecución de una consulta específica con la consola deGoogle Cloud , consulta Comprende cómo Spanner ejecuta consultas. También puedes ver planes de consultas históricos de muestra para comparar el rendimiento de las consultas a lo largo del tiempo. Para obtener más información, consulta Planes de consultas con muestreo.
Spanner usa sentencias de SQL declarativas para consultar sus bases de datos. Las sentencias de SQL definen qué quiere el usuario sin especificar cómo obtener los resultados. Un plan de ejecución de consultas es el conjunto de pasos para saber cómo obtener los resultados. Para una instrucción de SQL determinada, puede haber varias formas de obtener los resultados. El optimizador de consultas de Spanner evalúa diferentes planes de ejecución y elige el más eficiente. Luego, Spanner usa el plan de ejecución para recuperar los resultados. Los planes de ejecución admiten bases de datos con dialecto de GoogleSQL y bases de datos con dialecto de PostgreSQL.
Para obtener más información sobre el optimizador de consultas, consulta Descripción general del optimizador de consultas.
De forma conceptual, un plan de ejecución es un árbol de operadores relacionales. Cada operador lee filas de sus entradas y produce filas de salida. El resultado del operador en la raíz de la ejecución se muestra como resultado de la consulta de SQL.
Por ejemplo, considera la siguiente consulta:
SELECT s.SongName FROM Songs AS s;
Esta consulta genera un plan de ejecución de consultas que se puede visualizar de la siguiente manera:

En este ejemplo, Spanner ejecuta el plan de consulta de arriba abajo y
los datos fluyen de abajo arriba. El operador distributed union se ejecuta primero. Las líneas azules discontinuas indican que este operador puede
realizar una llamada remota. Ya sea de forma local o remota, invoca el operador serialize result y continúa por el árbol. Cuando el operador table scan produce una fila, devuelve el control de inmediato al operador serialize result. Este proceso
continúa hasta que la consulta analiza todas las filas.
Las consultas y los planes de ejecución en esta página se basan en el siguiente esquema de base de datos:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Puedes usar las siguientes declaraciones del lenguaje de manipulación de datos (DML) para agregar datos a estas tablas:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Obtener planes de ejecución eficientes es un desafío porque Spanner divide los datos en divisiones. Las divisiones se pueden mover de forma independiente entre sí, y Spanner puede asignarlas a servidores diferentes, que podrían estar en ubicaciones físicas distintas. Para evaluar los planes de ejecución en datos distribuidos, Spanner realiza las siguientes tareas:
- Ejecuta subplanes de forma local en los servidores que almacenan los datos.
- Organiza y agrega varias ejecuciones remotas con una reducción de distribución agresiva.
Para habilitar este modelo, Spanner usa el operador
distributed union, junto con sus variantes
distributed cross apply
y
distributed outer apply.
Cómo Spanner ejecuta las consultas
De forma conceptual, la ejecución de la consulta fluye de arriba abajo y los resultados de la consulta fluyen de abajo arriba. En el siguiente diagrama, se muestra este patrón:
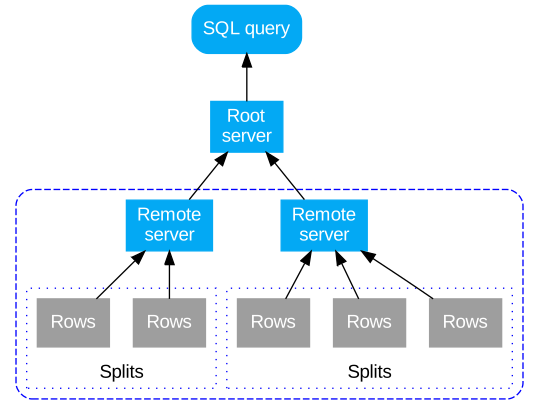
Spanner compila una consulta en SQL en un plan de ejecución. Para minimizar la cantidad de saltos a los datos consultados, Spanner elige un servidor raíz inicial y le envía el plan. El servidor raíz realiza las siguientes acciones:
- Inicia la ejecución remota de los subplanes, si es necesario.
- Espera los resultados de las ejecuciones remotas.
- Maneja los pasos de ejecución local restantes, como la agregación de resultados.
- Devuelve los resultados de la consulta.
Un servidor remoto que recibe un subplan actúa como un servidor raíz para su subplan y sigue el mismo modelo que el servidor raíz superior. Este modelo de ejecución genera un árbol de ejecuciones remotas.
Métricas de rendimiento clave
El visualizador del plan de consultas de Spanner Studio muestra métricas de resumen para la ejecución de consultas. Las métricas de resumen representan el agregado de métricas de todos los operadores individuales ejecutados durante la consulta. En la siguiente tabla, se describen las métricas de rendimiento clave:
| Métrica | Descripción |
|---|---|
| Tiempo total transcurrido | Es el tiempo total de reloj que se tarda en ejecutar la consulta. |
| Tiempo de CPU | Es la cantidad total de tiempo de CPU que se dedicó en todos los servidores involucrados en la ejecución de la consulta. Debido a que algunas partes de la ejecución de la consulta pueden continuar en paralelo, el tiempo de CPU puede ser mayor que el tiempo total transcurrido. |
Planes de consultas con muestreo
Los planes de consultas de muestra de Spanner te permiten ver muestras de planes de consultas históricos y comparar el rendimiento de una consulta a lo largo del tiempo. Los planes de consultas de muestra no están disponibles para todas las consultas. Spanner podría muestrear solo las consultas que consumen una cantidad significativa de CPU. Spanner conserva las muestras de planes de consulta durante 30 días. Para encontrar muestras de planes de consultas en la página Estadísticas de consultas de la consola deGoogle Cloud , consulta Visualiza planes de consultas de muestra.
La anatomía de un plan de consulta de muestra es la misma que la de un plan de ejecución de consultas normal. Para obtener más información sobre cómo comprender los planes visuales y usarlos para depurar tus consultas, consulta Un recorrido por el visualizador del plan de consultas.
Casos de uso comunes para planes de consulta con muestreo
Entre los casos de uso comunes de los planes de consulta de muestra, se incluyen los siguientes:
- Observar los cambios en el plan de consulta debido a cambios en el esquema (por ejemplo, agregar o quitar un índice).
- Observar cambios en el plan de consultas debido a una actualización de la versión del optimizador.
- Observar los cambios en el plan de consulta debido a las nuevas estadísticas del optimizador.
Spanner recopila estas estadísticas automáticamente cada tres
días, o puedes actualizarlas de forma manual con el comando
ANALYZE.
Si el rendimiento de las consultas varía de forma significativa con el tiempo o si deseas mejorarlo, consulta las prácticas recomendadas de SQL para crear instrucciones de consulta optimizadas que ayuden a Spanner a encontrar planes de ejecución eficientes.
Patrones comunes
En los siguientes ejemplos, se ilustran patrones comunes en los planes de ejecución de Spanner.
Consultas agregadas
Una consulta de agregación implementa la lógica de GROUP BY.
Por ejemplo, la siguiente consulta calcula los recuentos de canciones por cantante:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
Estos son los resultados:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
De manera conceptual, este es el plan de ejecución:
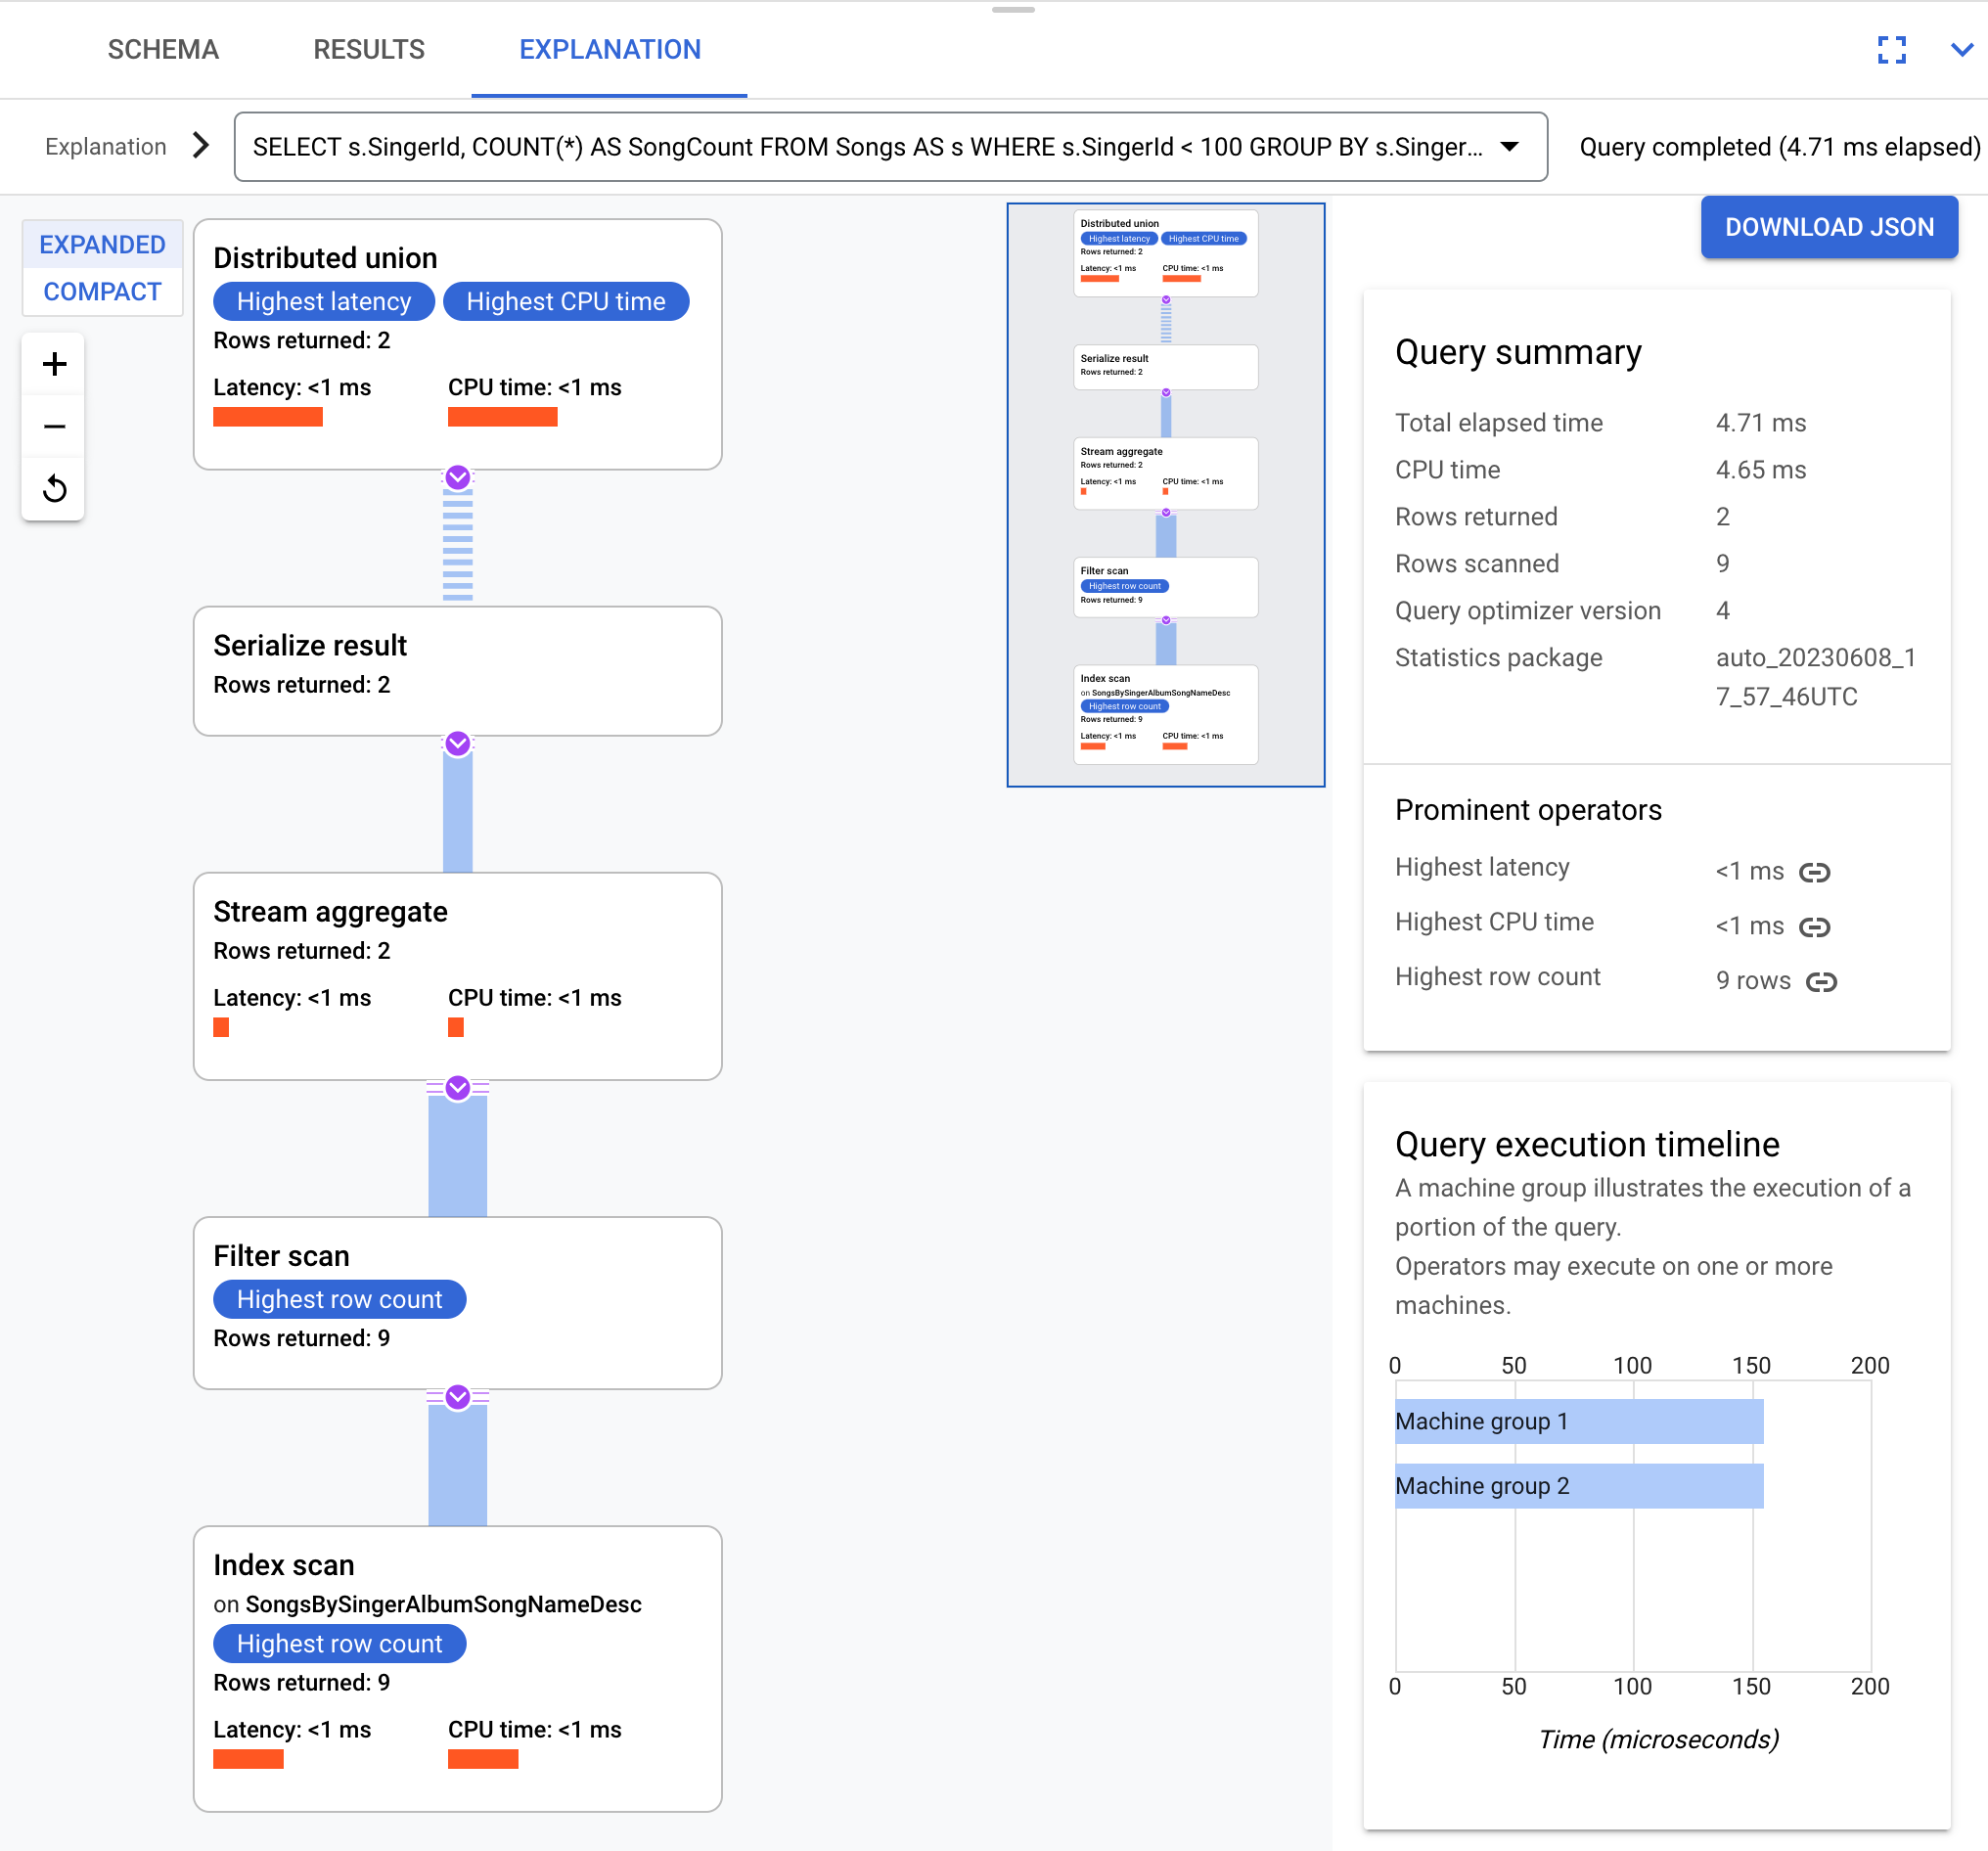
Spanner envía el plan de ejecución a un servidor raíz que coordina la ejecución de la consulta y distribuye los subplanes de forma remota.
Este plan de ejecución comienza con un operador distributed union que distribuye
subplanes a servidores remotos cuyas divisiones cumplen con SingerId < 100. Una vez que se completa el análisis
en las divisiones individuales, el operador stream aggregate agrega filas
para obtener los recuentos de cada SingerId. Luego, el operador serialize result
serializa el resultado. Por último, el distributed union combina todos los resultados y
los devuelve.
Para obtener más información sobre los agregados, consulta Operadores de agregación.
Consultas de unión ubicadas en el mismo lugar
En las tablas intercaladas, Spanner almacena físicamente las filas relacionadas juntas. Una unión ubicada en el mismo lugar es una unión entre tablas intercaladas. Las uniones ubicadas en el mismo lugar pueden mejorar el rendimiento en comparación con las uniones que requieren índices o reversión de uniones.
Por ejemplo, considera la siguiente consulta:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
En esta consulta, se supone que Songs está intercalada en Albums.
Estos son los resultados:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
Este es el plan de ejecución:
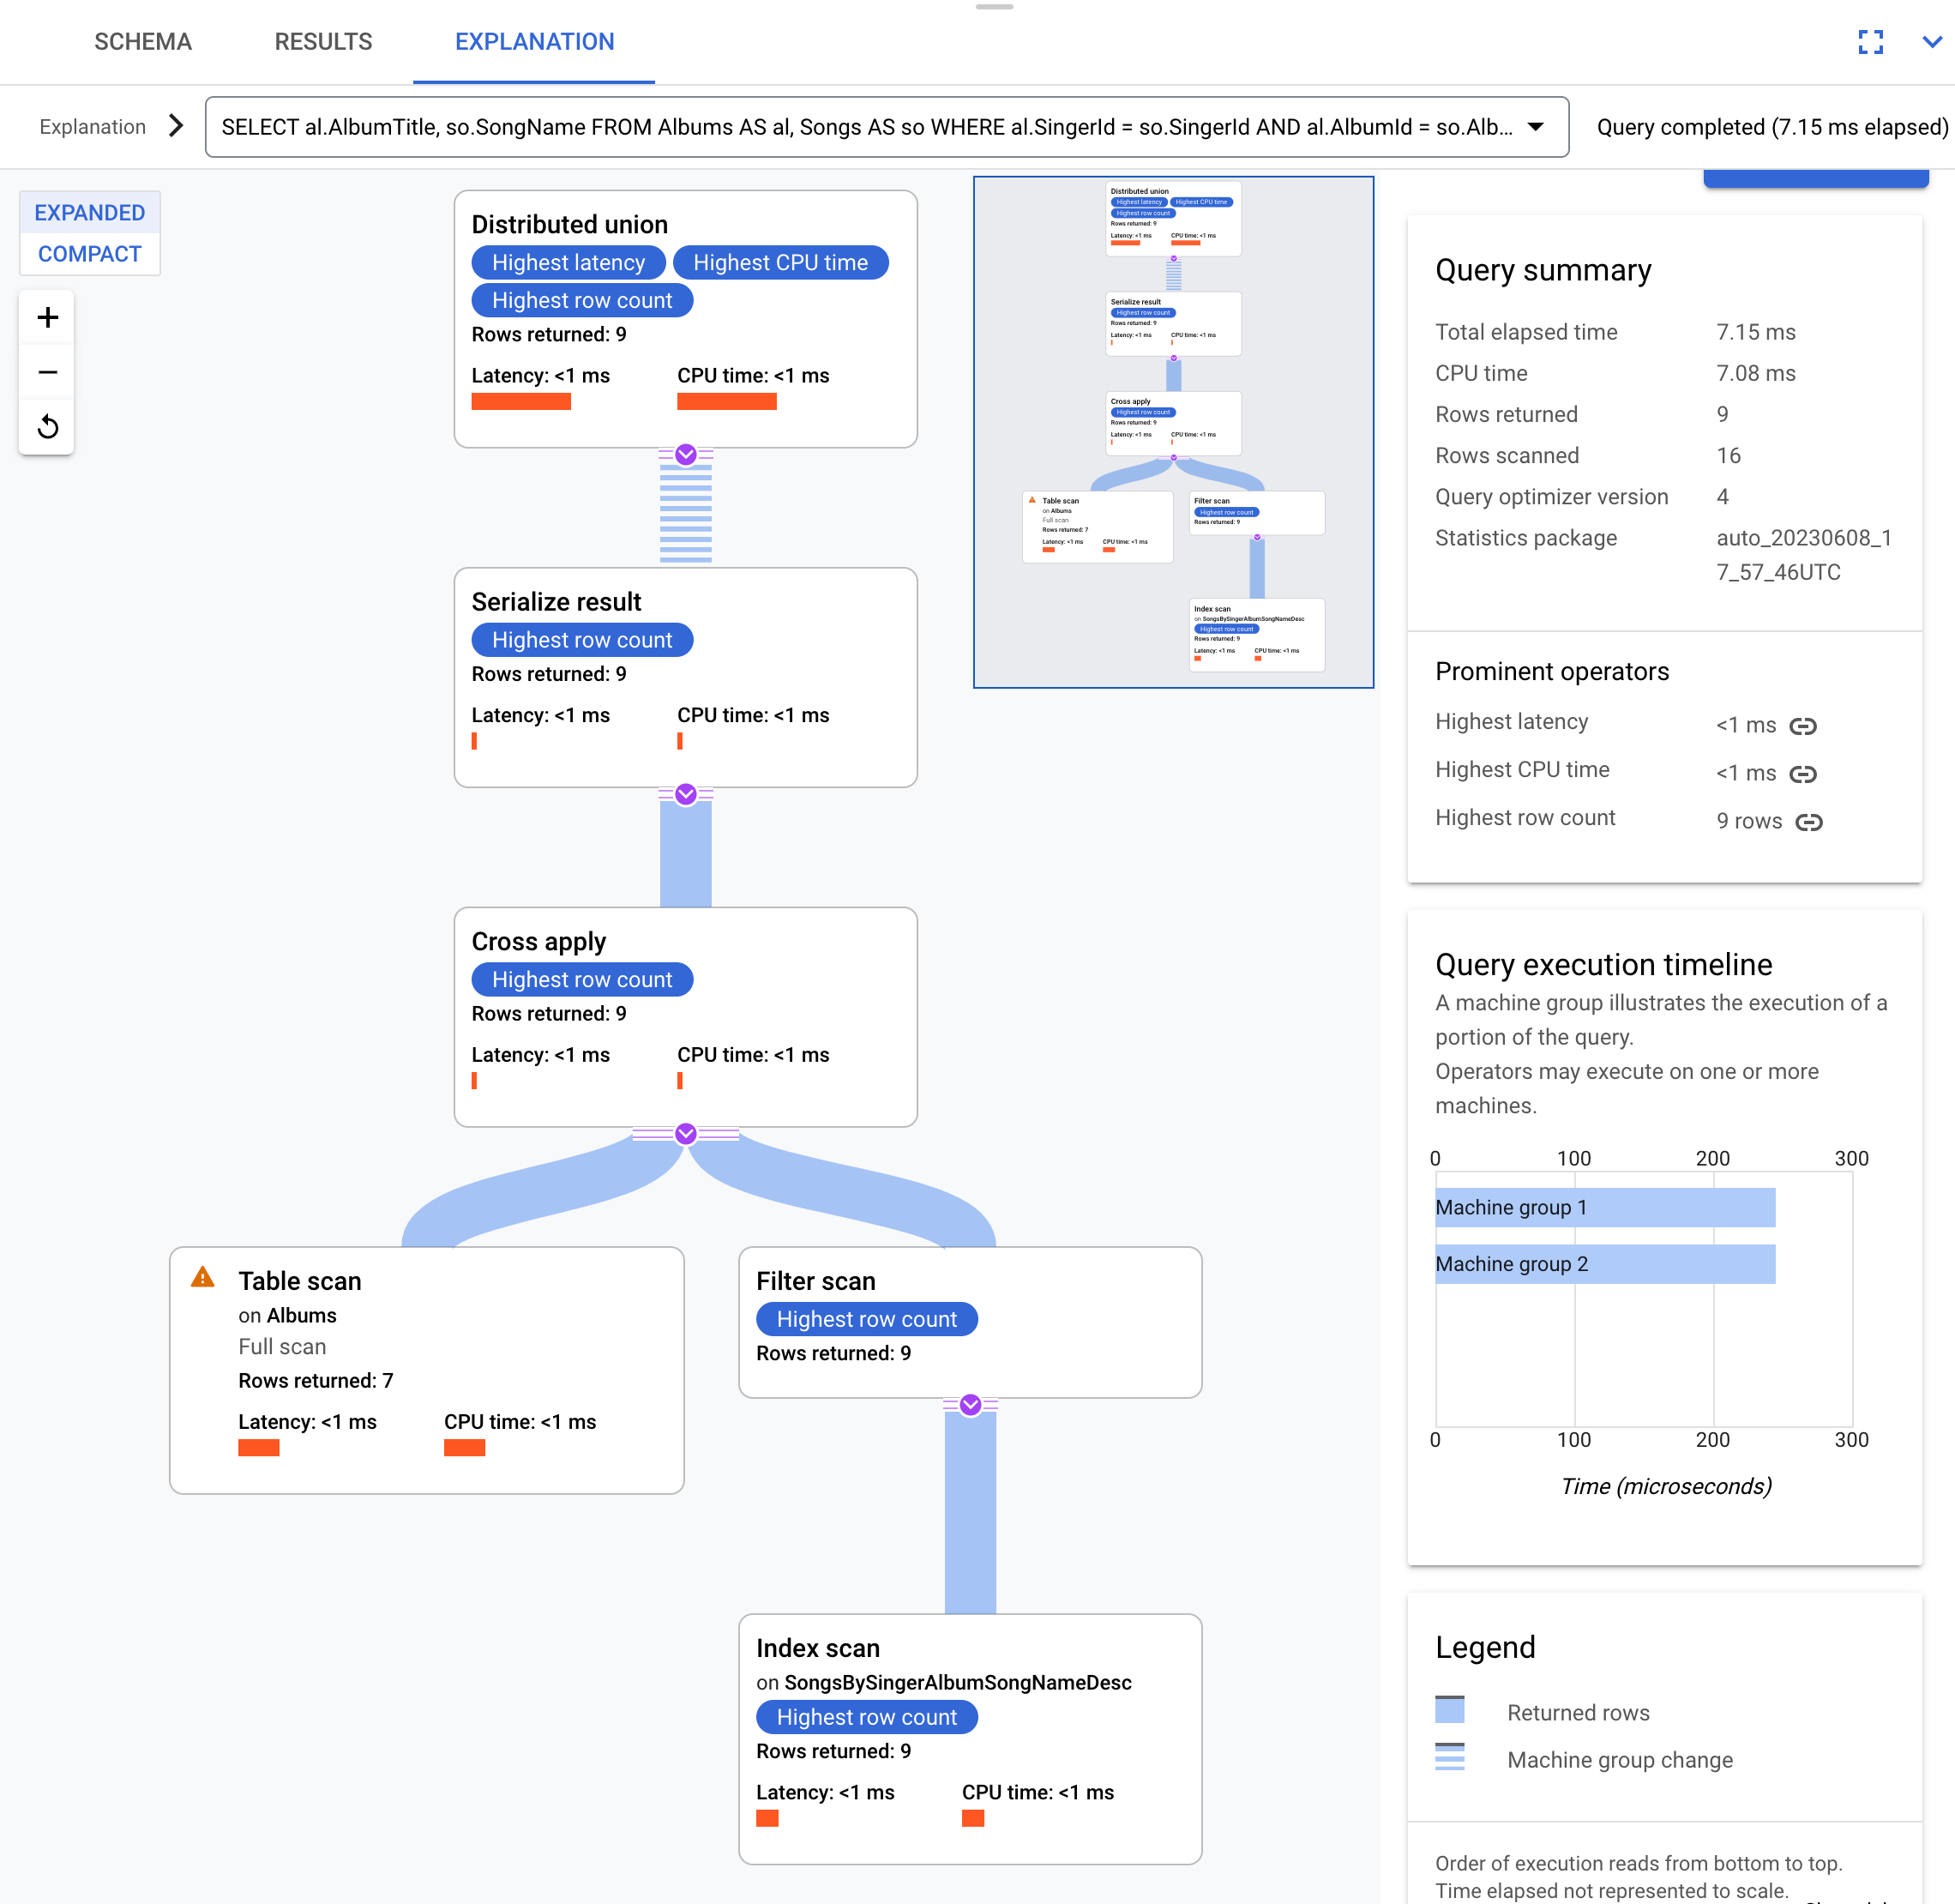
Este plan de ejecución comienza con un operador distributed union que distribuye
subplanes a servidores remotos, que contienen divisiones de la tabla Albums. Debido a que
Songs está intercalada en Albums, cada servidor remoto ejecuta todo el
subplan de forma local sin realizar una unión entre diferentes servidores.
Los subplanes contienen un operador cross apply. Cada operador cross apply
realiza una
table scan en la tabla Albums para recuperar SingerId, AlbumId y
AlbumTitle. Luego, el operador cross apply asigna el resultado del análisis de la tabla
al resultado de un análisis del índice SongsBySingerAlbumSongNameDesc.
Este índice está sujeto a un filtro, que requiere que el SingerId en el índice coincida
con el SingerId del resultado del análisis de la tabla. Cada operador cross apply envía
sus resultados a un operador serialize result, que serializa los
datos de AlbumTitle y SongName, y devuelve los resultados a las uniones
distribuidas locales. La unión distribuida agrega los resultados de las uniones distribuidas locales y los devuelve como el resultado de la consulta.
Consultas de índices y de reversiones de uniones
En el ejemplo anterior, se usa una unión en dos tablas, en la que una tabla se intercala en la otra. Si dos tablas, o una tabla y un índice, no están intercalados, los planes de ejecución son más complejos y menos eficientes.
Considera un índice creado con el siguiente comando:
CREATE INDEX SongsBySongName ON Songs(SongName);
Para usar este índice en una consulta, selecciona una de las siguientes opciones de dialecto de base de datos:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Estos son los resultados:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
Este es el plan de ejecución:

El plan de ejecución resultante es complejo porque el índice SongsBySongName
no contiene la columna Duration. Para obtener el valor Duration,
Spanner une los resultados indexados a la tabla
Songs. Esta es una unión, pero no se ubica en el mismo lugar porque la tabla Songs y
el índice global SongsBySongName no están intercalados. Si los datos no se ubican de forma conjunta, Spanner realiza optimizaciones para acelerar la ejecución. Estas optimizaciones hacen que el plan de ejecución sea más complejo que
el ejemplo anterior de unión coubicada.
El operador superior es un distributed cross apply. El lado de entrada
de este operador recibe lotes de filas del índice SongsBySongName que
satisfacen el predicado STARTS_WITH(s.SongName, "B"). Luego, el operador distributed cross apply
asigna estos lotes a servidores remotos que contienen divisiones con los
datos de Duration. Para recuperar la columna Duration, los servidores remotos realizan
un análisis de la tabla. Esta exploración usa la condición de filtro Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId), que une TrackId de la tabla Songs a las columnas TrackId de las filas agrupadas por lotes del índice SongsBySongName.
Spanner agrega los resultados a la respuesta final de la consulta.
A su vez, el lado de entrada del operador distributed cross apply contiene un par
distributed union o local distributed union para evaluar las filas del
índice que satisfacen el predicado STARTS_WITH.
Considera hacer una consulta un poco diferente, que no seleccione la columna s.Duration:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
En el siguiente plan de ejecución, se muestra que esta consulta usa el índice por completo:
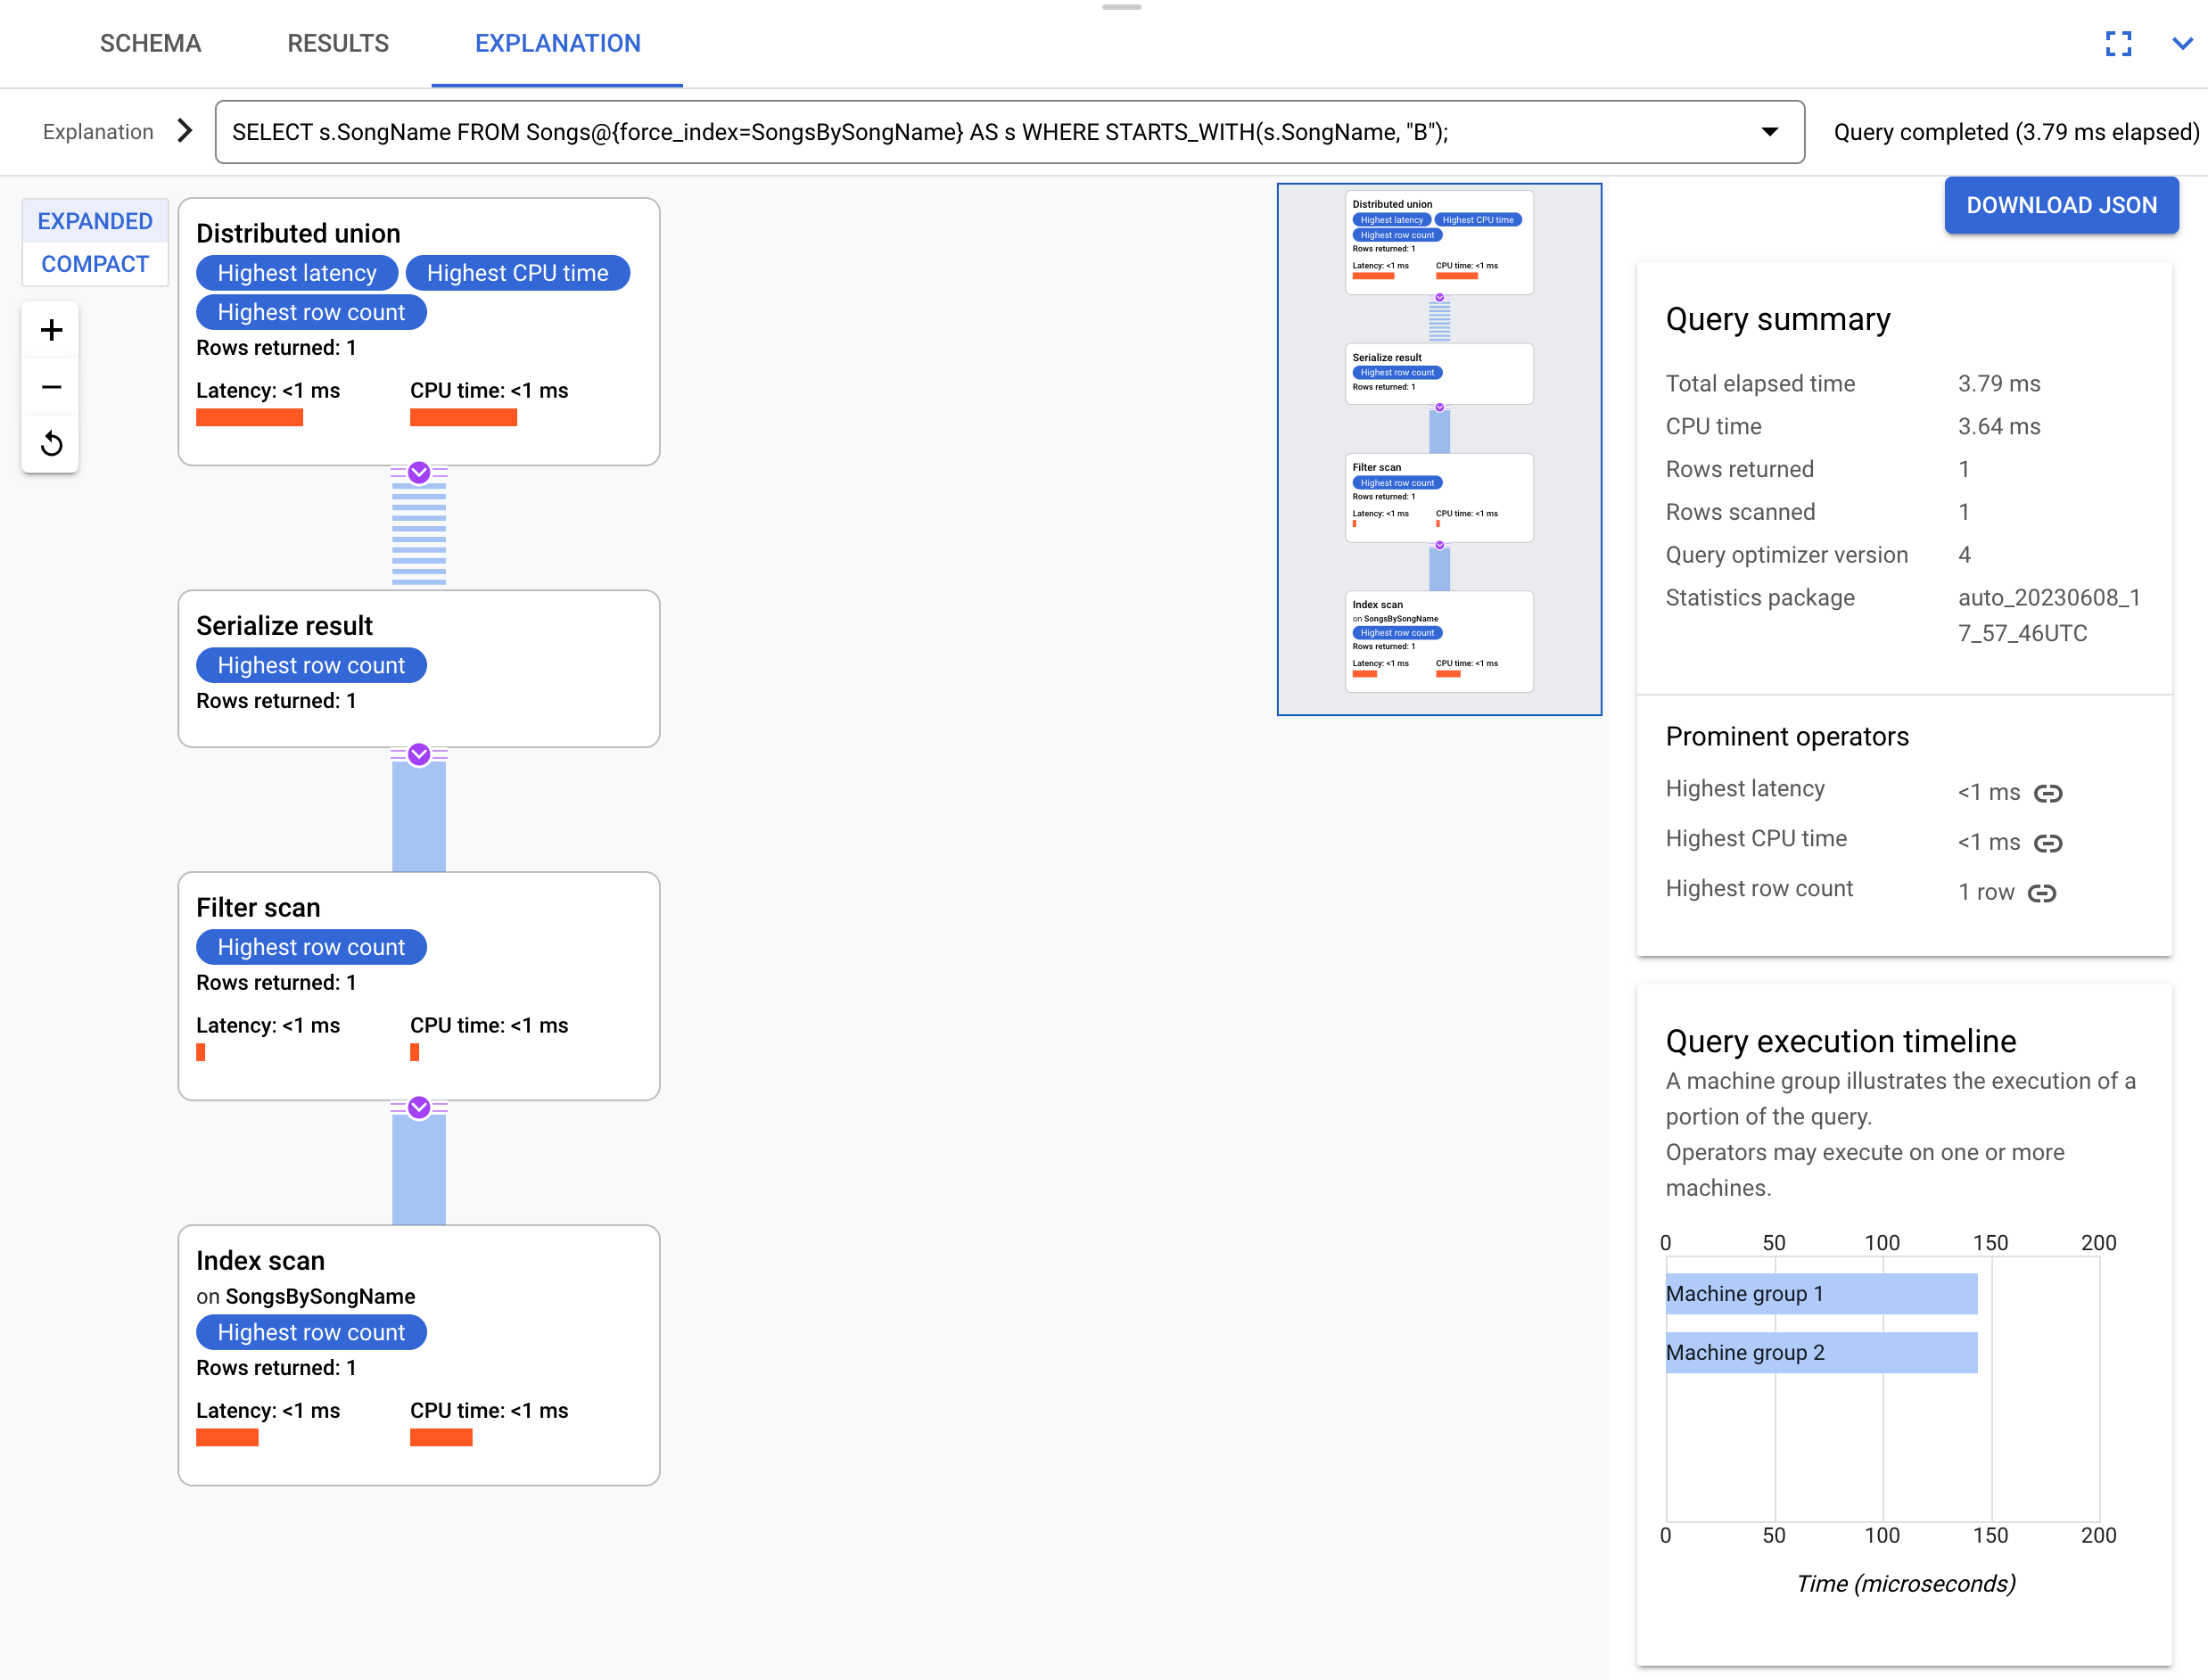
El plan de ejecución no requiere una unión inversa porque el índice contiene todas las columnas que solicita la consulta.
Análisis secuencial en comparación con búsquedas dispersas
Leer un rango contiguo de filas es mucho más rápido que leer la misma cantidad de filas dispersas.
Por ejemplo, la siguiente consulta suma la duración de las canciones de un conjunto específico de cantantes. Esta consulta realiza búsquedas para cada ID de cantante especificado. Para ver cuántas búsquedas realizó la consulta, consulta la estadística Recuento de búsquedas.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
Sin embargo, si estructuras la consulta para leer una secuencia contigua de IDs de
cantantes, puedes mejorar el rendimiento realizando una lectura secuencial de la
tabla Songs. La tabla Songs contiene SingerId como parte de su clave primaria.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
Esta diferencia es relevante cuando eliges un método de unión y cuando tomas decisiones de diseño de esquemas, como elegir una clave primaria. Para obtener más información sobre cómo elegir un método de unión, consulta Cómo interactúan las uniones con los análisis.
Cómo compartir uniones distribuidas
Cada tabla o índice de una consulta debe tener un operador distribuido correspondiente.
Este operador es distributed union o distributed apply. Si dos
tablas o índices se intercalan en el mismo elemento superior, el optimizador de consultas
podría usar un solo operador distributed union para ambas tablas o índices.
¿Qué sigue?
- Obtén más información sobre los operadores de ejecución de consultas.
- Obtén información sobre el optimizador de consultas de Spanner.
- Obtén información para administrar el optimizador de consultas.