


本文說明如何使用 Hotspot 深入分析資訊主頁,偵測 Spanner 資料庫中的熱點。
資源使用率不均洞察總覽
熱點會導致 Spanner 資料庫延遲。您可以透過「Hotspot insights」(熱點深入分析) 資訊主頁,偵測受熱點影響的分割。請按照下列步驟判斷熱點是否造成延遲,如果是,請按照下列步驟解決問題:
熱點深入分析功能適用於單一區域、多區域和雙區域設定。
定價
使用熱點深入分析功能不會產生額外費用。
資料保留
Hotspot 深入分析圖表和 TopN 分割資料表的資料保留政策,取決於基礎 SPANNER_SYS.SPLIT_STATS_TOP_* 資料表。如需特定保留政策,請參閱「熱門分割統計資料保留」。
必要的角色
視您是 IAM 使用者或精細存取控管使用者而定,您可能需要不同的 Identity and Access Management (IAM) 角色和權限。
IAM 使用者
如要取得查看「Hotspot insights」(熱點深入分析) 頁面所需的權限,請要求管理員授予您執行個體的下列 IAM 角色:
-
全部:
- Cloud Spanner 檢視者 (
roles/spanner.viewer) - Cloud Spanner 資料庫讀取者 (
roles/spanner.databaseReader)
- Cloud Spanner 檢視者 (
您必須具備 Cloud Spanner 資料庫讀取者 (
roles/spanner.databaseReader) 角色的下列權限,才能查看「Hotspot insights」(熱點深入分析) 頁面:
spanner.databases.beginReadOnlyTransactionspanner.databases.selectspanner.sessions.create
精細存取控管使用者
如果您是精細存取控管使用者,請務必:
- Cloud Spanner 檢視者 (
roles/spanner.viewer) - 具備精細的存取控管權限,並獲派
spanner_sys_reader系統角色或其成員角色之一。 - 在資料庫「Overview」(總覽) 頁面,選取
spanner_sys_reader或成員角色做為目前的系統角色。
詳情請參閱「精細的存取控管總覽」和「精細的存取控管系統角色」。
開啟「資源使用率不均洞察」資訊主頁
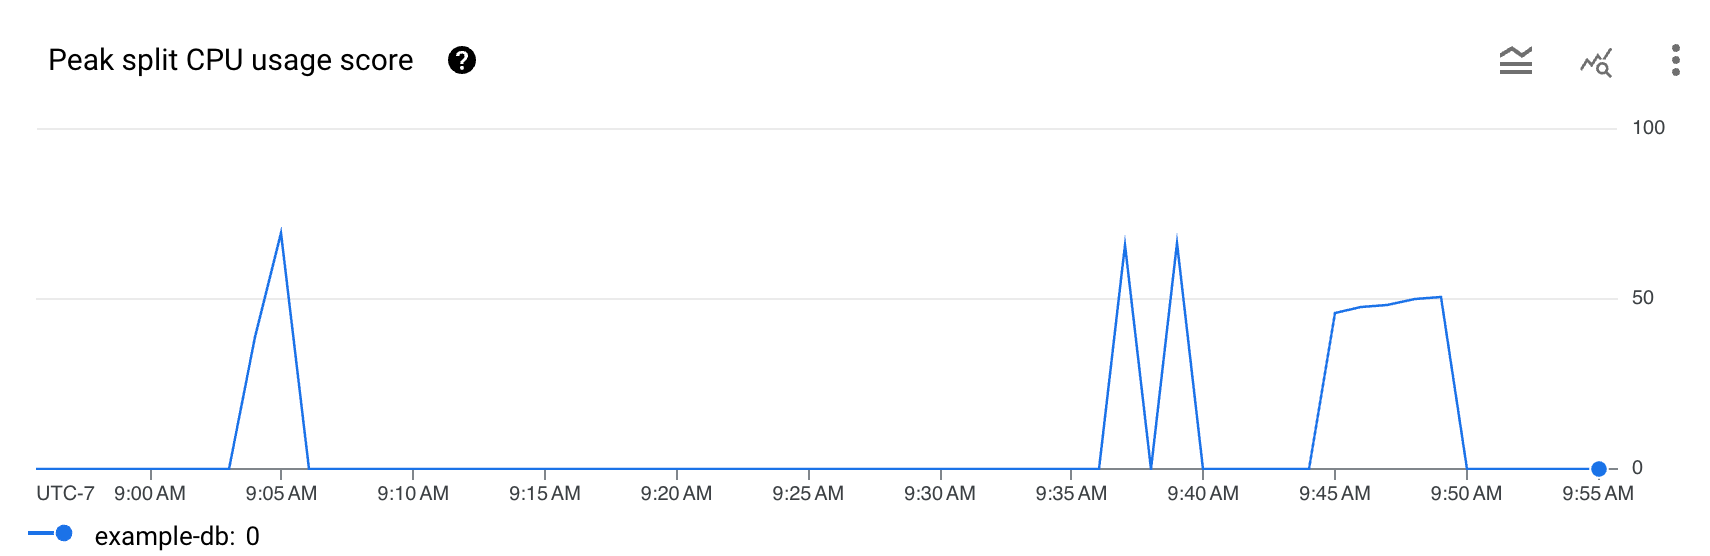
「Hotspot insights」(熱點深入分析) 資訊主頁會顯示分割 CPU 用量百分比的最高值。這項指標是介於 0 到 100 之間的抽象百分比,反映存取分割內資料列時使用的 CPU 數量。
如要查看資料庫的「Hotspot insights」(熱點深入分析) 資訊主頁,請按照下列步驟操作:
在 Google Cloud 控制台開啟「Spanner」頁面。
從清單中選取執行個體。
在導覽選單中,按一下「Hotspot insights」(熱點深入分析) 分頁標籤。
在「database」(資料庫) 欄位中,從清單選取資料庫。資訊主頁會顯示資料庫的最高分割 CPU 用量分數。
資訊主頁包含下列元素:
- 最高的分割 CPU 用量分數圖表:較高的 CPU 用量分數 (例如接近 100) 代表分割相當熱門,伺服器極有可能出現資源使用率不均的情況。
- 「Database」(資料庫) 欄位:篩選特定資料庫或所有資料庫的熱門分割資訊。
- 時間範圍篩選器:以 1 分鐘為單位,篩選 CPU 用量最高的分割,最多可篩選 6 小時。
- 前幾名分割表格:顯示前幾名分割的清單,並依分割 CPU 用量分數排序。

瞭解「前 N 名分割」表格中的資料:
「前 N 名分割」表格會根據您選取的日期範圍,填入基礎 SPANNER_SYS.SPLIT_STATS_TOP_* 表格中的資料。詳情請參閱「熱門分割統計資料保留」。
解讀 10MINUTE 或 HOUR 資料表的資料列:
來自 SPANNER_SYS.SPLIT_STATS_TOP_10MINUTE 或 SPANNER_SYS.SPLIT_STATS_TOP_HOUR 的資料列代表各時間間隔的匯總資料。如表格事件匯總所述,這些資料列中的 CPU_USAGE_SCORE 是在任何基礎 1 分鐘子間隔中觀察到的「最大」分數,而 UNSPLITTABLE_REASONS 是原因的「聯集」。
判斷是否需要介入處理熱點
如果圖表中的整體延遲時間和持續偏高的分割 CPU 用量分數出現高峰或上升,可能需要進一步調查。
請查看圖表,思考下列問題:
哪個資料庫的延遲時間變長?從「Databases」(資料庫) 清單中選取不同的資料庫,找出延遲時間最長的資料庫。如要找出負載最高的資料庫,您也可以在 Google Cloud 控制台中查看資料庫的「Latency」(延遲時間) 圖表。
延遲時間是否過長?與工作負載的預期延遲時間相比,延遲時間是否偏高?圖表是否會隨著時間推移而出現高峰或上升趨勢?如果延遲時間不長,表示熱點不是問題。
分割 CPU 用量分數是否達到 100%?圖表是否出現高峰,或隨著時間推移而上升?如果 CPU 使用率百分比未持續 10 分鐘以上達到 100% 尖峰分割,則可能沒有熱點問題。如果分割 CPU 用量百分比峰值超過 10 分鐘,建議您進一步調查,看看資料庫的延遲時間是否高於預期。
如果分割 CPU 用量峰值百分比超過 10 分鐘都維持在 100%,可能需要您介入處理。接下來,您可以找出資料庫中的熱門分割,繼續偵錯。
找出有問題的熱門分割
如要找出可能有熱點問題的分割,請參閱 Google Cloud 控制台中的「TopN splits」(前 N 個分割) 部分,如下所示。

「TopN splits」(前 N 名分割) 表格會概略列出所選時間範圍內可能熱門的分割,並依時間由新到舊排序。TopN 分割數量上限為 100。
Spanner 會從前 N 個熱門分割統計資料表中擷取資料,並以一分鐘為單位繪製圖表。圖表中每個資料點的值代表一分鐘間隔內的平均值。
表格會顯示下列屬性:
- Interval end:CPU 使用率高峰結束的日期和時間。
- 分割起始:分割內資料列範圍的起始鍵。如果分割起始位置是 <begin>,代表資料庫鍵範圍的開頭。
- 分割極限:分割內資料列範圍的極限鍵。如果極限鍵是 <end>,則代表資料庫鍵範圍的結尾。
- 分割 CPU 用量分數:這個抽象分數介於 0 至 100 之間,呈現出某個伺服器中,存取分割內資料列耗用的 CPU 數量。您可以參考 CPU 用量分數,評估是否有資源使用率不均的情況。
- 受影響的資料表:所含資料列可能儲存於分割的資料表。
- 無法分割的原因:Spanner 無法進一步分割熱門分割區的原因陣列。如果這裡有值,表示基於負載的分割無法因應列出的原因,緩解熱點問題。詳情請參閱「
UNSPLITTABLE_REASONS類型」。
分析無法分割的原因
「TopN splits」(前 N 項分割) 表格可讓您深入瞭解哪些特定分割在特定時間受到這些原因影響,如「Unsplittable reasons」(無法分割的原因) 欄所示。
診斷工作流程範例
以下是使用資訊主頁偵錯熱點的一般工作流程:
- 觀察效能問題:留意應用程式的延遲時間或錯誤是否增加。
- 開啟資源使用率不均洞察:在 Google Cloud 控制台中,前往相關 Spanner 資料庫的「Hotspot insights」(資源使用率不均洞察) 資訊主頁。選取問題發生的日期範圍。
- 查看圖表:
- 查看「Peak split CPU usage score」(最高的分割 CPU 用量分數) 圖表,看看是否有持續偏高的值,例如 >50%,尤其是接近 100% 且持續至少 10 分鐘。
- 找出受影響的分割並建立發現結果的關聯:如果 CPU 使用率偏高,請前往「TopN splits」(前 N 名分割) 表格。篩選或排序,找出影響期間內分割 CPU 用量分數最高的分割。查看這些主要分割的
UNSPLITTABLE_REASONS欄:- 高分割 CPU 用量分數和無法分割的原因:這強烈表示效能問題與 Spanner 無法自動解決的熱點有關。原因類型 (例如
HOT_ROW或MOVING_HOT_SPOT) 是重要線索。 - 分割 CPU 用量分數偏高,且沒有無法分割的原因:熱點可能是新出現的,Spanner 可能仍在分割。或者,問題可能是因應工作負載的變更,您不需要採取任何行動。
- 高分割 CPU 用量分數和無法分割的原因:這強烈表示效能問題與 Spanner 無法自動解決的熱點有關。原因類型 (例如
- 瞭解原因:請留意
UNSPLITTABLE_REASONS陣列中的特定代碼。 - 緩解:根據找出的原因,參閱
UNSPLITTABLE_REASONS類型 ,取得詳細說明和建議的緩解策略,通常涉及結構定義設計變更或工作負載調整。
後續步驟
- 瞭解分割熱點統計資料