


במאמר הזה נסביר איך למדוד את k-anonymity של מערך נתונים באמצעות Sensitive Data Protection, ואיך להציג את הנתונים באופן חזותי ב-Data Studio. כך תוכלו גם להבין טוב יותר את הסיכון ולהעריך את הפשרות בתועלת שתעשו אם תצנזרו נתונים או תסירו מהם את פרטי הזיהוי.
למרות שהנושא הזה מתמקד בהצגה חזותית של מדד ניתוח הסיכונים לשחזור פרטי זיהוי של אנונימיות k, אפשר גם להציג באופן חזותי את המדד גיוון l באמצעות אותן שיטות.
הנושא הזה מבוסס על ההנחה שאתם כבר מכירים את המושג אנונימיות-k ואת השימוש בו להערכת היכולת לזהות מחדש רשומות בתוך מערך נתונים. כדאי גם להכיר לפחות באופן בסיסי את אופן חישוב k-anonymity באמצעות Sensitive Data Protection, ואת השימוש ב-Data Studio.
מבוא
שיטות להסרת פרטי זיהוי יכולות לעזור לכם להגן על פרטיות המשתמשים בזמן שאתם מעבדים את הנתונים או משתמשים בהם. אבל איך אפשר לדעת אם מערך נתונים עבר מספיק תהליכים של הסרת פרטים מזהים? ואיך תדעו אם הסרת פרטי הזיהוי גרמה לאובדן נתונים רב מדי לתרחיש לדוגמה שלכם? כלומר, איך אפשר להשוות בין הסיכון לשחזור פרטי הזיהוי לבין התועלת של הנתונים כדי לקבל החלטות מבוססות-נתונים?
חישוב ערך ה-k-אנונימיות של קבוצת נתונים עוזר לענות על השאלות האלה, על ידי הערכת היכולת לזהות מחדש את הרשומות של קבוצת הנתונים. ב-Sensitive Data Protection יש פונקציונליות מובנית לחישוב ערך k-anonymity בקבוצת נתונים, על סמך מזהים חלקיים שאתם מציינים. כך תוכלו להעריך במהירות אם הסרת פרטי הזיהוי מעמודה מסוימת או משילוב של עמודות תגרום לכך שיהיה סיכוי גבוה או נמוך יותר לשחזר את פרטי הזיהוי של מערך הנתונים.
מערך נתונים לדוגמה
השורות הראשונות של מערך נתונים גדול לדוגמה:
user_id |
age |
title |
score |
|---|---|---|---|
602-61-8588 |
24 |
Biostatistician III |
733 |
771-07-8231 |
46 |
Executive Secretary |
672 |
618-96-2322 |
69 |
Programmer I |
514 |
... |
... |
... |
... |
במדריך הזה לא נתייחס ל-user_id, כי אנחנו מתמקדים במזהים חלקיים. במצב אמיתי, צריך לוודא ש-user_id מצונזר או מומר לאסימונים בצורה מתאימה. העמודה score היא קניינית למערך הנתונים הזה, ולא סביר שתוקף יוכל ללמוד אותה באמצעים אחרים, לכן לא תכללו אותה בניתוח. ההתמקדות תהיה בעמודות age ו-title שנותרו, שבאמצעותן תוקף יכול ללמוד על אדם מסוים דרך מקורות נתונים אחרים. השאלות שאתם מנסים לענות עליהן לגבי מערך הנתונים הן:
- איך שני המזהים החלקיים,
ageו-title, ישפיעו על הסיכון הכולל לשחזור פרטי הזיהוי של הנתונים שהוסרו מהם פרטי הזיהוי? - איך החלת טרנספורמציה של הסרת פרטי זיהוי תשפיע על הסיכון הזה?
חשוב לוודא שהשילוב של age ו-title לא ימופה למספר קטן של משתמשים. לדוגמה, נניח שיש רק משתמש אחד במערך הנתונים שהתפקיד שלו הוא "מתכנת 1" והוא בן 69. יכול להיות שתוקף יצליח להצליב את המידע הזה עם מידע דמוגרפי או מידע זמין אחר, לגלות מי האדם וללמוד את ערך הציון שלו.
למידע נוסף על התופעה הזו, קראו את הקטע מזהי ישויות וחישוב אנונימיות מסוג k בנושא ניתוח סיכונים.
שלב 1: מחשבים את k-anonymity בקבוצת הנתונים
קודם כול, משתמשים ב-Sensitive Data Protection כדי לחשב את האנונימיות מסוג k במערך הנתונים, על ידי שליחת ה-JSON הבא למשאב DlpJob. בקובץ ה-JSON הזה, מגדירים את מזהה הישות לעמודה user_id, ומזהים את שני המזהים החלקיים כעמודות age ו-title. אתם גם מורים ל-Sensitive Data Protection לשמור את התוצאות בטבלה חדשה ב-BigQuery.
קלט JSON:
POST https://dlp.googleapis.com/v2/projects/dlp-demo-2/dlpJobs

{
  "riskJob": {
    "sourceTable": {
      "projectId": "dlp-demo-2",
      "datasetId": "dlp_testing",
      "tableId": "dlp_test_data_kanon"
    },
    "privacyMetric": {
      "kAnonymityConfig": {
        "entityId": {
          "field": {
            "name": "id"
          }
        },
        "quasiIds": [
          {
            "name": "age"
          },
          {
            "name": "job_title"
          }
        ]
      }
    },
    "actions": [
      {
        "saveFindings": {
          "outputConfig": {
            "table": {
              "projectId": "dlp-demo-2",
              "datasetId": "dlp_testing",
              "tableId": "test_results"
            }
          }
        }
      }
    ]
  }
}
אחרי שהמשימה של אנונימיות k מסתיימת, Sensitive Data Protection שולח את תוצאות המשימה לטבלה ב-BigQuery בשם dlp-demo-2.dlp_testing.test_results.
שלב 2: קישור התוצאות ל-Data Studio
עכשיו תקשרו את הטבלה ב-BigQuery שיצרתם בשלב 1 לדוח חדש ב-Data Studio.
פותחים את Data Studio.
לוחצים על יצירה > דוח.
בחלונית Add data to report, בקטע Connect to data, לוחצים על BigQuery. יכול להיות שתצטרכו לתת ל-Data Studio הרשאת גישה לטבלאות ב-BigQuery.
בבורר העמודות, בוחרים באפשרות My projects. אחר כך בוחרים את הפרויקט, מערך הנתונים והטבלה. בסיום, לוחצים על הוספה. אם מופיעה הודעה על הוספת נתונים לדוח, לוחצים על Add to report.
תוצאות הסריקה של k-אנונימיות נוספו לדוח החדש ב-Data Studio. בשלב הבא תיצרו את התרשים.
שלב 3: יוצרים את התרשים
כדי להוסיף ולהגדיר את התרשים:
- ב-Data Studio, אם מופיעה טבלת ערכים, בוחרים אותה ולוחצים על Delete כדי להסיר אותה.
- בתפריט הוספה, לוחצים על תרשים משולב.
- לוחצים ומשרטטים מלבן באזור העריכה שבו רוצים שהתרשים יופיע.
בשלב הבא, מגדירים את נתוני התרשים בכרטיסייה נתונים כך שהתרשים יציג את ההשפעה של שינוי הגודל וטווחי הערכים של הקטגוריות:
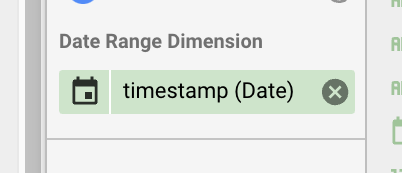
- מנקים את השדות שמתחת לכותרות הבאות: מציבים את הסמן מעל כל שדה ולוחצים על X, כמו שמוצג כאן:
- מאפיין טווח תאריכים
- מאפיין
- מדד
- מיון
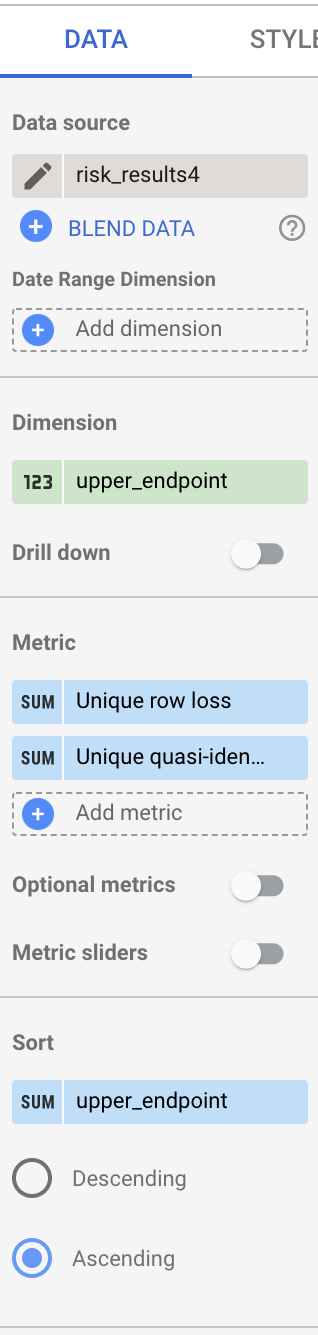
- אחרי שמנקים את כל השדות, גוררים את השדה upper_endpoint מהעמודה Available fields לכותרת Dimension.
- גוררים את השדה upper_endpoint לכותרת Sort ובוחרים באפשרות Ascending.
- גוררים את השדות bucket_size ו-bucket_value_count לכותרת Metric.
- מציבים את הסמן על הסמל שמימין למדד bucket_size, ומופיע סמל העריכה .
לוחצים על סמל העריכה ואז:
- בשדה Name, מקלידים
Unique row loss. - בקטע סוג, בוחרים באפשרות אחוז.
- בקטע חישוב השוואה, בוחרים באפשרות אחוז מהסה"כ.
- בקטע חישוב מצטבר, בוחרים באפשרות סכום מצטבר.
- בשדה Name, מקלידים
- חוזרים על השלב הקודם בשביל המדד bucket_value_count, אבל בשדה Name מקלידים
Unique quasi-identifier combination loss.
בסיום, העמודה אמורה להיראות כך:
לבסוף, מגדירים את התרשים כך שיוצג תרשים קו לשני המדדים:
- לוחצים על הכרטיסייה סגנון בחלונית שבצד שמאל של החלון.
- בוחרים באפשרות קו גם לסדרה 1 וגם לסדרה 2.
- כדי לראות את התרשים הסופי בנפרד, לוחצים על הלחצן View בפינה הימנית העליונה של החלון.
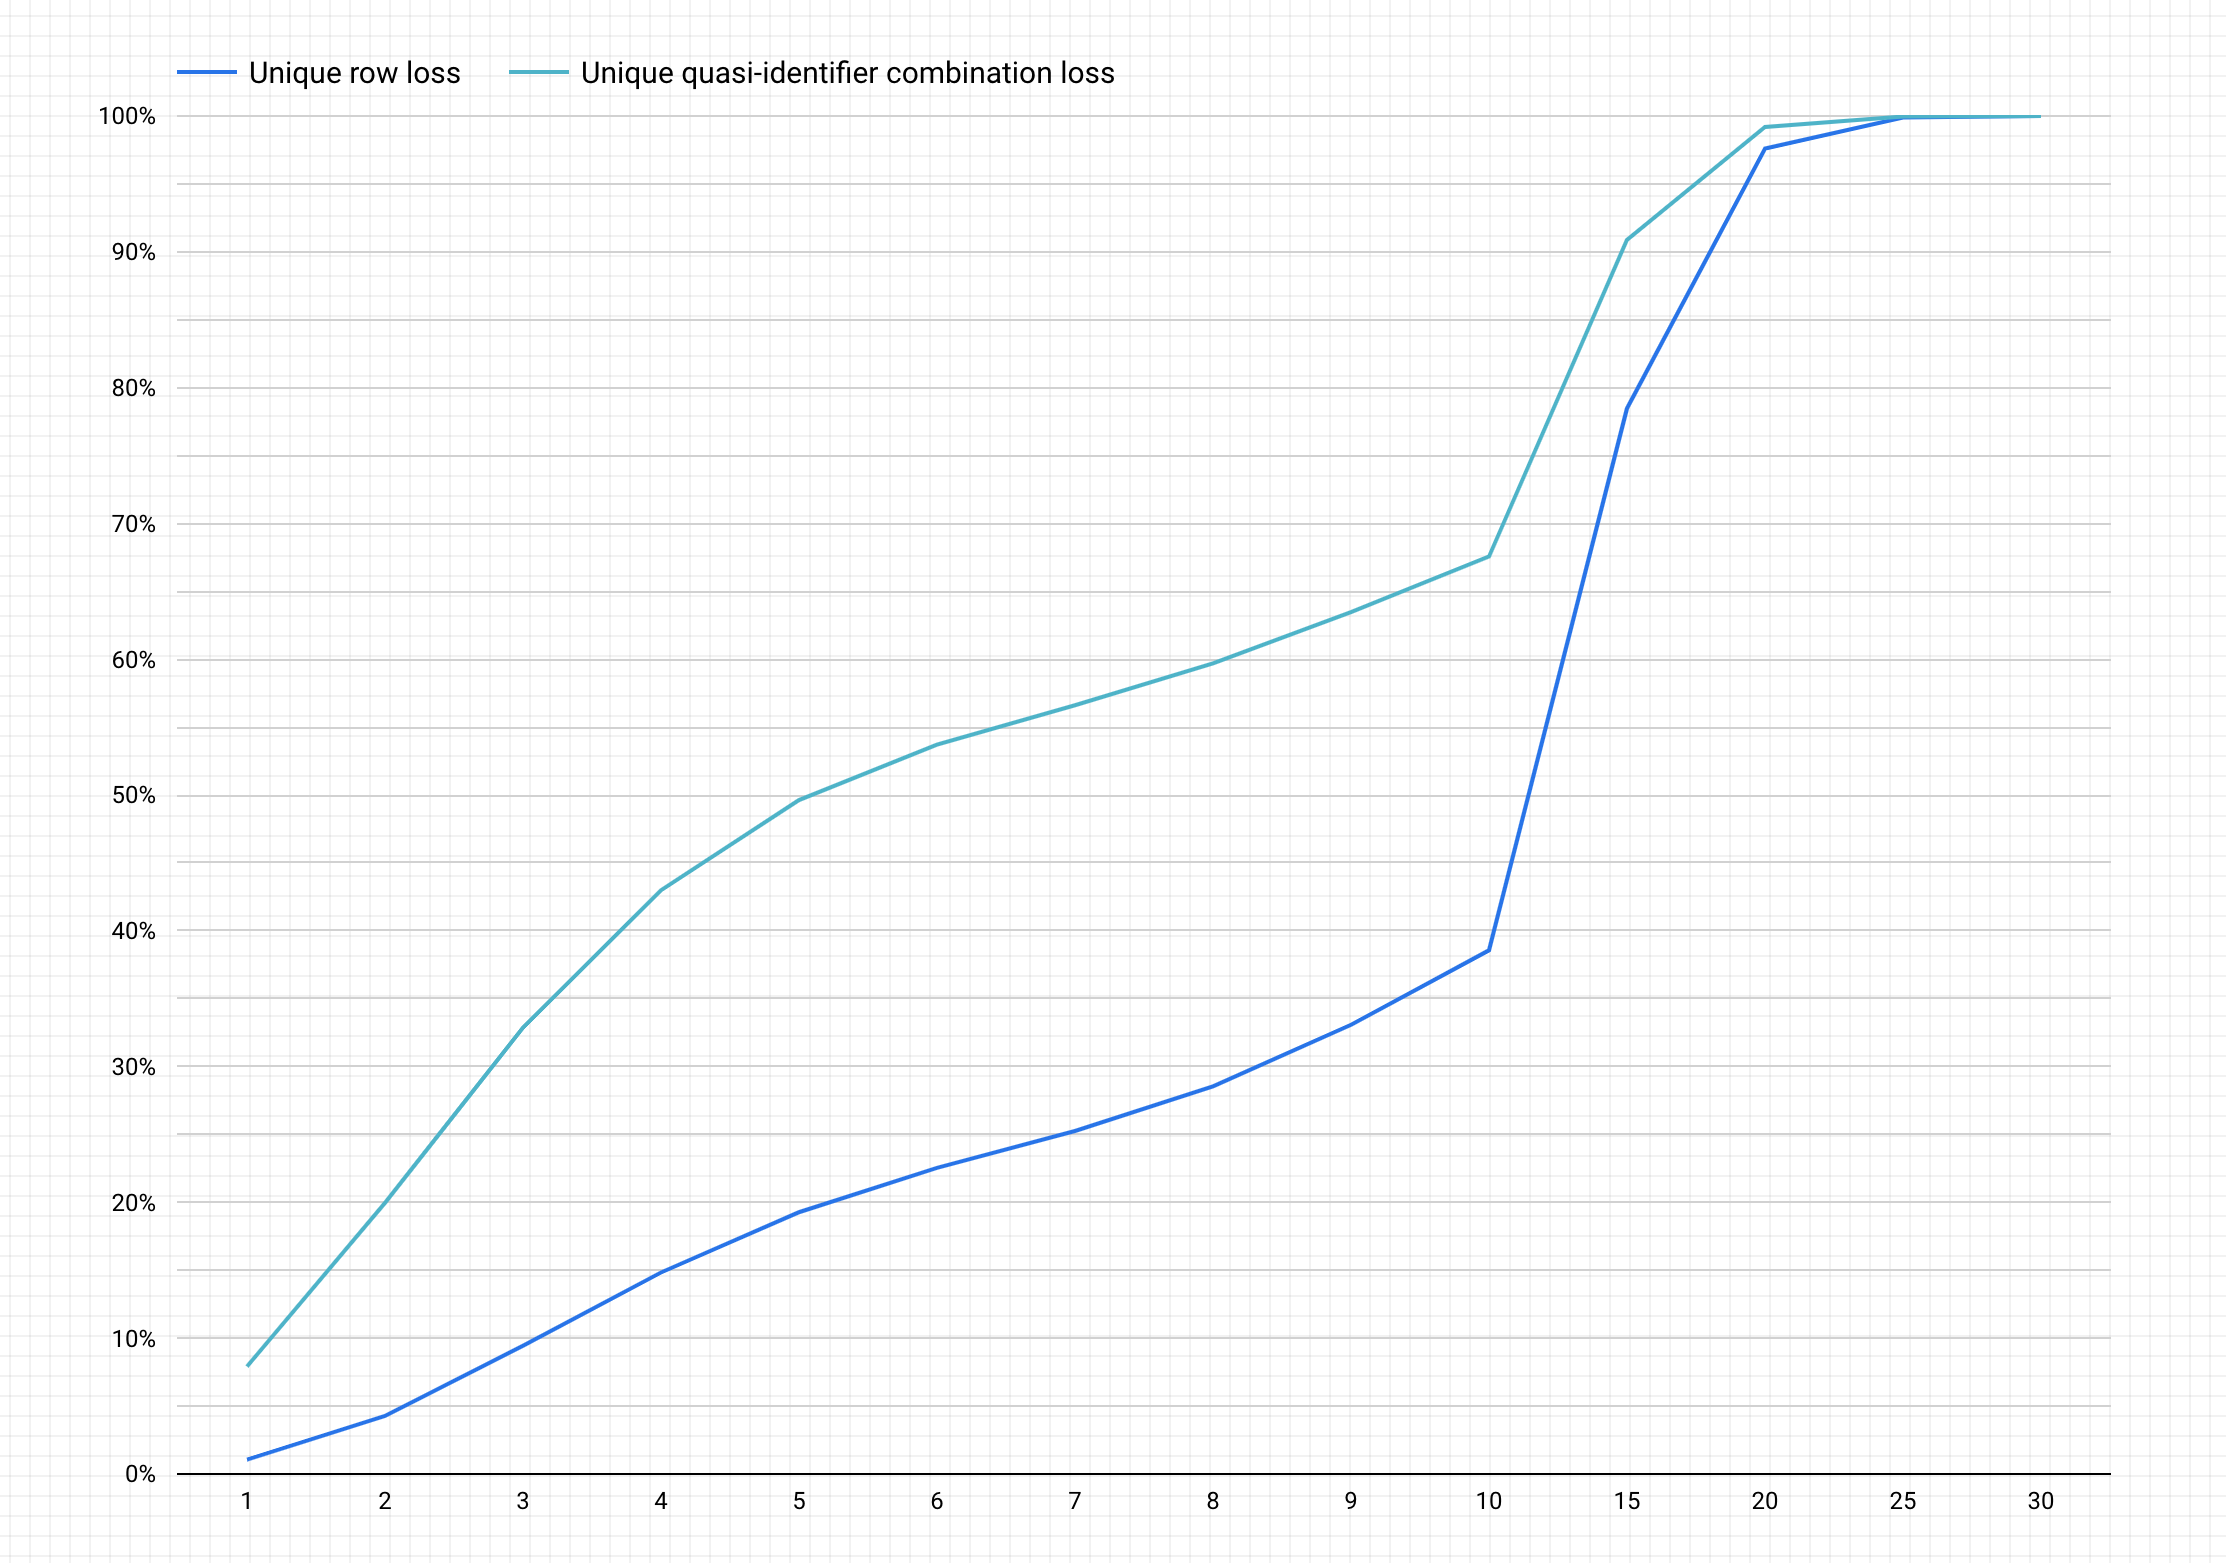
התרשים הבא הוא דוגמה לתרשים שנוצר אחרי השלמת השלבים הקודמים.
הסבר על התרשים
בתרשים שנוצר, בציר ה-y מוצג אחוז אובדן הנתונים הפוטנציאלי גם לשורות ייחודיות וגם לשילובים ייחודיים של מזהים חלקיים, כדי להשיג בציר ה-x ערך של k-אנונימיות.
ערכים גבוהים יותר של k-anonymity מצביעים על סיכון נמוך יותר לשחזור פרטי זיהוי. עם זאת, כדי להשיג ערכי k-אנונימיות גבוהים יותר, תצטרכו להסיר אחוזים גבוהים יותר מסך השורות ושילובים ייחודיים גבוהים יותר של מזהים חלקיים, מה שעשוי להפחית את התועלת של הנתונים.
למרבה המזל, השמטת נתונים היא לא האפשרות היחידה לצמצום הסיכון לשחזור פרטי זיהוי. שיטות אחרות להסרת פרטי הזיהוי יכולות לאזן טוב יותר בין אובדן הנתונים לבין התועלת. לדוגמה, כדי לטפל באובדן הנתונים שקשור לערכי אנונימיות k גבוהים יותר ולקבוצת הנתונים הזו, אפשר לנסות לחלק את הגילאים או את שמות המשרות לקטגוריות כדי להפחית את הייחודיות של השילובים בין הגילאים לשמות המשרות. לדוגמה, אתם יכולים לנסות לחלק את הגילאים לטווחים של 20-25, 25-30, 30-35 וכן הלאה. למידע נוסף על האופן שבו אפשר לעשות זאת, ראו הכללה וחלוקה לקטגוריות והסרת פרטי הזיהוי של נתונים רגישים בתוכן טקסט.