


As anotações de eventos em gráficos no Cloud Monitoring permitem correlacionar tendências de métricas com atividades do sistema, como implantações, failovers ou falhas. Um evento é uma atividade que afeta a operação de um sistema e é identificado por alertas abertos, pelo Personalized Service Health ou por entradas de registro. Os painéis podem exibir várias anotações, e cada anotação pode listar vários eventos. As guias Observabilidade de serviços como o Compute Engine e o Google Kubernetes Engine também podem exibir anotações, mas nem todos os tipos de evento são compatíveis.
Para cada tipo de evento listado, este documento inclui links para conteúdo de solução de problemas e consultas de registro que podem ser usadas na Análise de registros ou em uma política de alertas com base em registros. Para instruções de configuração, consulte Mostrar eventos em um painel.
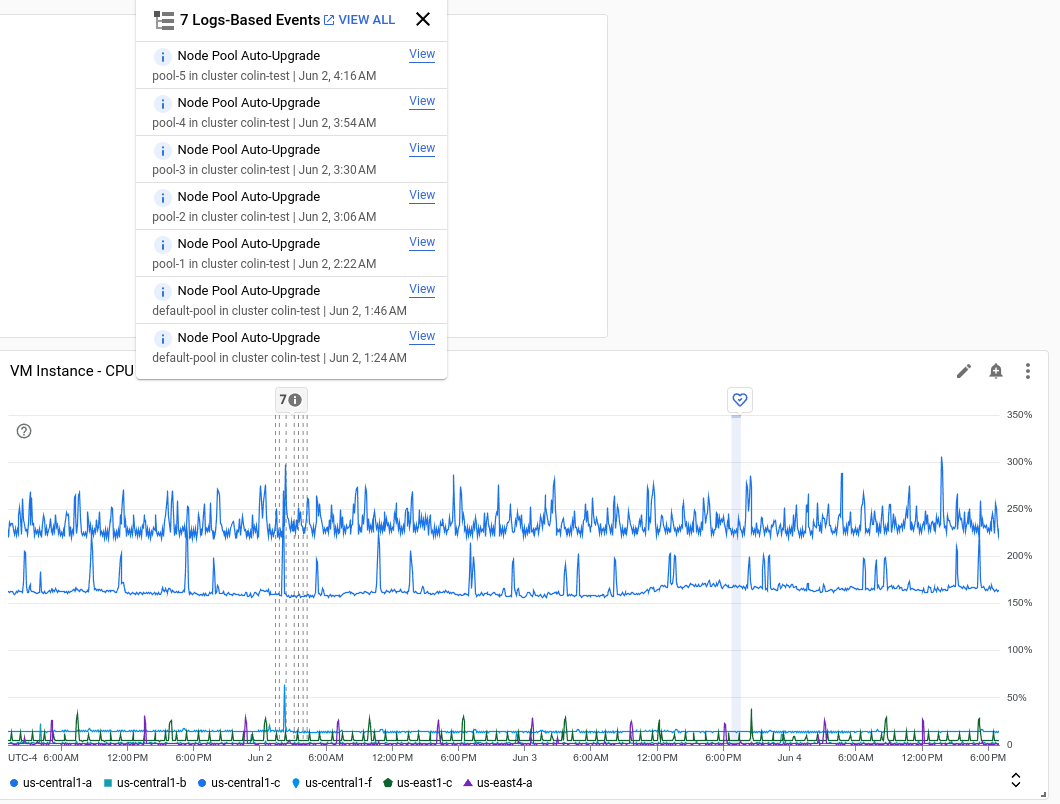
Exemplo de um painel com anotações
A captura de tela a seguir ilustra um gráfico que mostra vários eventos baseados em registros e um evento do Service Health:
Tipos de evento de alerta
Esta seção descreve os tipos de eventos de alerta que podem ser mostrados em um painel.
Alerta aberto
Os eventos de alerta aberto ajudam a correlacionar os dados do gráfico com o momento em que os alertas foram abertos. Um evento de alerta aberto é mostrado quando as seguintes condições são verdadeiras:
- O alerta correspondente foi aberto durante o período especificado pelo painel.
- O alerta correspondente não está fechado.
Os alertas que foram abertos fora do período especificado pelo painel não são mostrados. Da mesma forma, um evento de alerta aberto não é mostrado quando o alerta correspondente foi aberto e fechado no período especificado pelo painel.
A dica de um evento de alerta aberto inclui o seguinte:
- Nome da política de alertas.
- Informações de resumo, quando disponíveis. Por exemplo, essas informações podem incluir o limite e o valor medido.
- A duração do alerta e a data e hora em que ele foi aberto.
- Rótulos de métricas e recursos. A dica pode não mostrar todos os rótulos.
- Um botão Visualizar, que abre a página Detalhes do alerta.
Tipos de evento do Google Kubernetes Engine
Nesta seção, descrevemos os tipos de evento do Google Kubernetes Engine que podem ser mostrados em um painel.
Carga de trabalho do GKE corrigida ou atualizada
Esse tipo de evento ajuda a resolver problemas de implantação de carga de trabalho do GKE ou de mudanças no StatefulSet, já que esses eventos podem se correlacionar com regressões de desempenho ou outros problemas de desempenho. Esse tipo de evento é mostrado quando uma carga de trabalho é criada, atualizada ou excluída.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(cloudaudit.googleapis.com%2Factivity)
resource.type=k8s_cluster protoPayload.methodName=(
    io.k8s.apps.v1.deployments.create OR io.k8s.apps.v1.deployments.patch OR
    io.k8s.apps.v1.deployments.update OR io.k8s.apps.v1.deployments.delete OR
    io.k8s.apps.v1.statefulsets.create OR io.k8s.apps.v1.statefulsets.patch OR
    io.k8s.apps.v1.statefulsets.update OR io.k8s.apps.v1.statefulsets.delete OR
    io.k8s.apps.v1.daemonsets.create OR io.k8s.apps.v1.daemonsets.patch OR
    io.k8s.apps.v1.daemonsets.update OR io.k8s.apps.v1.daemonsets.delete
)
-protoPayload.authenticationInfo.principalEmail=("system:addon-manager" OR "system:serviceaccount:kube-system:namespace-controller")
-protoPayload.request.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.response.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.resourceName=~"namespaces/(kube-system|gmp-system|gmp-public|gke-gmp-system|istio-system)"
Para mais informações, consulte Visão geral da implantação de cargas de trabalho e Conferir métricas de observabilidade.
Falha de um pod do GKE
Esse tipo de evento ajuda a identificar e resolver problemas em falhas de pods do GKE. As falhas no pod podem ser causadas por esgotamento da memória ou um erro de aplicativo. Esse tipo de evento é mostrado quando ocorre uma das seguintes situações:
- O status do pod é
CrashLoopBackOff. - O pod é encerrado com um código de saída diferente de zero.
- O pod é encerrado com uma condição de falta de memória.
- O pod é despejado.
- A sondagem de prontidão ou de atividade falha.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
(
    log_id(events)
    (
        (resource.type=k8s_pod jsonPayload.reason=(BackOff OR Unhealthy OR Killing OR Evicted)) OR
        (resource.type=k8s_node jsonPayload.reason=OOMKilling)
    )
    severity=WARNING
) OR (
    log_id(cloudaudit.googleapis.com%2Factivity) resource.type=k8s_cluster
    (protoPayload.methodName=io.k8s.core.v1.pods.eviction.create OR
        (protoPayload.methodName=io.k8s.core.v1.pods.delete
        protoPayload.response.status.containerStatuses.state.terminated.exitCode:*
        -protoPayload.response.status.containerStatuses.state.terminated.exitCode=0
        )
    )
)
Para informações sobre solução de problemas, consulte Solução de problemas: CrashLoopBackOff.
Falha ao programar um pod do GKE
Esse tipo de evento ajuda a identificar e resolver problemas de pods que não podem ser programados em um nó. Esse tipo de evento é mostrado quando a programação de pods falha por qualquer um dos seguintes motivos:
- CPU do nó insuficiente.
- Memória de nó insuficiente.
- Nenhum nó para taints ou tolerâncias.
- Nós no limite máximo de pods.
- Pool de nós no tamanho máximo.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
(
    log_id(events) resource.type=k8s_pod jsonPayload.reason=(NotTriggerScaleUp OR FailedScheduling)
) OR (
    log_id(container.googleapis.com/cluster-autoscaler-visibility)
    resource.type=k8s_cluster jsonPayload.noDecisionStatus.noScaleUp:*
)
Para informações sobre solução de problemas, consulte Solução de problemas: pod não programável.
Falha ao criar um contêiner do GKE
Esse tipo de evento ajuda a identificar e resolver problemas de falha na criação de um contêiner do GKE. A criação de contêineres pode falhar por diversos motivos, como falhas nas montagens de volume ou na extração de imagens.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(events) resource.type=k8s_pod jsonPayload.reason=(Failed OR FailedMount) severity=WARNING
Para informações sobre solução de problemas de extrações de imagens, consulte Resolver problemas de extrações de imagens.
Escalonamento vertical do escalonador automático de pods
Esse evento dá visibilidade sobre os reescalonamentos do Escalonador automático horizontal de pods, que aumentam ou diminuem o número de pods em execução para uma carga de trabalho. Para mais informações, consulte Escalonamento automático horizontal de pods.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=k8s_cluster log_id(events)
jsonPayload.involvedObject.kind=HorizontalPodAutoscaler jsonPayload.reason=SuccessfulRescale
Escalonamento vertical e redução da escala vertical do escalonador automático de clusters
Esse evento mostra quando o escalonador automático de cluster aumenta ou diminui o número de nós em um pool de nós do cluster. Para mais informações, consulte Sobre o escalonamento automático de clusters e Como visualizar eventos do escalonador automático de clusters.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
(resource.type=k8s_cluster log_id(container.googleapis.com%2Fcluster-autoscaler-visibility)
jsonPayload.decision:*)
Criar e excluir clusters
Esse evento rastreia ações de criação e exclusão cluster do GKE. Para mais informações, consulte Criar um cluster do Autopilot, Criar um cluster zonal e Excluir um cluster.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
protoPayload.methodName=(
    google.container.v1alpha1.ClusterManager.CreateCluster OR
    google.container.v1beta1.ClusterManager.CreateCluster OR
    google.container.v1.ClusterManager.CreateCluster OR
    google.container.v1alpha1.ClusterManager.DeleteCluster OR
    google.container.v1beta1.ClusterManager.DeleteCluster OR
    google.container.v1.ClusterManager.DeleteCluster
)
operation.first=true
Atualização do cluster
Esse evento monitora atualizações de clusters do GKE. Isso inclui upgrades automáticos ou manuais da versão do plano de controle e mudanças na configuração dos clusters. Para mais informações, consulte Como fazer upgrade manual de um cluster ou pool de nós e Upgrades de cluster Standard.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.PatchCluster OR
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.UpdateCluster
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateCluster OR
        google.container.v1.ClusterManager.UpdateCluster
    )
    operation.first=true
)
protoPayload.metadata.operationType=(UPGRADE_MASTER OR REPAIR_CLUSTER OR UPDATE_CLUSTER)
Atualização do pool de nós
Este evento rastreia atualizações do pool de nós do GKE. Isso inclui upgrades automáticos ou manuais da versão do pool de nós, mudanças na configuração e redimensionamento. Para mais informações, consulte Como fazer upgrade manual de um cluster ou pool de nós e Upgrades de cluster Standard.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gke_nodepool log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.RepairNodePool
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateNodePool OR
        google.container.v1.ClusterManager.UpdateNodePool OR
        google.container.v1beta1.ClusterManager.SetNodePoolSize OR
        google.container.v1.ClusterManager.SetNodePoolSize OR
        google.container.v1beta1.ClusterManager.SetNodePoolManagement OR
        google.container.v1.ClusterManager.SetNodePoolManagement OR
        google.container.v1beta1.ClusterManager.SetNodePoolAutoscaling OR
        google.container.v1.ClusterManager.SetNodePoolAutoscaling
    )
    operation.first=true
)
Tipos de evento do Cloud Run
Nesta seção, descrevemos os tipos de evento do Cloud Run que podem ser mostrados em um painel.
Implantação do Cloud Run
Esse tipo de evento ajuda a identificar e resolver problemas de implantação do Cloud Run. A implantação pode falhar por motivos como uma conta de serviço excluída, permissões incorretas, uma importação de contêiner com falha ou um contêiner que não foi iniciado.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloud_run_revision
protoPayload.methodName=google.cloud.run.v1.Services.ReplaceService
Para informações sobre solução de problemas, consulte Solução de problemas: problemas do Cloud Run.
Tipos de evento do Cloud SQL
Nesta seção, descrevemos os tipos de eventos do Cloud SQL que podem ser mostrados em um painel.
Failover do Cloud SQL
Esse tipo de evento ajuda a identificar quando ocorrem failovers manuais ou automáticos. Um failover ocorre quando há uma falha na instância ou na zona e a instância em espera se torna a nova instância principal. Durante um failover, o Cloud SQL muda automaticamente para a veiculação de dados da instância em espera.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=cloudsql_database
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=cloudsql.instances.failover
        operation.last=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.autoFailover
    )
)
Para mais informações, consulte Sobre a alta disponibilidade.
Iniciar ou interromper o Cloud SQL
Esse tipo de evento ajuda a identificar quando uma instância do Cloud SQL foi iniciada, interrompida ou reiniciada manualmente. Quando uma instância é interrompida, todas as conexões, arquivos abertos e operações em execução também são.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloudsql_database
protoPayload.methodName=cloudsql.instances.update operation.last=true
protoPayload.metadata.intents.intent=(START_INSTANCE OR STOP_INSTANCE)
Para mais informações, consulte Sobre a alta disponibilidade e Iniciar, interromper e reiniciar instâncias.
Armazenamento do Cloud SQL
Esse tipo de evento ajuda a identificar eventos relacionados ao armazenamento do Cloud SQL, incluindo quando o armazenamento do banco de dados está cheio e quando um banco de dados é encerrado devido ao alcance da capacidade de armazenamento. Os bancos de dados com capacidade de armazenamento e sem o armazenamento automático ativado podem ser encerrados para evitar a corrupção de dados.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=cloudsql_database
(
    (
        (log_id(cloudsql.googleapis.com%2Fpostgres.log) OR log_id(cloudsql.googleapis.com%2Fmysql.err))
        textPayload=~"No space left on device"
        severity=(ERROR OR EMERGENCY)
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.databaseShutdownOutOfStorage
    )
)
Tipos de evento do Cloud Interconnect
Nesta seção, descrevemos os tipos de evento do Cloud Interconnect que podem ser mostrados em um painel.
Manutenção da interconexão iniciada
Esse tipo de evento monitora o início da manutenção de infraestrutura de uma interconexão. Durante o período da manutenção, as sessões do protocolo de gateway de borda (BGP) em anexos de rede local virtual (VLAN) ficam inativas.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="RUNNING"
labels."maintenance.googleapis.com/updated_fields" : "state"
Para mais informações, consulte Eventos de manutenção de infraestrutura.
Manutenção da interconexão concluída
Esse tipo de evento monitora a conclusão da manutenção de infraestrutura de uma interconexão. Os endereços MAC Ethernet do dispositivo de borda podem sofrer alterações após determinados eventos de manutenção.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="SUCCEEDED"
labels."maintenance.googleapis.com/updated_fields" : "state"
Para mais informações, consulte Eventos de manutenção de infraestrutura.
Tipos de evento do Cloud VPN
Nesta seção, descrevemos os tipos de evento do Cloud VPN que podem ser mostrados em um painel.
Manutenção da VPN
Esse tipo de evento monitora a manutenção de infraestrutura de uma tarefa de VPN. Isso inclui eventos de início e conclusão da manutenção.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Starting VPN task maintenance" OR
    textPayload:"VPN task maintenance Completed"
)
Seletores de tráfego de VPN restritos
Esse tipo de evento ajuda a identificar quando os seletores de tráfego são restritos para uma SA filha. Isso inclui eventos para seletores de tráfego local e remoto.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Warning: Local traffic selectors narrowed for Child SA" OR
    textPayload:"Warning: Remote traffic selectors narrowed for Child SA"
)
Tipos de evento do Compute Engine
Nesta seção, descrevemos os tipos de eventos do Compute Engine que podem ser mostrados em um painel.
Encerramentos de máquinas virtuais
Esse tipo de evento ajuda a identificar encerramentos de máquina virtual (VMs), incluindo redefinições e interrupções acionadas manualmente, encerramentos do SO convidado, encerramentos de manutenção e erros do host.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(
            beta.compute.instances.reset OR v1.compute.instances.reset OR
            beta.compute.instances.stop OR v1.compute.instances.stop
        )
        operation.first=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=(
            compute.instances.hostError OR
            compute.instances.guestTerminate OR
            compute.instances.terminateOnHostMaintenance
        )
    )
)
Para mais informações, consulte Interromper e iniciar uma VM e Solução de problemas de desligamento e reinicialização de VMs.
Falha ao iniciar a instância de VM
Esse evento acompanha falhas na inicialização de instâncias de VMs do Compute Engine. O evento mostra falhas de inicialização devido a esgotamentos, limite no espaço IP, cota excedida ou erros de integridade da VM protegida.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(beta.compute.instances.insert OR v1.compute.instances.insert)
        protoPayload.status.message=(ZONE_RESOURCE_POOL_EXHAUSTED OR IP_SPACE_EXHAUSTED OR QUOTA_EXCEEDED)
    ) OR (
        log_id(compute.googleapis.com%2Fshielded_vm_integrity)
        severity="ERROR"
    )
)
Erro do SO convidado da instância de VM
Esse evento rastreia erros específicos do SO convidado da instância de VM do Compute Engine, conforme indicado pelos registros do console serial. Os erros registrados são: disco cheio, falha na montagem do sistema de arquivos e falhas na inicialização que ativam o modo de emergência do Linux.
Para que esses eventos fiquem visíveis, é necessário ativar a geração de registros de saída da porta serial para o
Cloud Logging. Isso pode ser feito definindo serial-port-logging-enable=true nos metadados da VM ou
do projeto. Para mais informações, consulte
Como ativar e desativar a geração de registros de saída da porta serial.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gce_instance
log_id(serialconsole.googleapis.com%2Fserial_port_1_output)
textPayload=~("No space left on device" OR "Failed to mount" OR "You are in emergency mode")
Atualização do grupo gerenciado de instâncias
Esse tipo de evento ajuda a identificar quando o grupo gerenciado de instâncias (MIG) foi atualizado. Por exemplo, VMs foram adicionadas ou removidas, ou o limite de tamanho foi atualizado. Para mais informações, consulte Aplicar atualizações de configuração de VM automaticamente em um MIG.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=gce_instance_group_manager
log_id(cloudaudit.googleapis.com%2Factivity) operation.first=true
protoPayload.methodName=(beta.compute.instanceGroupManagers.patch OR v1.compute.instanceGroupManagers.patch)
Para mais informações, consulte Trabalhar com instâncias gerenciadas e Solução de problemas de grupos gerenciados de instâncias.
Escalonador automático do grupo gerenciado de instâncias
Este evento rastreia decisões de dimensionamento tomadas pelo escalonador automático de um MIG. Essas decisões podem incluir alterações no tamanho recomendado para um MIG ou no status do próprio escalonador automático. Para mais informações, consulte Escalonamento automático de grupos de instâncias.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
resource.type=autoscaler log_id(cloudaudit.googleapis.com%2Fsystem_event)
protoPayload.methodName=(compute.autoscalers.resize OR compute.autoscalers.changeStatus)
Tipos de evento do Personalized Service Health
Nesta seção, descrevemos os tipos de evento do Personalized Service Health que podem ser exibidos em um painel.
Google Cloud incidente
Ao solucionar problemas, talvez você queira diferenciar as falhas causadas por um serviço que você possui daquelas causadas por um serviço doGoogle Cloud que você usa. Ao ativar as anotações do Personalized Service Health em um painel, é possível conferir interrupções ou eventos de integridade de serviços do Google Cloud . Para uma lista de serviços integrados ao Service Health, consulte Produtos do Google compatíveis.
Ao contrário de outros tipos de eventos,os incidentes do Google Cloud não são identificados pela análise das entradas de registro. Se você quiser receber notificações quando esses eventos ocorrerem, crie uma política de alertas. É possível selecionar uma política de alertas pré-configurada usando as opções na página Painel de Service Health. Para mais informações, consulte Guia de início rápido: configurar um alerta.
O Monitoring identifica incidentes do Google Cloud emitindo uma solicitação para a API Service Health e filtrando a resposta para os incidentes relevantes para os dados que você está visualizando. A solicitação tem a seguinte configuração:
A enumeração
Relevanceestá definida comoRELATED,IMPACTEDouPARTIALLY_RELATED. Essa restrição garante que o painel mostre apenas eventos dos serviços do Google Cloud que o projeto doGoogle Cloud está usando.A enumeração
DetailedStatenão está definida comoFALSE_POSITIVE.
As anotações do Service Health são exibidas com um horário de início e uma duração. A duração é exibida mudando a cor de fundo do gráfico. A dica de um incidente do Google Cloud identifica o seguinte:
- O serviço Google Cloud .
- Se o incidente está aberto ou resolvido.
- Data e horário de início do evento.
- Ícones que mostram o número de produtos e locais afetados. Para listar os produtos ou locais afetados, coloque o ponteiro no ícone correspondente.
- Um botão Visualizar que, quando selecionado, abre a página de detalhes do incidente.
Para saber como emitir uma solicitação para a API Service Health, consulte Verificar se há interrupções com o Service Health.
Para informações sobre solução de problemas, consulte Resolver problemas comuns no Service Health.
Tipos de evento de verificação de tempo de atividade
Nesta seção, descrevemos os tipos de eventos de verificação de tempo de atividade que podem ser mostrados em um painel.
Falha na verificação de tempo de atividade
Esse tipo de evento ajuda a identificar falhas na verificação de tempo de atividade das regiões configuradas.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(monitoring.googleapis.com%2Fuptime_checks)
(
  resource.type=uptime_url OR resource.type=gce_instance OR
  resource.type=gae_app OR resource.type=k8s_service OR
  resource.type=servicedirectory_service OR resource.type=cloud_run_revision OR
  resource.type=aws_ec2_instance OR resource.type=aws_elb_load_balancer
)
labels.uptime_result_type=UptimeCheckResult
severity=NOTICE
Para informações sobre solução de problemas, consulte Resolver problemas com monitores sintéticos e verificações de tempo de atividade.
Tipos de evento do agente para SAP
Nesta seção, descrevemos os tipos de eventos do Agente para SAP que podem ser mostrados em um painel.
Disponibilidade do SAP
Esse tipo de evento ajuda a identificar eventos relacionados à disponibilidade do agente para SAP. Esses eventos são acionados quando a disponibilidade do cluster do SAP HANA, SAP NetWeaver ou Pacemaker muda.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=(workload.googleapis.com/sap/hana/service OR workload.googleapis.com/sap/hana/availability OR
  workload.googleapis.com/sap/nw/service OR workload.googleapis.com/sap/nw/availability OR
  workload.googleapis.com/sap/cluster/nodes OR workload.googleapis.com/sap/cluster/resources)
SAP Backint
Esse tipo de evento ajuda a identificar eventos relacionados ao Backint do agente para SAP. Qualquer backup ou recuperação do Backint grava um evento com detalhes de sucesso ou falha, e as estatísticas de transferência. Os backups e as recuperações de registros são mostrados apenas em caso de falha, enquanto os backups e as recuperações de dados são mostrados em caso de sucesso e falha.
log_id(google-cloud-sap-agent-backint)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
(jsonPayload.fileType=data OR (jsonPayload.fileType=log AND jsonPayload.success=false))
jsonPayload.message=SAP_BACKINT_FILE_TRANSFER
Operações SAP
Esse tipo de evento ajuda a identificar eventos relacionados às operações do agente para SAP. Esses eventos são acionados quando o status de replicação do SAP HANA muda.
Se você quiser criar uma política de alertas baseada em registros para esse tipo de evento, use a seguinte consulta:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=workload.googleapis.com/sap/hana/ha/replication
A seguir
Para saber como mostrar eventos nos painéis, consulte Mostrar eventos em um painel.