


En este documento, se describen los tipos de eventos que se pueden mostrar como anotaciones en los gráficos. Un evento es una actividad, como un reinicio o una falla, que afecta el funcionamiento de un sistema. Mostrar eventos puede ayudarte a correlacionar datos de diferentes fuentes cuando solucionas un problema.
Para cada evento, se proporcionan vínculos a referencias o documentación de solución de problemas, junto con información sobre cómo consultar el evento. Por ejemplo, cuando se identifican eventos analizando tus registros, se proporciona una consulta adecuada para usar con el Explorador de registros o con una política de alertas basada en registros.
Para agregar anotaciones a tus gráficos, debes configurar el panel o la pestaña que muestra el gráfico. Por ejemplo, puedes configurar la mayoría de los paneles que se enumeran en la página Paneles de la consola de Google Cloud para que muestren eventos. De manera similar, puedes configurar algunas pestañas de Observabilidad específicas del servicio, como las de Compute Engine y Google Kubernetes Engine, para que muestren eventos. Para obtener información sobre la configuración, consulta Cómo mostrar eventos en un panel.
En la siguiente captura de pantalla, se ilustra un gráfico que muestra varios eventos identificados a partir del análisis de entradas de registro y un evento de Service Health:
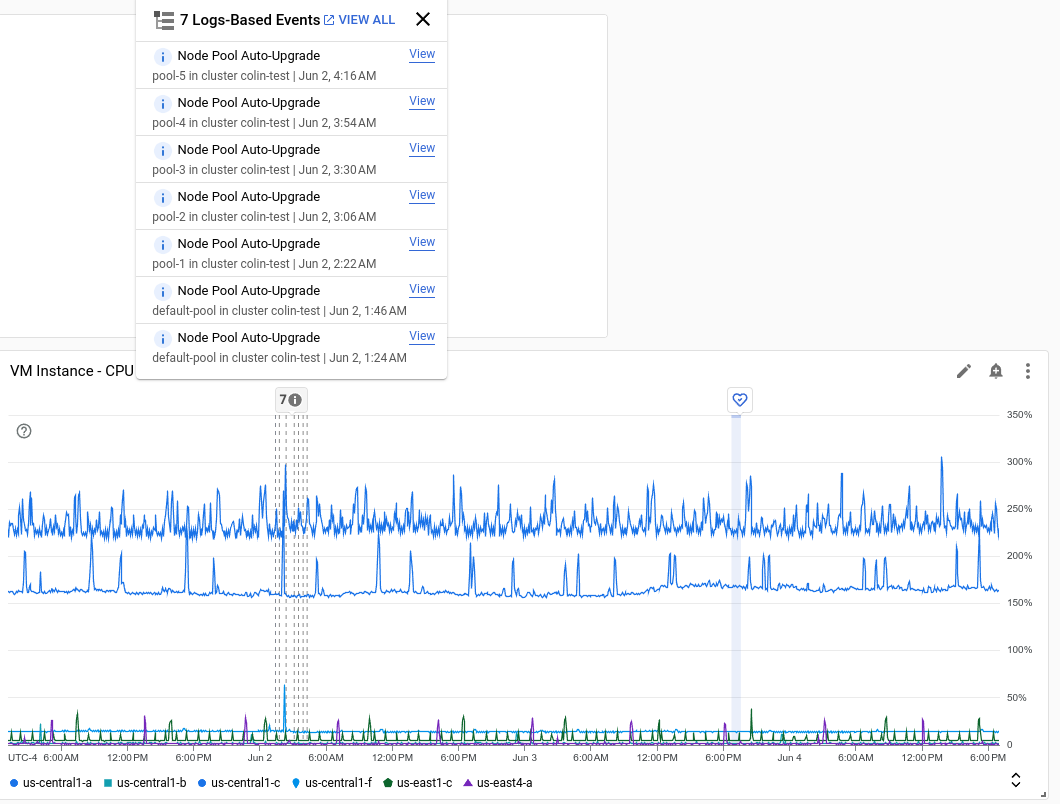
Cada anotación puede enumerar varios eventos. En la captura de pantalla anterior, se muestra un evento para una implementación de GKE.
Tipos de eventos de alerta
En esta sección, se describen los tipos de eventos de alerta que se pueden mostrar en un panel.
Se abrió la alerta
Los eventos de alerta abierta te ayudan a correlacionar los datos de tus gráficos con el momento en que se abrieron los incidentes. Se muestra un evento de alerta abierta cuando se cumplen las siguientes condiciones:
- El incidente correspondiente se abrió durante el intervalo de tiempo especificado por el panel.
- El incidente correspondiente no está cerrado.
No se muestran las anotaciones realizadas para los incidentes que se abrieron fuera del intervalo de tiempo especificado por el panel. Del mismo modo, no se muestra un evento de alerta abierta cuando el incidente correspondiente se abrió y luego se cerró dentro del intervalo de tiempo especificado por el panel.
El cuadro de información sobre un evento de alerta abierta incluye lo siguiente:
- Nombre de la política de alertas.
- Es la información de resumen, cuando está disponible. Por ejemplo, esta información podría incluir el umbral y el valor medido.
- La duración del incidente, y la fecha y hora en que se abrió.
- Etiquetas de métricas y recursos Es posible que la sugerencia no muestre todas las etiquetas.
- Un botón Ver, que abre la página Detalles del incidente
Tipos de eventos de Google Kubernetes Engine
En esta sección, se describen los tipos de eventos de Google Kubernetes Engine que se pueden mostrar en un panel.
Carga de trabajo de GKE actualizada o con parches
Este tipo de evento te ayuda a solucionar problemas relacionados con la implementación de cargas de trabajo de GKE o los cambios de StatefulSet, ya que estos eventos pueden correlacionarse con regresiones de rendimiento o con otros problemas de rendimiento. Este tipo de evento se muestra cuando se crea, actualiza o borra una carga de trabajo.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(cloudaudit.googleapis.com%2Factivity)
resource.type=k8s_cluster protoPayload.methodName=(
    io.k8s.apps.v1.deployments.create OR io.k8s.apps.v1.deployments.patch OR
    io.k8s.apps.v1.deployments.update OR io.k8s.apps.v1.deployments.delete OR
    io.k8s.apps.v1.statefulsets.create OR io.k8s.apps.v1.statefulsets.patch OR
    io.k8s.apps.v1.statefulsets.update OR io.k8s.apps.v1.statefulsets.delete OR
    io.k8s.apps.v1.daemonsets.create OR io.k8s.apps.v1.daemonsets.patch OR
    io.k8s.apps.v1.daemonsets.update OR io.k8s.apps.v1.daemonsets.delete
)
-protoPayload.authenticationInfo.principalEmail=("system:addon-manager" OR "system:serviceaccount:kube-system:namespace-controller")
-protoPayload.request.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.response.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.resourceName=~"namespaces/(kube-system|gmp-system|gmp-public|gke-gmp-system|istio-system)"
Para obtener más información, consulta la Descripción general de la implementación de cargas de trabajo y Visualiza métricas de observabilidad.
Falla de un Pod de GKE
Este tipo de evento te ayuda a identificar y solucionar problemas relacionados con las fallas de los Pods de GKE. Las fallas del Pod pueden deberse al agotamiento de la memoria o a un error de la aplicación. Este tipo de evento se muestra cuando ocurre alguna de las siguientes situaciones:
- El estado del pod es
CrashLoopBackoff - El Pod finaliza con un código de salida distinto de cero.
- El Pod finaliza con una condición de memoria insuficiente.
- Se expulsa el Pod.
- Falla el sondeo de preparación o funcionamiento.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
(
    log_id(events)
    (
        (resource.type=k8s_pod jsonPayload.reason=(BackOff OR Unhealthy OR Killing OR Evicted)) OR
        (resource.type=k8s_node jsonPayload.reason=OOMKilling)
    )
    severity=WARNING
) OR (
    log_id(cloudaudit.googleapis.com%2Factivity) resource.type=k8s_cluster
    (protoPayload.methodName=io.k8s.core.v1.pods.eviction.create OR
        (protoPayload.methodName=io.k8s.core.v1.pods.delete
        protoPayload.response.status.containerStatuses.state.terminated.exitCode:*
        -protoPayload.response.status.containerStatuses.state.terminated.exitCode=0
        )
    )
)
Para obtener información sobre la solución de problemas, consulta Soluciona problemas: CrashLoopBackOff.
No se pudo programar un Pod de GKE
Este tipo de evento te ayuda a identificar y solucionar problemas cuando los Pods no se pueden programar en un nodo. Este tipo de evento se muestra cuando falla la programación de Pods por cualquiera de los siguientes motivos:
- CPU del nodo insuficiente.
- Memoria de nodo insuficiente.
- No hay nodos para los taint o las tolerancias.
- Nodos con el límite máximo de Pods.
- El grupo de nodos tiene el tamaño máximo.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
(
    log_id(events) resource.type=k8s_pod jsonPayload.reason=(NotTriggerScaleUp OR FailedScheduling)
) OR (
    log_id(container.googleapis.com/cluster-autoscaler-visibility)
    resource.type=k8s_cluster jsonPayload.noDecisionStatus.noScaleUp:*
)
Para obtener información sobre la solución de problemas, consulta Solución de problemas: No se puede programar el Pod.
No se pudo crear un contenedor de GKE
Este tipo de evento te ayuda a identificar y solucionar problemas relacionados con la creación de un contenedor de GKE. La creación de contenedores puede fallar por motivos como fallas en las activaciones de volúmenes o la extracción de imágenes.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(events) resource.type=k8s_pod jsonPayload.reason=(Failed OR FailedMount) severity=WARNING
Para obtener información sobre la solución de problemas relacionados con las extracciones de imágenes, consulta Soluciona problemas relacionados con las extracciones de imágenes.
Ajuste de escala automático de Pods
Este evento te brinda visibilidad sobre los reajustes de escala del Horizontal Pod Autoscaler, que aumentan o disminuyen la cantidad de pods en ejecución para una carga de trabajo. Para obtener más información, consulta Ajuste de escala automático horizontal de Pods.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=k8s_cluster log_id(events)
jsonPayload.involvedObject.kind=HorizontalPodAutoscaler jsonPayload.reason=SuccessfulRescale
Escalamiento vertical y reducción vertical del escalador automático del clúster
Este evento te brinda visibilidad sobre cuándo el escalador automático del clúster aumenta o disminuye la cantidad de nodos en un grupo de nodos de tu clúster. Para obtener más información, consulta Acerca del ajuste de escala automático de clústeres y Cómo ver los eventos del escalador automático de clústeres.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
(resource.type=k8s_cluster log_id(container.googleapis.com%2Fcluster-autoscaler-visibility)
jsonPayload.decision:*)
Creación y eliminación de clústeres
Este evento realiza un seguimiento de las acciones de creación y eliminación de clúster de GKE. Para obtener más información, consulta Crea un clúster de Autopilot, Crea un clúster zonal y Borra un clúster.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
protoPayload.methodName=(
    google.container.v1alpha1.ClusterManager.CreateCluster OR
    google.container.v1beta1.ClusterManager.CreateCluster OR
    google.container.v1.ClusterManager.CreateCluster OR
    google.container.v1alpha1.ClusterManager.DeleteCluster OR
    google.container.v1beta1.ClusterManager.DeleteCluster OR
    google.container.v1.ClusterManager.DeleteCluster
)
operation.first=true
Actualización del clúster
Este evento realiza un seguimiento de las actualizaciones de los clústeres de GKE. Las actualizaciones incluyen las actualizaciones automáticas de la versión del plano de control, así como actualizaciones manuales y cambios en la configuración de clúster. Para obtener más información, consulta Actualiza un clúster o grupo de nodos de forma manual y Actualizaciones de clústeres estándar.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.PatchCluster OR
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.UpdateCluster
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateCluster OR
        google.container.v1.ClusterManager.UpdateCluster
    )
    operation.first=true
)
protoPayload.metadata.operationType=(UPGRADE_MASTER OR REPAIR_CLUSTER OR UPDATE_CLUSTER)
Actualización del grupo de nodos
Este evento realiza un seguimiento de las actualizaciones del grupo de nodos de GKE. Las actualizaciones incluyen actualizaciones automáticas de la versión del grupo de nodos, así como actualizaciones manuales, cambios en la configuración y cambios de tamaño. Para obtener más información, consulta Actualiza un clúster o grupo de nodos de forma manual y Actualizaciones de clústeres estándar.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gke_nodepool log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.RepairNodePool
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateNodePool OR
        google.container.v1.ClusterManager.UpdateNodePool OR
        google.container.v1beta1.ClusterManager.SetNodePoolSize OR
        google.container.v1.ClusterManager.SetNodePoolSize OR
        google.container.v1beta1.ClusterManager.SetNodePoolManagement OR
        google.container.v1.ClusterManager.SetNodePoolManagement OR
        google.container.v1beta1.ClusterManager.SetNodePoolAutoscaling OR
        google.container.v1.ClusterManager.SetNodePoolAutoscaling
    )
    operation.first=true
)
Tipos de eventos de Cloud Run
En esta sección, se describen los tipos de eventos de Cloud Run que se pueden mostrar en un panel.
Implementación de Cloud Run
Este tipo de evento te ayuda a identificar y solucionar problemas relacionados con las fallas en la implementación de Cloud Run. Deployment puede fallar por motivos como la eliminación de la cuenta de servicio, permisos incorrectos, la falla en la importación de un contenedor o la falla en el inicio de un contenedor.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloud_run_revision
protoPayload.methodName=google.cloud.run.v1.Services.ReplaceService
Para obtener información sobre la solución de problemas, consulta Solución de problemas: Problemas de Cloud Run.
Tipos de eventos de Cloud SQL
En esta sección, se describen los tipos de eventos de Cloud SQL que se pueden mostrar en un panel.
Conmutación por error de Cloud SQL
Este tipo de evento te ayuda a identificar cuándo ocurren conmutaciones por error manuales o automáticas. Una conmutación por error ocurre cuando hay una falla en una instancia o zona, y la instancia en espera se convierte en la nueva instancia principal. Durante una conmutación por error, Cloud SQL cambia automáticamente a entregar datos desde la instancia en espera.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=cloudsql_database
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=cloudsql.instances.failover
        operation.last=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.autoFailover
    )
)
Para obtener más información, consulta Acerca de la alta disponibilidad.
Inicio o detención de Cloud SQL
Este tipo de evento te ayuda a identificar si se inició, detuvo o reinició manualmente una instancia de Cloud SQL. Cuando se detiene una instancia, también se detienen todas las conexiones, los archivos abiertos y las operaciones en ejecución.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloudsql_database
protoPayload.methodName=cloudsql.instances.update operation.last=true
protoPayload.metadata.intents.intent=(START_INSTANCE OR STOP_INSTANCE)
Para obtener más información, consulta Acerca de la alta disponibilidad y Inicia, detén y reinicia instancias.
Almacenamiento de Cloud SQL
Este tipo de evento te ayuda a identificar eventos relacionados con el almacenamiento de Cloud SQL, incluidos los momentos en que el almacenamiento de la base de datos está lleno y cuando una base de datos se cierra debido a que alcanzó el límite de su capacidad de almacenamiento. Es posible que las bases de datos que tengan capacidad de almacenamiento y que no tengan habilitado el almacenamiento automático se cierren para evitar que se dañen los datos.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=cloudsql_database
(
    (
        (log_id(cloudsql.googleapis.com%2Fpostgres.log) OR log_id(cloudsql.googleapis.com%2Fmysql.err))
        textPayload=~"No space left on device"
        severity=(ERROR OR EMERGENCY)
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.databaseShutdownOutOfStorage
    )
)
Tipos de eventos de Cloud Interconnect
En esta sección, se describen los tipos de eventos de Cloud Interconnect que se pueden mostrar en un panel.
Se inició el mantenimiento de la interconexión
Este tipo de evento hace un seguimiento del inicio del mantenimiento de la infraestructura para una interconexión. Durante el evento de mantenimiento, se cierran las sesiones del protocolo de puerta de enlace de frontera (BGP) en los adjuntos de red de área local virtual (VLAN).
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="RUNNING"
labels."maintenance.googleapis.com/updated_fields" : "state"
Para obtener más información, consulta Eventos de mantenimiento de infraestructura.
Se completó el mantenimiento de la interconexión
Este tipo de evento hace un seguimiento del final del mantenimiento de la infraestructura para una interconexión. Las direcciones MAC de Ethernet del dispositivo perimetral pueden cambiar después de ciertos eventos de mantenimiento.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="SUCCEEDED"
labels."maintenance.googleapis.com/updated_fields" : "state"
Para obtener más información, consulta Eventos de mantenimiento de infraestructura.
Tipos de eventos de Compute Engine
En esta sección, se describen los tipos de eventos de Compute Engine que se pueden mostrar en un panel.
Finalizaciones de máquinas virtuales
Este tipo de evento te ayuda a identificar los cierres de máquina virtual (VM), incluidos los restablecimientos y las detenciones activados de forma manual, los cierres de SO invitado, los cierres de mantenimiento y los errores de host.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(
            beta.compute.instances.reset OR v1.compute.instances.reset OR
            beta.compute.instances.stop OR v1.compute.instances.stop
        )
        operation.first=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=(
            compute.instances.hostError OR
            compute.instances.guestTerminate OR
            compute.instances.terminateOnHostMaintenance
        )
    )
)
Para obtener más información, consulta Inicia y detén una VM y Soluciona problemas de reinicio y apagado de VM.
Falla en el inicio de la instancia de VM
Este evento hace un seguimiento de los errores de inicio de la instancia de VM de Compute Engine. El evento muestra los errores de inicio debido a desabastecimiento, agotamiento del espacio de la IP, cuota excedida o errores de integridad de las VM protegidas.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(beta.compute.instances.insert OR v1.compute.instances.insert)
        protoPayload.status.message=(ZONE_RESOURCE_POOL_EXHAUSTED OR IP_SPACE_EXHAUSTED OR QUOTA_EXCEEDED)
    ) OR (
        log_id(compute.googleapis.com%2Fshielded_vm_integrity)
        severity="ERROR"
    )
)
Error del SO invitado de la instancia de VM
Este evento realiza un seguimiento de errores específicos del SO invitado de la instancia de VM de Compute Engine tal como se registra en los registros de la consola en serie. Los errores registrados son disco lleno, fallo en la activación del sistema de archivos y fallos de inicio que activan el modo de emergencia de Linux.
Para que estos eventos sean visibles, debes habilitar el registro de salidas de puerto en serie en Cloud Logging. Para ello, configura serial-port-logging-enable=true en la VM o en los metadatos del proyecto. Para obtener más información, consulta Inhabilita y habilita el registro de salida del puerto en serie.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gce_instance
log_id(serialconsole.googleapis.com%2Fserial_port_1_output)
textPayload=~("No space left on device" OR "Failed to mount" OR "You are in emergency mode")
Actualización del grupo de instancias administrado
Este tipo de evento te ayuda a identificar cuándo se actualizó tu grupo de instancias administrado (MIG). Por ejemplo, se agregaron o quitaron VMs, o se actualizó el límite de tamaño. Para obtener más información, consulta Aplica de forma automática las actualizaciones de configuración de VM en un MIG.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=gce_instance_group_manager
log_id(cloudaudit.googleapis.com%2Factivity) operation.first=true
protoPayload.methodName=(beta.compute.instanceGroupManagers.patch OR v1.compute.instanceGroupManagers.patch)
Para obtener más información, consulta Trabaja con instancias administradas y Soluciona problemas de grupos de instancias administrados.
Escalador automático de grupos de instancias administrados
Este evento hace un seguimiento de las decisiones de escalamiento tomadas por el escalador automático de un MIG. Estas decisiones podrían incluir cambios en el tamaño recomendado de un MIG o en el estado del escalador automático. Si quieres obtener más información, consulta Ajuste de escala automático para grupos de instancias.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
resource.type=autoscaler log_id(cloudaudit.googleapis.com%2Fsystem_event)
protoPayload.methodName=(compute.autoscalers.resize OR compute.autoscalers.changeStatus)
Tipos de eventos de Personalized Service Health
En esta sección, se describen los tipos de Personalized Service Health que se pueden mostrar en un panel.
Google Cloud incidente
Cuando solucionas problemas, es posible que desees diferenciar entre las fallas causadas por un servicio que te pertenece y las causadas por un servicio deGoogle Cloud que usas. Cuando habilitas las anotaciones de Personalized Service Health en un panel, puedes ver las interrupciones o los eventos de estado del servicio para los servicios de Google Cloud . Para obtener una lista de los servicios integrados en Service Health, consulta Productos de Google compatibles.
A diferencia de otros tipos de eventos,los Google Cloud incidentes no se identifican analizando tus entradas de registro. Si deseas recibir notificaciones cuando se produzcan estos eventos, crea una política de alertas. Puedes seleccionar una política de alertas preconfigurada con las opciones de la página Service Health Dashboard. Para obtener más información, consulta Guía de inicio rápido: Configura una alerta.
La supervisión identifica Google Cloud incidentes enviando una solicitud a la API de Service Health y, luego, filtrando la respuesta para mostrar solo los incidentes que son relevantes para los datos que estás viendo. La solicitud tiene la siguiente configuración:
La enumeración
Relevancese establece enRELATED,IMPACTEDoPARTIALLY_RELATED. Esta restricción garantiza que tu panel solo muestre eventos de los Google Cloud servicios que usa tuGoogle Cloud proyecto.La enumeración
DetailedStateno está establecida enFALSE_POSITIVE.
Las anotaciones de Service Health se muestran con una hora de inicio y una duración. La duración se muestra cambiando el color de fondo del gráfico. La sugerencia de un incidente Google Cloud identifica lo siguiente:
- El servicio de Google Cloud
- Indica si el incidente está abierto o resuelto.
- Fecha y hora de inicio del evento.
- Fichas que muestran la cantidad de productos y ubicaciones afectados Para ver la lista de productos o ubicaciones afectados, coloca el puntero sobre el chip correspondiente.
- Un botón Ver que, cuando se selecciona, abre la página de detalles del incidente.
Para obtener información sobre cómo emitir una solicitud a la API de Service Health, consulta Verifica si hay interrupciones con Service Health.
Para obtener información sobre la solución de problemas, consulta Soluciona problemas habituales en Service Health.
Tipos de eventos de verificación de tiempo de actividad
En esta sección, se describen los tipos de eventos de verificación de tiempo de actividad que se pueden mostrar en un panel.
Falla en la verificación de tiempo de actividad
Este tipo de evento te ayuda a identificar los errores en las verificaciones de tiempo de actividad de las regiones configuradas.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(monitoring.googleapis.com%2Fuptime_checks)
(
  resource.type=uptime_url OR resource.type=gce_instance OR
  resource.type=gae_app OR resource.type=k8s_service OR
  resource.type=servicedirectory_service OR resource.type=cloud_run_revision OR
  resource.type=aws_ec2_instance OR resource.type=aws_elb_load_balancer
)
labels.uptime_result_type=UptimeCheckResult
severity=NOTICE
Para obtener información sobre la solución de problemas, consulta Soluciona problemas de los monitores sintéticos y las verificaciones de tiempo de actividad.
Tipos de eventos del agente para SAP
En esta sección, se describen los tipos de eventos del Agente para SAP que se pueden mostrar en un panel.
Disponibilidad de SAP
Este tipo de evento te ayuda a identificar eventos relacionados con la disponibilidad del Agente para SAP. Estos eventos se activan cuando cambia la disponibilidad de SAP HANA, SAP NetWeaver o el clúster de Pacemaker.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=(workload.googleapis.com/sap/hana/service OR workload.googleapis.com/sap/hana/availability OR
  workload.googleapis.com/sap/nw/service OR workload.googleapis.com/sap/nw/availability OR
  workload.googleapis.com/sap/cluster/nodes OR workload.googleapis.com/sap/cluster/resources)
Backint para SAP
Este tipo de evento te ayuda a identificar eventos relacionados con Agent for SAP Backint. Cualquier copia de seguridad o recuperación de Backint escribe un evento que detalla si se realizó correctamente o no, junto con las estadísticas de transferencia. Las copias de seguridad y recuperaciones de registros solo se muestran en caso de errores. En el caso de las copias de seguridad y recuperaciones de datos, estas se muestran tanto en casos de éxito como de errores.
log_id(google-cloud-sap-agent-backint)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
(jsonPayload.fileType=data OR (jsonPayload.fileType=log AND jsonPayload.success=false))
jsonPayload.message=SAP_BACKINT_FILE_TRANSFER
Operaciones de SAP
Este tipo de evento te ayuda a identificar eventos relacionados con las operaciones del Agente para SAP. Estos eventos se activan cuando cambia el estado de replicación de SAP HANA.
Si deseas crear una política de alertas basada en registros para este tipo de evento, usa la siguiente consulta:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=workload.googleapis.com/sap/hana/ha/replication
¿Qué sigue?
Para obtener información sobre cómo mostrar eventos en tus paneles, consulta Cómo mostrar eventos en un panel.