


使用 Spark 和 Lakehouse 运行时目录创建湖仓一体
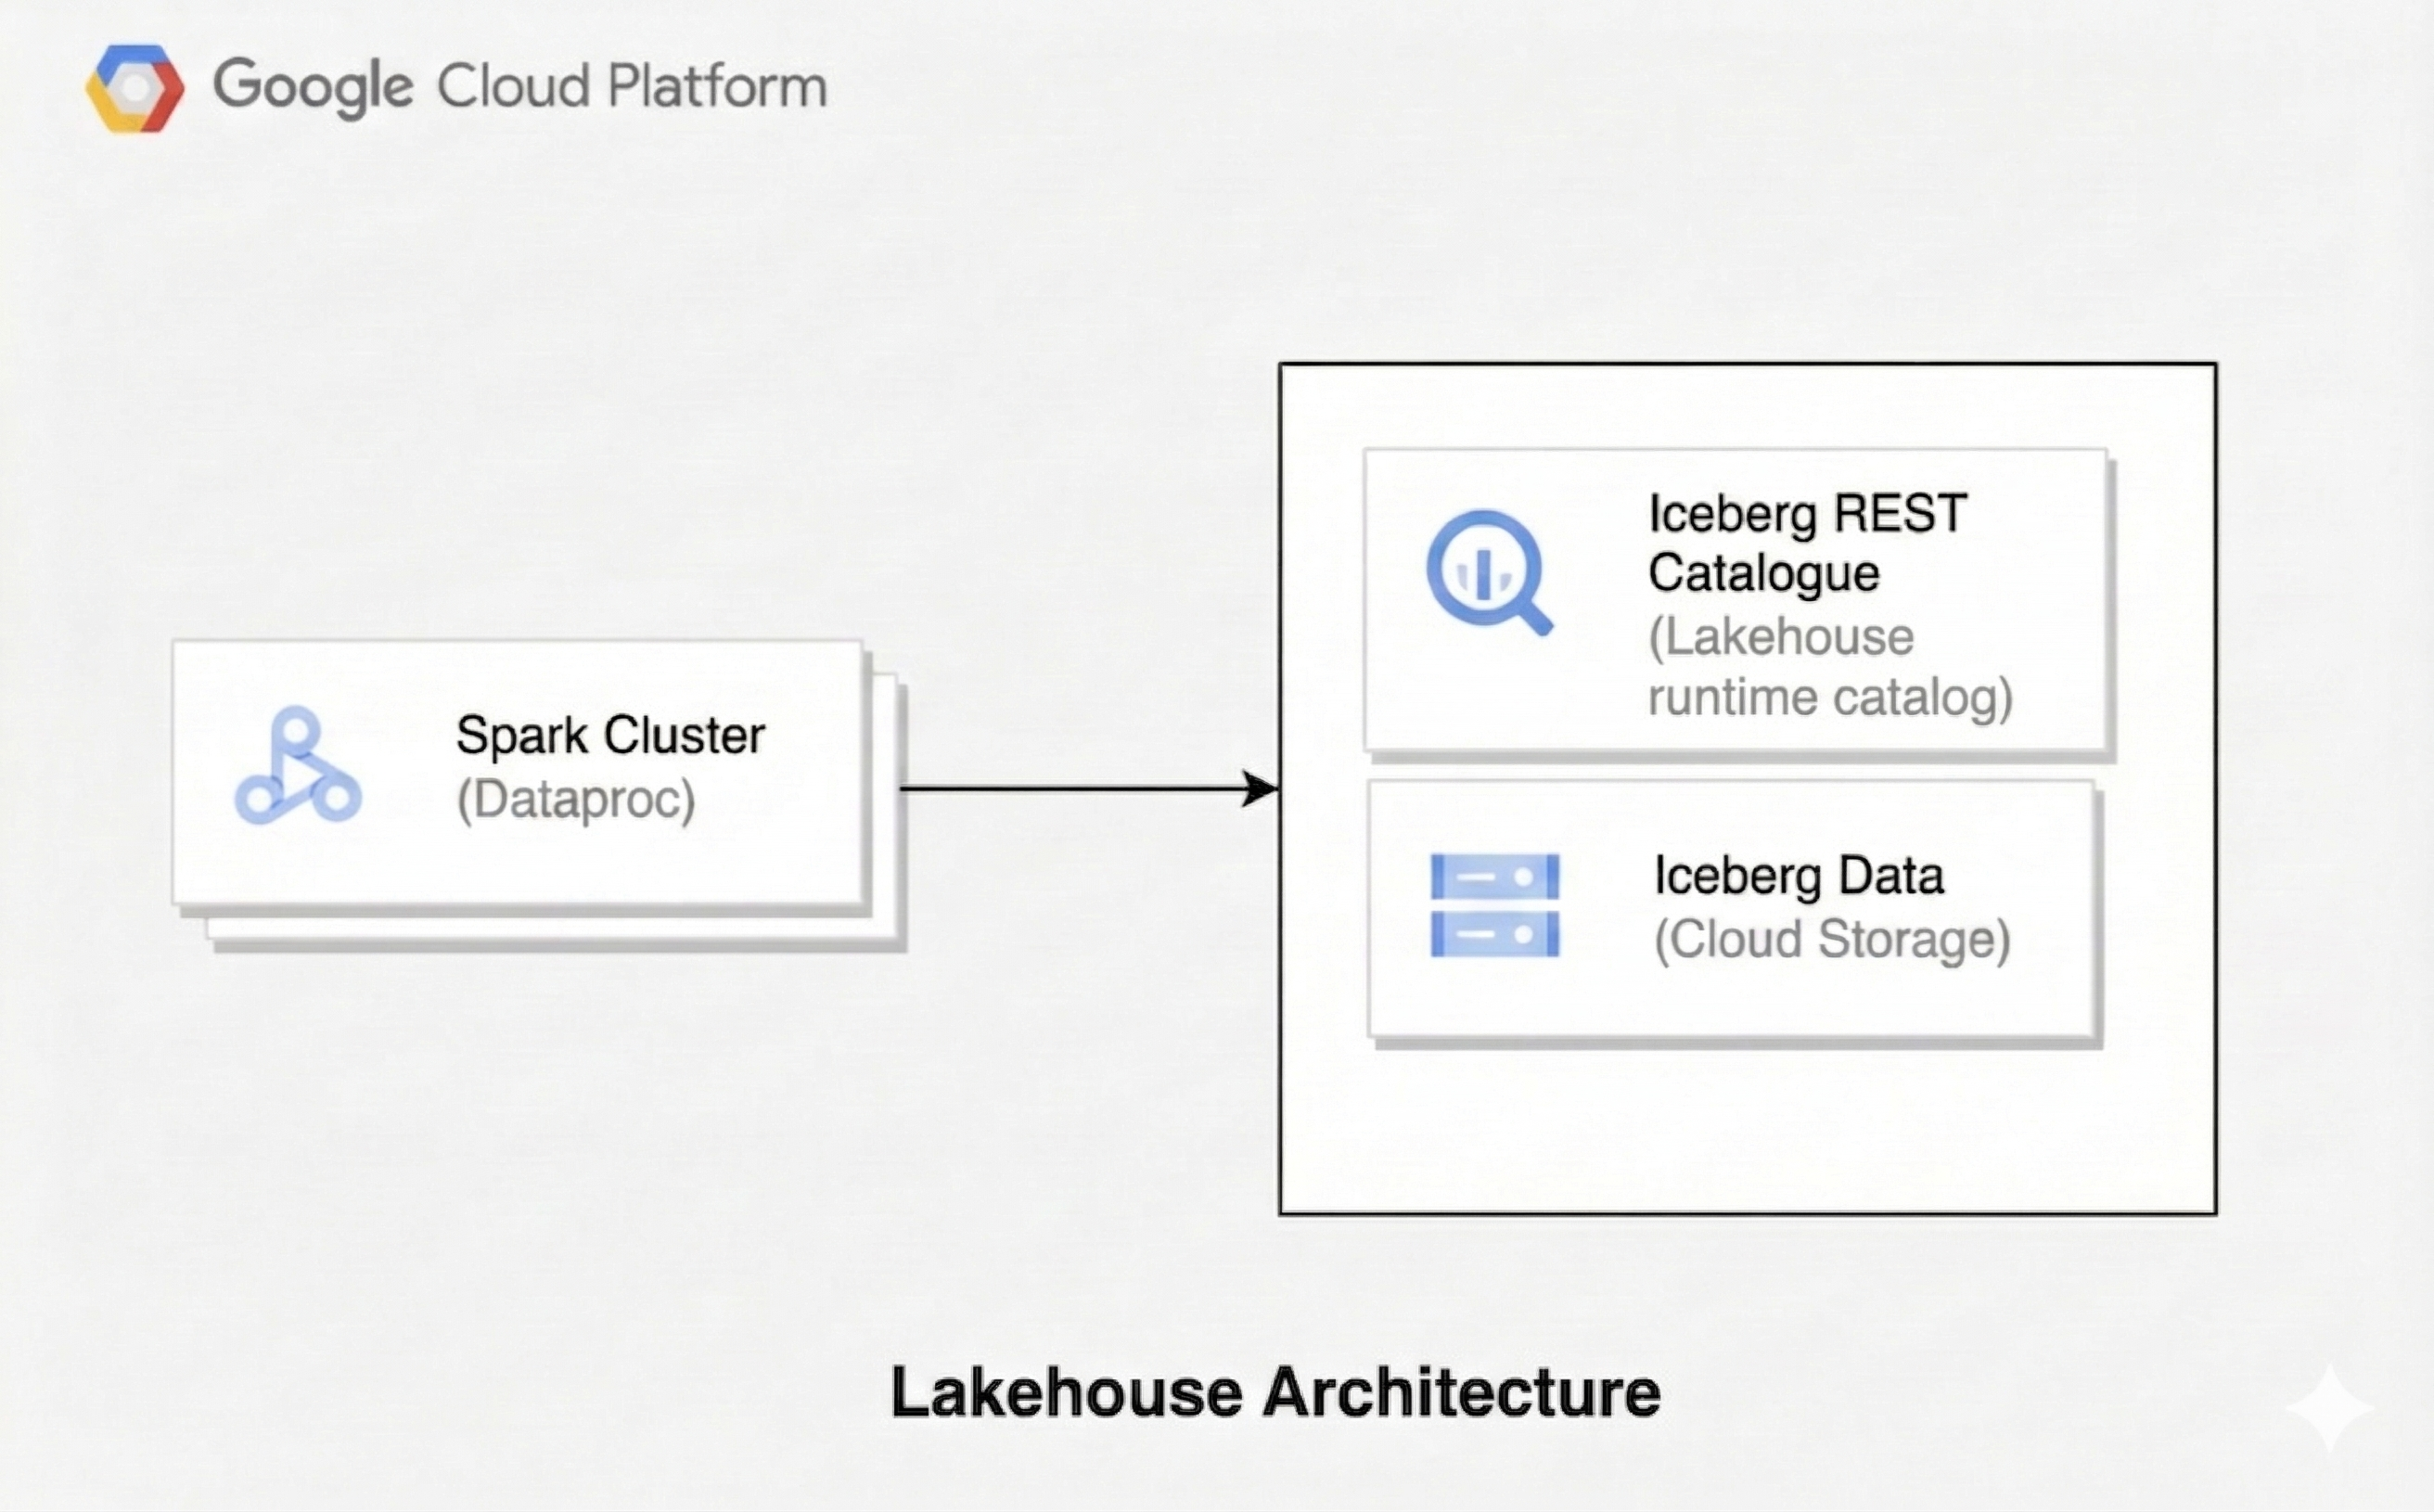
湖仓一体架构结合了数据湖的灵活性和数据仓库的数据管理功能。本文档介绍了如何在 上设置湖仓一体 Google Cloud。您可以使用 Apache Iceberg 作为表格式,使用 Managed Service for Apache Spark 进行处理,并使用 Lakehouse 运行时目录 Iceberg REST Catalog 进行统一元数据管理。
此架构使用 Iceberg 等开放表格式,将事务和架构演变等数据仓储功能添加到 Cloud Storage 中的数据。这种方法为您的数据创建了一个单一事实来源,各种引擎都可以访问该来源。
本文档介绍了您在 Lakehouse 运行时目录中创建的目录。如需通过 Lakehouse 运行时目录联合目录查询由 AWS Glue Data Catalog、Databricks Unity Catalog 或 Snowflake Horizon Catalog 管理的 Iceberg 表,请参阅 使用 Spark 查询联合目录。
准备工作
- 登录您的 Google Cloud 账号。如果您是新手 Google Cloud, 请创建一个账号来评估我们的产品在 实际场景中的表现。新客户还可获享 $300 赠金,用于 运行、测试和部署工作负载。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- 创建 Cloud Storage 存储桶 以存储 Iceberg 数据。
- 在 Lakehouse 运行时目录中创建 一个指向存储桶的目录。建议使用多存储桶目录。
所需角色
您需要拥有某些 Identity and Access Management (IAM) 角色才能运行此页面上的示例。根据组织政策,系统可能已授予这些角色。如需检查角色授予情况,请参阅 您是否需要授予角色?。
如需详细了解如何授予角色,请参阅 管理对项目、文件夹和组织的访问权限。
您需要的角色取决于工作负载的运行方式。
Managed Service for Apache Spark 集群和 Managed Service for Apache Spark 无服务器运行时 2.3 及更早版本以服务帐号身份运行工作负载。Managed Service for Apache Spark 无服务器运行时 3.0 及更高版本默认使用最终用户凭据 (EUC) 运行工作负载,因此您需要向用户账号(而不是服务帐号)授予数据访问角色。如果您为 3.0 或更高版本的运行时指定自定义服务帐号,则工作负载将使用服务帐号凭据运行。如需了解详情,请参阅
无服务器部署角色。
用户角色
如需获得创建 Managed Service for Apache Spark 集群、提交批量工作负载或创建交互式会话所需的权限,请让管理员向您授予以下 IAM 角色:
-
使用集群或无服务器运行时 2.3 或更早版本:
- Dataproc Editor (
roles/dataproc.editor) 项目的 - Compute Engine 默认服务帐号或自定义服务帐号的
Service Account User (
roles/iam.serviceAccountUser)
- Dataproc Editor (
-
使用无服务器运行时 3.0 或更高版本:
Dataproc Serverless Editor (
roles/dataproc.serverlessEditor) 项目的 -
在无服务器运行时 3.0 或更高版本上使用服务帐号凭证:
Service Account User (
roles/iam.serviceAccountUser) 自定义服务账号的
如果您使用 Managed Service for Apache Spark 无服务器运行时 3.0 或更高版本以及最终用户凭据(默认),还需要以下数据访问角色:
如需获得使用最终用户凭据读取和写入目录中的表所需的权限,请让管理员向您授予以下 IAM 角色:
-
在凭据自动售卖模式下读取和写入表数据:
BigLake Editor (
roles/biglake.editor) 包含目录的项目的 -
在非凭据自动售卖模式下管理目录资源和写入表数据:
- BigLake Editor (
roles/biglake.editor) 包含目录的项目的 - Storage Object User (
roles/storage.objectUser) 与目录关联的所有 Cloud Storage 存储桶
- BigLake Editor (
服务账号角色
向运行工作负载的服务帐号授予以下角色。
只有当工作负载使用服务帐号凭据运行时,Managed Service for Apache Spark 无服务器运行时 3.0 及更高版本才需要这些角色。
为确保 Compute Engine 默认服务帐号或自定义服务帐号拥有运行 Managed Service for Apache Spark 作业以及读取和写入目录中的表所需的 权限,请让管理员向 Compute Engine 默认服务帐号或自定义服务帐号授予以下 IAM 角色:
-
在集群或无服务器运行时 2.3 或更早版本上运行 Managed Service for Apache Spark 作业:
Dataproc Worker (
roles/dataproc.worker) on the project -
在无服务器运行时 3.0 或更高版本上运行 Managed Service for Apache Spark 作业:
- Dataproc Serverless Node (
roles/dataproc.serverlessNode) 项目的 - Dataproc Resource Manager Node Service Agent (
roles/dataprocrm.nodeServiceAgent) 项目的
- Dataproc Serverless Node (
-
在凭据自动售卖模式下读取和写入表数据:
BigLake Editor (
roles/biglake.editor) 包含目录的项目的 -
在非凭据自动售卖模式下管理目录资源和写入表数据:
- BigLake Editor (
roles/biglake.editor) 包含目录的项目的 - Storage Object User (
roles/storage.objectUser) 与目录关联的所有 Cloud Storage 存储桶
- BigLake Editor (
配置 Managed Service for Apache Spark 并创建 Spark 会话
将 Managed Service for Apache Spark 集群、Managed Service for Apache Spark 无服务器批量工作负载或 Managed Service for Apache Spark 无服务器交互式会话配置为使用 Lakehouse 运行时目录 Iceberg REST Catalog。这三者都支持
dataproc.lakehouse.catalog.CATALOG_NAME简化配置属性(推荐),该属性可让 Managed Service for Apache Spark
读取目录定义并生成 Iceberg REST
Catalog Spark 属性。只有集群表单采用 dataproc: 前缀。
简化配置和手动配置都使用 Google 授权进行 Iceberg (GoogleAuthManager),这需要以下版本之一:
- Managed Service for Apache Spark 集群:
2.2映像 版本2.2.65及更高版本,或2.3映像 版本2.3.11及更高版本。 - Managed Service for Apache Spark 无服务器批量工作负载和交互式
会话:
2.2运行时2.2.60及更高版本、2.3运行时2.3.10及更高版本,或3.0运行时。
对于无服务器批量工作负载和交互式会话,所需的角色取决于运行时版本。运行时 3.0 及更高版本默认使用最终用户凭据。如需了解详情,请参阅所需角色。
集群
使用简化配置属性(推荐)或通过在笔记本中手动指定目录属性,创建包含 Iceberg 和 Jupyter 可选组件的 Managed Service for Apache Spark 集群。
使用属性进行简化配置(推荐)
使用目录属性创建集群:
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
替换以下内容:
CLUSTER_NAME:集群的名称。PROJECT_ID:您的 Google Cloud 项目 ID。REGION:集群的 Google Cloud 区域,例如us-central1。IMAGE_VERSION:Managed Service for Apache Spark 映像版本,例如2.3-debian12。请参阅 支持的映像和运行时版本。CATALOG_NAME:本地 Spark 目录的名称,例如iceberg_catalog。它可以与CATALOG_ID相同。CATALOG_ID:您在准备工作中创建的目录 的 ID。
Lakehouse 运行时目录 Iceberg REST Catalog 正常运行不需要 dataproc:dataproc.lineage.enabled=true 属性。在
数据沿袭示例中,添加该属性是为了进行沿袭跟踪。
使用 Jupyter 笔记本(Vertex AI Workbench 笔记本或在集群上启动的笔记本)连接到集群,并创建 SparkSession 而不指定目录配置:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
将 APP_NAME 替换为 Spark 应用的名称。
手动配置
如果您不使用简化配置属性,请按照前面的说明创建集群,而不在 --properties 标志中添加 dataproc:dataproc.lakehouse.catalog.,连接到 Jupyter 笔记本,然后手动配置 SparkSession,如下所示:
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
替换以下内容:
CATALOG_NAME:本地 Spark 目录的名称,例如iceberg_catalog。APP_NAME:Spark 应用的名称。WAREHOUSE_PATH:仓库的路径。对于多存储桶目录(推荐),请使用bl://projects/PROJECT_ID/catalogs/CATALOG_ID. 对于单存储桶目录,请使用gs://CLOUD_STORAGE_BUCKET_NAME。PROJECT_ID:您的 Google Cloud 项目 ID。
使用凭据自动售卖进行配置
如需使用凭据自动售卖,您必须使用
凭据自动售卖模式下的目录
,并通过向
SparkSession构建器添加以下行,将X-Iceberg-Access-Delegation标头添加到值为
vended-credentials的 Iceberg REST Catalog 请求:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
以下示例使用凭据自动售卖配置 SparkSession:
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
当目录使用凭据自动售卖模式时,简化配置会添加此标头。如需了解详情,请参阅 Iceberg 文档的
部分中的 RESTCatalog
标头。
无服务器
使用简化配置属性(推荐)或通过手动指定目录属性,向 Managed Service for Apache Spark 无服务器提交 PySpark 批量工作负载。
使用属性进行简化配置(推荐)
提交批量工作负载时,传递 dataproc.lakehouse.catalog.CATALOG_NAME
属性(不带 dataproc: 前缀):
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
替换以下内容:
PYSPARK_FILE:PySpark 应用文件的gs://Cloud Storage 路径。PROJECT_ID:您的 Google Cloud 项目 ID。REGION:批量工作负载的区域。RUNTIME_VERSION:Managed Service for Apache Spark 无服务器运行时版本,例如3.0。所需的角色取决于运行时 版本(请参阅 支持的映像和运行时版本)。CATALOG_NAME:本地 Spark 目录的名称,例如iceberg_catalog。它可以与CATALOG_ID相同。CATALOG_ID:您在准备工作中创建的目录 的 ID。
在 PySpark 应用文件中,创建 SparkSession 而不指定目录配置:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
手动配置
如果您不使用简化配置属性,请在提交批量工作负载时在 --properties 标志中指定目录属性:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
将 WAREHOUSE_PATH 替换为仓库的路径。对于多存储桶目录(推荐),请使用
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
对于单存储桶目录,请使用
gs://CLOUD_STORAGE_BUCKET_NAME。
使用凭据自动售卖进行配置
如需使用凭据自动售卖,您必须使用
凭据自动售卖模式下的目录
,并通过向
--properties标志添加以下属性,将
X-Iceberg-Access-Delegation标头添加到值为
vended-credentials的 Iceberg REST Catalog 请求:
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials以下示例使用凭据自动售卖提交批量工作负载:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
当目录使用凭据自动售卖模式时,简化配置会添加此标头。如需了解详情,请参阅 Iceberg 文档的
部分中的 RESTCatalog
标头。
无服务器
使用简化配置属性(推荐)或通过手动
指定目录属性,从
笔记本使用
DataprocSparkSession
API 创建 Managed Service for Apache Spark 无服务器交互式会话。
使用属性进行简化配置(推荐)
在安装了 dataproc-spark-connect 软件包的笔记本(例如
BigQuery Studio 笔记本或 Vertex AI Workbench
笔记本)中,创建会话时传递
dataproc.lakehouse.catalog.CATALOG_NAME 属性
(不带 dataproc: 前缀):
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
替换以下内容:
CATALOG_NAME:本地 Spark 目录的名称,例如iceberg_catalog。它可以与CATALOG_ID相同。RUNTIME_VERSION:Managed Service for Apache Spark 无服务器运行时版本,例如3.0。所需的角色取决于运行时 版本(请参阅 支持的映像和运行时版本)。APP_NAME:Spark 应用的名称。PROJECT_ID:您的 Google Cloud 项目 ID。CATALOG_ID:您在准备工作中创建的目录 的 ID。
您还可以在 会话模板中设置这些属性。
手动配置
如果您不使用简化配置属性,请在创建会话时指定目录属性:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
按照此标签页中前面简化配置示例中的说明替换 RUNTIME_VERSION。
将 WAREHOUSE_PATH 替换为仓库的路径。对于多存储桶目录(推荐),请使用
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
对于单存储桶目录,请使用
gs://CLOUD_STORAGE_BUCKET_NAME。
使用凭据自动售卖进行配置
如需使用凭据自动售卖,您必须使用
凭据自动售卖模式下的目录
,并通过向
会话构建器添加以下行,将 X-Iceberg-Access-Delegation 标头添加到
值为
vended-credentials 的 Iceberg REST Catalog 请求:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
以下示例使用凭据自动售卖创建会话:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
当目录使用凭据自动售卖模式时,简化配置会添加此标头。如需了解详情,请参阅 Iceberg 文档的
部分中的 RESTCatalog
标头。
使用 Spark SQL 管理数据
配置 Spark 会话后,使用 Spark SQL 执行数据管理操作。
设置目录: dataproc.lakehouse.catalog. 属性会将目录注册到 Spark,但不会将其设为默认目录。 上一部分中的示例设置了 spark.sql.defaultCatalog
(spark:spark.sql.defaultCatalog 集群上的) 以便您可以使用
非限定表名。如果您省略该属性,请使用
目录名称限定表名,例如
CATALOG_NAME.NAMESPACE_NAME.base_table。
创建命名空间。在 Lakehouse 运行时目录 Iceberg REST Catalog 中,命名空间对应于 BigQuery 数据集。
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
将
NAMESPACE_NAME替换为命名空间的名称,例如spark_lakehouse。以 Iceberg 格式创建基表并插入数据。
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
输出类似于以下内容:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
为新数据创建另一个表。
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
输出类似于以下内容:
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
将新数据合并到基表中。
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
输出类似于以下内容:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
更新基表中的记录。
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
输出类似于以下内容:
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
从基表中删除记录。
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
输出类似于以下内容:
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
查询历史快照
通过查询快照 ID 检索表的先前版本。此操作也称为“时间旅行”。
检索
MERGE、UPDATE和DELETE操作之前的表版本的快照 ID。snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]将
NAMESPACE_NAME替换为您创建的命名空间。使用检索到的快照 ID 查询表。
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
输出显示了
MERGE操作之后但在UPDATE或DELETE操作之前的表状态。+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
发现数据沿袭
使用 Managed Service for Apache Spark 2.2 及更高版本的映像版本,
您可以使用数据沿袭跟踪 Lakehouse 运行时目录
Iceberg REST Catalog 表之间的数据移动。
数据沿袭示例
创建源 Iceberg 表和目标 Iceberg 表,然后复制数据。
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
在 Google Cloud 控制台中,前往 Knowledge Catalog 搜索 页面。
搜索其中一个表,然后点击
Lineage标签页: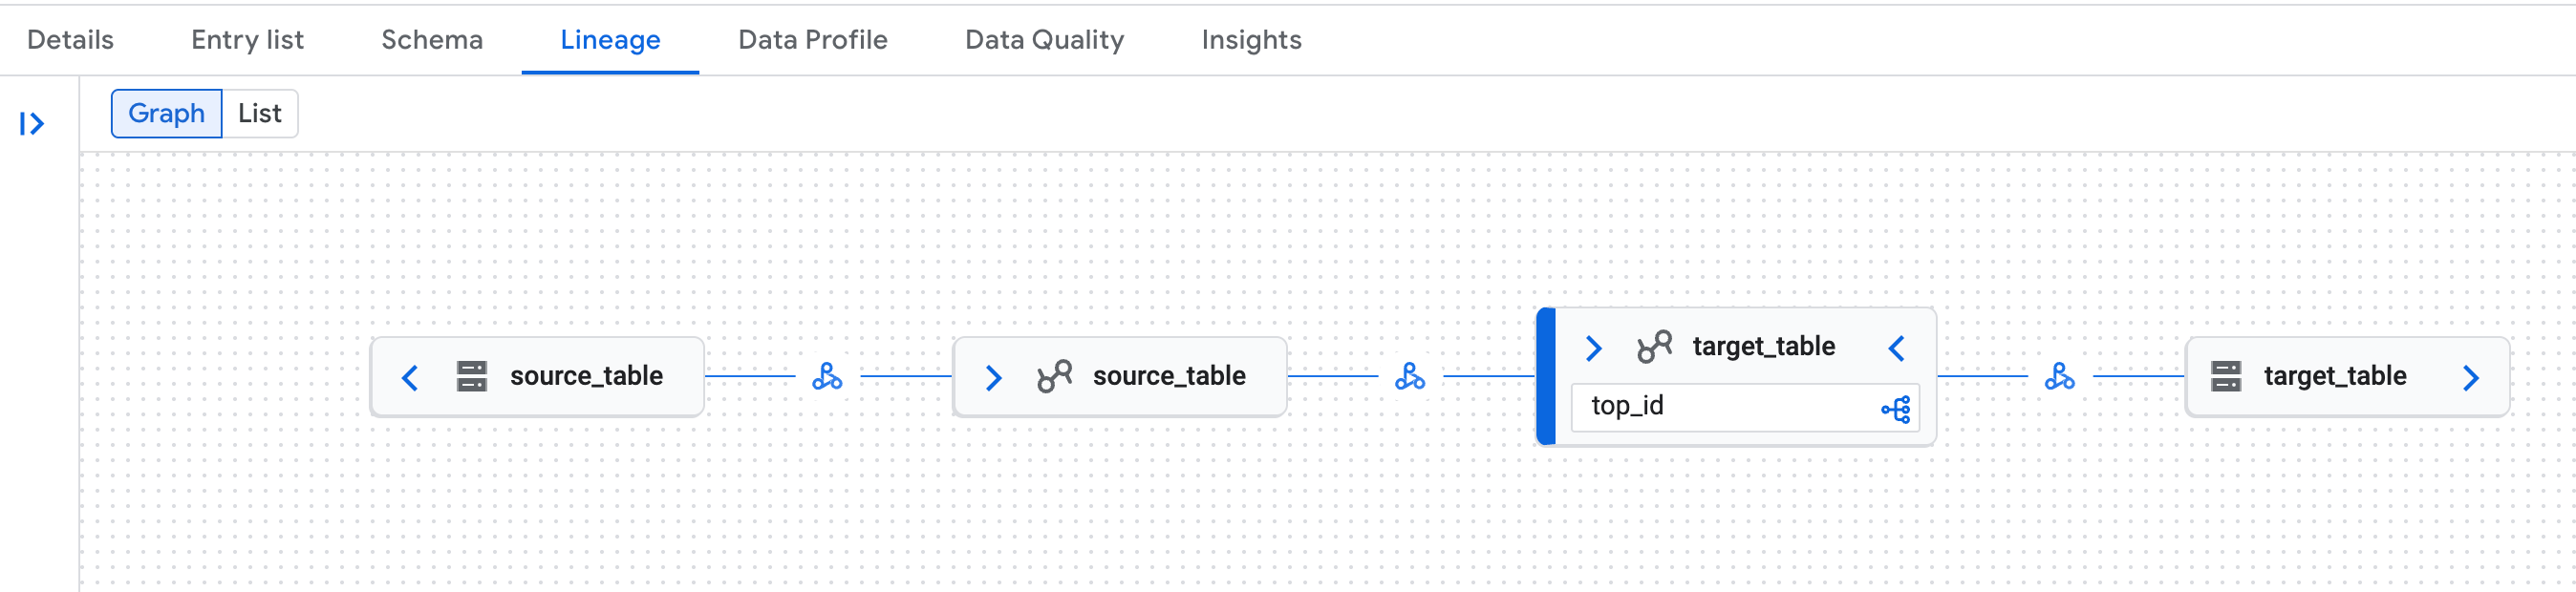
控制台中的 Knowledge Catalog 页面中的数据沿袭图示例。 Google Cloud 数据沿袭可识别 Lakehouse 运行时目录 Iceberg REST Catalog 表的逻辑(Lakehouse 运行时目录表)和物理 (Cloud Storage) 表示形式。
数据沿袭已知问题
在某些 Managed Service for Apache Spark 集群中,由于 OpenLineage 库问题,可能无法生成完整的数据沿袭。这是一个已知限制。如果它影响您的工作负载,请与 Google Cloud 支持团队联系。
后续步骤
- 详细了解 Lakehouse 运行时目录 Iceberg REST Catalog。
- 使用 Spark 查询联合目录。
- 探索 Apache Iceberg 的功能。
- 了解如何从 Lakehouse 运行时目录查询 Iceberg 数据。
- 详细了解 数据沿袭和 Managed Service for Apache Spark。