


Ce document explique comment migrer vos charges de travail Apache Kafka vers Managed Service pour Apache Kafka.
L'approche présentée dans ce document utilise Kafka Connect avec MirrorMaker 2.0. Kafka Connect est un framework permettant de connecter Kafka à des systèmes externes, et MirrorMaker 2.0 est un outil permettant de répliquer des données entre des clusters Kafka en temps réel.
Architecture
Le diagramme suivant illustre l'architecture de migration des données vers Managed Service pour Apache Kafka :
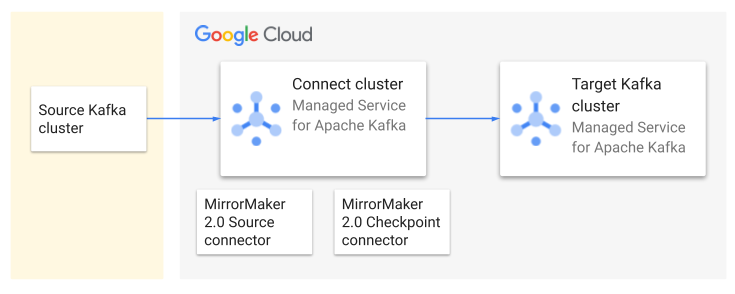
L'architecture se compose des éléments suivants :
Cluster Kafka source : votre cluster Kafka existant, qui peut être situé sur site ou dans un autre environnement cloud. Il contient les thèmes que vous souhaitez migrer.
Cluster Kafka cible : cluster Managed Service pour Apache Kafka vers lequel vous allez déplacer vos données Kafka.
Cluster Connect : déploiement distribué de Kafka Connect associé au cluster Kafka cible.
Connecteur source MirrorMaker 2.0 : réplique les sujets du cluster source vers le cluster cible. Il crée automatiquement les rubriques et partitions correspondantes dans le cluster cible si elles n'existent pas. Il configure également les LCA des thèmes sur le cluster cible pour qu'ils correspondent à ceux des thèmes sources.
Connecteur de point de contrôle MirrorMaker 2.0. Réplique les décalages des clients afin que les clients puissent passer au cluster Kafka secondaire et lire à partir du même point où ils se sont arrêtés.
Workflow de haut niveau
Cette section décrit le workflow général du processus de migration.
Planifier la migration
Documentez votre configuration Kafka existante, y compris la taille des clusters, les sujets, le débit et les groupes de consommateurs.
Planifiez votre stratégie de migration, y compris la façon dont vous allez transférer les charges de travail actives vers le nouveau cluster.
Estimez la taille de cluster requise. Ce calcul vous donne une taille initiale pour votre cluster Managed Service pour Apache Kafka, afin de vous assurer qu'il dispose de suffisamment de ressources pour exécuter vos charges de travail. Vous pourrez effectuer un scaling à la hausse du cluster ultérieurement, si nécessaire.
Migrer les données
Créez Google Cloud des ressources, y compris un cluster Managed Service pour Apache Kafka, un cluster Connect et les connecteurs MirrorMaker 2.0 qui répliquent vos données.
Une fois que vous avez vérifié que les sujets et les groupes de consommateurs sont répliqués, migrez les consommateurs et les producteurs vers le cluster Managed Service pour Apache Kafka.
Passer au nouveau cluster
Validez l'intégrité des données et la fonctionnalité de l'application avec le cluster Managed Service pour Apache Kafka.
Effectuez la bascule finale en redirigeant le trafic vers le cluster Managed Service pour Apache Kafka.
Mettez hors service votre ancien cluster Kafka.
Surveiller
Surveillez en continu les performances de votre cluster Managed Service pour Apache Kafka. Pour en savoir plus, consultez Surveiller un cluster Managed Service pour Apache Kafka.
Vérifiez et mettez à jour la documentation pour refléter les modifications.
Documenter votre configuration Kafka
Avant de lancer une migration, documentez votre configuration Kafka actuelle. Rassemblez les informations suivantes :
Vérifiez la version de votre cluster Apache Kafka. MirrorMaker 2.0 nécessite que le cluster soit en version 2.4.0 ou ultérieure.
Identifiez les thèmes à migrer. Documentez également le facteur de réplication et le nombre de partitions de chaque sujet.
Mesurez le débit de messages au niveau du cluster et du thème.
Identifiez les producteurs et les consommateurs associés à chaque thème. Pour les consommateurs, identifiez tous les groupes de consommateurs.
Documentez les configurations des consommateurs, en particulier les protocoles de sécurité et toute intégration avec d'autres services Google Cloud .
Grâce à ces informations, vous pouvez calculer la taille requise du cluster Managed Service pour Apache Kafka et choisir les paramètres de configuration des connecteurs MirrorMaker 2.0.
Pour éviter toute interruption pendant la migration, cartographiez toutes les dépendances d'application liées à votre cluster Kafka source.
Planifier la stratégie de migration
Cette section présente quelques considérations opérationnelles pour la migration de vos données Kafka. Pour minimiser les temps d'arrêt pendant le processus de migration, envisagez les stratégies suivantes :
Déploiements parallèles : avant de passer au nouveau cluster, exécutez des instances parallèles de vos applications sur les anciens et nouveaux clusters. Pendant cette période de transition, désactivez temporairement toutes les actions de votre application qui ne doivent se produire qu'une seule fois par message, afin d'éviter les conséquences indésirables du traitement du même message deux fois. Une fois les nouvelles instances entièrement synchronisées, redirigez tout le trafic vers le nouveau cluster et réactivez toutes les fonctionnalités.
Déploiements progressifs : migrez par étapes plus petites et plus faciles à gérer, en commençant par les applications les moins critiques. Cette approche permet d'isoler les problèmes potentiels et de minimiser l'impact des éventuelles perturbations.
Déploiements bleu et vert : créez une réplique complète de votre environnement de production (vert) à côté de l'environnement existant (bleu). Déplacez progressivement le trafic du bleu vers le vert. Testez et validez le nouvel environnement de production avant le basculement final. Cette approche minimise les temps d'arrêt, mais nécessite plus de ressources lors de la migration.
Dry run. Avant de migrer votre environnement de production, effectuez une migration test dans un environnement de développement. Validez le processus et identifiez les problèmes potentiels.
Voici quelques éléments supplémentaires à prendre en compte lorsque vous planifiez une migration :
Exigences de traitement des messages : comprenez la tolérance de votre application aux messages en double ou manquants, et configurez les consommateurs en conséquence.
Communication et coordination : définissez des canaux de communication clairs et coordonnez les délais de transition.
Rétrograder Créez un plan de rollback pour revenir à votre cluster d'origine si nécessaire.
Estimer la taille du cluster
Pour estimer la mémoire et le nombre de vCPU nécessaires pour votre cluster Managed Service pour Apache Kafka, commencez par calculer le débit d'écriture et de lecture total de vos charges de travail. Vous pouvez utiliser les métriques JMX suivantes pour mesurer ces valeurs :
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: taux d'octets entrants des clients pour tous les thèmes. Pour obtenir le taux agrégé pour tous les thèmes, omettez le paramètretopic={...}.kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: débit d'octets sortants vers les clients pour tous les thèmes. Pour obtenir le taux global, omettez le paramètretopic={...}.
Ces métriques sont enregistrées au niveau du courtier. Pour calculer le débit du cluster, agrégez les données de tous les courtiers.
En surveillant ces métriques JMX sur une période donnée, vous pouvez collecter des points de données pour calculer les métriques suivantes :
Débit moyen des données entrantes (en Mo/s) : débit moyen auquel les données sont ingérées dans le cluster Kafka.
Débit de données maximal en entrée (MB/s) : débit maximal auquel les données sont ingérées dans le cluster Kafka.
Débit moyen des données sortantes (Mo/s) : débit moyen auquel les données sont consommées à partir du cluster Kafka.
Débit de données maximal (Mo/s) : débit maximal auquel les données sont consommées à partir du cluster Kafka.
À l'aide de ces valeurs calculées, estimez le taux d'équivalent d'écriture comme suit :
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
Le taux équivalent en écriture tient compte du fait que la bande passante en lecture est plus efficace à traiter que la bande passante en écriture. Utilisez le taux équivalent en écriture pour choisir une taille appropriée pour votre cluster Managed Service pour Apache Kafka. Pour en savoir plus, consultez Planifier la taille de votre cluster Kafka.
Connecter Apache Kafka sur site à Google Cloud
Si votre cluster Apache Kafka source est situé sur site, vous devez établir une connexion sécurisée entre votre réseau sur site et le cloud privé virtuel (VPC) où réside votre cluster Managed Service pour Apache Kafka. Utilisez l'une des options suivantes à partir de Google Cloud.
Cloud VPN : solution économique adaptée aux besoins de bande passante plus faibles ou aux premiers tests de migration. Il crée un tunnel chiffré sur l'Internet public. Pour en savoir plus sur Cloud VPN, consultez la présentation de Cloud VPN.
Cloud Interconnect : fournit une connexion dédiée à bande passante élevée entre votre réseau sur site et Google Cloud. Il est idéal pour les déploiements de niveau Enterprise qui nécessitent un débit plus élevé et une latence plus faible. Vous pouvez choisir entre interconnexion dédiée (pour une connexion physique directe) et interconnexion partenaire (connexion via un fournisseur de services compatible). Pour en savoir plus, consultez la présentation de Cloud Interconnect.
Lorsque vous créez un cluster Managed Service pour Apache Kafka, vous devez sélectionner au moins un sous-réseau dans votre réseau VPC. Ce sous-réseau fournit les adresses IP que votre cluster utilise pour communiquer avec d'autres ressources de votre réseau VPC.
Pour vous connecter de manière sécurisée à votre cluster Managed Service for Apache Kafka depuis des réseaux sur site ou d'autres réseaux VPC, vous pouvez utiliser Private Service Connect sur Cloud VPN ou Cloud Interconnect. Vous n'avez pas besoin de configurer explicitement les points de terminaison Private Service Connect. Lorsque vous sélectionnez un sous-réseau lors de la création du cluster, le service Managed Service pour Apache Kafka crée automatiquement les points de terminaison Private Service Connect nécessaires. Cela simplifie la configuration du réseau en vous permettant d'accéder à votre cluster à l'aide d'adresses IP internes dans votre réseau VPC, sans avoir à gérer des règles de pare-feu complexes ni des adresses IP publiques.
Pour en savoir plus, consultez Mise en réseau pour Managed Service pour Apache Kafka.
Créer des ressources Google Cloud
Créez les ressources suivantes :
Cluster Managed Service pour Apache Kafka. Pour en savoir plus, consultez Créer et afficher un cluster Managed Service pour Apache Kafka.
Un cluster Connect dont le cluster Kafka principal est le cluster que vous avez créé à l'étape précédente. Pour en savoir plus, consultez Créer un cluster Connect.
Placez le cluster Connect dans la même région que le cluster Managed Service pour Apache Kafka.
Un connecteur source MirrorMaker 2.0 pour répliquer les données. Pour en savoir plus, consultez Créer un connecteur source MirrorMaker 2.0.
Un connecteur de point de contrôle MirrorMaker 2.0 pour répliquer les points de contrôle des clients. Pour en savoir plus, consultez Créer un connecteur de point de contrôle MirrorMaker 2.0.
Paramètres MirrorMaker 2.0
Les paramètres suivants déterminent la fréquence à laquelle les points de contrôle sont créés et répliqués, ce qui peut avoir une incidence sur la précision de la traduction des décalages de consommateur entre les clusters.
Clients :
auto.commit.interval.ms: fréquence à laquelle un consommateur valide des décalages.
Connecteur source MirrorMaker 2.0 :
offset.lag.max: fréquence à laquelle le connecteur source écrit les synchronisations de décalage.
Connecteur de point de contrôle MirrorMaker 2.0 :
sync.group.offsets.enabled: si la valeur esttrue, le connecteur Checkpoint copie les points de contrôle d'un sujet interne vers le sujet__consumer_offsetsutilisé par les consommateurs. Pour permettre aux consommateurs de basculer facilement, définissez cette propriété surtrue.emit.checkpoints.interval.seconds: fréquence à laquelle le connecteur Checkpoint écrit les points de contrôle.sync.group.offsets.interval.seconds: fréquence à laquelle le connecteur Checkpoint copie les points de contrôle dans__consumer_offsets.
Pour en savoir plus, consultez Fonctionnement du connecteur de point de contrôle MirrorMaker 2.0.
Surveiller la réplication des données
Surveillez le processus MirrorMaker 2.0 pour vous assurer qu'il s'exécute correctement et qu'il réplique les données comme prévu. Pour en savoir plus, consultez Surveiller un cluster Connect.
Après avoir migré vos applications, surveillez les métriques suivantes pour valider la réussite de la migration :
Débits descendants : assurez-vous qu'il n'y a pas de changements importants dans les débits descendants.
Utilisation du processeur et de la mémoire : surveillez l'utilisation du processeur et de la mémoire de votre cluster Managed Service pour Apache Kafka. Pour en savoir plus, consultez Surveiller la fiabilité des clusters Kafka.
Journaux d'erreurs : vérifiez régulièrement Cloud Logging pour détecter les journaux d'erreurs liés à votre cluster Managed Service pour Apache Kafka ou à vos applications.
Étapes suivantes
- Présentation de Kafka Connect
- Répliquer des sujets Kafka avec MirrorMaker 2.0
- Surveiller un cluster Managed Service pour Apache Kafka