


總覽
這份解決方案參考架構 (SRA) 定義概念設計、元件拓撲和技術界線,用於在 Distributed Cloud 軟體專屬獨立叢集上,代管、提供及驗證開放權重的大型語言模型 (LLM)。
企業邊緣環境通常需要低延遲推論和嚴格的資料主權。這份解決方案參考架構提供標準化、安全且可觀測的服務堆疊,可在配備客戶來源 NVIDIA RTX PRO 6000 GPU (96 GB VRAM) 的單一節點 Distributed Cloud 軟體專屬叢集上,部署 Gemma 4 31B 模型。
特點與功能
- 本機模型服務:在 Distributed Cloud 軟體專屬叢集邊界內,公開與 OpenAI 相容的業界標準 API。
- 支援大型邊緣模型:經過最佳化,可使用原生精確度 (BF16) 或量化格式執行 Gemma 4 31B,充分運用 96 GB VRAM 容量。
- 可觀測性:僅與 Distributed Cloud 軟體的監控基礎架構 (Google Cloud Managed Service for Prometheus) 整合,使用原生
PodMonitoring資源匯出 GPU 遙測資料和 vLLM 效能指標,因此不需要獨立的本機 Prometheus 伺服器。 - 互動式驗證:部署以 Gradio 為基礎的網頁介面,立即以視覺化方式驗證模型回應。
架構原則
- 簡單易用且可攜性高:採用 Kubernetes 原生建構 (部署、服務) 標準,而非複雜的服務運算子,確保單一節點設定的部署和維護作業簡單易行。
- 資料主權:所有推論流量、提示和回應資料都會嚴格保留在當地叢集範圍內。
- 資源隔離:將實體 GPU 加速器專用於單一提供模型執行個體,避免資源爭用,並確保延遲時間可預測。
架構與設計
元件
解決方案元件包括:
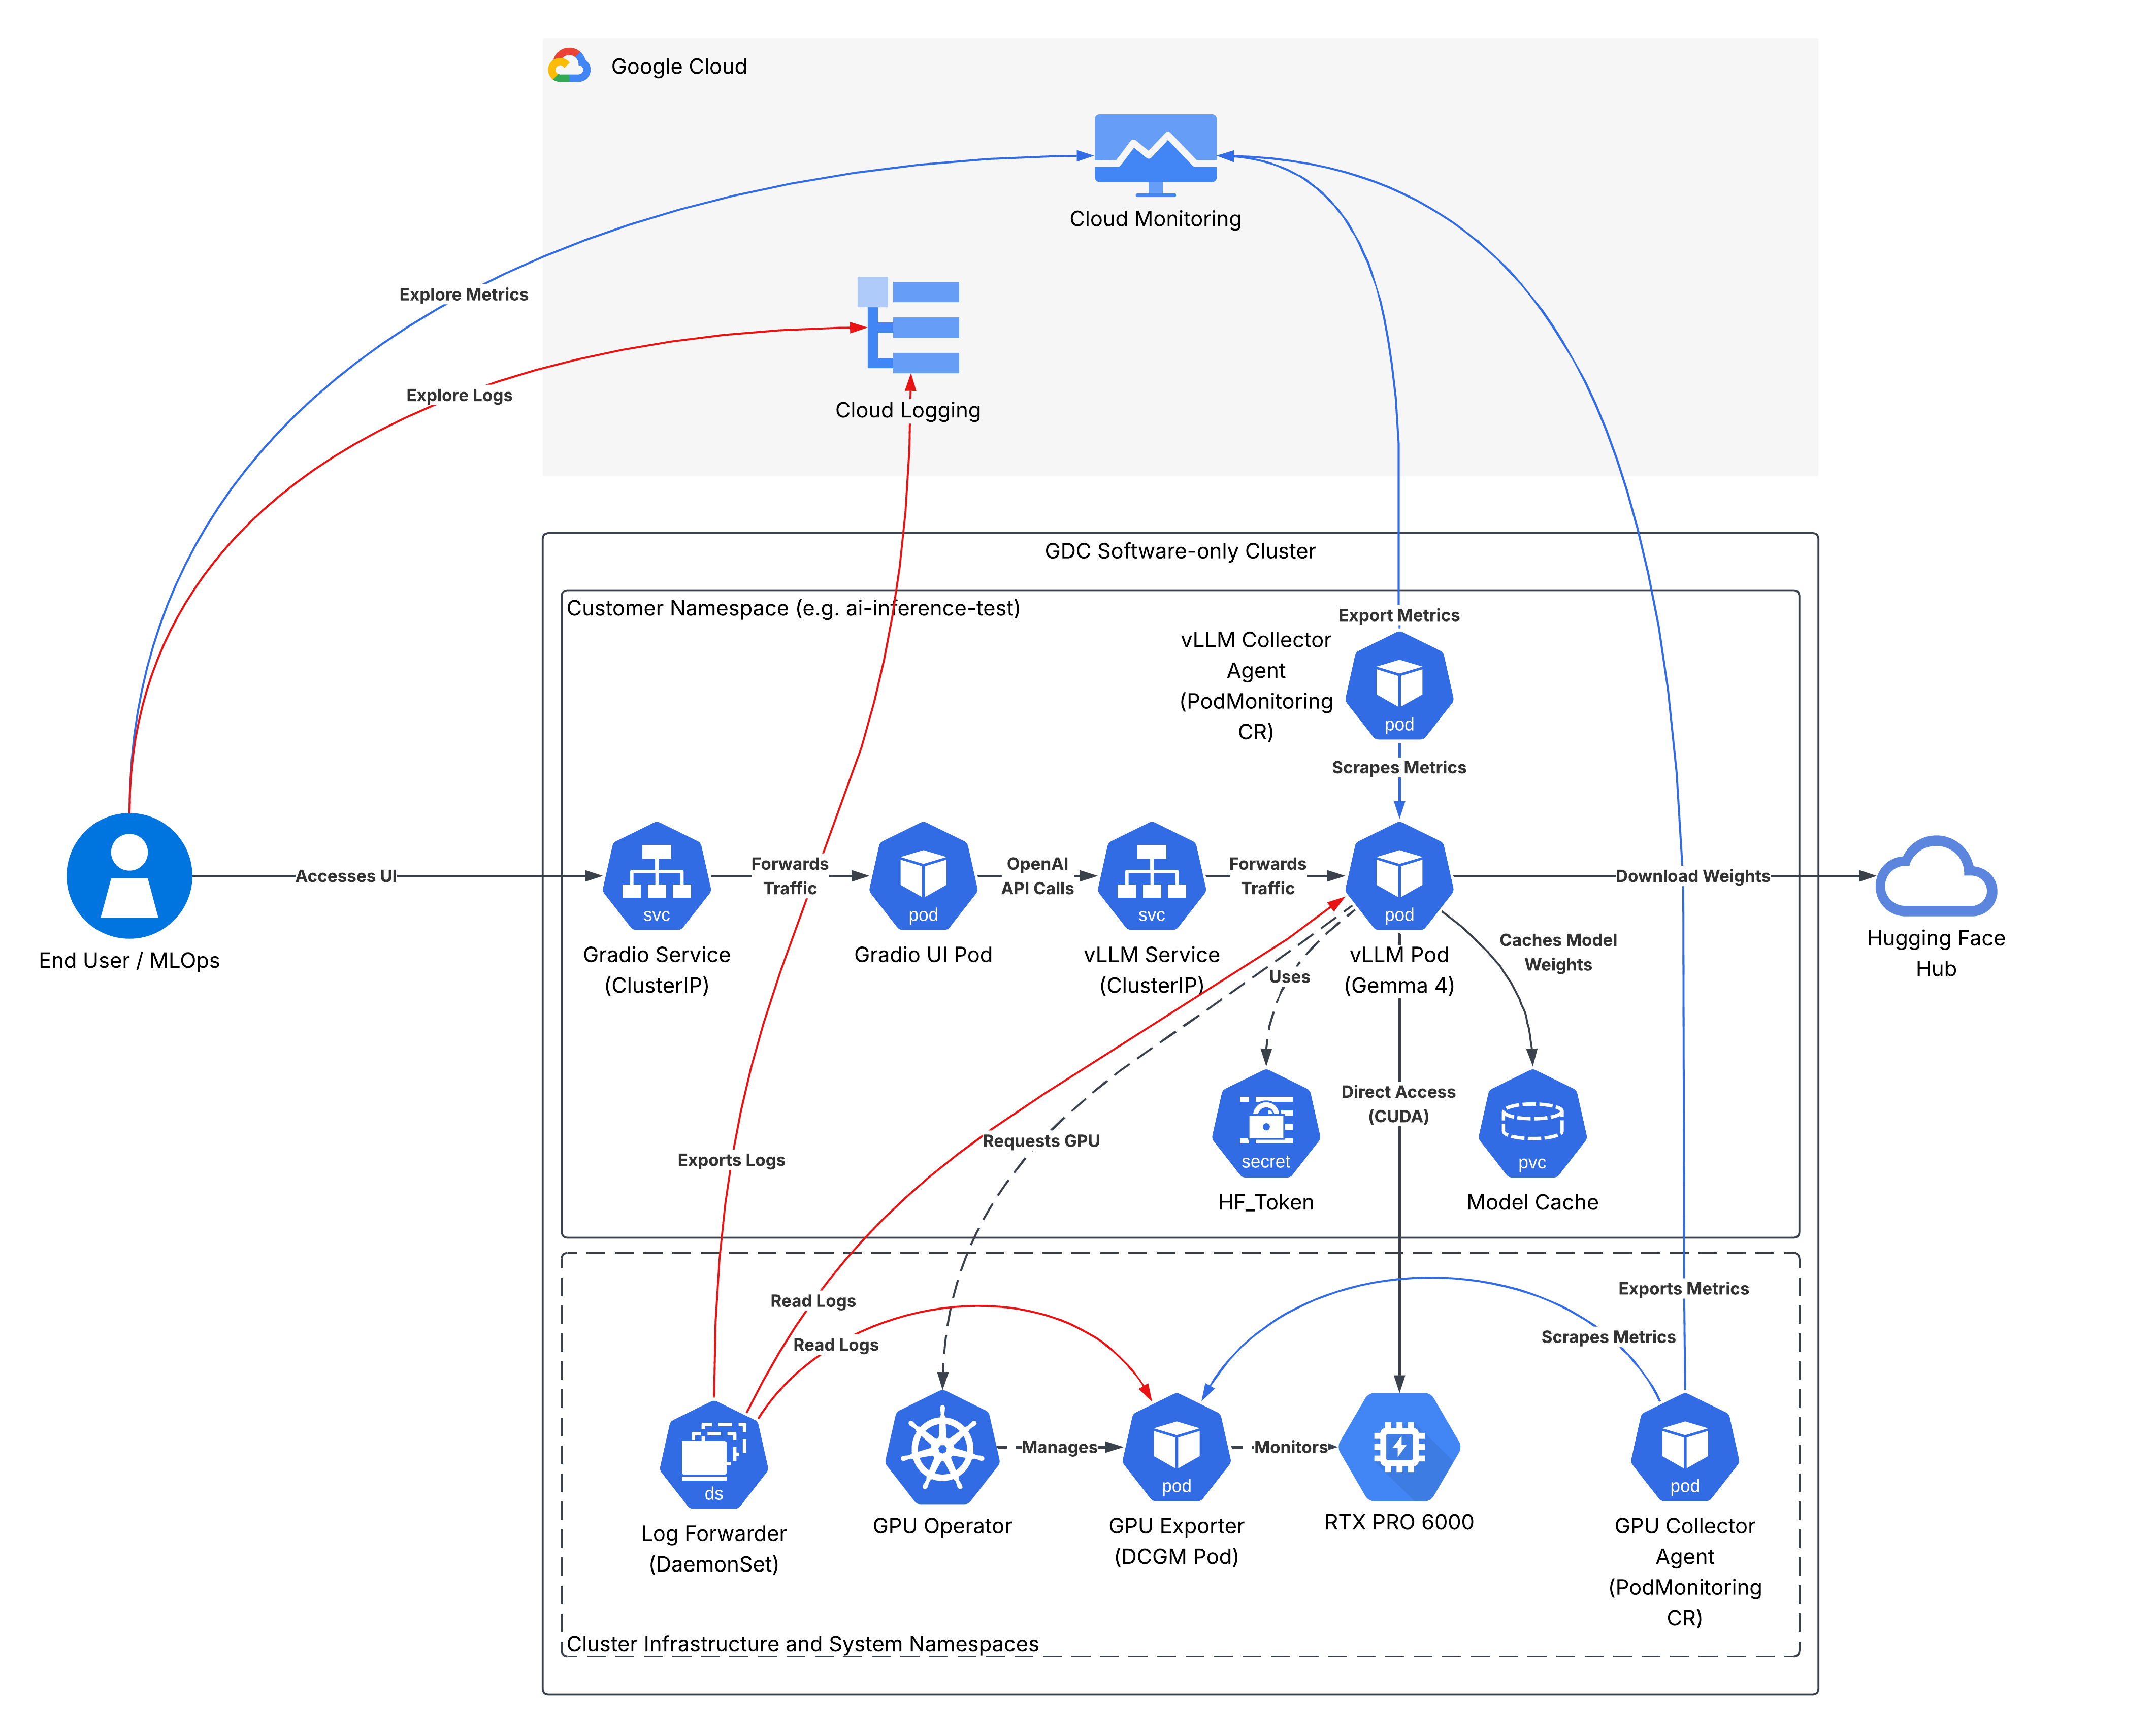
- 客戶命名空間 (僅限 Distributed Cloud 軟體叢集):
- vLLM 服務引擎:部署為 Kubernetes Deployment,執行 vLLM 容器。設定為從永久儲存空間載入 Gemma 權重,並公開與 OpenAI 相容的 API。
- Gradio 網頁介面:部署為 Kubernetes Deployment,提供驗證用的即時通訊介面 (選用:也可以在開發人員工作站或連線至叢集 vLLM 服務的測試執行階段外部執行)。
- 永久磁碟區聲明 (PVC):僅由 Distributed Cloud 軟體支援,使用本機共用儲存空間 (使用
local-sharedStorageClass) 來代管模型權重。 - Kubernetes Service:vLLM API 端點的 ClusterIP 服務;Gradio UI 的 NodePort 或 LoadBalancer 服務,可將其公開至客戶網路。
- 基礎架構 (客戶管理):
- NVIDIA GPU 運算子:協調實體 GPU 資源,並僅向 Kubernetes 工作節點公開這些資源,以供 Distributed Cloud 軟體使用。
- NVIDIA RTX PRO 6000 GPU:基礎實體加速器 (96 GB GDDR7 記憶體架構)。
- Google Cloud 整合:
- Google Cloud Monitoring & Logging:預設 Distributed Cloud 軟體僅限代理程式,可收集及轉送系統記錄、容器記錄和基本指標至Google Cloud。
高階架構總覽
下圖說明 Distributed Cloud (僅限軟體) 叢集內的要求流程和元件互動:
硬體限制
這項解決方案適用於配備 NVIDIA RTX PRO 6000 Blackwell GPU 的客戶自備硬體。
- GPU 規格:NVIDIA RTX PRO 6000 (Blackwell 伺服器或工作站版本)。
- 記憶體架構:96 GB GDDR7 VRAM (含 ECC)
- 模型選取影響:
- 96 GB 的 VRAM 可讓目標 Gemma 4 31B 模型以原生 BF16 精確度執行 (佔用約 62 GB 的權重,並留下約 34 GB 的 VRAM 空間供鍵值 (KV) 快取)。
- 啟用 Blackwell 硬體加速 FP8 量化 (
--quantization=fp8) 時 (如參考實作中設定),模型權重記憶體會減半至約 31 GB,將可用 KV 快取擴展至約 56.5 GiB (61,728權杖),並在--gpu-memory-utilization=0.95啟用大型內容視窗或高並行批次大小,不會發生記憶體不足 (OOM) 錯誤。
支援性矩陣 (責任)
| 元件 | 管理員: | 附註 |
|---|---|---|
| 實體硬體和作業系統 | 客戶 | 客戶提供的硬體 (具體來說,是搭載 NVIDIA RTX PRO 6000 Blackwell GPU 的伺服器或工作站)。 |
| 僅限 Distributed Cloud 軟體的叢集安裝作業 | 客戶 | 必須遵循標準的 Distributed Cloud 軟體安裝說明文件。 |
| GPU 驅動程式和運算子 | 客戶 | 安裝 NVIDIA GPU 運算子和 Helm 圖表。Google 不支援 NVIDIA 運算子部署作業。 |
| vLLM 放送資訊清單 | Google (解決方案) | 本解決方案指南提供相關資訊。 |
| 模型構件 | 客戶 | 下載及代管 Gemma 模型權重。 |
| Gradio UI 和應用程式程式碼 | 客戶 | 客戶擁有的應用程式層,用於驗證和使用。 |
| Cloud Logging 和 Cloud Monitoring | 接縫 | Google 提供預設整合功能,客戶負責設定。 |
概念和技術
本節詳細說明功能元件、各自的責任,以及元件在系統內的通訊方式。這份文件會列出支援目標用途所需的核心服務、資料儲存單元和網路介面。
基礎架構和平台
- NVIDIA RTX PRO 6000 GPU:提供 96 GB GDDR7 VRAM。實體 GPU 完全專用於提供模型執行個體。為確保模型擁有完整的 VRAM 和記憶體頻寬,避免資源爭用,因此未啟用 GPU 分割 (MIG)。
- NVIDIA GPU 運算子:由客戶管理的運算子,可將實體 GPU 資源協調及公開給 Distributed Cloud 軟體,僅限 Kubernetes 工作站節點。
- 節點本機儲存空間 (Persistent Volume Claim):僅由 Distributed Cloud 軟體節點本機儲存空間支援,用於在節點上代管及保存模型權重。這可確保模型權重下載後,會保留在本機。後續的 Pod 重新啟動或更新會從這個本機快取載入權重,縮短啟動時間並防範 WAN 中斷。
- 共用記憶體區段 (
/dev/shm):emptyDir磁碟區會掛接在/dev/shm,並分配 16GiB,以避免 vLLM 中高並行張量運算期間發生區段錯誤。medium: Memory
服務和邏輯
- vLLM 服務引擎:部署為 Kubernetes Deployment,執行 Vertex AI 認證的 vLLM 容器,並透過
ClusterIP服務 (連接埠 8000) 公開。主要設定參數包括:--model:Gemma 模型的路徑或 ID (例如google/gemma-4-31B-it)。--tensor-parallel-size:設為1(單一 GPU 限制)。--dtype:設為bfloat16,即可針對非量化層和啟用項目,運用硬體原生精確度。--quantization:在參考實作中設為fp8,即可運用 Blackwell FP8 權重量化 (約 31 GB 權重,約 56.5 GiB KV 快取),如果偏好未量化的 BF16 (約 62 GB 權重,約 34 GB KV 快取),則可省略。
- Gradio 網頁版 UI:部署為 Kubernetes Deployment,提供用於驗證的即時通訊介面,並透過
ClusterIP服務 (通訊埠 8080) 公開。並連線至 vLLM 服務,進行提示和回覆互動。
觀測能力與 Google Cloud 整合
- Cloud Logging:使用預設的 Distributed Cloud 軟體專用記錄代理程式,自動擷取容器記錄 (vLLM 應用程式記錄和 GPU 診斷),並轉送至 Cloud Logging。
- Cloud Monitoring (PodMonitoring):Google Cloud Managed Service for Prometheus (GMP) 資源會同時以 vLLM Pod (用於提供權杖處理量和 KV 快取用量等遙測資料) 和 GPU 匯出工具 Pod (用於提供 GPU 遙測資料) 為目標,並將指標匯出至 Cloud Monitoring。
注意事項
擴充性和效能
- GPU 專用:NVIDIA RTX PRO 6000 GPU 完全專用於 vLLM 容器。為確保可預測的推論延遲時間並避免 OOM,這個架構不會透過 MIG 或時間切片共用 GPU。Gemma 4 31B 模型也需要大部分的 VRAM 容量來儲存模型權重 (~62 GB),因此沒有太多記憶體可供其他模型同時執行。
- 部署策略:強制執行為
Recreate。由於我們只有一個 GPU,因此更新期間無法同時執行兩個 vLLM Pod 執行個體。必須先終止舊 Pod,釋放 GPU 鎖定,新 Pod 才能啟動。
資源管理
- VRAM 空間:96 GB 的 NVIDIA RTX PRO 6000 適合用於未量化的 BF16 精確度 Gemma 4 31B 模型 (權重約 62 GB,KV 快取約 34 GB),但參考部署作業會啟用 Blackwell FP8 量化 (
--quantization=fp8),將權重記憶體減少至約 31 GB,並將可用 KV 快取擴充至約 56.5 GiB (61,728並行權杖)。 - KV 快取大小:SRA 會採用預設的 vLLM 分配 (
--gpu-memory-utilization=0.95),盡量使用引擎的 VRAM。
可用性和穩定性
- 快取暖機:使用節點本機 PV 至關重要。如果節點重新啟動,主機目錄中的快取權重會重複使用。
- 映像檔快取:由於 vLLM 容器映像檔很大 (>10 GB),建議您設定
imagePullPolicy: IfNotPresent,避免在 Pod 重新啟動時,登錄檔提取作業發生延遲。
作業複雜度
- 控制台可見度:與 GKE 不同,Distributed Cloud 軟體僅支援以控制台為基礎的「AI/ML 模型」檢視畫面。所有驗證和監控作業都必須透過
kubectlCLI、連接埠轉送和直接 Cloud Monitoring 資訊主頁執行。
設計決策
推論引擎:vLLM、Triton 或 Ollama
- 選取的選項: vLLM
- 理由:vLLM 透過 PagedAttention 為 LLM 提供最佳的開箱即用效能,支援 OpenAI API 同位檢查,並提供 Vertex AI 預先認證的容器映像檔。
- 遭拒的替代方案:
- Triton:設定和編譯過於複雜,無法用於單一模型邊緣部署。
- Ollama:缺少進階遙測端點和細微的並行調整功能,無法用於正式環境監控。
遙測路徑:原生 GMP 與本機 Prometheus
選取的選項: 原生 GMP (PodMonitoring)
- 理由:Distributed Cloud 軟體僅支援與 Cloud Monitoring 的原生整合。我們可以透過 Managed Prometheus 將指標直接傳送至Google Cloud ,減少叢集內的營運支出。
- 遭拒的替代方案:
- 本機 Prometheus 和 Grafana Stack:遭拒,以盡量減少單一節點叢集上的控制層資源用量。
假設和限制
假設
- GPU 運算子可用性:假設客戶已成功安裝 NVIDIA GPU 運算子,並在部署此解決方案前設定
nvidiaRuntimeClass。 - Hugging Face 存取權:部署作業需要有效的 Hugging Face 權杖,且該權杖必須有權存取封閉式 Gemma 4 存放區,並以 Kubernetes Secret 形式儲存。
- 網路路徑:叢集必須具備網際網路存取權 (或內部 Proxy),才能在初始設定期間下載容器映像檔和模型權重。
限制
- 單一 GPU 邊界:第 1 階段架構受限於單一 NVIDIA RTX PRO 6000 GPU 的實體容量。第 1 階段不支援大於約 310 億個參數的模型 (或需要多 GPU 張量平行處理的高並行工作負載)。
- 不支援滾動更新:
Recreate策略表示模型更新或設定變更期間,服務會暫時停止運作,因為新舊 Pod 無法共用 GPU。 - 不含效能調整:與專案範圍一致,節點層級最佳化 (CPU 固定、hugepages、
PerformanceTuningProfile) 不包含在此架構中。