


O mecanismo RAG na Gemini Enterprise Agent Platform oferece diferentes modos de implantação para operar suas instâncias de RAG. A escolha do modo de implantação determina onde os dados são armazenados, como esse armazenamento é escalonado à medida que os dados aumentam e qual nível de gerenciamento de infraestrutura é necessário. Ao entender como esses modos funcionam, você pode escolher o equilíbrio certo de simplicidade, escalonabilidade e custos para seu projeto.
O mecanismo RAG oferece dois modos de implantação: sem servidor e Spanner. É possível alternar entre os dois modos sem problemas. Os dados em cada modo permanecem isolados uns dos outros.
Modos de implantação disponíveis
Nesta seção, discutimos os dois modos de implantação disponíveis para o RAG Engine:
Modo sem servidor
O modo sem servidor é o jeito mais acessível e recomendado de começar a usar o mecanismo RAG. Ele oferece um banco de dados totalmente gerenciado, em escala global e pronto para empresas que abstrai todo o provisionamento e escalonamento de bancos de dados.
- Ideal para: a maioria dos usuários, integração rápida e escalonamento sem precisar gerenciar configurações de infraestrutura.
- Principais recursos: não requer gerenciamento de nível. Ele usa automaticamente a Pesquisa Vetorial gerenciada por RAG como o banco de dados vetorial padrão para oferecer uma experiência de RAG simplificada e pronta para uso.
No modo sem servidor, o banco de dados gerenciado por RAG é usado para gerenciar operações comerciais de RAG e armazenar recursos de RAG. Esses recursos incluem, entre outros, RagCorpus, RagFiles, RagMetadata, DataSchema etc. No entanto, ele não pode mais ser usado para indexação de embeddings e pesquisa vetorial.
Os usuários sempre precisarão escolher um banco de dados vetorial diferente separadamente. No modo sem servidor, por padrão, o mecanismo RAG provisiona uma coleção da Pesquisa Vetorial 2.0 no seu projeto para indexação de embeddings e pesquisa vetorial. Em comparação com o modo Spanner, o provisionamento da Pesquisa Vetorial 2.0 no seu projeto oferece visibilidade e controle totais sobre o uso e os custos do banco de dados vetorial. Consulte a seção Modo Spanner versus Modo sem servidor para uma comparação detalhada.
Modo Spanner
O modo Spanner aloca uma infraestrutura dedicada do Spanner especificamente para servir como base da implantação do mecanismo RAG. Ele foi projetado para cargas de trabalho que exigem recursos de conformidade específicos (como CMEK) ou instâncias de banco de dados dedicadas e isoladas. O modo Spanner é atribuído como padrão se uma opção de modo não for selecionada explicitamente.
Ao usar o modo Spanner, você precisa gerenciar sua infraestrutura selecionando um nível de desempenho:
- Nível básico (padrão): um nível fixo, econômico e de baixa computação, adequado para experimentos, tamanhos de dados pequenos ou cargas de trabalho que não são sensíveis à latência.
- Nível escalonado: oferece desempenho em escala de produção com funcionalidade de escalonamento automático. Ele é ideal para clientes com grandes quantidades de dados ou cargas de trabalho sensíveis ao desempenho.
Isolamento de dados e modos de troca
O RAG Engine permite alternar o modo de implantação do projeto, desde que não haja operações em andamento no modo de implantação ativo. É possível ter dados nos dois modos. No entanto, apenas um modo pode estar ativo por vez, e os dados são estritamente isolados entre os modos de implantação.
Para facilitar, imagine que seu projeto se comporta como se tivesse dois back-ends completamente separados. Os recursos criados (corpora, arquivos importados e enviados e embeddings analisados) ficam permanentemente vinculados ao modo de implantação que estava ativo durante a criação. Todas as solicitações de recuperação, sejam diretas ou pelo Gemini, também serão limitadas aos corpora e arquivos presentes no modo de implantação atual. Alternar entre os dois modos não move nem exclui dados do outro modo.
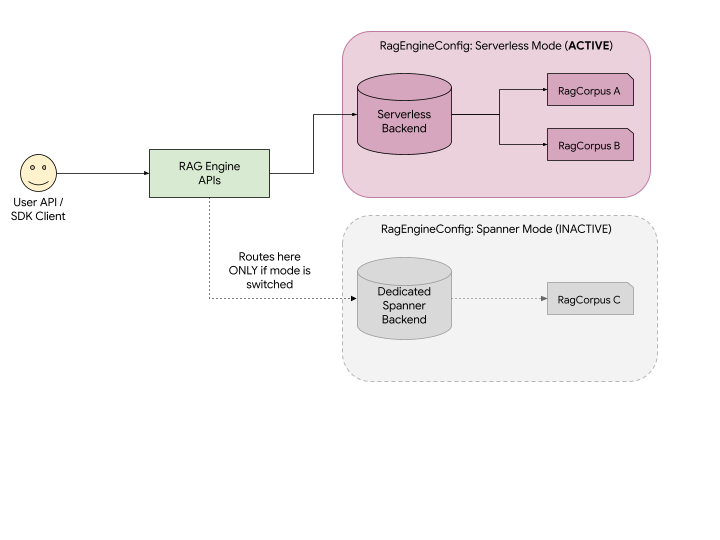
Conforme ilustrado no diagrama:
- API unificada: use as mesmas APIs de RAG da Agent Platform para criar e gerenciar recursos. A API encaminha automaticamente suas solicitações para o back-end associado ao modo de implantação ativo.
- Visibilidade: se o modo sem servidor estiver ativo, seu aplicativo só poderá ver e interagir com os RagCorpus A e B. O RagCorpus C, que foi criado no modo Spanner, permanece armazenado com segurança, mas fica completamente oculto e inacessível para o aplicativo até que você mude o modo do projeto de volta para Spanner.
- Sem perda de dados: a troca de modos não exclui seus dados. Ela só muda o "back-end" que a API está analisando.
Gerenciar o modo de implantação
O modo de implantação é uma configuração para envolvidos no projeto. É possível conferir ou mudar o modo atual usando as APIs GetRagEngineConfig e UpdateRagEngineConfig. Consulte a página Alternar entre modos para saber como alternar entre os modos de implantação e escolher um nível adequado para o modo do Spanner.
Excluir dados e interromper o faturamento
Como os dados são isolados entre os modos, os processos para limpar recursos e interromper o faturamento são um pouco diferentes, dependendo de onde os dados estão.
- Para excluir dados sem servidor: verifique se o modo ativo está definido como Sem servidor. Chame a API
ListRagCorporapara conferir seus recursos e exclua manualmente cada corpus usando a APIDeleteRagCorpus. - Para excluir dados do Spanner (desprovisionamento): verifique se o modo ativo está definido como Spanner. Atualize o
RagEngineConfige defina o nível do Spanner comoUnprovisioned. Isso vai excluir imediatamente sua instância dedicada do Spanner e todos os dados de RAG nela, interrompendo qualquer faturamento associado ao modo Spanner. Observação: não é possível recuperar os dados excluídos usando o nível não provisionado.
Modo Spanner x modo sem servidor
| Recurso | Modo sem servidor | Modo Spanner |
|---|---|---|
| Custo |
|
|
| Escalonamento | Escalonamento automático totalmente gerenciado | A escolha do nível precisa ser configurada, mas oferece um nível de escalonamento automático. |
| Isolamento | O armazenamento não é isolado | Oferece isolamento de armazenamento e desempenho. |
| CMEK | Nenhuma CMEK no momento | Oferece suporte a CMEK |
| Controles de segurança de VPC | Com suporte | Com suporte |
| BDs de vetores compatíveis |
|
|
A seguir
- Para começar a usar o RAG Engine, consulte o guia de início rápido do RAG.
- Para mudar o modo de implantação ou atualizar o nível do modo do Spanner, consulte Alternar entre os modos.
- Para excluir sua instância do Spanner, consulte Atualizar para o nível não provisionado.
- Para saber mais sobre o modo Spanner, consulte Gerenciar o modo Spanner.
- Para saber mais sobre o modo sem servidor, consulte Modo sem servidor.
- Para saber mais sobre os preços, consulte Faturamento do Mecanismo RAG na Gemini Enterprise Agent Platform.