


RAG Engine en Gemini Enterprise Agent Platform proporciona diferentes modos de implementación para operar tus instancias de RAG. La elección del modo de implementación determina dónde se almacenan tus datos, cómo se escala ese almacenamiento a medida que crecen tus datos y qué nivel de administración de la infraestructura se requiere de tu parte. Si comprendes cómo funcionan estos modos, puedes elegir el equilibrio adecuado entre simplicidad, escalabilidad y costos para tu proyecto.
RAG Engine ofrece dos modos de implementación: sin servidores y Spanner. Puedes cambiar entre ambos modos sin problemas. Los datos de cada modo permanecen aislados de los demás.
Modos de implementación disponibles
En esta sección, analizaremos los dos modos de implementación disponibles para RAG Engine:
Modo sin servidores
El modo sin servidores es la forma más económica y recomendada de comenzar a usar RAG Engine. Proporciona una base de datos completamente administrada, a escala global y lista para empresas que abstrae todo el aprovisionamiento y el escalamiento de la base de datos.
- Ideal para: La mayoría de los usuarios, incorporación rápida y escalamiento sin problemas, sin necesidad de administrar configuraciones de infraestructura.
- Funciones clave: No requiere administración de niveles. Usa automáticamente Vector Search administrado por RAG como la base de datos de vectores predeterminada para proporcionar una experiencia de RAG optimizada y lista para usar.
En el modo sin servidores, la base de datos administrada de RAG se usa para administrar las operaciones comerciales de RAG y almacenar los recursos de RAG. Estos recursos incluyen (entre otros) RagCorpus, RagFiles, RagMetadata, DataSchema, etc. Sin embargo, ya no se puede usar para incorporar la indexación y la búsqueda de vectores.
Los usuarios siempre deberán elegir una base de datos de vectores diferente por separado. En el modo sin servidores, de forma predeterminada, RAG Engine aprovisiona una colección de Vector Search 2.0 en tu proyecto para la indexación de embeddings y la búsqueda de vectores. En comparación con el modo Spanner, aprovisionar Vector Search 2.0 en tu proyecto te brinda visibilidad y control totales sobre el uso y los costos de la base de datos de vectores. Consulta la sección Modo Spanner frente al modo sin servidores para obtener una comparación detallada.
Modo de Spanner
El modo de Spanner asigna infraestructura de Spanner dedicada específicamente para que sirva como base de tu implementación de RAG Engine. Está diseñado para cargas de trabajo que requieren funciones de cumplimiento específicas (como CMEK) o instancias de base de datos dedicadas y aisladas. El modo Spanner se asigna como predeterminado si no se selecciona de forma explícita una opción de modo.
Cuando usas el modo Spanner, debes administrar tu infraestructura seleccionando un nivel de rendimiento:
- Nivel básico (predeterminado): Es un nivel fijo, rentable y de bajo procesamiento, adecuado para la experimentación, los tamaños de datos pequeños o las cargas de trabajo que no son sensibles a la latencia.
- Nivel de escalamiento: Ofrece un rendimiento a escala de producción con la funcionalidad de ajuste de escala automático. Es adecuado para clientes con grandes cantidades de datos o cargas de trabajo sensibles al rendimiento.
Aislamiento de datos y cambio de modo
RAG Engine te permite cambiar el modo de implementación de tu proyecto, siempre y cuando no haya operaciones en curso en el modo de implementación activo. Puedes tener datos en ambos modos. Sin embargo, solo puede haber un modo activo a la vez, y los datos están estrictamente aislados entre los modos de implementación.
Como herramienta útil, puedes imaginar que tu proyecto se comporta como si tuviera dos backends completamente independientes. Los recursos que creas (corpus, archivos importados y subidos, y embeddings analizados) están vinculados de forma permanente al modo de implementación que estaba activo durante su creación. Las solicitudes de recuperación, ya sea directamente o a través de Gemini, también se limitarán a los corpus y archivos que estén presentes en tu modo de implementación actual. Cambiar entre los dos modos no mueve tus datos ni los borra del otro modo.
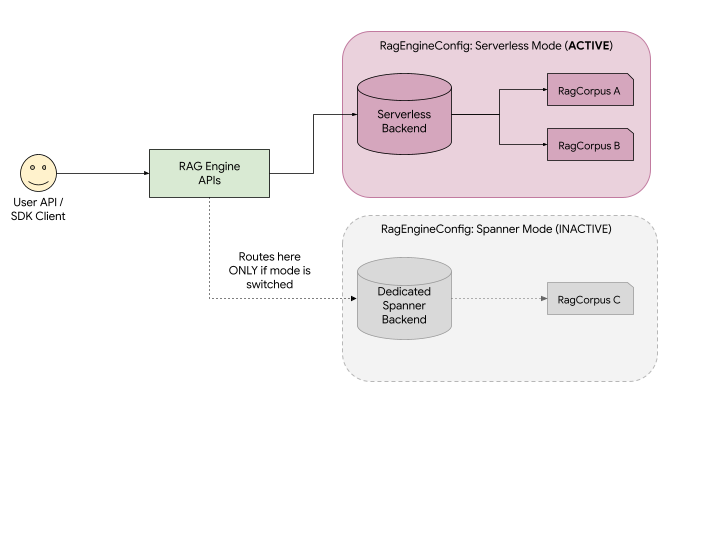
Como se ilustra en el diagrama:
- API unificada: Usas exactamente las mismas APIs de RAG de Agent Platform para crear y administrar recursos. La API enruta automáticamente tus solicitudes al backend asociado con tu modo de implementación activo.
- Visibilidad: Si el modo sin servidores está activo, tu aplicación solo puede ver RagCorpus A y B, y, además, interactuar con ellos. RagCorpus C, que se creó en el modo Spanner, permanece almacenado de forma segura, pero está completamente oculto y no es accesible para tu aplicación hasta que vuelvas a cambiar el modo de tu proyecto a Spanner.
- Sin pérdida de datos: Cambiar de modo no borra tus datos. Solo cambia el "backend" que la API está mirando.
Administra tu modo de implementación
El modo de implementación es un parámetro de configuración a nivel del proyecto. Puedes ver o cambiar el modo actual con las APIs de GetRagEngineConfig y UpdateRagEngineConfig. Consulta la página Cambia entre modos para obtener detalles sobre cómo cambiar entre los modos de implementación y elegir un nivel adecuado para tu modo de Spanner.
Borra los datos y detén la facturación
Debido a que los datos están aislados entre los modos, los procesos para limpiar los recursos y detener la facturación difieren un poco según dónde se encuentren tus datos.
- Para borrar datos sin servidores, asegúrate de que el modo activo esté configurado como Sin servidores. Llama a la API de
ListRagCorporapara ver tus recursos y, luego, borra manualmente cada corpus con la API deDeleteRagCorpus. - Para borrar datos de Spanner (desaprovisionamiento): Asegúrate de que el modo activo esté configurado en Spanner. Actualiza tu
RagEngineConfigy establece el nivel de Spanner enUnprovisioned. Esta acción borrará de inmediato tu instancia de Spanner dedicada y todos los datos de RAG que contiene, lo que detendrá cualquier facturación asociada para el modo de Spanner. Nota: Los datos borrados con el nivel sin aprovisionar no se pueden recuperar.
Modo Spanner frente al modo sin servidores
| Función | Modo sin servidores | Modo de Spanner |
|---|---|---|
| Costo |
|
|
| Escalamiento | Ajuste de escala automático completamente administrado | Se debe configurar la elección del nivel, pero ofrece un nivel de ajuste de escala automático. |
| Aislamiento | El almacenamiento no está aislado | Proporciona aislamiento de almacenamiento y rendimiento. |
| CMEK | No hay CMEK en este momento | Ofrece compatibilidad con CMEK |
| Controles de seguridad de VPC | Admitido | Admitido |
| Bases de datos de vectores compatibles |
|
|
¿Qué sigue?
- Para comenzar a usar RAG Engine, consulta la guía de inicio rápido de RAG.
- Para cambiar el modo de implementación o actualizar el nivel del modo de Spanner, consulta Cambia entre modos.
- Para borrar tu instancia de Spanner, consulta Actualiza al nivel sin aprovisionamiento.
- Para obtener más información sobre el modo Spanner, consulta Administra el modo Spanner.
- Para obtener más información sobre el modo sin servidores, consulta Modo sin servidores.
- Para obtener información sobre los precios, consulta Facturación de RAG Engine en Gemini Enterprise Agent Platform.